Hinton预言十年后,阿里通用医疗影像AI登Science正刊
9 月 18 日,阿里达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像模型 DAMO RADAR 登上《Science》正刊,并正式对外开源。这也是近年来中国 AI 模型罕见登上《Science》正刊。
2016 年 11 月,深度学习先驱、诺贝尔物理学奖得主 Geoffrey Hinton 有过一则过于乐观的预言。他认为应该停止培养放射科医生,深度学习将在五年或十年内做得更好。
加拿大多伦多大学罗特曼管理学院举办的 Machine Learning and the Market for Intelligence 大会。视频地址:https://www.youtube.com/watch?v=2HMPRXstSvQ
近十年过去,Hinton 预言中的场景并没有出现。放射科医生短缺,至今仍是医疗体系面临的现实问题。AI 虽然已经能在不少影像任务中达到专家水平,却还难以像医生一样,全面检查多个器官,识别各种并存异常。
现在,阿里达摩院为这个问题交出了一份新答案。
9 月 18 日,阿里达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像模型 DAMO RADAR 登上《Science》正刊,并正式对外开源。
这也是近年来中国 AI 模型罕见登上《Science》正刊。
- 论文链接:www.science.org/doi/10.1126/science.aec6129
- 开源地址:https://github.com/alibaba-damo-academy/damo-radar
RADAR 全称为 Rapid Abdominal Diagnosis with AI and Radiology,中文为基于人工智能与放射学的快速腹部诊断。该模型聚焦腹部增强 CT,在涵盖 18 个解剖结构、146 种临床相关影像学表现的近 4 万次系统评估中,平均 AUC(区分患者与未患病者的能力指标,1 为完美区分)为 0.913,首次达到影像科专家水平。
更值得关注的是,达摩院的这次突破不是来自通用聊天模型的医学考试成绩,它直面严肃的临床挑战,经受住了多医院的数万病例和大规模医生对照读片的检验。
这是否意味着,医疗影像 AI 已经接近属于自己的 GPT 时刻了?
医疗影像的 GPT 时刻,
为何迟迟未到?
医疗领域持续吸引 AI 公司进入。IBM Watson 曾尝试为肿瘤治疗提供决策支持;DeepMind 探索过临床预警和眼科影像,2026 年又提出在医生授权下工作的「AI co-clinician」;OpenAI 也推出 ChatGPT Health 和 OpenAI for Healthcare。
这些探索瞄准不同环节,却面对相似的要求。医疗 AI 必须准确、可靠,还要能够接受复核。一次漏诊可能耽误治疗,一次误报也可能引发额外的检查。模型在测试集上取得高分之后,仍需证明它有能力适应不同医院、设备、扫描协议和患者人群。医疗也因此成为检验 AI 能否进入现实世界的一场高压测试。识别能力、泛化能力和安全边界,每一项都要经得起临床检验。
影像 AI 是其中发展较成熟、落地较快的方向之一。过去,深度学习推动了一批专用模型,在肺结节、糖尿病视网膜病变、特定癌症筛查等任务上达到甚至超过专家水平。这些成果大多围绕明确的病种和任务展开,收集影像,制作标签,再训练模型判断某种异常是否存在。任务边界清楚,模型也能被反复优化。
到了真实临床,任务边界往往更加复杂。单项任务中的高分,很难直接换算成全面的诊断能力。模型覆盖的疾病受到训练标签限制。每增加一项任务,都可能需要重新整理数据、标注、训练和验证。不同医院的影像采集和患者分布存在差异,换一个环境,模型性能可能下降。达摩院在专病研究中也遇到了这些问题。
达摩院高级算法专家张建鹏参与的第一个单病种 AI 项目是肺癌,此后又陆续负责肠癌等专病项目。按照传统流程,一个病种从立项到能力发布,往往需要两三年。做到第二个项目时,团队已经感到这条路线难以覆盖真实临床。「真实世界病种成千上万,按照这个速度,可能一辈子都做不完。」
达摩院资深算法专家张灵提到了另一种反差。团队研发胰腺癌筛查模型时发现,AI 能够识别细微的肿瘤线索,却仍可能受到腹水、术后改变或伪影的干扰,产生假阳性。对医生来说通常不难辨认的异常变化,反而可能成为专病模型的盲点。临床中,团队很难为每一种干扰因素都额外开发一个模型。真实世界不是一场 AI 答题考试,病人很可能得的不是一种特定的病,而是多种不确定的病,这是把多个专病模型串联起来都无法解决的问题。
这些困难推动达摩院重新思考学习方式。此次发布的 DAMO RADAR 要回答一个更大的问题:能否让同一个模型学习不同解剖结构、影像表现和临床描述之间的关系,从而覆盖更广泛的疾病谱?
视觉语言学习(Vision - Language Learning)提供了新的切入口。医院日常产生的 CT 影像和放射学报告天然存在对应关系,模型可以直接学习这些配对数据,减少为每个病种逐例制作专门标签的需求。不过,把整套 CT 和整份报告简单配对,仍然不够。DAMO RADAR 的关键设计,正是进一步建立了器官级的细粒度图文对应关系。
CT 影像与报告,
在解剖结构层面对齐
AI 系统学习医疗影像这门语言,首先要解决一个问题:怎样把影像中的结构、异常与报告里的描述准确对应起来?DAMO RADAR 面向的腹部增强 CT,集中体现了这项任务的难度。
浙大一院放射科主任肖文波介绍称,临床上的一份腹部增强 CT 通常包含多个期相、数百幅图像。腹部同时涉及消化、泌尿、生殖等多个系统,许多器官都是密度接近的软组织,肠道又盘绕其中。有些病灶与周围组织的差异很小,医生需要逐层查看,结合位置、形态和增强表现作出诊断。
对模型来说,还面临另一重困难。一套 CT 中的局部病灶,可能只占医学三维影像极小的一部分。报告却同时描述多个器官,既有正常所见,也有异常发现。直接将整套 CT 与整份报告全局对齐,关键异常容易被无关信息稀释。模型即使学到了总体关联,也未必能准确对应某个器官及其异常。
DAMO RADAR 将学习的基本单元细化到了解剖结构层面。团队将 CT 体数据与对应的放射学报告配对,形成百万级的个体数据图像—文本对。随后借助 Qwen 语言模型,将报告拆分成不同解剖结构对应的描述,再与相应影像区域配对,得到超过千万级的解剖级图像—文本对。
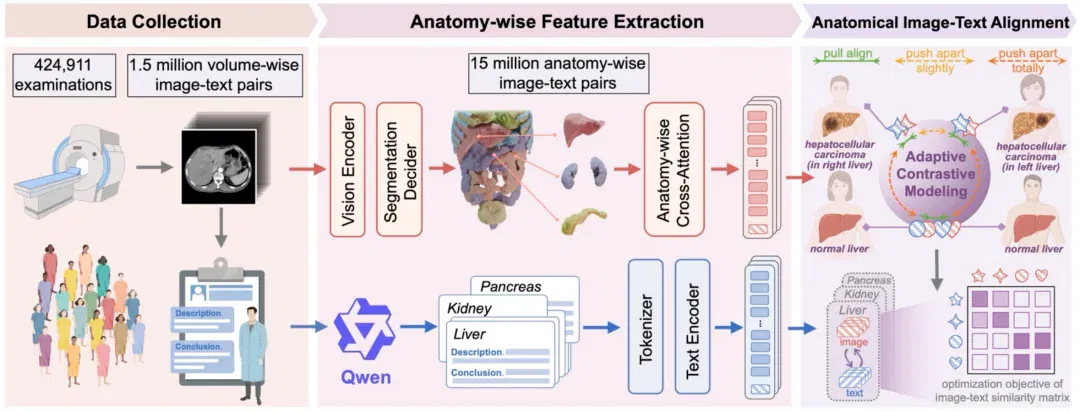
从数据收集,到基于解剖结构的特征提取,再到解剖级图像 - 文本对齐。
一番操作下,已有临床报告能够提供丰富的学习信号,减少逐病制作人工标签的需求。不过,疾病描述与解剖定位使用的监督信息需要区分。模型仍在带有体素级标注的 TotalSegmentator 数据集上进行分割预训练,最终得到 18 个目标解剖结构。同时使用公开可用的 TotalSegmentator 模型生成器官掩码,作为后续训练的伪标签。评估中的测试标签也需人工标注、医生复核和质量控制。
模型如何利用这些数据呢?第一个关键环节,是解剖感知与细粒度图文对齐。
如下图所示,DAMO RADAR 由视觉分支和文本分支组成。视觉分支使用三维 U-Net 提取影像特征,分割解码器负责定位不同解剖结构。模型根据分割结果,聚合相应区域的视觉特征。文本分支使用 BERT 编码器,处理报告中对应的描述。两类特征在同一表示空间中对齐,让模型学习具体结构的影像表现与临床语言之间的联系。分割与图文对齐在训练中联合优化。
张建鹏提到,这种组织方式更接近放射科医生的阅片习惯。他们通常按照解剖结构依次检查肝脏、胰腺、胆道、肾脏和肠道等区域,再综合不同部位的信息形成判断。对 DAMO RADAR 来说,明确的局部对应关系有助于减少其他器官和无关描述的干扰。
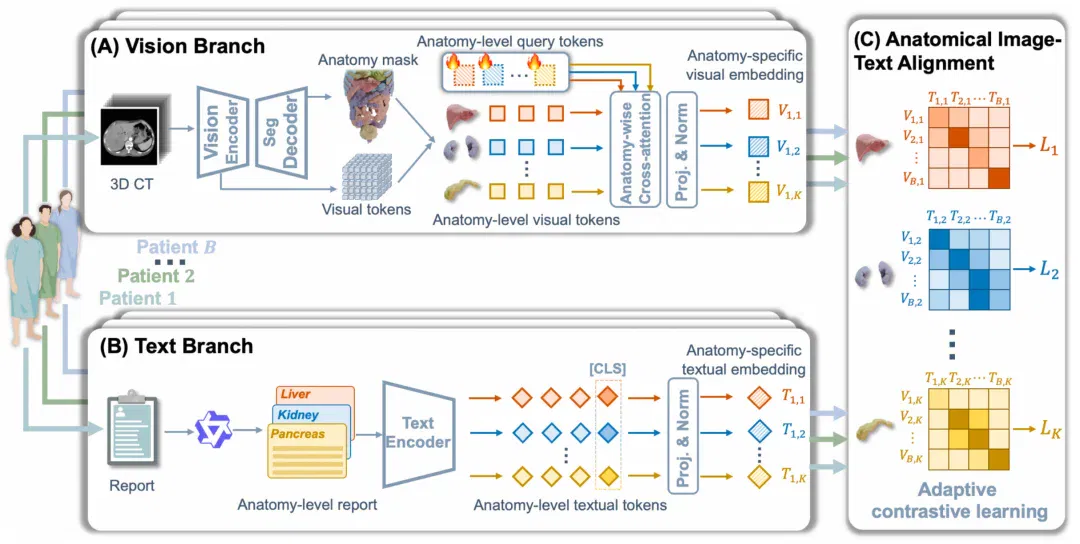
DAMO RADAR 架构概览
第二个关键环节,是自适应对比建模。完成局部配对之后,模型还要处理不同患者之间的相似性。
标准图文对比学习通常将配对的影像与文本拉近,并把其他不配对的样本视为负样本。但患者不同,不代表影像含义一定不同。两名患者的正常肝脏可能具有相似特征,描述相近的异常病例也可能共享某些影像表现。将这些样本一律推开,可能会产生「假负样本」,干扰学习。
DAMO RADAR 根据解剖结构的正常或异常状态,以及异常描述之间的语义相似性,动态调整对比学习的监督关系。对于正常结构,不同患者之间的样本可以作为额外的正样本。对于异常结构,模型依据文本描述的相似度,通过软监督调整配对权重,减少语义相近样本被过度推开的情况。
训练完成后,模型通过文本提示判断目标影像表现。以结肠炎为例,分别输入描述其存在与不存在的提示,再与对应解剖结构的影像特征比较相似度,得到预测分数。疾病查询由此可以复用同一套图文表示,无需为每项查询重新训练一个专用分类器。
解剖级对齐解决三维影像中诊断信号稀疏的问题,而自适应对比学习进一步减少患者间语义相似带来的干扰。两者结合,使同一个模型能够覆盖更广的影像表现,并通过文本提示查询不同目标,减少逐病标注和重复训练的成本。对于整个行业来说,医院长期积累的影像与报告数据,有机会转化为持续扩展的诊断能力。
走出训练数据,
经受多中心与真实阅片检验
CT 影像与报告在解剖结构层面对齐,解决的是模型学习的问题。接下来还要回答两个更实际的问题:在未参与训练的医院中,模型能否保持性能?进入医生的阅片流程后,能否真正发挥作用?
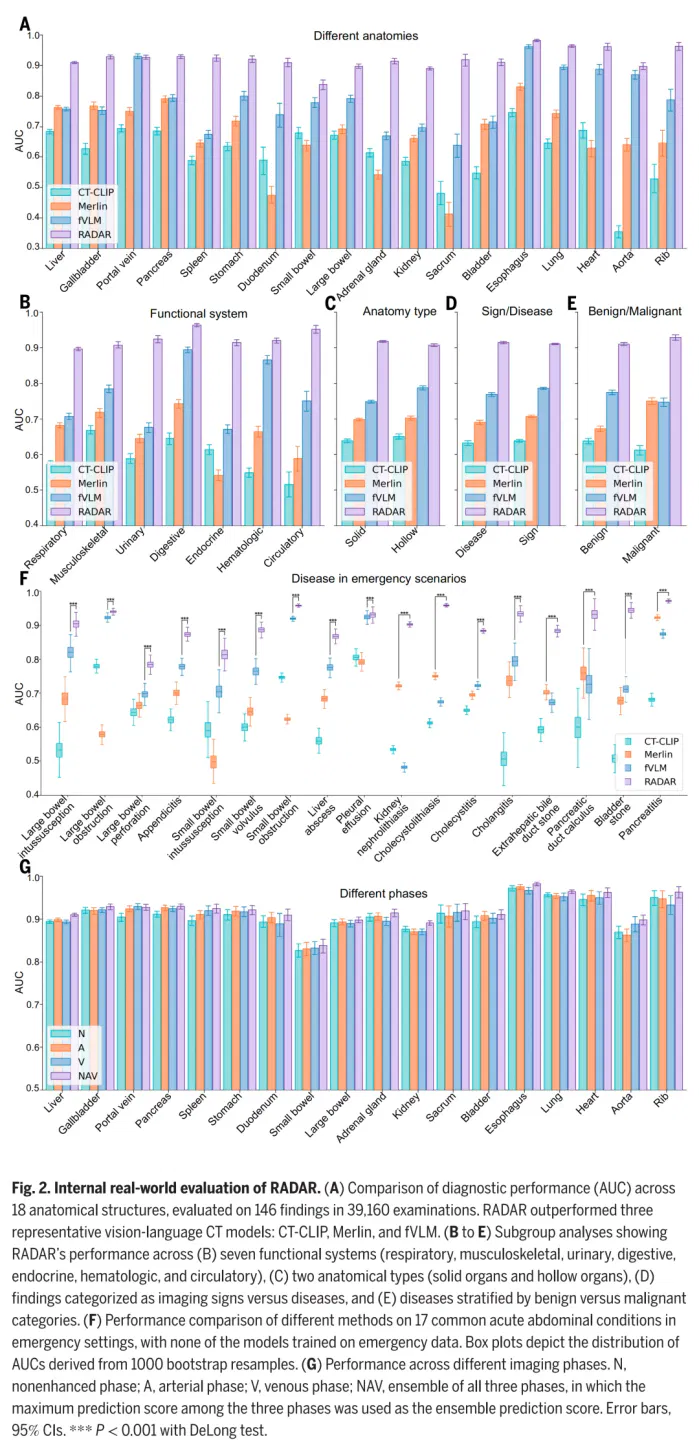
先看内部真实世界测试。团队使用一个独立时间段的连续病例组成测试队列,共包含 39,160 次腹部增强 CT 检查,覆盖 18 个解剖结构和 146 种临床相关影像学表现。结果显示,DAMO RADAR 的平均 AUC 达到 0.913,95% 置信区间为 0.911 至 0.915。这里的 146 种表现既包括具体疾病,也包括影像学征象。
分组结果显示,DAMO RADAR 在不同任务上的表现较为均衡。18 个解剖结构的 AUC 介于 0.838 至 0.982。实质器官和空腔器官的平均 AUC 分别为 0.918 和 0.907,疾病与影像学征象的平均 AUC 分别为 0.914 和 0.911。良性与恶性表现的平均 AUC 分别为 0.910 和 0.929。
这些结果说明,模型的能力并没有集中在少数高频病种或某类器官上,它能够同时处理肝脏、胰腺等实质器官,也能识别胃肠道等空腔器官中的异常。
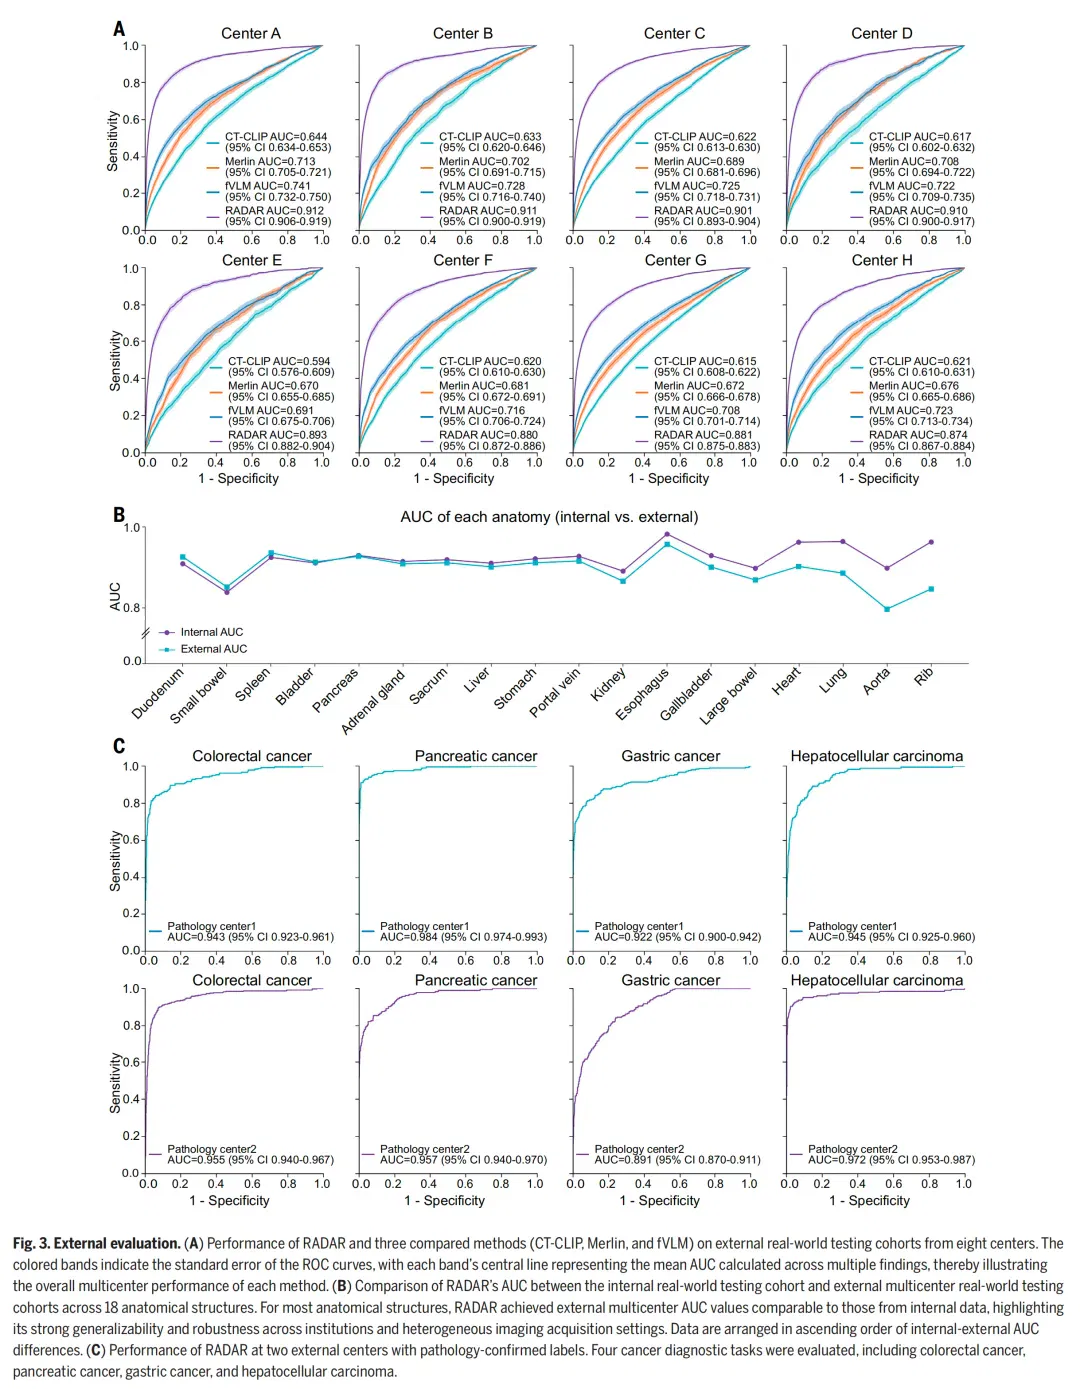
模型更难的一道关卡,是它面对不同医院的设备、扫描方案和患者构成时能否保持稳定。团队在 8 个外部中心进行验证,共纳入 24,239 次增强腹部 CT 检查。这些病例来自急诊、住院、门诊和健康体检等不同场景,扫描范围覆盖全腹、上腹、中腹、下腹和盆腔。各中心评估的影像学表现数量介于 68 至 136 种。
结果依然亮眼,DAMO RADAR在 8 个外部中心的平均 AUC 为 0.895,大幅优于排名第二的 fVLM,并且单中心 AUC 介于 0.874 至 0.912。与内部队列相比,平均 AUC 下降 0.018。性能有所回落,但各中心仍保持在相对稳定的区间。超过一半的解剖结构在内部和外部测试中的 AUC 差异低于 0.01,包括胃、肝脏和骶骨等部位。
团队还设置了几组难度更高的测试。
训练目标排除了急诊,团队因此使用 27,267 例急诊检查,评估 DAMO RADAR 对 17 种常见急性腹部疾病的识别能力。模型的平均 AUC 为 0.904,95% 置信区间为 0.900 至 0.909。这项结果说明,它在未直接参与训练的急诊场景中保留了较好的区分能力。
跨人群验证使用了斯坦福医院公开的 Merlin 测试集。该数据集包含 5,137 次 CT 扫描,以西方患者为主。DAMO RADAR 没有使用 Merlin 数据进行训练或微调,直接测试其现有能力范围内的 21 种影像学表现,AUC 也达到了 0.883。
另一项测试引入了更严格的病理诊断金标准。两个独立外部队列共纳入了 4,333 例病例,包括 648 例结直肠癌、388 例胰腺癌、537 例胃癌、383 例肝细胞癌和 2,377 例正常对照。DAMO RADAR在四类癌症上的 AUC 介于 0.891 至 0.984。模型主要通过影像和放射学报告进行训练,却能在病理确诊病例中保持较高性能,这为其诊断信号的可靠性提供了进一步证据。
外部测试验证了模型是否有能力适应不同数据。接下来的读片研究把问题推进了一步:是否切实地帮到医生?研究纳入了来自 14 家机构的 26 名放射科医生,以及 300 例腹部增强 CT 检查,覆盖 61 种影像学表现。医生按经验和所在机构分为四组,包括顶级医院与其他医院的资深和初级放射科医生。
在第一阶段,医生独立判读 CT 并撰写报告。结果显示,大多数医生的工作点位于 DAMO RADAR 的受试者工作特征曲线下方,仅有 3 名资深医生略高于模型(如下图 A 所示)。不过,这里比较的是单纯影像判读表现,医生没有结合完整病史、实验室检查和其他临床信息。因此,这项结果不能用于推导 AI 的整体临床诊断能力超过医生。
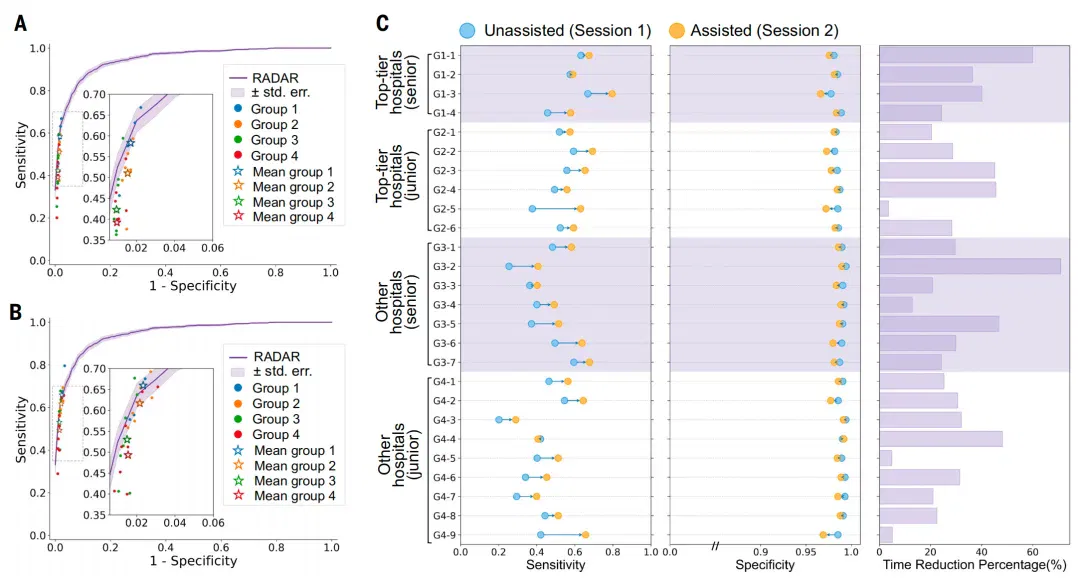
经过至少一个月的洗脱期,同一批医生按照重新随机的病例顺序再次进行阅片。此次 DAMO RADAR 会给出预测结果,并通过注意力图标出可疑区域。AI 辅助使得医生的整体灵敏度提高 10.0%,特异度由 98.8% 轻微降至 98.2%,平均每例阅片时间减少 30.7%(如上图 B 和 C 所示)。这说明,模型提高了异常检出能力,代价是特异度小幅下降。
分层结果进一步显示,DAMO RADAR 对不同经验水平的医生都产生了帮助。在顶级医院中,AI 辅助后的初级医生与未使用 AI 的资深医生表现相当。其他医院也观察到了相同趋势。可以说,AI 辅助缩小了初级医生与资深医生之间的判读差距。相比模型单独超过了多少名医生,人机协作结果更有实际临床价值。
对通用医疗影像 AI 来说,这些结果展示了,一个模型开始同时经受住疾病覆盖、跨中心泛化和人机协作等多重检验。当然,目前的临床验证仍以回顾性研究为主。 DAMO RADAR 能否在前瞻性临床环境中保持性能,需要在更多样的人群和医疗场景中继续验证。未来进入日常诊疗,也要经过工作流测试、监管审查和长期质量监测。
通用智能,
打破「一病一模」的边界
理解 DAMO RADAR 的意义,还需要把它放回达摩院过去几年的医疗 AI 探索中来看。达摩院将重点放到「平扫 CT+AI」,希望利用临床和体检中大量存在的常规 CT,发现容易被忽略的疾病线索。
这条路线最先在专病模型上展开。2023 年,DAMO PANDA 利用平扫 CT 筛查胰腺癌,并在超过两万名患者的真实世界回顾性研究中发现多例此前未被识别的病变,这项工作被顶级医学期刊《自然・医学》评为「基于影像 AI 的癌症筛查开启黄金时代」。随后 DAMO GRAPE 将探索扩展到胃癌,DAMO COCA 进一步探索结直肠癌的机会性筛查。DAMO iAorta 进入急诊场景,利用平扫 CT 识别急性主动脉综合征,并在医院真实工作流中接受验证。
这些项目覆盖实质器官、空腔脏器和主动脉急症,在验证专病路线临床价值的过程中逐渐显露出了扩展成本。DAMO RADAR 完成了一次关键转向:它开始利用大规模 CT 影像和放射学报告学习,不再依赖为每种目标疾病单独制作训练标签。
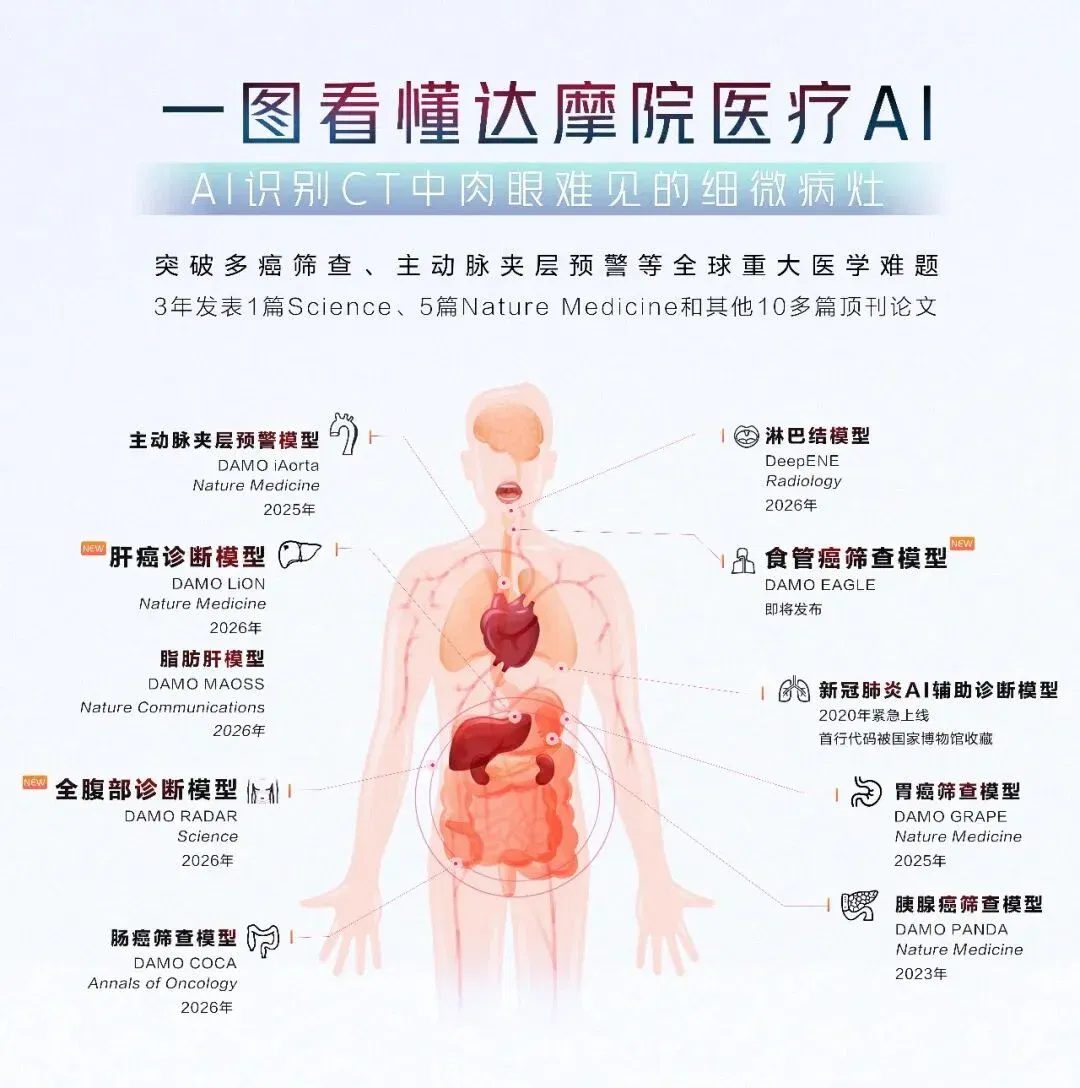
达摩院医疗 AI 的研究重点也由此发生了变化。专病模型积累了医学影像处理、临床合作、真实世界验证和工作流适配的经验,DAMO RADAR 把研究范围扩展到了更完整的腹部影像。未来两类模型可能长期共存。专病模型适合围绕高风险疾病进行深度优化,通用模型承担广泛异常发现、辅助阅片和第二意见等任务。
十年前,Hinton 设想的是 AI 取代放射科医生。DAMO RADAR 给出的答案更贴近现实:AI 先成为医生的辅助工具,帮助他们发现更多异常,并以更短时间完成阅片。
虽然不能就此判断医疗影像 AI 的 GPT 时刻已经到来,但 DAMO RADAR 至少将这幅图景变得更清晰。它的开源为更多机构复现、验证和扩展这条路线提供了条件。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Hinton错了!中国AI登顶Science,全球首个专家级通用影像AI来了 (opens in a new tab)
阿里巴巴达摩院与浙大一院联合研发的DAMO RADAR登上Science正刊,作为全球首个专家级通用影像AI模型,其在39,160次测试中可一次性识别超过146种腹部病症,平均AUC达0.913,首次达到影像科资深医生水平。
MedGPT lung cancer case study: higher plan scores for doctors using AI assistance (opens in a new tab)
The study evaluates diagnostic and treatment strategies for 40 unpublished complex cases. Scores improved when 250 doctors used the system, but the results do not establish real treatment outcomes.
Google 推出 Gemini for healthcare 美国预览版,辅助医疗行政流程 (opens in a new tab)
这套方案面向医疗服务方和保险方,通过连接器整理病历、预授权与福利材料,并保留人工审核。部分连接器仍在有限测试阶段。
多智能体协同重构医疗AI!清华AIR孵化:医生AI分身“坐诊”医院 (opens in a new tab)
不会……只有我这样做吧? 现在每次去医院看病前,我都会让AI帮我跑一轮。 哪里不舒服、持续了多久,还包括既往病史,这些零零碎碎的信息,都在预问诊阶段准备妥帖。 等到和医生面对面,结果发现医生也在Vibe Working: Agent协助医生下判断,诊室之外的随访与健康信息管理也由AI跟上。 乍一听有点赛博朋克,但却是实实在在发生在现实的一幕。 张亚勤院士创办的清华AIR,最近又跑出来一家明星AI医疗企业—— 紫荆智康。 其研发的“紫荆AI医院”系统,已经在全国各地的医院陆续上线测试。 走进去更科幻更未来的是,这里的每个医生都能拥有辅助自己工作的专属AI分身,但这还远远不够。 单说咱去看病,一个
哈佛重磅研究:AI凭人脸照片,就能预测癌症患者死亡风险! (opens in a new tab)
就在今天,这个新闻上了各大热搜。 哈佛附属的马萨诸塞州总医院百瀚癌症研究所,在《柳叶刀·数字健康》上发布了一项突破性研究。 他们训练出了一个全球首创的AI模型——FAHR-Face。 只需输入一张普通的脸部照片,这个AI不仅能看穿你的「生物学真实年龄」,甚至能直接预测癌症患者的存活几率! 最高风险组的患者,有超过一半在拍照后90天内离世。 简直是科幻成真了。这个「看脸知生死」的AI,底层到底藏着什么技术? 链接:https://www.thelancet.com/journals/landig/article/PIIS2589-7500(26)00079-8/fulltext 喂给AI 400