蒋涛:大模型的“PC服务器时代”到来,解锁Token自由,走向人人程序员、行行炼模型
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
作为国内最大的开发者社区,CSDN 拥有海量开发者的真实行为数据,蒋涛借此类比二十多年前 x86 服务器颠覆专有 Unix 服务器的产业变迁,提出了一个核心判断:AI正在复刻服务器产业的历史,统一内存 AI PC 与工作站,正在开启大模型的 PC 服务器时代,“开发 Token 自由”与“应用 Token 自由”,将推动“人人程序员,行行炼模型”的产业新图景落地。
历史轮回:从 x86 服务器崛起,看懂本地 AI 的产业逻辑
回顾互联网发展历史,二十多年前服务器行业发生过一次深刻变革,这一段历史,能够为今天的本地大模型浪潮提供重要参照。
1998年,Sun SPARC 服务器代表着高端算力,信奉“网络就是计算机”,是互联网行业的正规军标配。互联网泡沫破裂之后,亚马逊率先将核心基础设施从昂贵的 Sun 机房迁移到 Linux x86 服务器;2003年 AMD Opteron 把64位计算带入 x86 生态,性价比优势彻底打开市场;最终,便宜十倍、普惠可用的 x86 商品服务器完成对专有 Unix 阵营的替代,Sun 在2010年被收购。
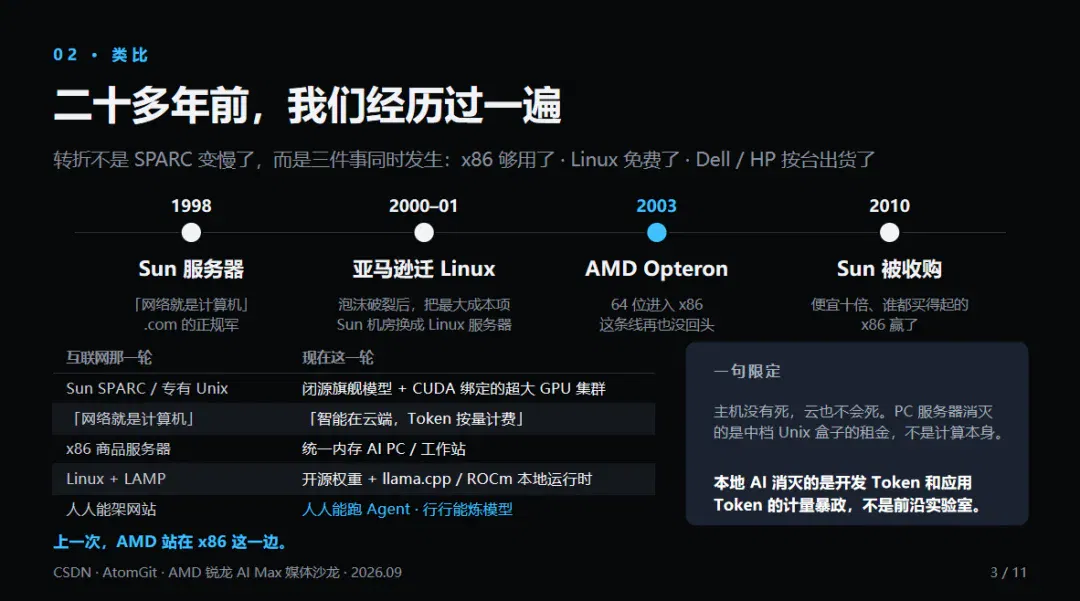
蒋涛指出,这一轮大模型浪潮,正在上演高度相似的产业剧本。
互联网上一轮变革大模型这一轮变革 Sun SPARC / 专有 Unix 服务器 闭源旗舰大模型+CUDA 绑定的超大 GPU 云端集群理念:网络就是计算机理念:智能在云端,Token 按量计费 x86商品服务器大容量统一内存 AI PC/ 工作站 Linux+LAMP 开源软件栈 开源模型权重+ llama.cpp 、ROCm 本地运行时人人可以搭建网站,人人可以运行 Agent ,行行可以做模型微调炼模,当然历史不会简单重复。
蒋涛特别做了边界限定:主机没有消亡,云也不会消亡。当年 x86 PC 服务器消灭的,是中档 Unix 盒子的租赁商业模式,不是计算本身。对应到 AI 时代,本地 AI 消灭的是开发 Token 与应用 Token 的计量暴政,并不是取代前沿实验室的大规模基座预训练。
上一轮产业变革中 AMD 站在 x86 的一边,今天,锐龙 AI Max 系列硬件,正在成为本地 AI 浪潮重要的硬件底座。
来自开发者一线的数据:亿万次 Token 调用背后,成本枷锁日益凸显
事实上,所有产业判断都根植于 CSDN 与 AtomGit 平台的真实开发者数据。作为国内最大开发者平台,CSDN 拥有5400万注册开发者,沉淀6000万博客与代码内容;开放原子开源基金会旗下 AtomGit 平台累计注册用户1200万,备份3157万个项目,托管1138个开源模型,平台上65%的 PR 提交已经由 AI Agent 完成。依托 AtomCode、TaoToken ,平台日 AI Token 调用量接近2000亿,四个月增长30倍,累计调用达到2.4万亿 Token。
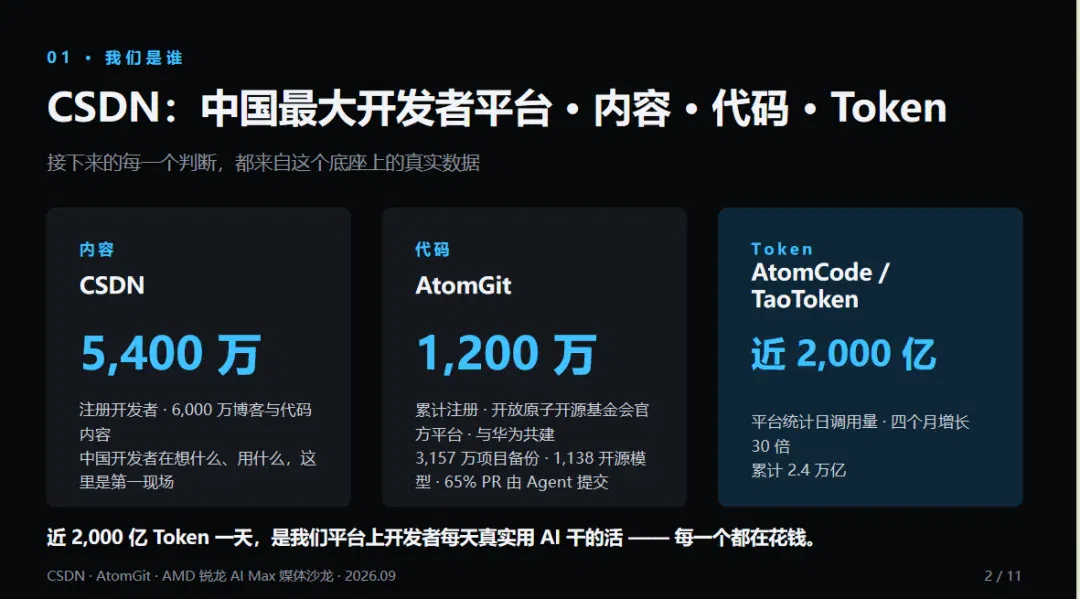
“接近2000亿 Token 每日调用量,是国内开发者每天真实在用 AI 完成工作,每一次调用都意味着实实在在的成本开销。”蒋涛强调,云端按量计费模式,正在成为开发者与 AI 应用落地不可忽视的枷锁。
现场演讲中,蒋涛展示了一组语音应用的云端成本测算:10万日活用户的语音 AI 应用,仅新增音频交互,不同云端模型月成本从百万元级别到千万元不等。即便是每分钟几分钱的主流模型,在高频业务场景下,月账单也会轻松突破百万元。云端模型单价看似不高,但乘以日活、交互时长,叠加多轮上下文开销,成本会快速膨胀。应用的使用频率越高,云端 Token 计费模式带来的成本压力就越突出,推理成本优化迫在眉睫。 这就是当下行业的现实:很多好的 AI 创意,不是模型能力达不到,而是跑不起。
开发者不敢让 Agent 24小时不间断调试,业务不敢放开用户高频使用AI功能,每一轮调用都要掂量 Token 开销。 而转折点已经出现:两条关键曲线正在交汇,开源大模型能力持续向上迭代,本地硬件内存、算力持续扩容,半年前只能跑在云端旗舰的模型,现在已经变成一份可以下载到本地的模型文件。
从模型层面看,Qwen 3.8‑27B 在2026年8月开源,Apache 2.0协议,4‑bit 量化后仅需17GB 内存,24GB 内存笔记本就可以完成本地运行,是2026‑2027年真正面向大众的主力模型;DeepSeek‑V4‑Flash‑0731,总参数量284B,激活参数13B,2‑3bit 量化版本在128GB 内存设备就能够部署,在 Agent 评测上表现优异。当然,评判本地模型体验不能只看参数,量化版本、上下文窗口、实际生成速度三者必须结合起来综合评估。
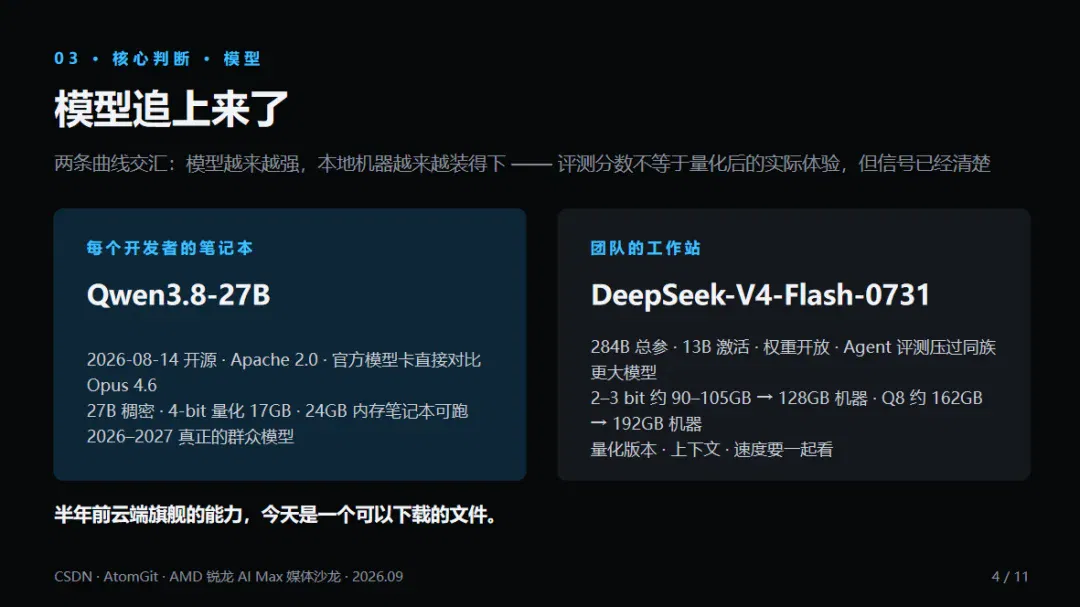
硬件端,AMD 锐龙 AI Max 系列补齐了关键拼图。锐龙 AI Max+395 支持最高128GB 统一内存,全新锐龙 AI Max+ PRO 495 把统一内存上限提升至192GB,CPU、GPU、NPU 共享同一内存池,无需额外独立显卡,单机就可以承载27B 乃至千亿级参数模型的本地推理,让开发者工作站具备本地运行前沿开源模型的硬件基础。
苏姿丰曾提出:“ AI PC 不是云端 AI 的替代品,而是下一代个人计算的基础设施。”蒋涛认为,软硬件的成熟,让“ PC 服务器时代”不再是概念。
两大 Token 自由:从按次付费,转向一次性硬件投入
当大模型可以稳定在本地设备运行,最大的变化不是实现零成本,而是彻底重构成本结构:从持续不断按次计费的云端账单,转变为一次性硬件投入,由此诞生两个关键的自由——开发 Token 自由、应用 Token 自由。
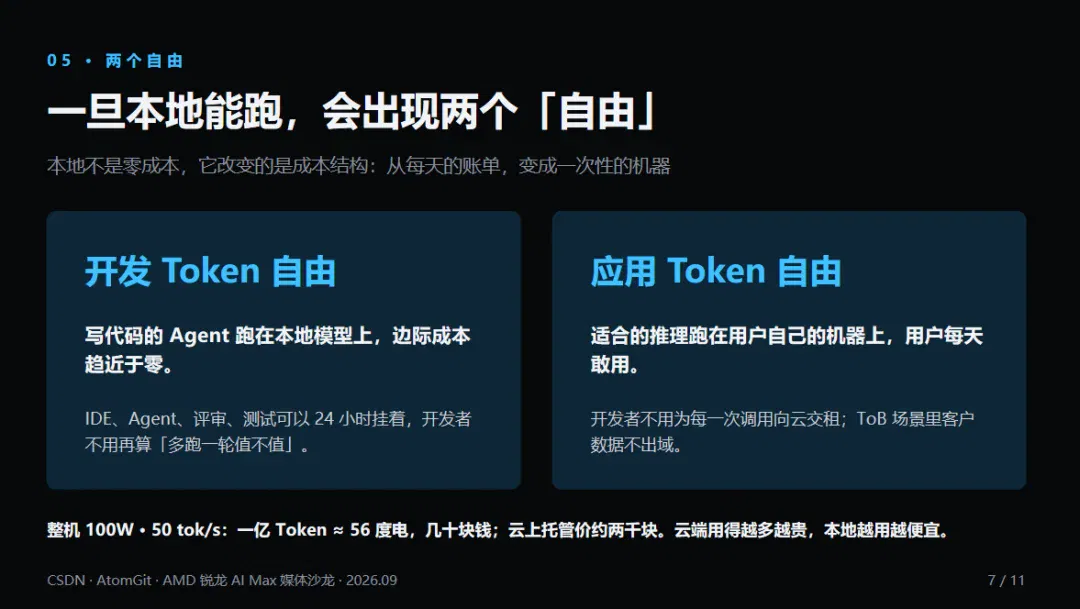
开发 Token 自由,面向开发者群体。代码 Agent、代码评审、自动化测试等工作负载部署在本地模型,推理边际成本趋近于零。开发者可以把 IDE、各类 Agent 全天挂起,不再需要反复权衡“多跑一轮AI到底值不值”。开发者不需要为每一次调试、每一次实验向云端支付 Token 租金,极大释放试错空间。
应用 Token 自由,面向业务和终端用户。 将适配的推理负载下沉到用户本地机器,用户不用再担心 AI 越用钱花得越多。尤其 ToB 行业场景,还天然满足客户数据不出域的硬性合规要求。
蒋涛现场算了一笔账:整机功耗100W,生成速度50tok/s 条件下,生成一亿 Token 大约消耗56度电,硬件侧电力成本仅几十元;同等规模调用,云端托管的市场价格大约两千元。云端模式用得越多开销越高;本地模式恰恰相反,越频繁使用,单位 Token 成本越低,长期价值就越明显。
两大 Token 自由打开之后,产业会迎来“人人程序员,行行炼模型”的新局面。蒋涛提出一个观点:AI 应用的大规模爆发,并不会发生在模型能力抵达巅峰的那一刻,而是发生在三件事同时成立的时候——模型能力跨过可用线、使用成本下降一个量级、分发运行生态全部就位。Web 互联网爆发的是网站,移动互联网爆发的是App,这一轮本地AI浪潮,将会爆发海量垂直AI应用。 所谓“人人程序员”,代表开发门槛下沉,懂业务的人也能够参与软件创造。
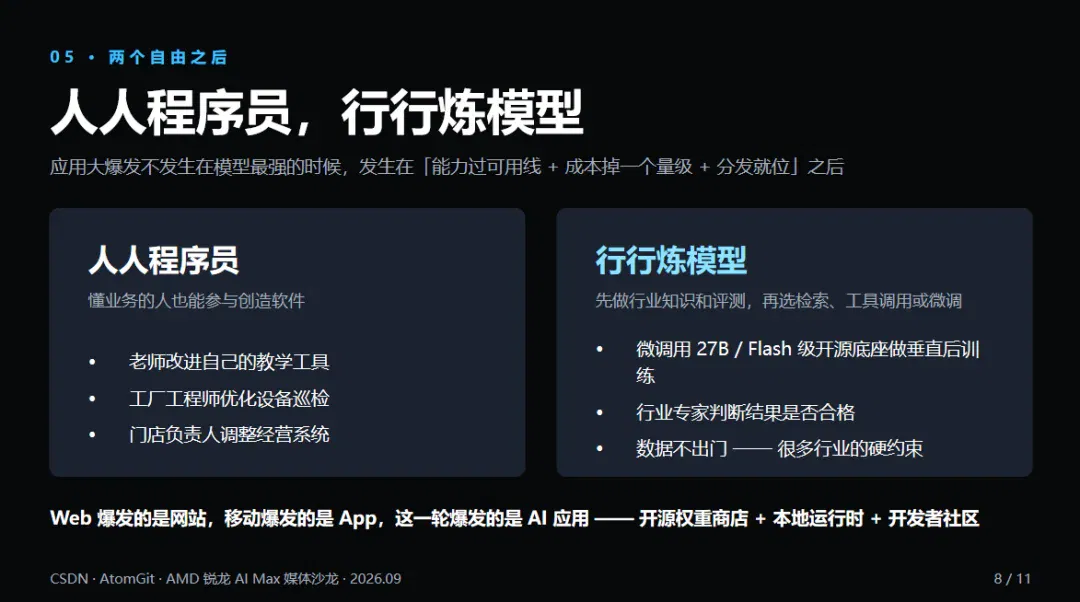
一线教师可以定制教学 AI 工具;工厂工程师可以搭建设备巡检智能体;门店运营人员可以迭代经营辅助系统,不再完全依赖专业开发团队。 所谓“行行炼模型”,意味着垂直行业可以基于开源底座做后训练、微调迭代。行业专家主导行业知识梳理与效果评测,选用27B、Flash 级别的开源底座做微调,业务原始数据全程保留在本地,满足很多行业数据不能外传的硬性约束。
“不是让所有人都去预训练千亿基座,而是每个行业,都有能力基于开源模型,炼出属于自己行业的专用模型与智能体。”蒋涛表示。 CSDN 与AMD 协同共建完整软件栈,补齐本地 AI 生态短板 硬件跑得起模型,只是走完一半路程,软件生态才是真正的门槛。 蒋涛直言,Ollama 这类海外工具虽然可以在锐龙 AI Max 硬件上运行,但并不完全适配国内开发者需求:模型仓库位于海外,国产开源模型上线更新滞后,缺少针对锐龙整机的版本管理,没有对接国内开发者服务工作台,本土化体验存在明显短板。
针对痛点,CSDN‑AtomGit 将和 AMD 协同,围绕运行时、调度服务层、开发者工作台三件事,打造面向国内开发者的 AI OS 软件体系。
第一,本地化模型运行时,复刻本土化 Ollama 体验。基于 AtomGit 开源模型仓库,平台现存1138个开源模型全部可供调用。针对锐龙 AI Max+395、PRO495 整机预先完成量化版本、上下文参数、镜像包实测适配,开发者一条命令即可启动模型,完全保持开源中立,不重复造轮子。
第二,TaoToken 模型调度服务层。原本可以通过一个 API Key 调用上百款云端模型,未来实现本地、云端模型统一接入同一套接口。硬件能够承载的任务就在本地完成;本地算力不足以处理,则在用户授权、遵从数据策略的前提下自动上云,开发者业务代码无需改动。AMD 企业混合部署实测,Token 综合成本可以下降约43%,接下来团队将针对个人开发者工作站完成同样的实测验证。
第三,AtomCode、InsCode 开发者工作台。AtomCode 是100%开源本地优先编码Agent内核,支持灵活替换底层模型,项目本身仅由3人小组,118天迭代41个版本完成,几乎全部依靠AI研发完成,是硅基时代的真实样本;InsCode 桌面工作台实现对话即编程,支持代码 Diff 审阅、三级权限审批,在锐龙 AI Max 整机开箱即用,开机就具备模型、Agent 与完整工作台能力。
蒋涛透露,项目第一步会选定两三款锐龙整机,选定若干主流开源模型版本,用真实的开发任务测试成功率、推理速度与稳定性,全部实测结果公开到 AtomGit 社区,给到国内开发者可复用的参考基准。
理性看待边界,本地AI不等于万能解药
演讲最后,蒋涛明确提出三条边界约束,避免行业对本地 AI 产生不切实际的幻想。
第一,基座大模型预训练,依旧属于超算数据中心的业务范畴。本地 AI 爆发的是推理、微调、Agent 应用,并非替代前沿实验室做大模型预训练。
第二,硬件“能够跑”不等于“好用”。DeepSeek‑V4‑Flash 低比特版本就需要上百 GB 内存。2026‑2027年,真正大规模普及的群众模型是27B 参数这一档;预计到2028年,才会逐步走向70B 稠密或者更大激活规模MoE模型的普及。
第三,生态战争远没有结束。CUDA 依然是行业默认的开发环境,ROCm 想要成为“ PC 服务器时代的 Linux ”,离不开开箱即用的工具链、中文教程、完整社区,这正是 CSDN 与 AMD 接下来协同攻坚的重点方向。
把 Token 自由,变成中国开发者桌上的现实
互联网浪潮中,x86商品服务器让搭建网站这件事走向普惠;今天,大模型浪潮把强大智能能力放到个人本地设备,高频AI应用迎来全新发展土壤,尤其是语音这类高交互、高 Token 消耗的场景,端侧具备巨大潜力。
5400万 CSDN 注册开发者、1200万 AtomGit 用户,每天产生接近2000亿 Token 调用,代表着国内AI开发真实旺盛的需求。锐龙 AI Max+395、PRO495 系列提供硬件底座;本地化运行时、统一调度服务、开发者工作台补齐软件短板。一半在 AMD 硬件,一半在 CSDN 开发者生态。
“我们希望,把‘开发 Token 自由、应用 Token 自由’,从行业热词,变成明年每一位中国开发者桌上触手可及的现实。”蒋涛在演讲结尾这样说道。
文章来自于"CSDN",作者 "CSDN"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
AMD想让人人“Token自由”? (opens in a new tab)
“AI PC是个人计算的基础设施,而非云端AI的替代品。”
黄仁勋刚走,苏妈就来了 | 附演讲全文 (opens in a new tab)
黄仁勋刚走,苏妈就来了。 这是 AMD 第一次把 AI 开发者大会搬到中国。苏姿丰没穿皮衣,开场第一句话是冲着全场喊:「你们兴奋吗?」台下站满了人,连过道都挤不动。 AMD 在中国卖了三十多年芯片,但这次不太一样。苏妈带着 ROCm、八大实操工作坊、还有一整个开源生态来,还顺手把上海研发中心的家底亮了出来:它是 AMD 全球最大的研发中心之一。 她给了一个数字:未来几年,全球 AI 活跃用户将超过五十亿。 苏妈在现场花了大段篇幅讲一件事:大语言模型「问一个问题、得一个答案」的时代正在翻篇。 「我们每个人可以拥有 5 个智能体、10 个智能体,或者 100 个智能体。想想你能多做多少事情。」 要

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。