MiniMax H3 的 24h AI 直播火了,但我们搓出了更炸裂的东西!
前两天刷 X 的时候,一条 Twitch 直播的录屏给看傻眼了: FAL 工程师 Rehan Sheikh 将 MiniMax H3 Max 接入 Twitch 直播流,搭建了一个由模型持续生成内容的频道,并把它称为「跨维度电视」。
前两天刷 X 的时候,一条 Twitch 直播的录屏给看傻眼了:
FAL 工程师 Rehan Sheikh 将 MiniMax H3 Max 接入 Twitch 直播流,搭建了一个由模型持续生成内容的频道,并把它称为「跨维度电视」。
这个频道不依赖预录节目,而是根据 H3 Max 按片段生成画面和声音,再经过编码、审核和缓冲后推送到直播流中。截至本文发稿,这条录屏的观看量已经接近 350 万次。
紧接着,另一位 FAL 工程师 Alex Koumpas 在 Twitch 开了一个频道,标题简单粗暴:Chat Directs the Show with MiniMax H3 Max,整个系统的逻辑是从弹幕中筛选可执行的指令,并将其中一部分转成下一段视频。
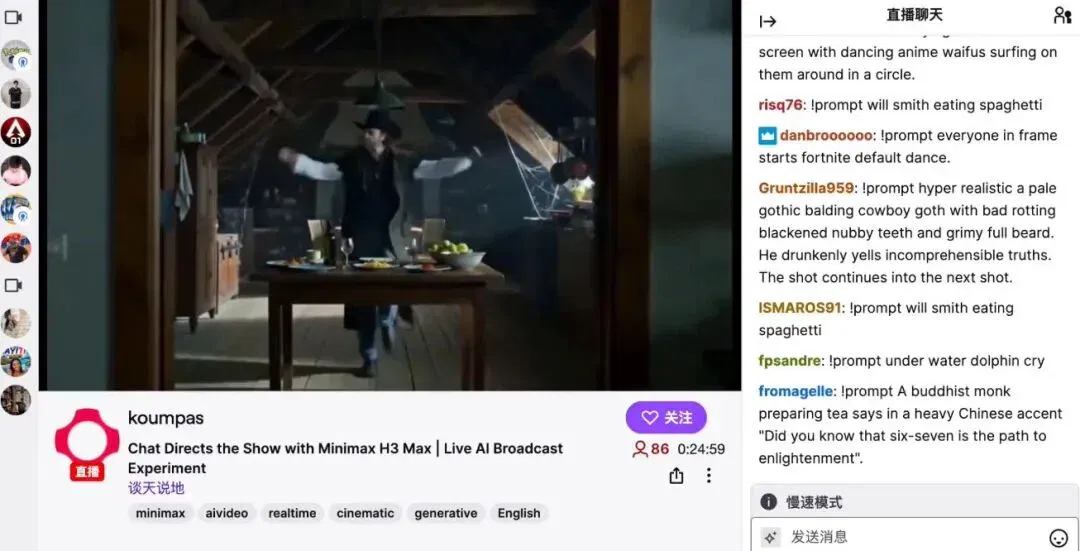
随后,知名开发者 Pieter Levels 上线了一个 24 小时 AI 直播网站:
可以 24 h 运行的 AI 直播间,因为 H3 的开源,变成了现实。
我当时的第一反应是:这帮人怎么玩得这么野。为什么国内没人跟上?
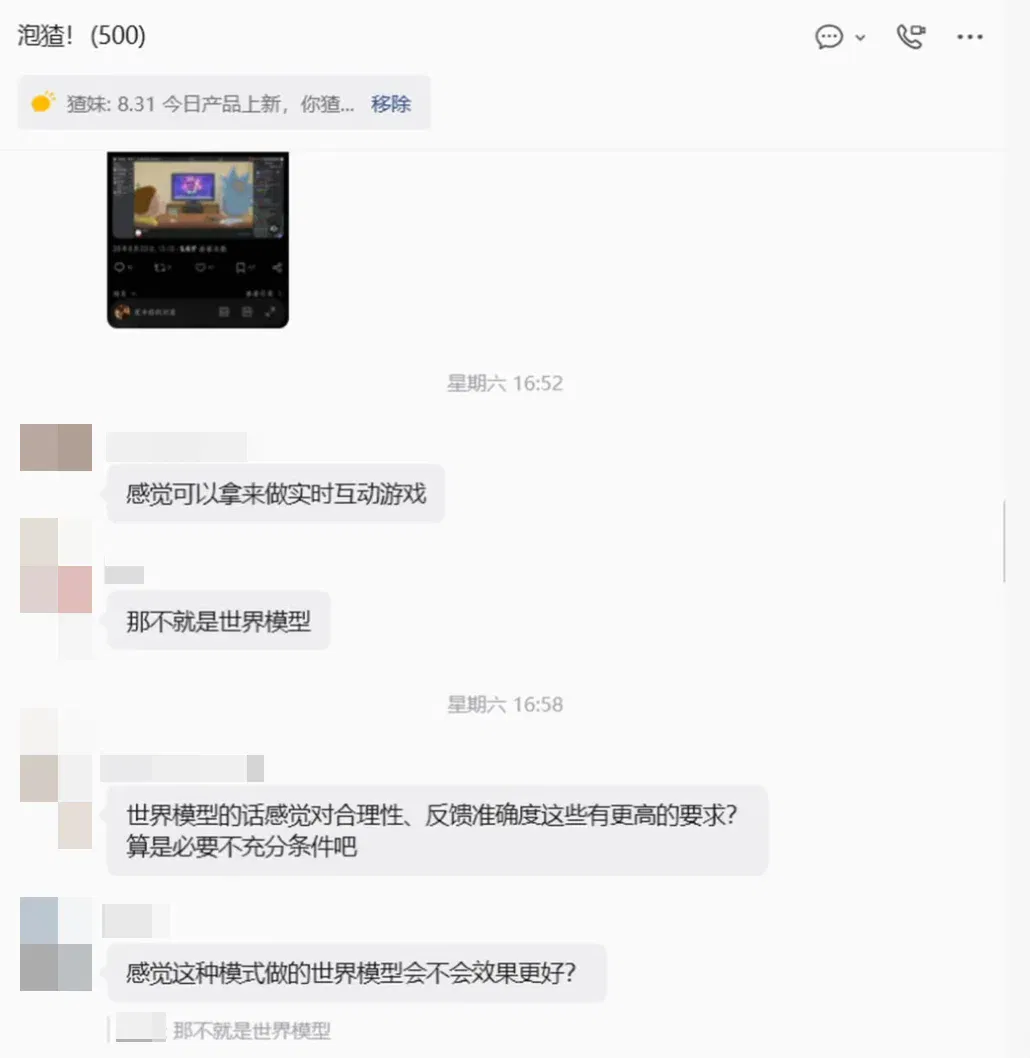
前两天,我就看到观猹群里有人在讨论这个:为什么不用 H3 Max 做一个生成式的世界模型?
弹幕进去,世界状态就变了,AI 实时把变化后的世界渲染成画面。
那为什么我们编辑部不来搞一下呢?
这个念头一冒出来,我们内部就开始了一场赛马:看看谁能搓出更有意思的东西。
24 小时后,五个可以 24h 运行的项目同时跑起来了。
为什么 H3 Max 能撑住这种玩法
在聊具体项目之前,你可能会好奇:为什么是 H3 Max,为什么是现在。
做过视频生成的人都知道,之前大部分模型生成一段 5 秒的视频,快的要十几秒,慢的要一两分钟。这个速度做短视频工具没问题,但做直播是不可能的。
用 AI 视频模型做直播的核心逻辑很简单:上一段视频还在播的时候,下一段必须已经准备好了。否则观众看到的就是黑屏或者转圈。
H3 Max 解决了这个门槛:5 秒、768p 的音视频,生成时间不到 3 秒。生成速度快过播放速度,中间还能留出余量给内容审核、编码和推流。
这个速度是怎么来的?
得益于 MiniMax H3 的开源,fal 在开源版本基础上做了后训练和推理优化:加入了新数据和可验证强化学习,同时针对自有推理基础设施做了适配。
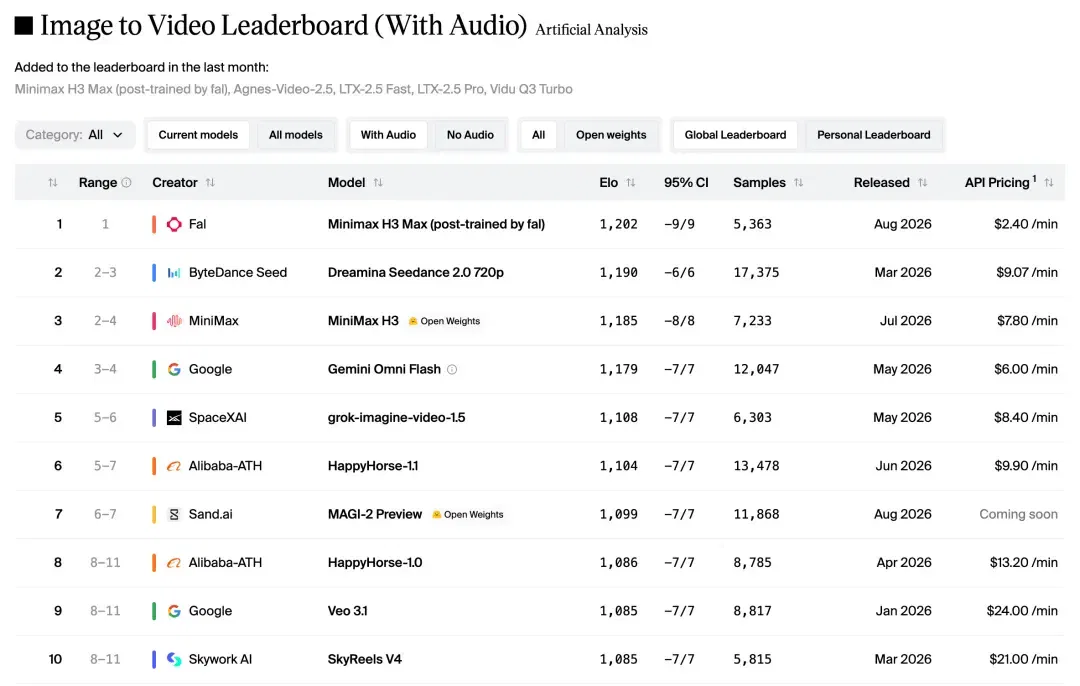
最终 H3 Max 的吞吐量大约是原版 H3 的 35 倍,目前在 Artificial Analysis 和 Design Arena 的图生视频榜单上排名第一。
另外一个关键能力是 H3 的原生音视频同步生成:生成的每一段内容拿过来就能直接播,不需要额外的音频合成环节。
得益于 H3 的音画同出,加上 H3 Max 更快的生成速度和原生音视频输出:
“弹幕进来,视频和语音出去,观众实时看到”——这条链路,就真正跑通了。
24 小时赛马,五个项目同时上线
说回我们编辑部的内部 Agent 赛马,规则非常简单:
每个人选一个自己最想做的方向,24 小时后看成品。
唯一的要求,就是自己开发一个 Agent,然后用 MiniMax H3 Max 做视频生成,用上一段视频的最后一帧抽出来,作为下一段视频的首帧输入来保证画面连续性。
最终跑出了五种不同的交互方式和内容形态:弹幕互动、连续直播剧、世界模型、影游互动和数字人直播。
一、弹幕梗工厂:发一条弹幕,AI 秒变视频梗。
这是最轻量的一个项目。
逻辑很简单:观众在弹幕里打一句话,比如「橘猫飞跃大峡谷」或者「霸王龙在星巴克喝咖啡」,AI 直接把这句话变成一段 5 秒的视频梗,投到页面的瀑布流上。
实测下来,4 条真实生成的视频全部成功上屏,合计视频成本 4.95 元。
这个项目验证了一件事:弹幕可以直接变成视频内容,而且成本可控。
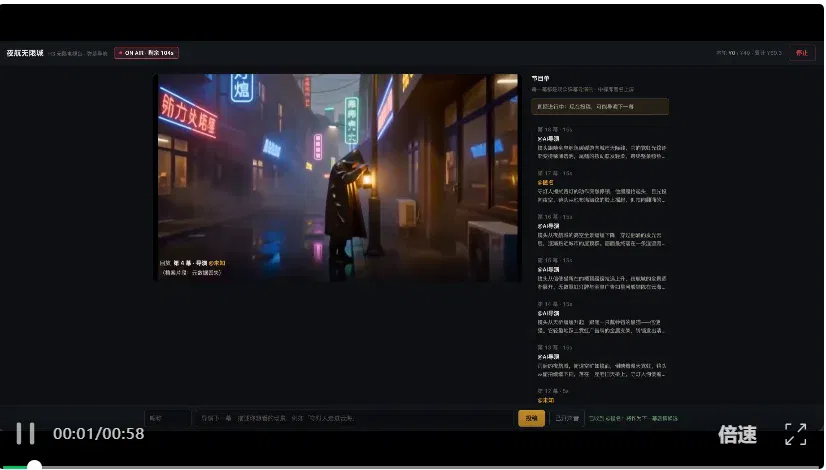
二、H3 无限电视台:观众当导演的 AI 连续剧
这个项目是一个连续剧集式的 AI 直播:
观众的弹幕不是变成独立的视频,是被导演 Agent 熔铸进一条连续的叙事线。
我们给这个电视台,先写了一份世界观圣经,叫「夜航无限城」。导演 Agent 会从弹幕池里挑选素材,判断哪些内容可以融入当前剧情,然后生成下一幕。每一幕 5-15 秒,末帧接力缝合,画面连续播放。
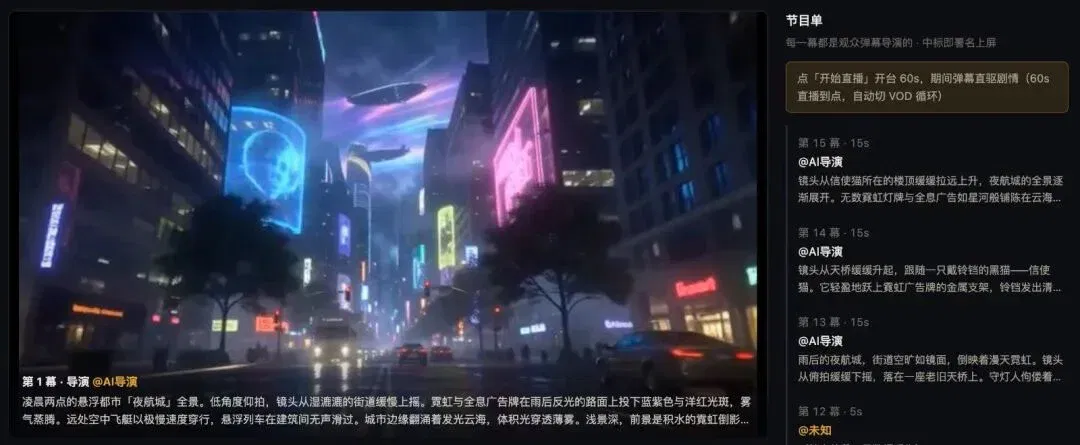
被采纳弹幕的观众名字会出现在画面角标上,标注为「本幕导演」。
如果想换一个完全不同的频道,只需要改掉世界观文件就行。换一份设定,就是一个新台。
三、生成式世界:用 H3 做一个世界模型
这个是我个人最兴奋的项目,也是群里那个「为什么不做世界模型」的想法落地的形态。
它的设计思路跟电视台不一样:电视台是线性叙事,有剧情推进。
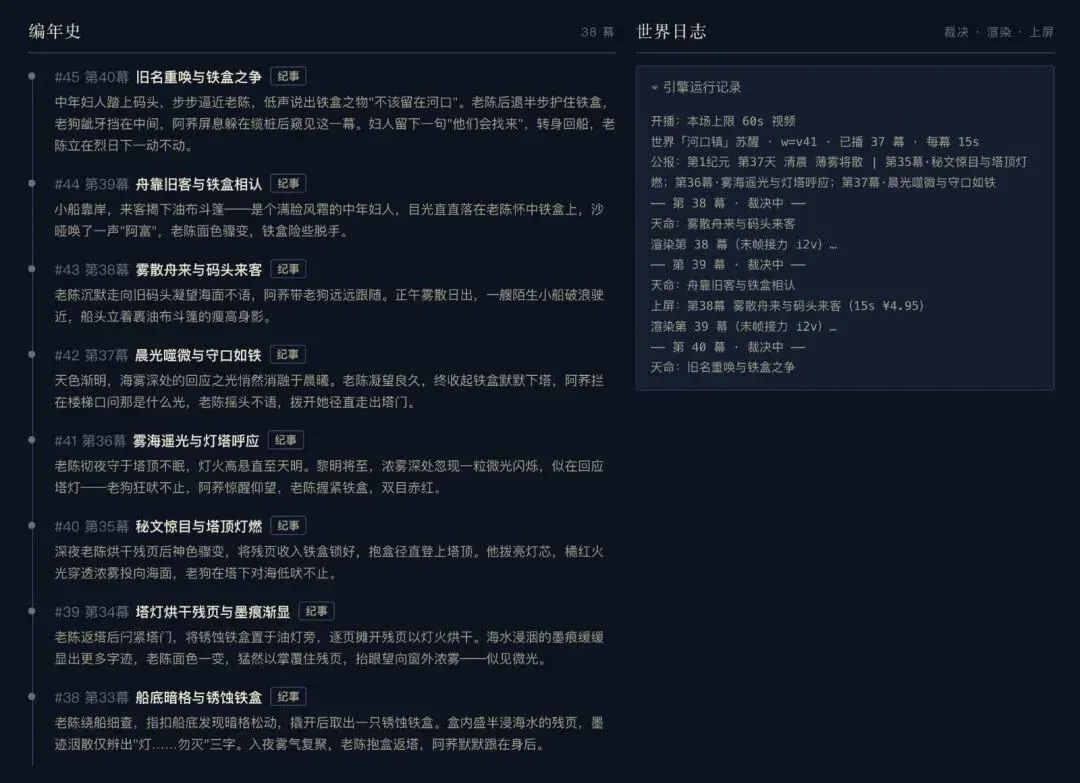
生成式世界是一个有状态的虚拟世界,观众的弹幕被称为「神谕」,每一条神谕都可能改变世界的状态。
世界有四层状态:时空、地理、生灵、因果。所有状态变更都记录在一个 append-only 的事件溯源账本里。
神谕进来之后,裁决 Agent 会做宪法审查(有些操作是被禁止的,比如直接毁灭世界),通过审查的神谕会被合并进世界状态,生成新的场景描述,然后 H3 Max 把新的世界状态渲染成画面。
我们用「河口镇」作为世界种子做了实测:3 幕连跑,合并了 2 条神谕,驳回了 1 条违宪神谕,世界状态从暴雨演化到小雨再到清晨,画面连续。系统还会自动更新编年史和世界公报。
不过,H3 Max 不是真正的世界模型,跨上下文一致性,靠的是末帧结合注入 Prompt 的近似方案,角色偶尔会变脸。
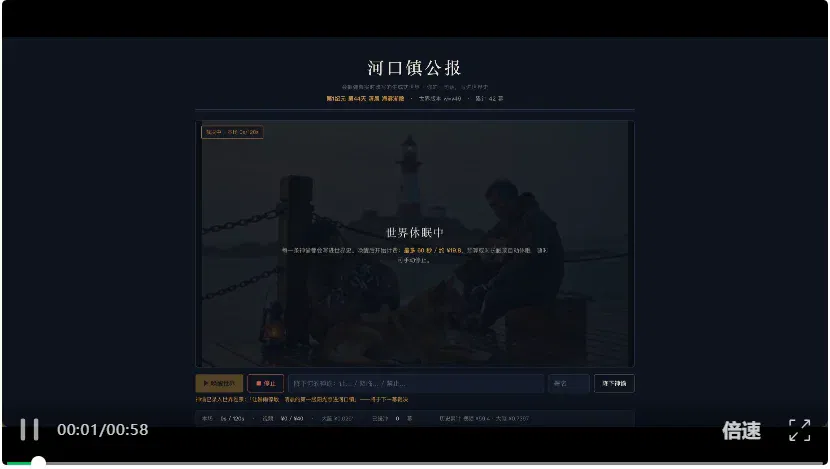
但作为一个 24 小时搓出来的世界模型原型,这个效果已经远超我的预期。
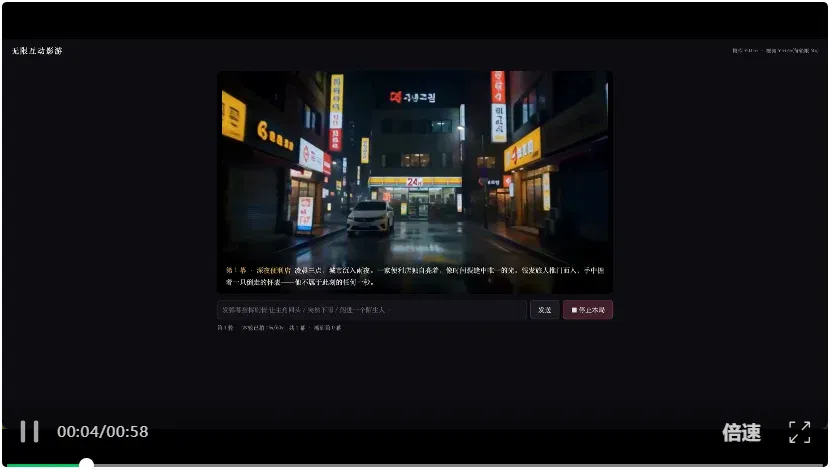
四、互动影游
这个灵感参考了《完蛋!我被美女包围了!》。
互动影游做的是回合制的分支叙事:看一段视频,读一段旁白,选一个走向,然后以上一幕末帧为首帧继续拍。
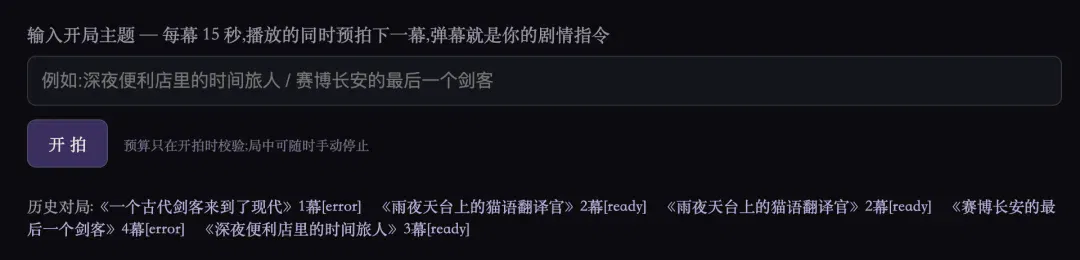
有点像早年间的 FMV 游戏,但所有内容都是实时生成的,每一次选择都通向一个从未存在过的画面。
除此之外,它还有一个自动连拍模式,AI 自己随机选走向连续拍摄。
五、点菜直播间
另一位同事开发的点菜直播间则走了一个完全不同的路线。
它模拟了一个竖屏直播间,有一个叫小灶的数字人主播,观众点菜(发弹幕说想看什么),主播就演什么。
没人点菜的时候,主播会从推荐清单里自己挑节目整活,模仿打工人读台词,保证不冷场。
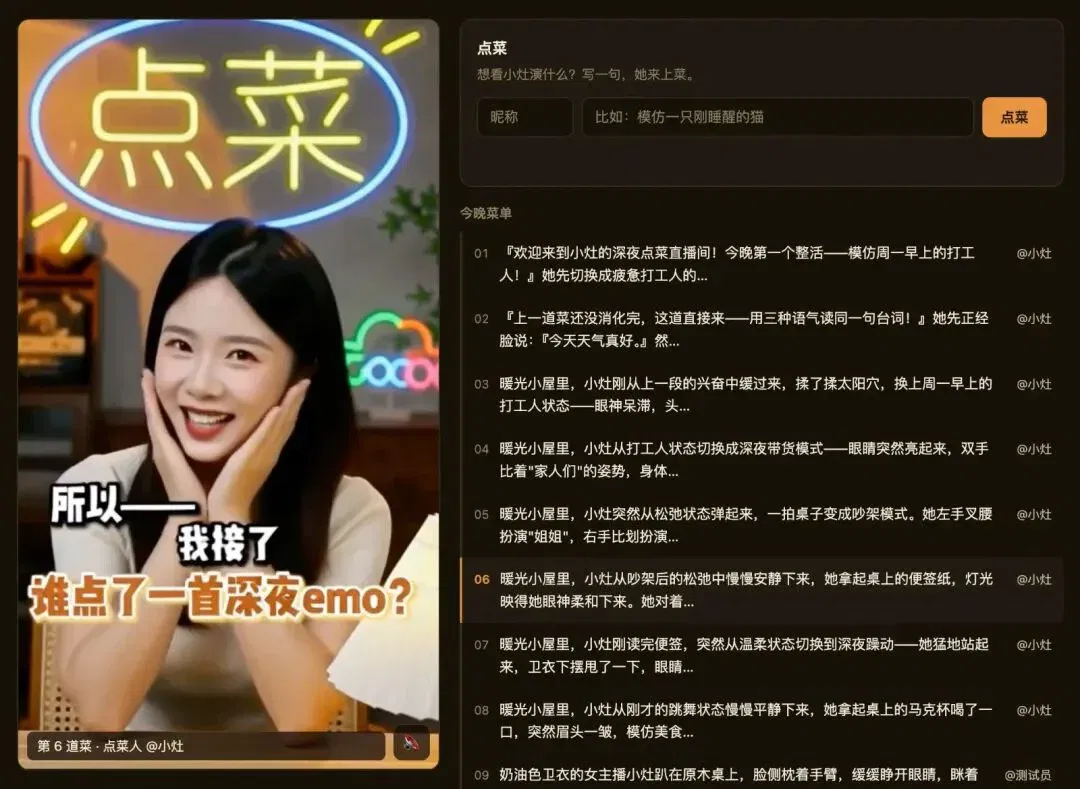
MD 不知道为什么电脑上的录屏软件没有录下来声音,前面四个项目其实都是有声音的,为了让大家看到声音,我用手机录了个屏:
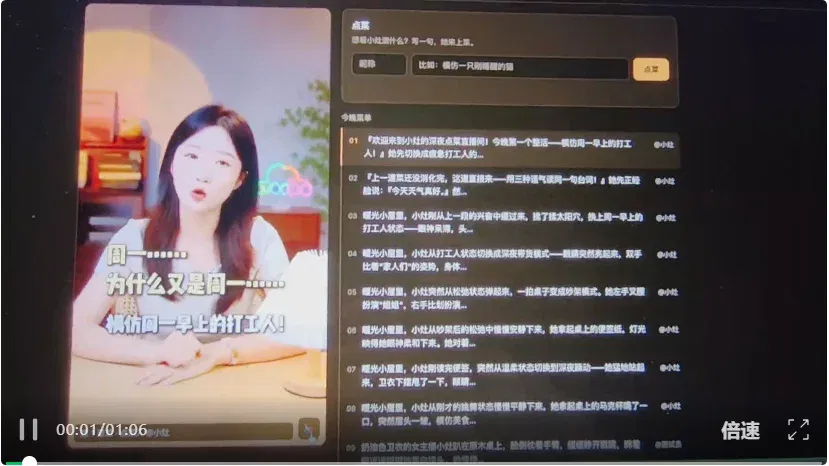
有意思的是,内部赛马我们采取了互投方式,点菜直播间被我们一致认为是最好玩且最实用的赛道!
这个项目我们还做了完整的产品化评估,结论是:
点菜式实时生成演绎,在现有直播产品里完全空白,如果不考虑生成成本,这是一个巨大的机会。
这些项目证明了什么
测试完我们开始思考一个问题:为什么这件事发生在 H3 生态里,而不是别的地方?
答案可能非常简单:
MiniMax 的 H3 很强,并且它们选择了开源。
H3 在达到 Seedance 级别的模型能力之后,没有选择闭源商业化,而是直接开源。
H3 开源三个多星期,下载量超过 2400 万次,产生了超过 300 个公开衍生模型,成为 2026 年全球下载量最高的模型。
正因如此,开源有机会让社区里具有创造性的开发者,不断对它进行优化:
fal 拿到开源权重之后,针对实时生成场景做了后训练和推理优化,搞出了 H3 Max。与此同时,FastVideo 沿着另一条路线,用蒸馏、稀疏化和硬件适配做出了 FastH3,在 8 张 B200 上 13 秒生成 15 秒 768p 视频。Running Hub 则打造了面向多场景需求的 MiniMax H3 480P。
每一个衍生版本都在解决不同的问题,每一个问题的解决又打开了新的应用可能:它们优化了 H3 的吞吐量、低分辨率成本和特定硬件部署,使直播、批量生成和低成本预览等场景更容易验证。
Rehan 的跨维度电视、Koumpas 的弹幕编剧室、Pieter Levels 的 24 小时直播站,以及我们这五个项目,全部是在这个开源生态里长出来的。
所以,我的感受是:
开源释放的不是算力,是想象力。
当模型的权重公开,当任何人都可以基于它做后训练和场景优化,创造力的涌现速度会远超任何一家公司的产品团队能规划出来的路线图。
当视频模型变成基础设施
过去我们谈论视频生成模型的时候,默认的使用方式是“输入一段描述,等一会,拿到一段视频”。它是一个工具,用完即走。
但 H3 Max 支撑的这些直播实验,正在把视频模型推向另一个位置:
它开始变成一种基础设施。就像数据库或者消息队列一样,视频模型被嵌入到一条持续运转的管线里,接收输入,产出内容,永不停歇。
顺着这个思路往下想,一些有意思的可能性就浮出来了:
比如现在抖音直播间里,观众给漂亮女主播送个礼物,然后主播就开始跳指定的舞蹈。
这个互动链条里,主播是真人,成本和时间都受限于真人的体力和档期。但如果有了 H3 Max 级别的实时生成能力,这件事似乎可以直接用 AI 实现:
未来,礼物或弹幕可以触发 AI 主播生成新表演,从而降低真人主播持续在线的压力:观众送礼触发生成,AI 主播实时演绎,永远不会累。
再比如,我们做的那个生成式世界项目,虽然现在还很粗糙,但它指向了一个让我们很兴奋的方向:
也许下一代的世界模型,不需要从头训练一个理解物理规律的巨型模型,而是可以用 Agent 做状态管理和决策,用视频模型做实时渲染,两者组合起来就能逼近一个「可交互的虚拟世界」的效果。
有意思的是,这些想法在半年前还是纯粹的脑洞。但当 H3 视频生成的效果优于世界模型,并且它的生成速度快过播放速度,这一切就有了可能。
这也是开源的最大意义:通过社区,探索 AGI 的边界。
开源让有算力和工程能力的开发者有机会做定制化优化,关于 AGI 的脑洞和现实之间的距离突然就变短了。
MiniMax 和开源社区一起把视频行业推到了一个新的位置:
H3 的开源不只是让更多人用上了一个好模型,它让整个视频生成的应用空间变大了,让过去不成立的产品形态开始成立,让过去算不过来的商业模型开始有了算过来的可能。
赛马完我们内部那五个项目,我的感受是:
它们虽然是 24 小时的产物,粗糙、有 bug、很多地方还需要打磨。
但它们让我确信了一件事:
当视频模型的速度和开放程度同时跨过临界点,会有大量我们今天还没想到的产品和创意,从社区里冒出来。
MiniMax 官方也上架了 H3 Max,期待看到更多人把 H3 Max 带进更多具体的场景里去创新。
那些还没有被定义过的产品,可能就藏在某个开发者今晚的一次突发奇想里。
文章来自于"特工宇宙",作者 "特工小师 特工小天"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
MiniMax H3 扩展开源生态:视频增强、蒸馏与商业授权 (opens in a new tab)
据报道,英伟达相关团队及Pika基于MiniMax H3探索高分辨率再生成和少步推理。文章同时分析其社区许可与单独商业授权路径;开放权重并不等于在所有地区、所有商业规模下均可免费使用。
反超Seedance 2.0!RunningHub发布增强版H3,1秒只要0.1 元 (opens in a new tab)
RunningHub基于MiniMax H3开源基座发布增强版H3 RH Enhanced,2000组实测显示其多镜头长时叙事能力显著优于Seedance 2.0,16镜以上角色崩坏率降低超60%,生成成本低至0.1元/秒。
李飞飞发布世界模型这天,Visko也让AI视频开起了直播 (opens in a new tab)
李飞飞旗下World Labs发布世界模型Atlas的同一天,Qing Yin创办的Visko推出世界模型Orbis并完成1000万美元Pre-seed融资,主打画面可持续运行并接受实时指令的Live Model。
MiniMax H3 团队 Reddit 上回应一切:2K 要开源,图像模型在路上,Apache 2.0 也在考虑了 (opens in a new tab)
8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。
等等,MiniMax H3不是刚发布吗?怎么就卷到几分钱的价格了…… (opens in a new tab)
救啊……谁成想,AI视频新模型的几分钱时代来得这么快啊???