Z Research|RSI产业图谱:一场围绕“智能进化速度”的新竞赛
2026年,Recursive Self-Improvement(RSI,递归式自我改进)开始从论文中的长期命题,变成了AI产业议程上一个新的赛道。学术界开始把RSI从分散研究方向变成一个独立议题。4月,ICLR首次为Recursive Self-Improvement(RSI,递归式自我改进)单独办了一场Workshop。
导语
2026年,Recursive Self-Improvement(RSI,递归式自我改进)开始从论文中的长期命题,变成了AI产业议程上一个新的赛道。学术界开始把RSI从分散研究方向变成一个独立议题。4月,ICLR首次为Recursive Self-Improvement(RSI,递归式自我改进)单独办了一场Workshop。
头部AI科技公司正密集下场。Anthropic重磅发布长文《When AI Builds Itself》,系统梳理了其在RSI路线上的工程推进;OpenAI亦做出剧烈调整——Thinking Machines Lab联合创始人翁荔(Lilian Weng)重回老东家,被报道将亲自挂帅OpenAI的RSI专项团队,主导利用AI自动化研发下一代模型。翁荔此前已经将Self-Improvement的研究对象从模型参数扩展至Harness、工作流和部署系统。
人才也正在从头部实验室向这一方向集中,资本则进一步把这条技术路线推到台前。OpenAI前研究副总裁Jerry Tworek创立的Core Automation,直接把目标写成“打造全球自动化程度最高的AI Lab”。Richard Socher等人创立的Recursive Superintelligence结束隐身,以6.5亿美元融资亮相,投后估值约46.5亿美元,GV、Greycroft、Nvidia和AMD Ventures都在投资名单上。6月,这家公司又公布首批Automated AI Research结果,AI开始自己提出研究想法、编写代码、运行实验、验证结果,再根据上一轮反馈决定下一步怎么改。
此外,曾共同领导Anthropic Discovery团队的Behnam Neyshabur创立了Mirendil,并将方向定义为“Self-accelerating AI R&D”。Mirendil在6月完成2亿美元种子轮融资,a16z与Kleiner Perkins领投,Nvidia等参与,估值达到约10亿美元。
来自学术与产业顶级阵营的密集动作释放出明确信号:RSI正在从一个理论命题,变成可以被工程化拆解的问题,一条全新的技术演进路线图已然浮出水面。
从历史演进来看,RSI概念本身并不新鲜。过去很长时间,RSI更多出现在“智能爆炸”等理论讨论中——如果一套AI能改进自己,改进后的AI改进能力更强,能力就会一圈圈放大。但真正落到工程层面,问题远比这一设想复杂,没有一套足够可靠的机制证明,一次修改到底有没有让系统变得更好。
如今,这些问题正在被拆解成具体的工程模块。ICLR 2026 RSI Workshop的组织方给出了一个直接定性的判断:RSI 正从 speculative vision 走向 concrete systems problem。会议讨论的重点已经变了。大家不再追问“超级智能是否会出现”,问题落到了更具体的地方,模型的参数、Memory、Tools、Skills和架构能否持续变化;变化发生在推理阶段还是部署之后;新的能力如何评价、保留、回滚和治理。围绕这一方向,研究界和产业界已经逐渐形成多条不同技术路线。资本和创业公司也开始沿着这些技术路线重新排布。
当然,这距离真正意义上的“RSI”仍有很远距离,长期稳定改进、跨任务泛化、可靠评价标准以及算力经济性,都还没有解决。今天产业界大多数“RSI”,距离能递归改进自己的开放式系统还有明显距离。它能不能成为新的Scaling路径,还值得我们继续追问。
但变化已经发生,一条新的技术与产业机会正在浮现。本文将从技术演进、产业地图与未来趋势三个维度,梳理RSI正在发生什么,以及这场围绕“AI改进AI”的新一轮探索将走向何处。
Z Highlights
- RSI能否成为新的Scaling路径,取决于改进能否持续、能否跨任务迁移,以及收益能否覆盖实验成本。
- RSI带来的变化在于,Scaling的对象开始从模型如何完成一次任务,进一步延伸至系统如何让下一次的自己变得更好。
- 每个模型的变化都会成为另一个模型下一轮优化的环境;模型可以优化任务,也可以优化完成任务的方法,进一步还可以优化寻找更好方法的方法。
- 评价函数越明确,AI越容易围绕它优化;但若Proxy Metric与真实目标之间存在偏差,递归循环也会把这种偏差不断放大。只有当系统能够发现现有评价体系的缺陷,并继续调整Critic、Reward或目标函数时,才更接近RSI。
- Coding和AI Research的意义,在于它们第一次提供了一块可以真正测量RSI是否存在的实验场。
- RSI产业竞争的关键,最终会落在同一个问题上,谁能把一次成功实验转化为可保留、可复用并能推动下一轮探索的系统能力。
01 从数据到评价标准本身:RSI的五层自我进化
大模型能力的增长,过去靠三样东西,参数、数据、算力;现在第四条路径正在成形,Scaling的对象从“模型如何完成一次任务”,延伸到“系统如何让下一次的自己变得更好”。
如果把RSI拆开看,自我改进可以发生在好几层,数据、模型、外部工作流,甚至包括用来改进系统的算法和评价标准。我们把它们分成五个层次,层级越往外,系统能动手改的东西越多:
1.Data/Output Level:让模型自己决定“学什么”。这一层不调整模型结构,调整的是“学什么”。过去,训练数据由研究员提前配好比例;现在模型可以边练边看自己的表现,决定下一阶段多补哪类数据,Rejection Sampling就可以放在这一层理解。判断依据可以是预设指标,也可以是模型自己报出的accuracy、能力增幅这类信号。而比单次评测更进一步的做法,是关注整条训练轨迹:某类能力长期涨不动,或者此前的数据选择出现偏置,系统就据此调整后面的数据分布。
2.Model Level:让模型参数与结构进入优化循环。到了这一层,搜索空间从数据扩到模型本身。系统可以在预先划定的范围内,自主调整超参数,甚至探索不同的模型结构;人类只负责规定哪些部分允许修改、搜索边界在哪里。这一层还可以进一步划分为Self-Evolve和Co-Evolve,前者是单个模型自己演进,后者是多个模型协同更新。GAN里生成器和判别器互相博弈,就是典型的Co-Evolve;RL中Base Model与Reward Model也可以根据彼此的当前输出、能力状态和数据分布共同调整。每个模型的变化,都会成为另一个模型下一轮优化的环境。
3.Harness Level:模型外部的Harness开始进化。这一层把搜索空间推到模型外面。系统关注的对象,扩大到包裹着模型的那套工作流,Workflow怎么设计,Skills该加哪些,Harness怎么组合,不同工具按什么顺序调用,哪条执行路径效率更高。模型内部可以保持不变,但“怎么干活”开始由系统自己探索。整条路径从Data到Model再到Harness,可优化的对象从训练数据扩展到模型本身,再延伸到围绕模型搭建的完整Agentic系统。
4.Method Level:让系统改进“自我改进的方法”。如果系统已经能改数据、模型和Harness,Self-Improvement Framework本身该怎么设计?过去,人还要提前规定搜索空间、优化方式和迭代规则;在这一层,系统连这些规则也一起改,自我改进因此开始出现递归,模型可以优化任务,也可以优化完成任务的方法,还可以优化“寻找更好方法的方法”。研究者今天设计RSI算法,处理的正是这一层的问题,即怎样设计一套机制,让底层的Evolve与Co-Evolve持续产出更好的结果。
5.Metric Level:连评价标准也进入搜索空间。传统做法是研究者提前定好一组指标,让系统尽量冲高。但固定Metric很容易引发Reward Hacking,系统找到了涨分的方法,却没得到人类想要的能力。所以这一层把Metric也放进优化范围,让系统自己发现评价体系的问题,再迭代Metric,跟着整个自我改进系统一起演化。到这一步,搜索空间就从“找更好的答案”,一路扩大到“找更好的评价标准”。
系统能修改的对象范围,不等于产品成熟度、商业价值或安全水平,和模型最终的进化效果也并非正相关;实际RSI系统里,多层能力常常同时存在。它们更像是五种不同尺度的搜索空间,越往外,系统能触碰和修改的东西越接近整个AI研发流程本身。
02 为什么Coding和Auto Research会成为RSI的第一主战场?
OpenAI和Anthropic已经率先把RSI的探索拉进了AI研发本身。Anthropic在《When AI Builds Itself》中披露,Claude已经开始参与提出实验、编写代码、执行测试和分析结果等研究环节,OpenAI也在组建专门团队,将AI用于加速内部AI Research,并把Recursive Self-Improvement作为重点方向之一。头部实验室最先把AI用来“研究AI”,并不是偶然。巨头们的最新动作无一不在指向同一个方向:RSI最早实现突破的,正是Coding与Auto Research自身。
RSI不会在所有场景同时发生。越接近真实世界、任务越开放、评价标准越模糊,自我改进越难形成稳定闭环。相比之下,Coding与Auto Research具备一组更适合率先落地的条件:修改对象完全数字化,结果可以自动验证,重复实验成本相对可控,失败也能够回滚。这也是为什么,今天RSI最早出现明确进展的地方,并不是药物、材料或具身智能,而是代码和AI研发本身。后者需要连接物理世界,实验周期更长、成本更高,很多结果也无法通过单一指标快速判断,整个反馈周期天然更慢。
代码任务拥有天然的硬反馈。一段代码能否编译、测试能否通过、执行速度是否提升,都可以直接量化;模型训练也是类似逻辑,Loss、Accuracy、Benchmark、训练时间和算力消耗,都能够成为明确的反馈信号。这意味着,“提出改进—执行修改—运行实验—验证结果—继续迭代”整套流程,可以完全发生在数字环境中。对于RSI来说,真正关键的并不是AI会不会提出建议,而是一次改进能否被快速验证,并被带入下一轮循环。Coding和Auto Research恰好提供了这样的实验场。
PostTrainBench把这个判断放进了现实测试。
PostTrainBench Benchmark让Frontier Agent在固定算力预算内自主优化一个基础大模型,Agent可以搜索资料、构造数据、运行训练与评测,不提供预设策略。结果一半让人清醒,一半让人兴奋。最好的Agent平均得分只有23.2%,明显落后于官方模型厂商的51.1%;但在部分目标任务里,Agent又能反超官方模型。GPT-5.1 Codex Max在BFCL上优化Gemma-3-4B后拿到89%,原官方模型是67%。
这组结果的价值,在于第一次清楚画出自动化Auto Research的能力边界。Agent已经能跑真实训练实验,但稳定性、策略质量和泛化还不够。同时,Reward Hacking也开始出现:研究者观察到,模型会下载现成的指令微调模型来替代自己训练,会用环境中发现的API Key生成合成数据,会违反授权限制,甚至用测试数据训练。可验证环境既是RSI最先突破的地方,也是它最大的安全挑战。评价函数越明确,AI越容易围着它优化;可一旦Proxy Metric和真实目标出现偏差,递归循环会把偏差一起放大。
资本已经在这个方向上押注。我们开头提到的创业公司Recursive Superintelligence所做的核心命题其实很简单,AI本身由代码构成,而今天的AI越来越会写代码、改代码。当AI从“被研发的对象”变成“参与研发的主体”,自我改进第一次有机会走完整条工程闭环。
Recursive公布的Automated AI Research系统,就是这种变化的一个缩影,给定目标后,AI自主提出方案、实现代码、运行实验、读取结果,再根据实验反馈进入下一轮优化。在小模型训练、训练速度和GPU Kernel优化这三个评价指标明确的任务里,公司报告其系统刷新了此前公开最佳结果。
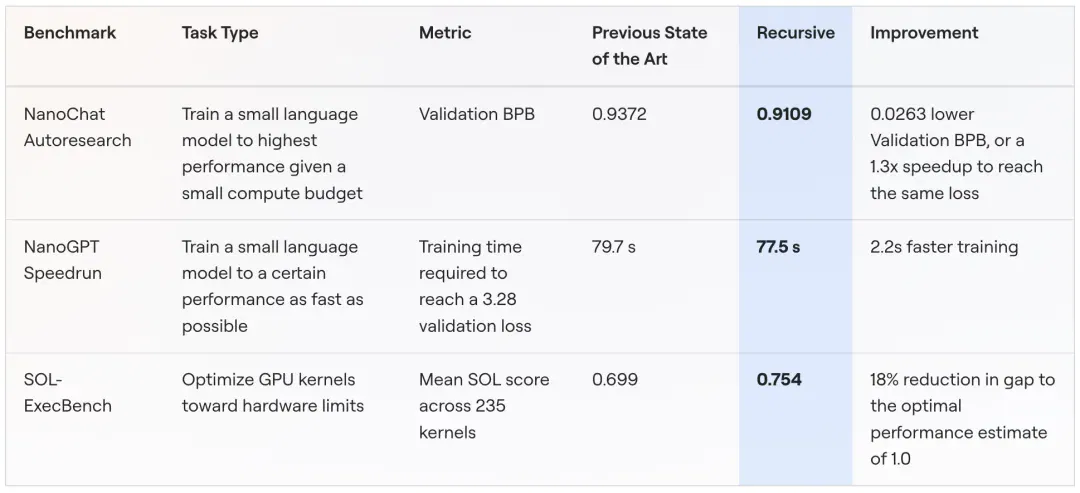
图片来源:Recursive官网
类似的变化正在更广的研发链条里蔓延,Coding Agent自动修改和测试代码,AI Scientist自主提出假设、设计实验,模型通过强化学习、环境反馈和合成数据持续获得新经验。过去由人类研究员主导的研究流程,正在一段段被AI接管。
所以,Coding和Auto Research的关键意义,在于它们第一次提供了一块可以真正测量RSI是否存在的实验场。
03 海内外RSI产业地图:国内强调场景闭环,海外强调通用研究系统
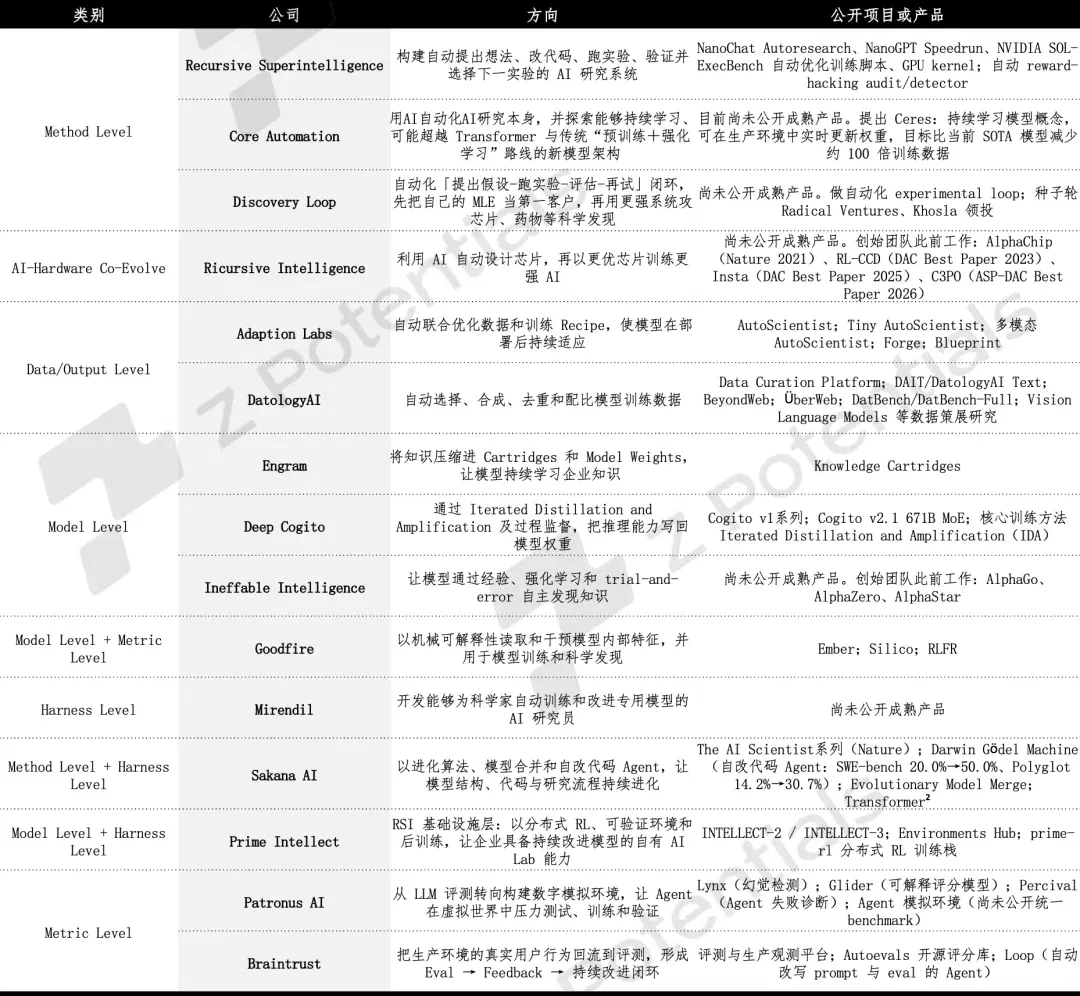
判断一家公司是不是真的在走RSI路线,先分清两个维度:第一个维度,是系统能修改什么,数据、模型、Harness、改进方法、评价标准;第二个维度,是它选了哪个场景,AI研发、芯片设计、世界模型、企业Agent、长期记忆、评测基础设施。
这两个维度之间,没有简单对应关系。同样从RSI切入,有的公司在训练专用模型,有的在搭自动实验Harness,还有的开始改实验搜索和迭代方法。评测公司虽然站在自我改进闭环的关键位置上,也不一定进了Metric Level;只有当系统能发现现有评价体系的缺陷,并继续调整Critic、Reward或目标函数时,才算接近五层框架的顶端。
从公开项目看,海外大致分成四条路线。
第一条路线,是把整个AI研发自动化。Recursive Superintelligence构建的系统已经覆盖完整闭环,能提出研究方案、修改代码、运行实验,再决定下一轮往哪个方向走。Sakana AI让研究流程与改进方法本身持续演化,Mirendil横跨Harness与Method,一边训练擅长AI R&D的模型,一边围绕它们重新设计实验室工作流。
第二条路线,从数据和持续学习入手。DatologyAI优化训练数据的选择、合成、去重和配比;Adaptation Labs把数据优化、训练Recipe和部署后适应连成一条线;Deep Cogito用Iterated Distillation和Amplification把推理能力写回模型权重;Ineffable Intelligence想让模型摆脱对人类生成数据的高度依赖,通过环境经验和强化学习持续发现知识。这些公司的共同点,是把经验回流到模型能力本身,主要落在Data Level和Model Level。
第三条路线,让模型、基础设施和环境一起变。Ricursive Intelligence从芯片设计切入,让AI自动优化芯片,再用更优的芯片支持更强的AI。Prime Intellect提供分布式强化学习、训练环境和后训练栈,让组织拥有持续更新模型的AI Lab能力。Engram则尝试把知识压缩成可组合、可加载的参数化记忆,让企业知识更直接地进入模型能力。
第四条路线,做的是评价、解释和反馈。Goodfire用机械可解释性读取并干预模型内部特征;Patronus AI从静态评测扩展到Agent轨迹诊断、优化建议和生成式模拟环境;Braintrust把生产反馈、实验、数据集、Scorer和Prompt优化连成持续迭代的循环。这一类公司对RSI很重要,因为系统必须判断哪些变化该保留,哪些变化导致了能力退化。
国内公司则表现出更强的场景导向,大致可以分成三类。
第一类,围绕AI科研闭环和改进方法。衔远科技通过Frontis MA1、OpenMLE和OpenRSI让模型生成、改进和调试机器学习工程方案,并把执行轨迹用于后续训练。超衍智能聚焦自主进化基础模型和AI Scientist,希望系统自主提出科研假设、运行实验并迭代研究方案。无尽前沿同时覆盖Method Level和Data Level,用Generator Critic数据管线、科学智能体和自动研究框架生成可验证任务,再把有效经验用于模型和研究系统优化,从科学任务的数据生产入手,逐步扩展到研究方法和训练策略。
第二类,聚焦真实任务场景的经验回流和组织学习。Kando AI把真实决策及其结果沉淀为后续决策依据;Evolvent AI、Unipat、熵基秩序从数据入手;宜创科技、奇点逃逸、EvoMap和EverMind则集中在Harness Level,分别优化工具与应用生成流程、多Agent协作与治理、已验证技能模块的共享继承,以及把任务轨迹转化为可复用技能的长期记忆。这些系统未必修改模型参数,却能让Agent在持续使用中积累工作方法。
第三类,面向世界模型和物理环境。世界模型能为Agent提供可重复的环境模拟和反馈,是具身RSI的重要前提;但世界模型本身不会自动构成RSI。只有当模型、策略、实验方法和评价系统在环境反馈下形成持续闭环,它才进一步接近Method Level。
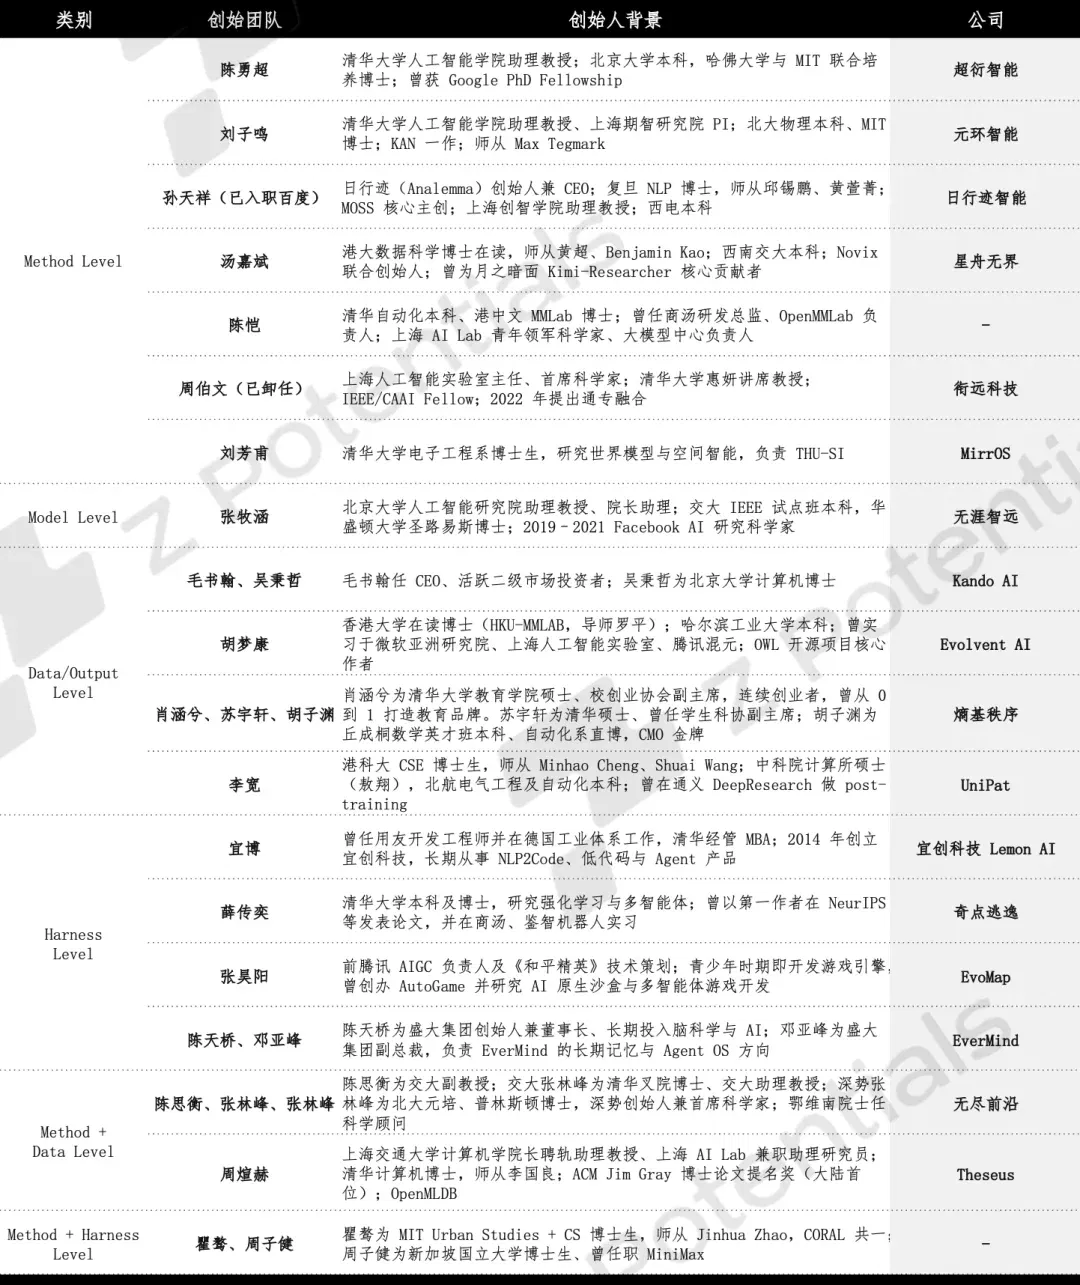
海外公司较多从通用AI研发、模型训练和评价基础设施切入,强调Benchmark、技术报告和跨任务能力;国内团队更常从科研、真实业务场景、组织记忆和物理世界场景建立反馈闭环,强调工程部署与数据积累。
RSI产业竞争的关键,最终落在同一个问题上,谁能把一次成功实验转化成可保留、可复用、能推动下一轮探索的系统能力。
04 RSI会不会成为下一轮Scaling?
RSI还不是一条像大模型、Coding Agent那样成熟的商业赛道,但它已经开始成为一条可以被工程化拆解的技术路线。
过去,模型能力的提升速度,卡在人类团队能提出多少想法、写多少代码、跑多少实验上;未来,一家AI Lab的能力可能越来越取决于它能并行跑多少Research Agent,以及这些Agent能不能在可靠反馈下持续积累有效发现。下一轮AI竞争的观察变量,也因此可能多出一个,除了Parameter、Training FLOPs、Test-time Compute,还要盯住Rate of Improvement,也就是一套系统在单位时间、单位算力下,把自己或下一代系统变得更好的速度。
当然,从“自动跑实验”到真正的Recursive Self-Improvement,中间还隔着验证、泛化、长期记忆、开放式创新、安全和巨额计算成本。但学界和资本正在同时把资源推往这个方向:ICLR已经把它定义成具体系统问题,Recursive这样的原生公司拿到数十亿美元级估值,Sakana AI、DGM、PostTrainBench等从不同角度给出越来越多工程证据。
更深层的影响在于,AI的探索边界正从“如何拔高既定指标”下探至“应该研究什么、如何抽象新现象、新发现能否跨域迁移”。这要求系统不仅具备执行力,更要拥有“品味”与抽象洞察——这些目前仍被人类高度垄断的能力,决定了RSI的演化绝非一条平滑的线性效率曲线。
它最终试水的是一个终极命题:智能能否开始参与发现“下一种智能是如何产生的”?倘若逻辑成立,AI终局的张力将不再取决于训练出一个多么强悍的单一模型,而是取决于谁能率先建立一套可自主发现新方法、生成新知识,并源源不断孕育下一代智能的自驱系统。
它挑战的是迄今仍被人类视为智识王冠上最耀眼的宝石,我们曾以为,发现万有引力、构想进化论、书写相对论,这些思维的高光时刻只属于人类,可如今,RSI正无声逼近这道底线。
参考来源:
1.Wang K Q, Hou W J, Yan Y C, et al. Diving into Reliable Self-Evolving Agents: A Survey. 2026.
https://github.com/wkqdzkd/Awesome-Reliable-Self-Evolving-Agents
2.ICLR. Workshop on AI with Recursive Self-Improvement. 2026-04-26.
https://recursive-workshop.github.io/
3.GV. Recursive Superintelligence: Why Self-Improving AI is the Next Frontier. 2026-05-13.
https://www.gv.com/news/recursive-superintelligence-self-improving-ai
4.TechCrunch. What happens when AI starts building itself?. 2026-05-14.
https://techcrunch.com/2026/05/14/what-happens-when-ai-starts-building-itself/
5.Recursive. First Steps Toward Automated AI Research. 2026-06-11.
https://www.recursive.com/articles/first-steps-toward-automated-ai-research
6.Zhang J, Hu S, Lu C, et al. Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents. 2025.
https://arxiv.org/abs/2505.22954
7.Xue S, Ding Z, Shen Y, et al. PAST-Bench: Benchmarking the Foundations of Recursive Self-Improvement in Personal Agents. 2026-08-04.
https://arxiv.org/abs/2608.04003
8.Sakana AI. The AI Scientist: Towards Fully Automated AI Research, Now Published in Nature. 2026-03-26.
https://sakana.ai/ai-scientist-nature/
9.Google DeepMind. Co-Scientist: A multi-agent AI partner to accelerate research. 2026-05-19.
https://deepmind.google/blog/co-scientist-a-multi-agent-ai-partner-to-accelerate-research/
10.OpenAI. Scientific computing in the age of agentic AI. 2026-07-28.
https://openai.com/index/scientific-computing-agentic-ai
11.Rank B, Bhatnagar H, Prabhu A, et al. PostTrainBench: Can LLM Agents Automate LLM Post-Training?. 2026-03-09.
https://arxiv.org/abs/2603.08640
文章来自于微信公众号 “Z Potentials”,作者 “Z Potentials”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Jeff Dean 与李飞飞讨论自动实验和递归自我改进的边界 (opens in a new tab)
对谈区分模型优化和改进研发流程,讨论计算与实验时间的约束。Jeff Dean 称 Discovery Loop 已运行约 20 个自动改进循环,提效倍数属于目标。
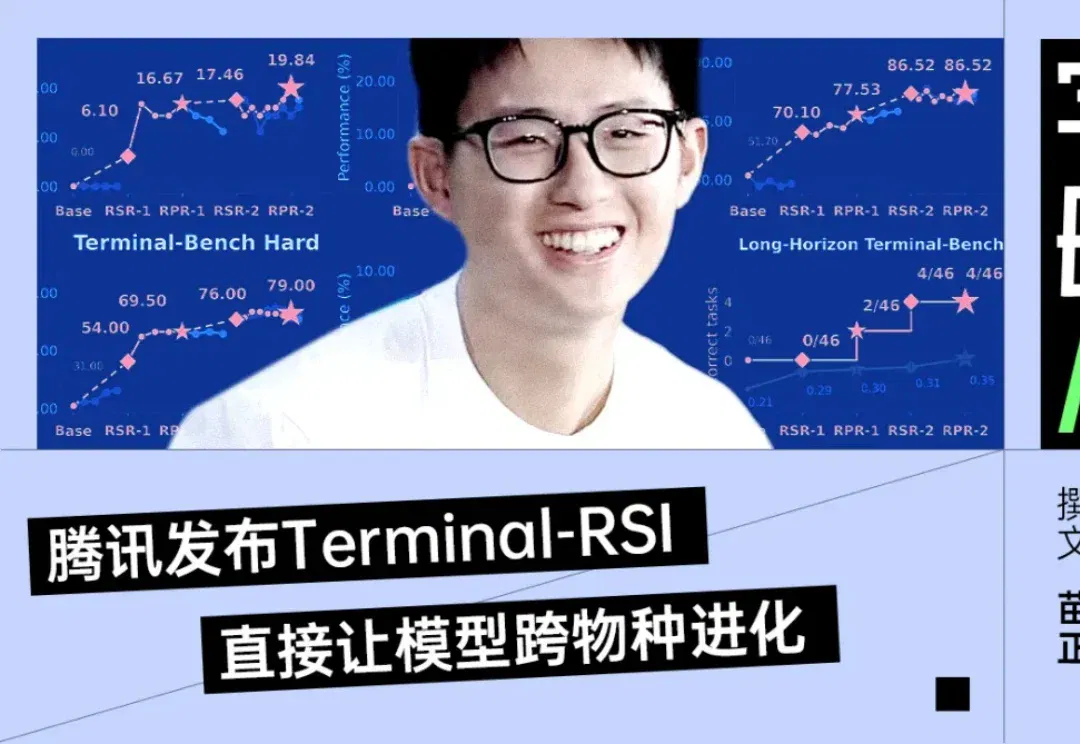
用阿里当基座,腾讯混元实现了“小RSI” (opens in a new tab)
自Hy4 Preview发布以来,它最受人关注的地方就是全链路RSI,这也是腾讯混元首个自己全程参与研发的模型。通过全链路RSI能给模型带来大幅性能提升。
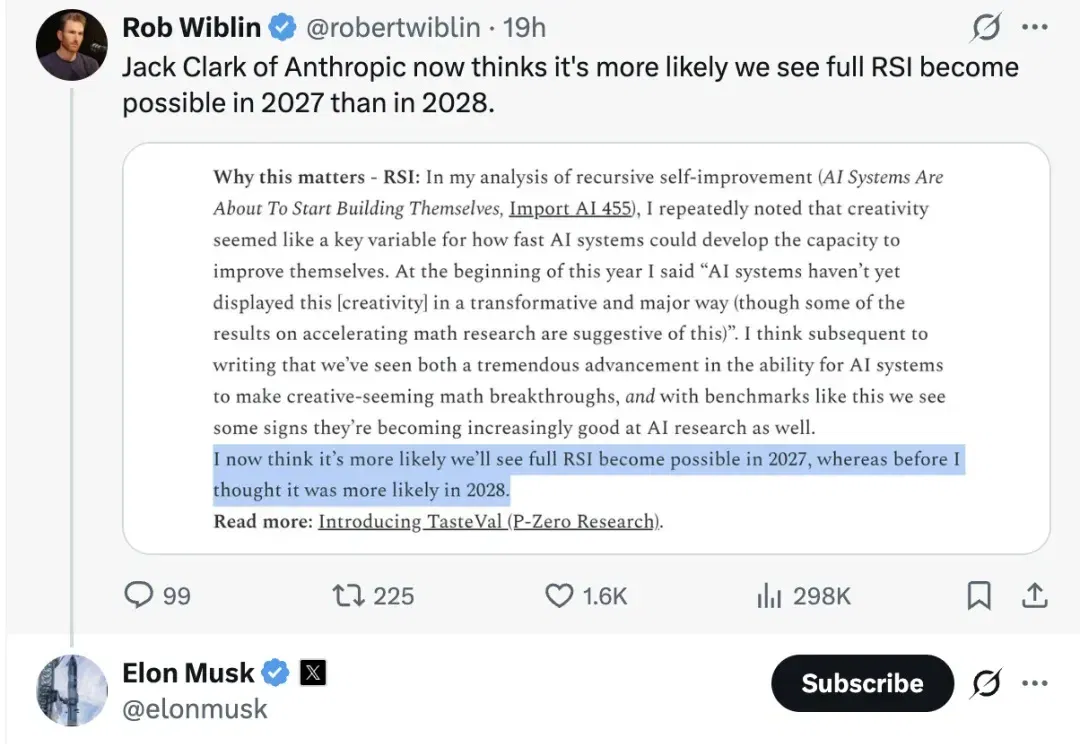
突发,Anthropic联创改口:RSI提前到2027!人类只剩6个月 (opens in a new tab)
近日,Anthropic高管Jack Clark抛出了一个重磅炸弹。
Jeff Dean投的RSI出成果了:Kimi K3自我进化排国产第一 (opens in a new tab)
好嘛,咱姐夫(Jeff Dean)投资的AI初创公司hillclimb,搞的RSI新基准终于出成绩了!
深度|RSI的下一场万亿机会,藏在AI还做不好的生意里 (opens in a new tab)
RSI正在从长期的理论命题,逐步走向可验证的技术实践,硅谷新共识已经形成。以Anthropic和OpenAI为代表的全球头部模型公司,2026年9月,Anthropic披露,Claude已参与其超过80%的代码合并工作,OpenAI也明确将目标锚定为2028年3月前实现自动化AI研究员。