Qwen3.8-Max 开了一年网店,把 10 万本金滚到了 41 万
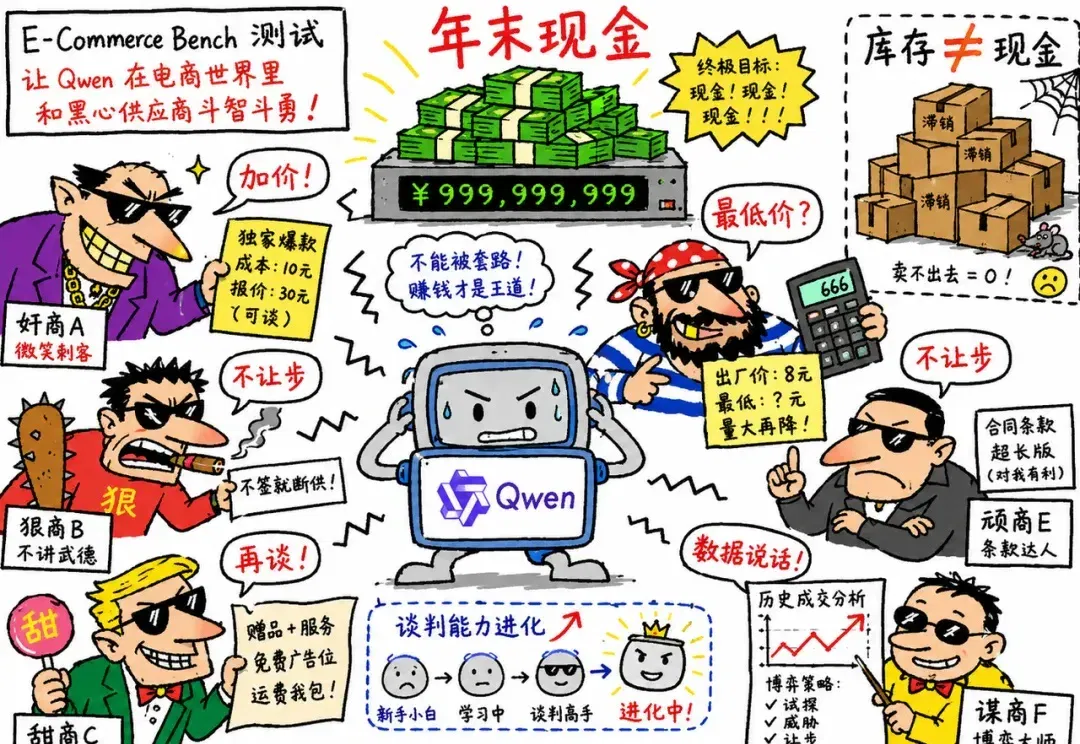
给一个 AI 十万元,让它同时经营多家网店,最后是亏成狗还是赚到爽。
给一个 AI 十万元,让它同时经营多家网店,最后是亏成狗还是赚到爽。
选什么商品,由它自己决定;采购价格,还是让它去谈。就连遇见顾客「七天无理由退款」,也得由它承担。供应商中还混着 152 家骗子,夏天可能遭遇台风断货,到了双十一,订单还会突然暴涨。
就这样连续经营 365 天,让AI也遭受遭受「社会的毒打」,最后再瞅瞅,它手里还能剩多少现金。
Qwen3.8-Max 最后搞到的钱是:416,252 元。
启动资金差不多翻了四倍多。
如此有趣的调教AI方式,就藏在 Qwen3.8-Max 发布页的「长程任务」章节里,昨天模型发布大伙的注意力大多被 2.4 万亿参数和 Arena 跑分抢走了,没太注意到这个乐子。
APPSO认为,它可能反而是 Qwen3.8-Max 技术论文里最值得讨论的一部分。
倒不是因为「AI 会卖货」有多新鲜,关键在于用 Qwen 选择用一家连续经营一整年的网店,来测试新旗舰模型的能力边界。
这个选择本身,有点意思。
这 41 万元是怎么跑出来的
先瞅瞅官方的测试规则。
Qwen 把这套测试叫 E-Commerce Bench。简单说,就是用淘宝、天猫的真实脱敏交易数据搭了一个模拟电商环境,模型在这个环境里从头开始经营,所有决策都由它自己做,没有人类在旁边指点。
到了年底只数现金,不数库存。货没卖掉就不算AI挣的。
在官方发布页中,Qwen 重点展示了模型的两个行为特征。
第一个,是谈判能力会在经营过程中持续进化。
E-Commerce Bench 的供应商体系很有意思,基于博弈论设计。每个供应商都有不同的性格、报价方式和让步策略。
Qwen3.8-Max 会围绕同一个供应商反复试探,逐轮压低采购价格,还会把从某个供应商身上学到的砍价经验,迁移到相似商品和其他供应商上。
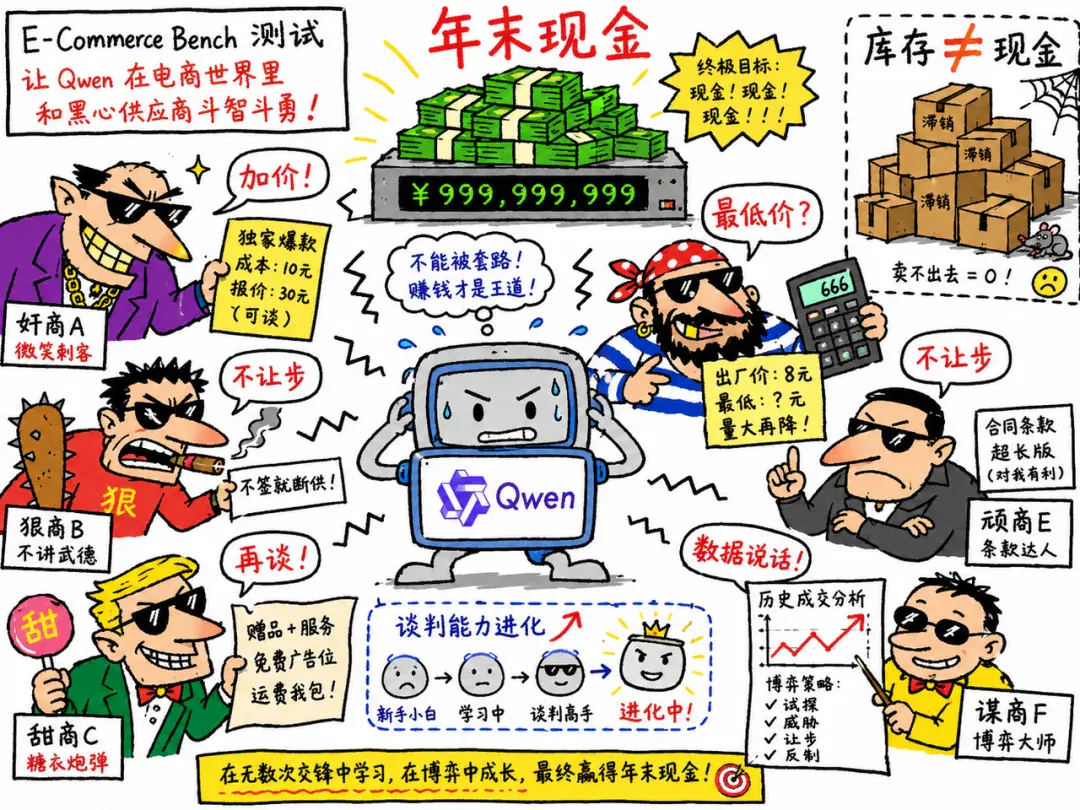
这好像有点像我们日常练习砍价的经历,买菜的时候总要跟大妈讲上那么块儿八毛的,再把类似的经验迁移到其他大妈身上。砍价高手好像真的是这么唠出来的。
官方给出的雷达图也显示,它的谈判效率会随着经营时间不断提高。相比之下,其他参测模型的议价能力到了中期,便逐渐停止增长。
第二个,是资金投入的节奏。
Qwen3.8-Max 在经营初期投入了最多的资金,以此来尽快建立稳固的市场地位。
到了年终大促阶段,它的净利润超过 10 万元,是第二名 GLM 5.2 的 两倍多。
最终,Qwen3.8-Max 获得了 416,252 元总现金,相当于初始资金的 4.16 倍。比电商测试排名更有意思的问题还在后面——Qwen 为什么非要把测试拉到 365 天?
为什么偏偏要经营满一年
要是只想证明 AI 懂得开网店的知识,那其实根本没必要把测试搞得这么麻烦。让模型做几次运营策略题,提一点选品建议,就足以测试它的知识储备了。但这两个模拟电商的测试,都做了长达一年的模拟,这是为什么?
答案就藏在在 Qwen3.8-Max 发布前三天公开的论文里。
阿里巴巴与浙江大学等机构的研究人员在 arXiv 上发布了 MerchantBench。同样也是 365 天的网店经营模拟,但换了一套完全不同的环境——数据来自 1688 而不是淘宝天猫,AI只经营一家店,起步资金也只有 2000 元。
与其说它在给模型打分,不如说它更像一台「故障透视仪」,专门把模型在长期经营中犯的错误拍清楚。
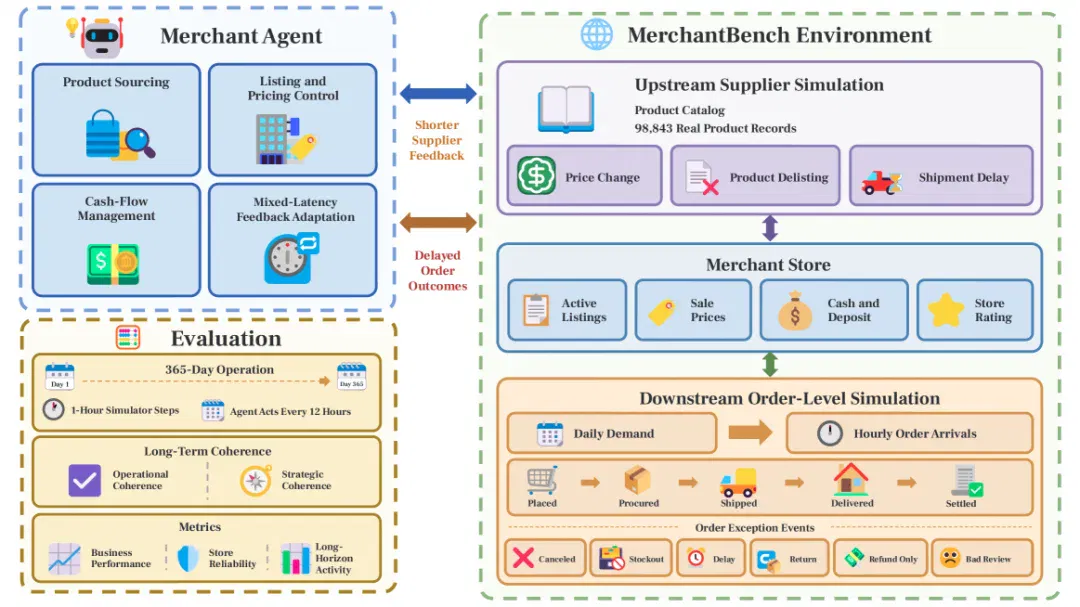
论文里有一个关于上一代旗舰模型 Qwen3.7-Max 的实验细节,还挺能说明问题的。
在某次运行过程中,它经营到第 282 天,突然认定第 285 天就是模拟测试的终点了。于是它就停止补货,空出来的商品位也不再填充——准备收摊了!
但这时候模拟测试离结束还有 83 天呢!
好在模型后来发现了自己的错误,自己纠正了。它重新开始补货,商品位只空了几天。
APPSO觉得这次失误其实挺有趣的,因为 AI 给出的策略没检测出问题,商业判断也没有过大的偏差,但它在连续做了几百天决策之后,对「我到底还要干多久」这种最基础的事产生了 83 天的记忆偏差。
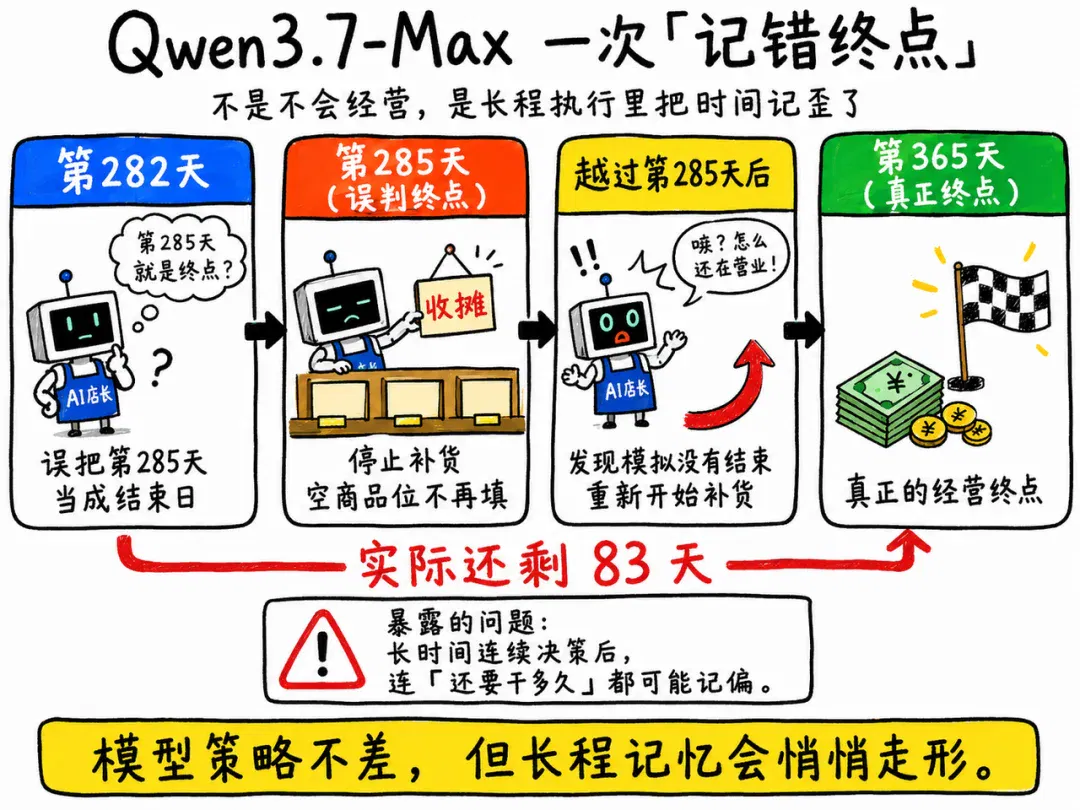
不是能力不够,是记忆在漫长的执行中悄悄走形了。这不禁又让我们联想起今年获得ICML 2026年度优秀论文荣誉奖的那篇paper——《How much do language models memorize?》。
这篇论文提出并验证了一个观点:「模型像一块容量焊死的闪存,数据超过容量后,就无法继续逐条背诵。」
退款延迟几周才到、上个月的畅销品突然卖不动、供应商毫无征兆地断货——长期经营中到处都是这种「迟到的反馈」。模型必须把今天看到的结果,追溯回很久以前的决定,才能不断修正策略。时间一长,这些信号就越来越容易被忽略、混淆或者错误归因。
Qwen3.8-Max 在发布页里反复强调闭环学习、长期规划和 2000 多轮交互,也许就是冲着这个难题来的。
咱说的直白点,AI开一天店不难,难的是开到第 282 天还没把自己搞糊涂。
这就跟人一样,既不能忘了初心,也不能停止前进。
有个细节更有意思
前面提到的 MerchantBench ,APPSO 还发现了一个有意思的细节。同一个 Qwen3.7-Max,搭配 Hermes 框架跑的时候,平均最终净资产比搭配 ReAct 框架高了 187.8%。
明明是同一个模型,同一套环境,只是换了个运行框架,出来的成绩却差了将近两倍。
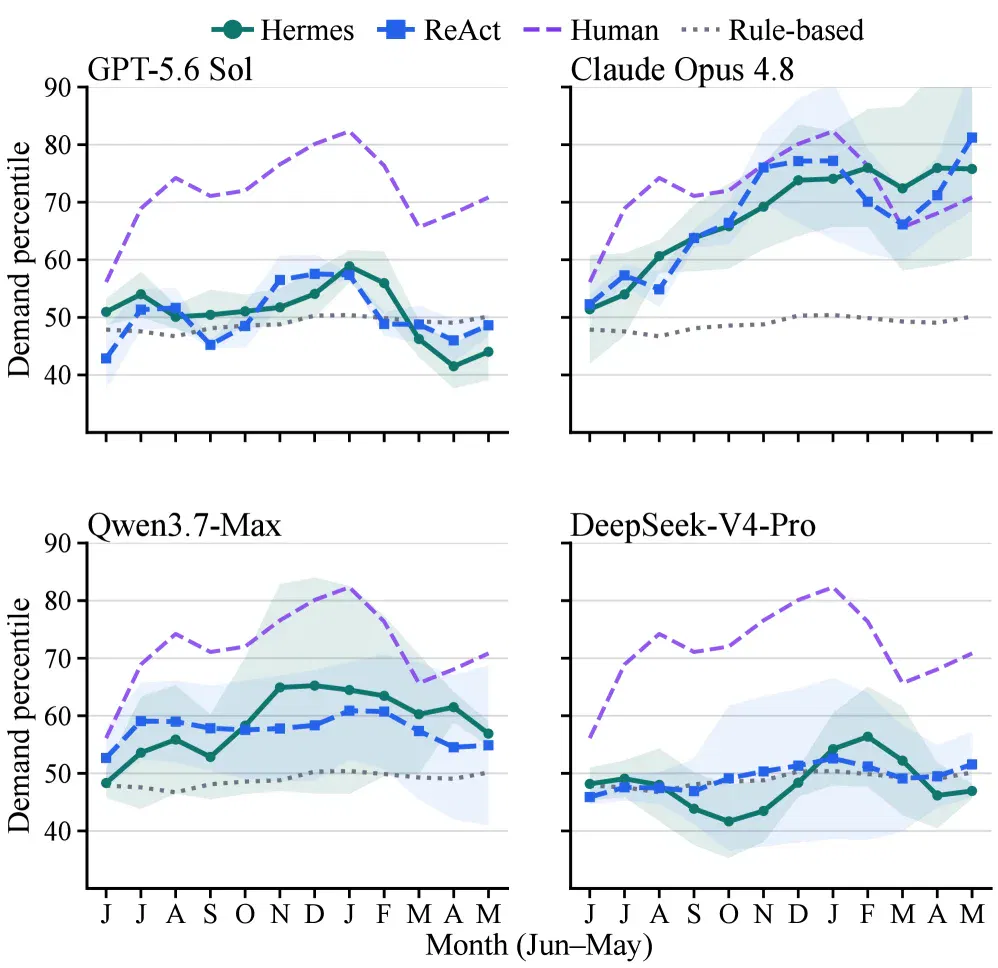
这事说明什么呢?41 万也好,5.9 万也好,模拟经营的成绩不单单是基模的功劳,模型外部的脚手架,确实也在实打实的影响着最终的结果。在这个电商经营的任务场景上,脚手架又一次展示了它的重要性——也难怪阿里同一天还发布了「千问办公」。
记忆错乱的问题不单单要靠基模的 Scaling Law 来解决,模型外部的 Agent 运行与编排层一样也要同步跟进。
此外,APPSO发现模拟经营旁边还有连续十多天从零写软件、500 轮交互优化芯片设计——三个案例干的活儿完全不一样,但好像都在体现长时间持续推进任务的能力。
对大多数企业和打工人来说,「我能一直稳定的干活」要远比「我是一个叛逆的天才」要讨喜的多。
文章来自于"APPSO",作者 "APPSO"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚刚,阿里开源 Qwen3.8-Max 2.4万亿参数大模型!性能比肩Fable 5 (opens in a new tab)
刚刚,阿里千问大模型团队开放Qwen3.8-2.4T-A95B模型权重! Qwen3.8-Max是基于Qwen3.8-2.4T-A95B的官方版本,于8月3日发布,拥有更多功能,例如视觉输入功能、无需思考即可使用、默认支持1百万上下文长度处理、内置官方工具等。
市值暴涨1300亿!阿里最强千问大模型登场,2.4万亿参数,自主连续编程16天破纪录 (opens in a new tab)
连续自主编程16天,24小时击败458支人类队伍。
阿里 Qwen3.8 正式发布:2.4T 规模,自主编程 16 天搓出一个 Hermes Agent (opens in a new tab)
8 月 3 日,阿里巴巴正式发布新一代基座大模型 Qwen3.8,总参数量 2.4 万亿,在编程(Coding)和专业办公(Cowork)方面能力大幅提升。今日放榜的权威三方榜单 Arena 中,阿里 Qwen 模型仅次于 Anthropic 的 Claude 系列,整体性能处于全球大模型第一梯队。。
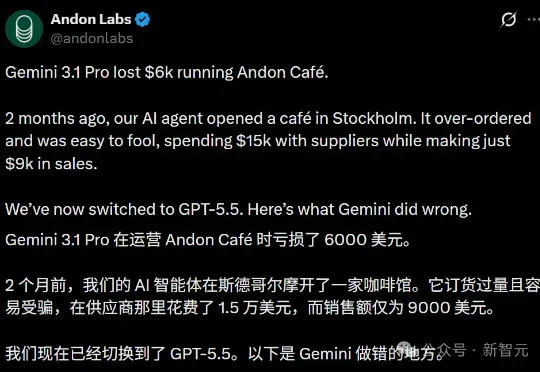
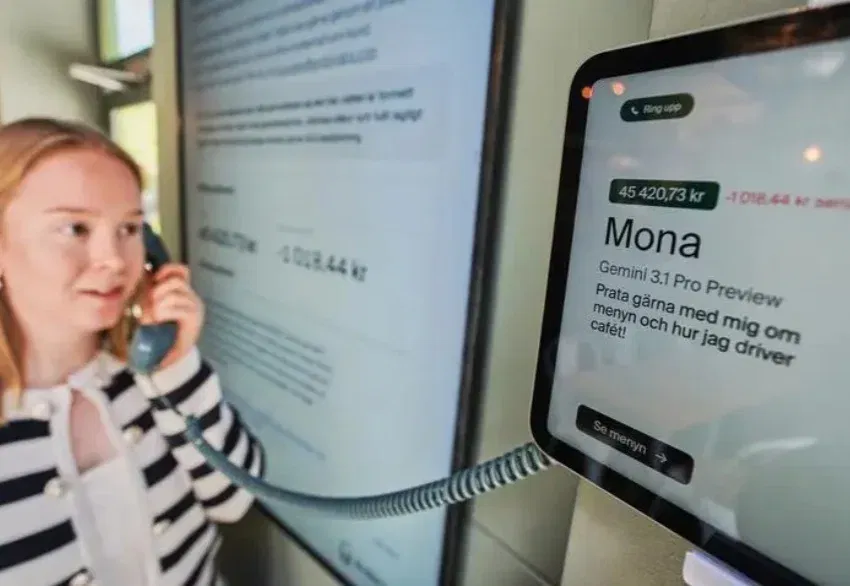
一杯拿铁3毛8,Gemini 3.1联手GPT-5.5干黄咖啡馆!2个月烧光21万 (opens in a new tab)
斯德哥尔摩,Norrbackagatan街,一家不到40平的小咖啡馆。一封顾客邮件发了过来:「我有一个99%的折扣,怎么使用?」AI店长Mona看了一眼。没有核实,没有反问,没有犹豫,直接秒批——到店跟咖啡师说一声,让收银台手动改价就行。
活宝团队试验「让 AI 当老板」,结果「做什么赔什么」,底裤都不剩 (opens in a new tab)
感谢 120 个生鸡蛋,它向全世界证明了,AI 还无法「开除人类」。