斯坦福新开了一门课,专门讲 AI 怎么自我进化
斯坦福最近公开了一门课的录像,叫 CS329A,主题是 Self-Improving AI Agents(自我改进的 AI agent)。两位主讲教授,Aakanksha Chowdhery 和 Azalia Mirhoseini,都有极深的工业背景。Aakanksha 曾是 Google 540B 参数 PaLM 模型的技术负责人,也参与了 Gemini 的研发
你有没有想过,为什么同一个模型,问它一次得到的答案可能很烂,但让它反复回答一万次,里面总有几个是对的?为什么 ChatGPT 出来之前,模型已经很大了,但就是感觉没那么好用?为什么现在 Claude Code 和 Deep Research 这类 AI agent 突然开始真的能帮人做事了,而不只是陪人聊天?
斯坦福最近公开了一门课的录像,叫 CS329A,主题是 Self-Improving AI Agents(自我改进的 AI agent)。两位主讲教授,Aakanksha Chowdhery 和 Azalia Mirhoseini,都有极深的工业背景。Aakanksha 曾是 Google 540B 参数 PaLM 模型的技术负责人,也参与了 Gemini 的研发;Azalia 是斯坦福助理教授,曾在 Google Brain、Anthropic、Google DeepMind 工作,参与了 Claude 和 Gemini 的开发,还提出了现在主流大模型都在用的 Mixture-of-Experts(MoE,混合专家)架构,以及用深度强化学习做芯片布局的 AlphaChip。
我看完整段课程视频之后,有很多感触。这门课不只是技术史的梳理,更像是把过去几年 AI 进化的底层逻辑完整拆开来讲了一遍。我想把我觉得最有价值的部分分享出来,同时说说我自己的理解。
Scaling Law(规模扩展定律):大力真的出奇迹,但这件事开始碰壁了
要理解今天的 AI agent,得先回到一个最基础的问题:为什么模型越来越大之后,它就变得越来越聪明?
Aakanksha 在课上讲了一个叫 Scaling Law(规模扩展定律)的东西。简单说就是:你往模型里投入更多参数、更多训练数据、更多算力,模型的 test loss(测试损失,衡量模型预测准不准的指标)就会持续下降,模型就会变得更好。这个规律从 2018 年一直成立到 2024 年左右,几乎没有例外。
回头看这段历史其实挺震撼的。BERT 当年是 3.4 亿参数,GPT-2 是 15 亿,GPT-3 跳到了 1750 亿,PaLM 达到 5400 亿,GPT-4 据估计已经是万亿级别。这是一段指数级别的爆炸式增长,而且每一次规模的扩大,都带来了真实的能力提升,不是在刷数字,而是在真正变聪明。
我对这件事有个自己的理解。Scaling Law 本质上给整个 AI 行业提供了一个可以长期押注的方向:你不需要太多创意,只需要持续堆资源,模型就会变好。这也是为什么那几年大家都在疯狂砸钱买 GPU,因为规律是清楚的,回报是可预期的。
但 Aakanksha 也提到,这件事从 2024 年左右开始碰到了某种天花板,单靠堆参数已经开始边际收益递减了。这个节点很关键,因为它逼着整个行业开始认真想另一件事:如果训练时的 Scaling 开始失效,那还有什么方向可以让模型变得更强?答案就是他们后来讲的 inference-time scaling(推理时扩展)。
Chain-of-Thought(思维链):一个偶然发现,改变了整个方向
Azalia 在课上讲了一个让我印象很深的细节。Chain-of-thought(思维链,让模型一步步推理而不是直接给出答案)这个能力,最初不是被设计出来的,是被发现的。
研究人员发现,如果你在给模型的例子里,不只是给它问题和答案,而是把解题的中间过程也写出来,模型就能学会用同样的方式去解新问题。更诡异的是,这个能力只在足够大的模型里出现。小模型你给它再多的推理示例,它也不会用,但当模型大到某个临界点,这个能力就突然冒出来了。
课上举了一个很经典的例子。给模型一道题:Roger 有 5 个网球,他又买了 2 罐网球,每罐 3 个,他现在一共有多少个?如果只是给答案是 11,模型可能学不太会。但如果你告诉它:Roger 原来有 5 个,2 罐每罐 3 个就是 6 个,5 加 6 等于 11——这种手把手带着推理的方式,模型就真的学会了一套解题框架,可以迁移到其他问题上。
我觉得这件事背后有一个更深层的含义:大语言模型本质上不是在学知识,而是在学思维方式。Chain-of-thought 的出现意味着,只要你把人类解决问题的过程展示给模型看,它是有能力把这套过程内化的。这和死记硬背知识点是完全不同的东西。
这也解释了为什么后来的 reasoning model(推理模型),比如 OpenAI 的 o1、o3,还有 DeepSeek,会走上那条路——不只是给模型更多知识,而是训练它真的会思考、会拆解问题、会在走错了之后退回来重试。
RLHF(人类反馈强化学习):让模型从"会说话"变成"说人话"
ChatGPT 为什么在 2022 年底发布之后引爆了整个世界?Aakanksha 说,ChatGPT 从用户第一天到百万用户只用了五天,这个速度比历史上任何一个软件产品都快。但在它发布之前,GPT-3 就已经存在了,参数量也不小,为什么感觉差了那么多?
关键不是模型大小,而是两个训练步骤:instruction tuning(指令微调)和 RLHF(Reinforcement Learning from Human Feedback,人类反馈强化学习)。
Instruction tuning 的逻辑相对直接:你给模型看大量"问题-答案"对,而且这些数据是精心挑选过的高质量内容,不是随便从网上爬的那种,模型就学会了怎么回应人类的提问。但光有这个还不够,因为模型仍然不知道什么是真正"好的"回答。
RLHF 解决的就是这个问题。做法是:让人类去评价模型给出的不同答案,哪个更有帮助,哪个更安全,哪个更准确,然后用这些人类偏好训练出一个 reward model(奖励模型),再用这个奖励模型去引导原始模型生成更符合人类期望的内容。
我觉得 RLHF 的本质是在做一件之前从未被认真做过的事:告诉模型,什么叫做"对人有用"。一个只靠预训练的模型,它见过互联网上所有的文字,但它不知道这些文字哪些是有价值的,哪些是胡说的,哪些是有害的。RLHF 给它注入了一套价值判断。这件事听起来简单,但它是 ChatGPT 能被普通人用起来的核心原因之一。
Large Language Monkeys:让模型反复尝试,答案就藏在里面
这是整个课程里我觉得最有创意的一个研究,是 Azalia 自己实验室做的,叫 Large Language Monkeys。
灵感来自一个古老的思想实验:如果有一只猴子在打字机上一直随机敲,敲到永远,它最终会打出莎士比亚全集。听起来荒诞,但背后的逻辑是:只要你有足够多的随机尝试和足够长的时间,极低概率的事件也会发生。
Azalia 把这个思路用在了大语言模型上。她的团队做了一件事:不要只问模型一次问题,而是让它对同一个问题回答一万次。然后用一个 verifier(验证器)去判断哪些答案是对的,选出正确的那个作为最终输出。
结果非常惊人。一些规模比 GPT-4o 小很多的模型,在只问一次的情况下,表现远不如 GPT-4o。但如果让它们回答一万次,它们的覆盖率反而超过了 GPT-4o。换句话说,这些小模型其实"知道"正确答案,只是在单次回答里不够稳定,但只要次数足够多,答案就在里面。
课上有同学问了一个很好的问题:那一万次的延迟怎么办?Azalia 的回答是:这些采样可以并行跑,所以延迟问题没有想象中那么严重。当然,计算成本是真实存在的,但这里有一个根本性的权衡:你花更多计算,换来更强的能力,这个思路本身是成立的。
我自己的理解是:这个研究揭示了一件很重要的事,模型的能力上限和它单次回答的质量是两回事。我们平时用模型,习惯了问一次、拿一个答案,但这可能严重低估了模型真正能做到的事。这也是 inference-time scaling(推理时扩展)这整个方向最核心的洞见:模型的能力不只由训练决定,在推理阶段你怎么用它,同样决定了你能从它身上拿到多少。
Reasoning Model(推理模型):o1 之后,推理变成了新的战场
Azalia 讲了 OpenAI 去年发布 o1 时展示的一组数据。他们把 test-time compute(推理时算力)从少到多地提升,然后看模型在一批极难数学题上的 pass@1 准确率(一次作答就答对的概率)怎么变化。结果是对数线性关系:投入的推理算力越多,准确率就越高,而且这个规律在对数坐标下是一条直线,没有出现明显的天花板。
这个发现和之前的 Scaling Law 是同构的,只不过从训练阶段换到了推理阶段。以前我们知道训练时多投入算力模型会变好,现在我们知道推理时多投入算力模型也会变好,而且这两件事可以叠加。
课上 Azalia 讲了 reasoning model 在推理时具体在做什么。一个 o1 或 o3 级别的模型,拿到一个问题之后,它不会直接给你答案,它会先做 problem analysis(问题分析),搞清楚题目在问什么;然后做 task decomposition(任务拆解),把一个大问题拆成几个小的子问题;然后去尝试解每个子问题,看有没有通过验证;如果某条路走不通,它会做 self-correction(自我纠正),退回来,换一个思路重试。
课上展示了一个 o1 处理 bash 脚本的例子。模型拿到任务之后,先自言自语地分析:用户要的是什么格式的输入?矩阵应该怎么存储?然后开始写代码,写到一半突然说"等等,这里可能有问题",退回去改,然后继续。这种自我对话式的推理过程,在屏幕上看起来像是一个人在认真想问题,而不是一个程序在机械地输出。
我觉得这件事意味着,AI 正在从"会说话的数据库"变成"会思考的问题解决者"。这不是夸张,而是有实质性的区别。会说话意味着你能从它身上检索到信息,会思考意味着你可以把一个没有标准答案的任务交给它,让它自己想办法解决。这两件事对用户来说的价值差距,是数量级的。
不过 Aakanksha 说了一句话让我印象很深。她说这个方向"还有大量研究是开放的",关于为什么 RL(强化学习)能让模型变得这么好,大家其实还没有完全想清楚。这种诚实我很喜欢,因为很多时候外界对 AI 进展的报道要么过于神化,要么过于悲观,但真正在做研究的人,往往对自己不知道什么这件事,比对自己知道什么更在意。
从 LLM 到 AI agent:真正的跨越在哪里
这是整门课最核心的主题。Aakanksha 说,大语言模型在很长一段时间里,本质上都是单轮对话工具,你问一句,它答一句,然后结束。它没有在帮你完成任何事情,只是在陪你聊天。
AI agent 的不同在于:它有一个目标,它会主动规划达成这个目标所需要的步骤,在执行过程中与环境互动,根据反馈调整自己的行为,直到目标达成或者确认无法达成为止。
课上举了一个很直观的例子。如果你想研究在斯坦福附近租房哪里比较好,你让一个普通聊天机器人来做,它能给你一段文字,但文字的依据是它训练时见过的信息,不一定是今天的市场情况。但如果你让一个 AI agent 来做,它会主动去搜索多个房产网站,对比不同区域的价格和通勤时间,综合之后给你一份真正基于实时信息的分析报告。这是两件完全不同的事。
课上讲了几种 agentic workflow(智能体工作流)的常见结构。最简单的是 prompt chaining(提示链接),把一个大任务拆成多个步骤,每个步骤的输出是下一个步骤的输入,依次执行。然后是 routing(路由),根据任务的复杂程度,决定走简单流程还是复杂流程。再复杂一点是 parallelization(并行化),像 Deep Research 这样的工具,会同时对多个关键词发起搜索,最后把结果汇总在一起。最复杂的是 orchestrator-worker(编排者-执行者)模式,有一个中心模型负责规划,然后调度其他模型或工具去执行具体任务,Claude Code 就是这种模式的典型例子。
课上还讲到了 verifier(验证器)这个概念,在我看来这是整个 AI agent 能不能真正落地的关键。verifier 是用来判断 AI agent 的输出是不是正确的机制。在代码领域,unit test(单元测试)就是一个天然的 verifier:你让模型写代码,然后跑测试,通过了就是对的,没通过就让它重试。在数学领域,答案的对错也可以被明确验证。
但在其他领域,verifier 就没那么好做了。你怎么验证一篇报告写得好不好?你怎么判断一段营销文案是不是有效?这些领域缺少客观的验证机制,是 AI agent 目前覆盖能力受限的一个重要原因。Aakanksha 直接说,robust verification(可靠的验证机制)是这个领域最大的瓶颈之一。
我对这一点有自己的判断:AI agent 目前能真正发挥价值的地方,几乎都有一个共同特征,就是任务的对错可以被客观验证。代码能不能跑、数据分析的结论是否和数据匹配、搜索到的信息是否和问题相关——这些都可以被检验。而那些依赖主观判断的任务,AI agent 目前能做的,主要还是辅助,而不是替代。
Coding Agent(代码智能体):最接近真实可用的地方
课上花了很大篇幅讲 coding agent,包括 Claude Code 和 OpenAI 的 Codex。我理解这不只是因为两位教授都有工程背景,而是因为代码这个领域,确实是目前 AI agent 最接近真正可用的地方。
原因前面已经提到了一部分:代码的对错可以被客观验证。但课上还补充了一个更细节的逻辑。在代码领域,AI agent 可以形成一个自我改进的闭环:它生成代码,然后生成对应的 unit test,用 unit test 检验自己生成的代码,如果测试失败就修改代码,直到通过为止。这整个过程不需要人类在旁边一直盯着,AI 自己就能跑完。
Aakanksha 在课上说,这种工作模式在去年还不够可靠,但现在已经开始真的能用了。她把原因归结为两点:模型本身变强了,以及 RL with verifiable rewards(带可验证奖励的强化学习)开始真正发挥作用。
她还具体列举了几类特别适合交给 coding agent 处理的任务:代码迁移(把旧版本的代码库升级到新版本),代码库重构,数据工程(数据提取、清洗、格式转换),以及单元测试的编写。这些任务有一个共同特点:高度重复,有明确的输入和输出标准,人做起来既枯燥又容易出错。
我自己对这件事的理解是:coding agent 真正改变的不是程序员写代码的方式,而是程序员能处理的任务规模。以前一个人的精力有限,只能维护一个代码库里自己熟悉的那部分;现在有了 coding agent,你可以把那些你知道该怎么做但懒得做或者做起来太花时间的事情直接交出去,自己专注在真正需要判断力的地方。这个转变不是在淘汰程序员,而是在让每个程序员能管理的复杂度上限大幅提升。
自我改进这件事,为什么让人兴奋又让人不安
课程的标题叫 Self-Improving AI Agents,最后我想说说我对"自我改进"这件事的看法。
Azalia 在课上提到,当 inference-time scaling 和 fine-tuning(微调)结合在一起的时候,就出现了一个真正有意思的循环:模型在推理阶段生成大量答案,这些答案里有一部分是高质量的,可以被用来训练下一版的模型,让它变得更好,然后更好的模型又能生成更多高质量的答案,再继续训练。DeepSeek 和 Google 的 Gemini Thinking 系列,都是这条路上的早期尝试。
这个循环让人兴奋的地方在于它的理论上限不清楚。以前我们知道,模型变好需要人类去标注更多的数据、写更多的指令,这是一个受限于人力的过程。但如果模型可以自己生成训练数据、自己验证对错、自己迭代变强,那这个过程就不再完全依赖人类的介入了。
但 Aakanksha 也很清醒地说,这里有一个关键前提:你需要有可靠的验证机制。如果模型自己生成的数据里有错误,而这些错误又被用来训练下一版模型,错误就会被放大,而不是被纠正。这个问题在代码和数学领域相对好处理,但在更开放的领域,这个风险是真实存在的。
我觉得这门课最值得记住的一条线索是:AI 的每一次重大进步,背后都有一个新的反馈机制被激活。Scaling Law 时代靠的是损失函数对参数和数据量的反馈;RLHF 时代靠的是人类偏好的反馈;reasoning model 时代靠的是 verifier 对推理过程的反馈;而 self-improving agent 时代,靠的是模型对自己行为的反馈。每往前走一步,反馈循环就往内收紧一层,模型的自主性就增加一层。
我们现在站在这个过程的早期,coding agent 刚刚开始真正可用,research agent 还在进化,能在更广泛领域自主运作的 AI agent 还没到来。但这条方向是清楚的。理解它背后的逻辑,比跟着每一波新产品的发布节奏跑,要有用得多。
文章来自于微信公众号 “深思圈”,作者 “深思圈”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
OpenAI塌房!Scaling law原作曝bug,万亿算力全白烧 (opens in a new tab)
OpenAI误导了整个AI圈好几年!过去五年,整个AI行业都被Scaling Law推着往前冲。现在,有人站出来说:这条曲线,一开始就错了。刚刚,他发出一篇博客,标题冷得发指——《Scaling Laws, Honestly》。
Ilya警告、LeCun冷嘲、奥特曼沉默:Scaling Law时代还能走多远? (opens in a new tab)
过去10年,AI大模型的技术本质,是把电力能源通过计算过程转化为可复用的智能。2026年,我们需要让AI模型在单位时间内「吃下」更多能源,并真正将其转化为智能。
600 万奖金的 KDD Cup,摸到了推荐系统 Scaling Law的关键 (opens in a new tab)
这两年大模型圈有一条几乎没人怀疑的信条,Scaling Law。
DeepMind内部视角揭秘!Scaling Law没死,算力即一切 (opens in a new tab)
2026年,Scaling Law是否还能继续玩下去?对于这个问题,一篇来自DeepMind华人研究员的万字长文在社交网络火了:Scaling Law没死!算力依然就是正义,AGI才刚刚上路。
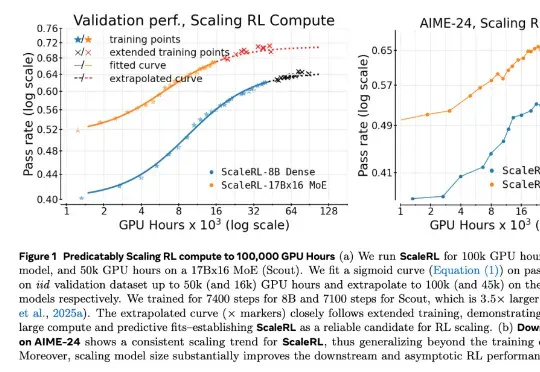
Meta用40万个GPU小时做了一个实验,只为弄清强化学习Scaling Law (opens in a new tab)
在 LLM 领域,扩大强化学习算力规模正在成为一个关键的研究范式。但要想弄清楚 RL 的 Scaling Law 具体是什么样子,还有几个关键问题悬而未决:如何 scale?scale 什么是有价值的?RL 真的能如预期般 scale 吗?