官宣开源|Milvus 3.0 正式发布
近日,Milvus 3.0 正式上线。作为 Milvus 架构演进中的里程碑式版本,3.0 不仅带来多项突破性新功能,更从底层重塑了向量数据的存储、索引与检索边界。在 Milvus 3.0 中,你可以获得:
近日,Milvus 3.0 正式上线。作为 Milvus 架构演进中的里程碑式版本,3.0 不仅带来多项突破性新功能,更从底层重塑了向量数据的存储、索引与检索边界。在 Milvus 3.0 中,你可以获得:
- 湖原生向量索引路径:数据无需搬家,就能直接在对象存储与开放格式(Parquet、Vortex)和开放表格式(Lance、Iceberg)上就地构建检索,让数据湖真正具备可检索能力。
- 更完整的检索引擎:更多计算被下推到引擎内部,包括服务端排序(Server-side sorting)、聚合(aggregation)、分面搜索(faceted search)、面向嵌套文档/分块结构与 ColBERT 向量的 StructArray(StructArray for nested doc/chunk structure and ColBERT vectors),以及全新设计的轻量化稀疏索引。大量排序、分组和结果处理逻辑得以从应用代码迁移至引擎内部。
这些能力共同奠定了 Milvus 3.0 的新方向:为生产级 AI 检索提供坚实的开源基础设施,并为全新的 Vector Lakebase(向量数据湖基座)架构提供底层能力保障。它将湖原生存储与高性能向量检索结合起来,让数据保留在统一的数据源中,以更高性价比为生产场景交付搜索与计算能力。
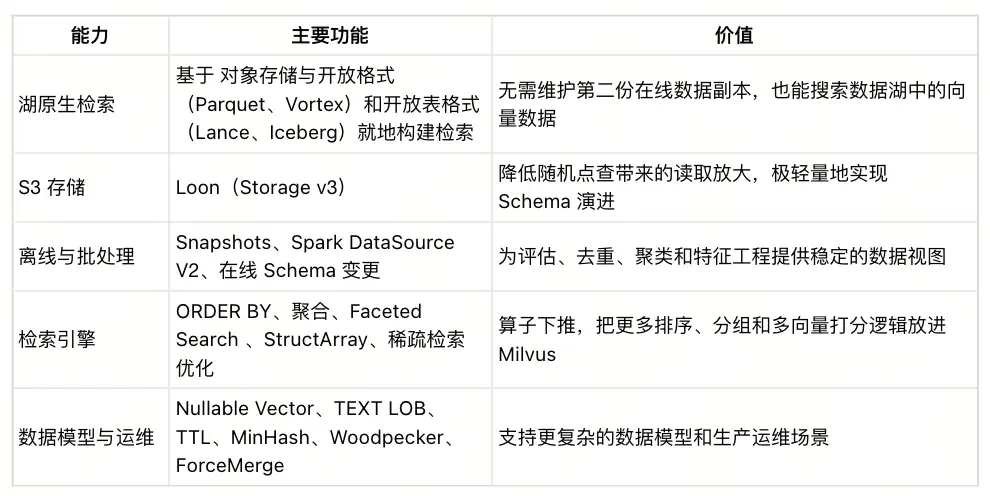
Milvus 3.0核心功能概览如下
01
Lake-native 基础设施:数据不搬家,也能建索引、做检索
Milvus 3.0 最重要的架构变革,是打破了数据必须先导入向量数据库,才能建立索引和提供检索的传统范式。现在,向量数据可以继续存放在对象存储和开放格式中,由 Milvus 负责构建索引、执行检索,并通过统一 API 对外提供服务。
(1)External Collections:直接搜索数据湖中的向量数据
许多 AI 团队早已将 Embedding 存放在数据湖内,比如 Lance 表、Iceberg 表、Parquet 文件,或是 S3/GCS/Azure Blob Storage 上的其他开放格式数据集。在 Milvus 3.0 之前,检索这些数据通常只有两条路:要么复制一份到向量数据库(查询延迟低,但会带来额外存储副本和复杂的 ETL 同步),要么直接暴力扫描数据湖(缺乏 ANN 索引,暴搜的延迟难以满足生产要求)。
对于那些对数据治理要求高、数据归属边界明确或极力希望节省存储成本的团队,External Collections(外部集合)给出了第三种优解:直接在 Milvus 中直接链接对象存储上的数据集,将外部字段映射到 Milvus Schema,无需移动数据文件,Milvus就会在原地直接构建向量索引、BM25 倒排索引、JSON 索引以及标量索引,整个操作过程就像操作普通 Milvus Collection 一样。
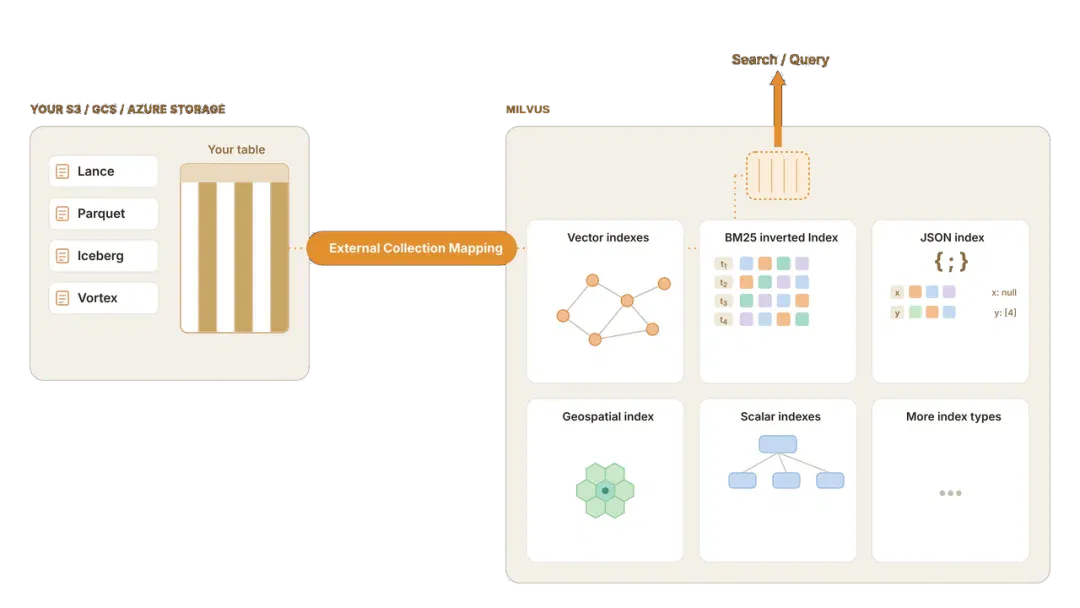
当外部数据集更新后,Milvus 会读取对应的存储 Manifest,仅对新增加的数据分片构建索引,无需全量重建。
import json import os import time from pymilvus import DataType, MilvusClient client = MilvusClient(uri="http://localhost:19530") # Register an Iceberg table as a zero-copy collection. schema = client.create_schema( external_source="s3://lake/docs/metadata/v1.metadata.json", external_spec=json.dumps( { "format": "iceberg-table", "snapshot_id": 123456789, "extfs": { "cloud_provider": "aws", "region": "us-east-1", "access_key_id": os.environ["AWS_ACCESS_KEY_ID"], "access_key_value": os.environ["AWS_SECRET_ACCESS_KEY"], }, } ), ) schema.add_field( field_name="id", datatype=DataType.INT64, external_field="doc_id", ) schema.add_field( field_name="emb", datatype=DataType.FLOAT_VECTOR, dim=1024, external_field="embedding", ) schema.add_field( field_name="title", datatype=DataType.VARCHAR, max_length=1024, external_field="title", ) client.create_collection( collection_name="docs", schema=schema, ) # Import the external table snapshot. job_id = client.refresh_external_collection(collection_name="docs") whileTrue: progress = client.get_refresh_external_collection_progress(job_id=job_id) if progress.state == "RefreshCompleted": break if progress.state == "RefreshFailed": raise RuntimeError(progress.reason) time.sleep(1) index_params = client.prepare_index_params() index_params.add_index( field_name="emb", index_type="HNSW", metric_type="COSINE", ) client.create_index( collection_name="docs", index_params=index_params, ) client.load_collection(collection_name="docs")
总的来说,大型 AI 系统中,External Collections的价值在于,让用户数据安心留在湖里,Milvus 主动走向数据,为其提供向量检索能力。一份数据服务多种场景,彻底免去数据转移与治理的额外成本。
但需要指出的是,对于写入频繁、延迟极度敏感的在线业务,原生 Milvus Collection 依然是最佳选择;External Collections 则专为数据源在 Milvus 之外且需长期留存的场景量身定制。
(2)Loon(Storage v3):攻克对象存储的随机点查瓶颈
External Collections 直接检索对象存储时面临一个现实痛点:对象存储虽适合低成本保存海量数据,但能否扛住 ANN 搜索后的大量随机点查?这一阶段的核心问题在于读放大(Read Amplification)。
典型的向量搜索分两步:ANN 索引返回候选 ID,再根据 ID 读取对应字段。如果底层存储格式专为全表扫描设计,哪怕只需读取极少记录,也可能触发大规模物理 I/O。
基于这一背景,Milvus 3.0 推出 Loon(即 Storage v3),一个面向 S3 兼容对象存储、基于 Manifest 管理的列式存储引擎。Loon 将字段组织为多个 ColumnGroup,通过对齐的 Row ID 关联。其核心设计思路有三:
- 物理布局优化:标量字段针对过滤与扫描优化,向量和点查频繁的字段则采用更小粒度随机读取友好的布局。
- 格式解耦:索引与数据格式相互独立,不同数据版本由不可变 Manifest 记录对应的 ColumnGroup。一套索引机制可通用服务于 Lance、Parquet、Iceberg 及 Vortex 等多种格式。
- 轻量级 Schema 演进:新增或删除字段只需修改元数据,无需重写已有列。补全新字段数据时,仅追加一个新的 ColumnGroup,现有数据保持不动。
在这条存储路径中,Vortex被设为默认格式。作为一种开放且兼容 Apache Arrow 的列式格式,Vortex 支持灵活的数据布局与可层层嵌套的编码方案,极其契合 AI 数据场景下的随机点查。
实测性能对比: 在 300 万行(128 维向量)、S3 对象存储及 256 个并发读取器的内部测试中:
- Parquet:每次点查的实测 I/O 消耗约为9.4MB;
- Loon + Vortex:单次点查 I/O 仅有0.07MB,读取量减少约 135 倍。
但客观而言,无论如何优化对象存储,都无法媲美本地内存的物理极限。 Loon 的价值在于将原本不可接受的读取放大降到了实用区间,让对象存储承载在线检索中的随机读取成为可能。未来我们还将加入谓词下推存储承载在线检索中的随机读取成为了可能。未来我们还将加入谓词下推(Predicate Pushdown)以及 Vortex 的本地存储版本。
(3)Snapshots:低成本创建数据视图
当生产 Collection 在持续接收写入时,离线数据任务往往需要一份稳定、一致的数据视图。
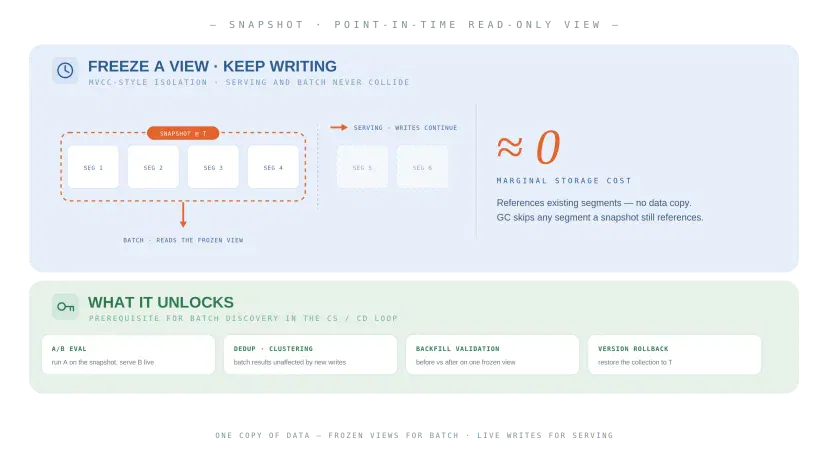
Milvus Snapshot 是某个时间点的只读视图。它不物理复制整个数据集,只记录对现有数据文件、索引文件及元数据文件的引用,创建成本极低。非常适合在模型切换、重生成 Embedding、修改 Schema 或执行高风险操作前调用。
恢复 Snapshot 时,也无需重新导入全部数据或重建所有索引,Milvus 可直接利用对象存储的服务端复制能力复用现有文件。对于 AI Agent 等数据频繁变化的业务,团队真正需要的是低成本、可高频创建的逻辑恢复点,而非偶发的高昂全量备份。
除了做备份,同一 Snapshot 还可用于模型评估、数据去重、Backfill 校验、隔离测试以及 Collection 克隆。
⚠️注意:Snapshot 不能代替数据备份方案,它是数据在某一个时间点的数据快照,底层物理设施(如对象存储与网络带宽)依然可能被多任务共享。此外,Snapshot 引用的是已有文件,适合短期隔离与逻辑恢复;而独立的 Backup 才会创建独立的物理副本,用于长期灾备。
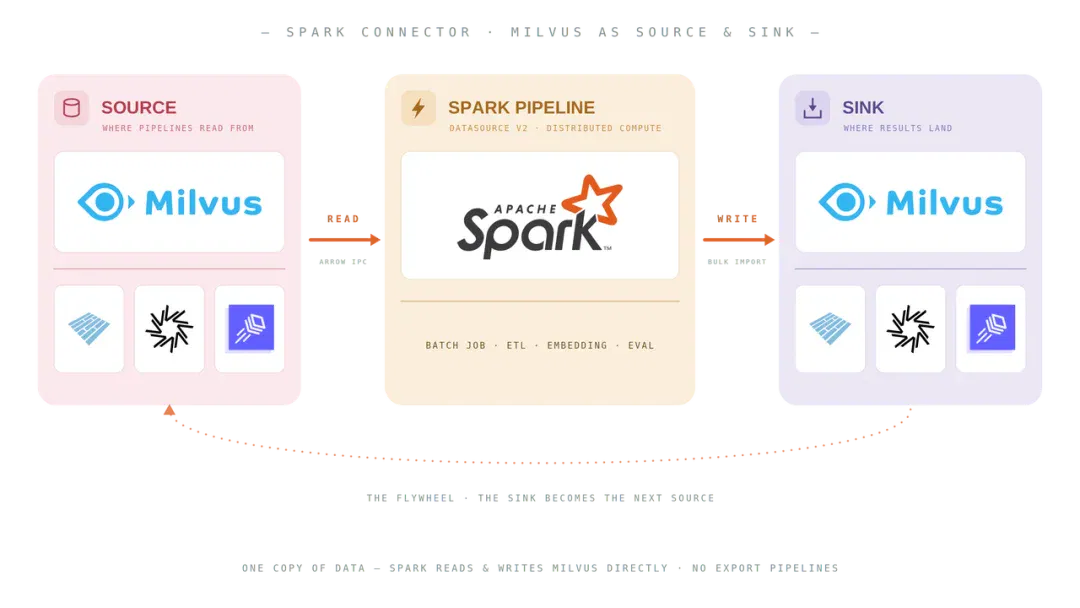
(4)Spark Connector:把 Milvus 接入批处理流水线
数据快照 (Snapshots) 再稳定,批处理引擎读不到也没有意义。于是,Milvus 3.0 推出了全新的Spark DataSource V2接口,让Spark、Databricks 和 EMR 任务都可以像操作传统数据库一样对 Milvus 发起读写。
AI 数据处理本质上是一个闭环迭代过程:反馈优化去重 → 重新生成 Embedding → 聚类 → 效果评估 → 产出新训练集 → 上线检索 → 反馈优化去重…… Snapshot 为这些任务提供一致输入,线上 Collection 继续提供实时服务。
通过 Spark Connector,一个任务的输出可以直接成为下一个任务的输入,无需每一步都将完整 Collection 导出到其他系统。此外,Milvus 3.0 还增加了面向向量数据的批处理算子,可用于去重、异常检测、聚类等计算密集型任务,这些任务可在在线查询路径之外直接操作 Milvus 中的向量数据。
(5)在线 Schema 变更与数据回填
生产环境的 Schema 几乎不会一成不变。随着业务演进,团队会持续增加新的 Embedding 模型、稀疏向量、标签、元数据字段等。Milvus 3.0 支持在服务不中断的情况下增加、填充和删除字段,彻底告别每次改模型就重建 Collection的历史。
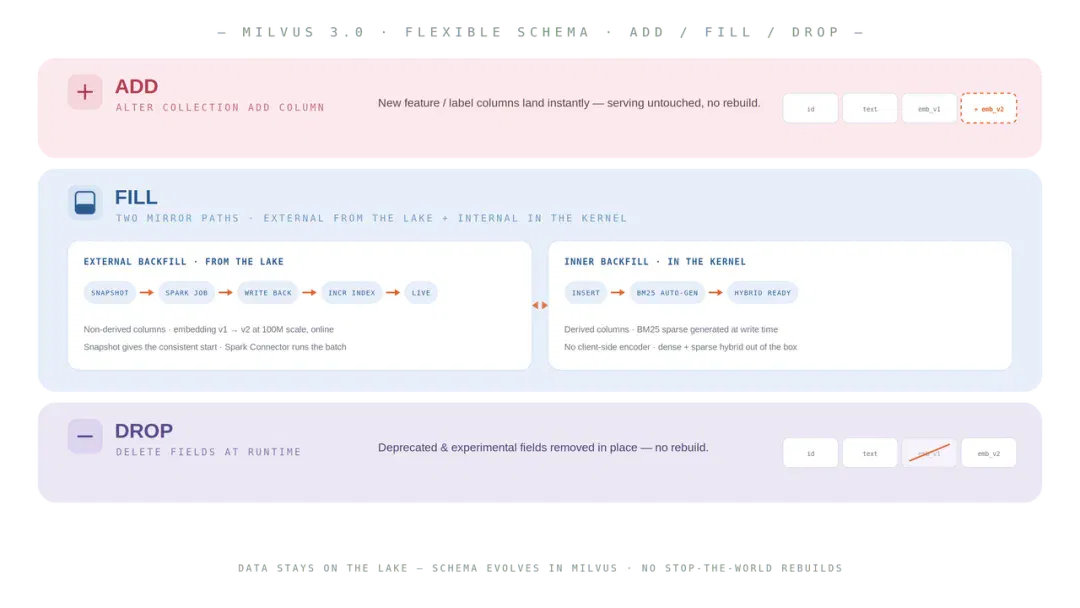
这里需要注意的是:增加或删除字段不会重写已有数据。记住client.add_collection_field(...) 我们可以在线增加一个新的 Nullable 字段;借助client.drop_collection_field(...) 我们可以在运行时移除不再需要的字段。这两个操作修改的是 Collection Manifest,而不是已有数据文件,因此不需要执行全量重建。
Milvus 3.0 提供两类回填(Backfill)路径:
- 内核内置 Backfill(已上线):适合根据现有字段派生新字段,例如直接在内核中基于文本列生成 BM25 稀疏向量。如此一来,在构建稠密+稀疏的混合检索时,应用侧不再需要额外部署独立的 BM25 编码服务。
- 外部 Backfill(能力规划中):适合在 Milvus 外部计算字段值。标准流程为:创建 Snapshot → 使用 Spark 读取一致视图并计算新值 → 写回 Milvus → Milvus 增量更新索引。
在线 Schema 变更与 Backfill 结合,让检索系统可以随业务持续演进,而无需频繁重新导入全量数据。
02
更强大的端到端检索引擎
Milvus 早已超越单纯的稠密向量检索,原生支持 BM25 稀疏检索与混合检索。在3.0 版本,我们更进一步:将大量原本依赖应用层完成的后处理计算直接下推到引擎内部,大幅减少过度召回、网络传输消耗和应用层重复逻辑。
(1)服务端 ORDER BY:直接在 Milvus 内部排序
过去,若要按评分、价格、时效性等标量字段排序,应用必须先拉取远超最终所需的数据,再在服务端手动排序截断,既浪费带宽又易受客户端本身截断位置影响。
Milvus 3.0 新增服务端 ORDER BY,允许在查询中直接按标量字段排序过滤后内容。在 Query 路径中,各 Segment 节点先局部排序,Query Node 合并有序流,最终由 Proxy 返回指定数据;在 Search 路径中,ORDER BY 会在引擎内部对 ANN 候选集按业务字段二次重排,非常适合优先展示高分商品、选择更低价格或排除无货商品的业务场景。
需要说明的是,ORDER BY 不会扩大 ANN 已确定的召回范围,仅对已召回的候选结果重新排序。
(2)聚合与分面搜索 (Aggregation and Faceted Search)
Milvus 3.0 为 Query 侧新增聚合计算,支持 count、sum、avg、min、max 以及按标量字段分组(group_by),无需将海量数据拉回客户端即可完成统计分析。
client.query( collection_name="orders", filter="in_stock == true", group_by_fields=["category"], output_fields=[ "category", "count(*)", "avg(price)", "max(rating)", ], )
Milvus 3.0 同时为分面搜索提供聚合能力。ANN 检索完成后,Milvus 自动按品牌、价格带、颜色、租户或文档类型对结果进行分桶,并返回桶内计数、统计指标及 Top‑N 示例结果。需注意,Search 侧聚合仅统计 ANN 已召回的候选集,计数为精准近似值;如需全量精确统计,请使用 Query 侧聚合。
(3)StructArray:把多向量实体作为一个整体存储和搜索
真实场景中,许多实体无法用单一向量概括,并且我们真正需要管理的实体是完整的文档或商品,而非被割裂的片段。比如:长文档包含多个 Chunk,视频包含多帧,商品包含多角度图片,而 ColBERT/ColPali 会为每个 Token 或图像 Patch 生成独立向量。
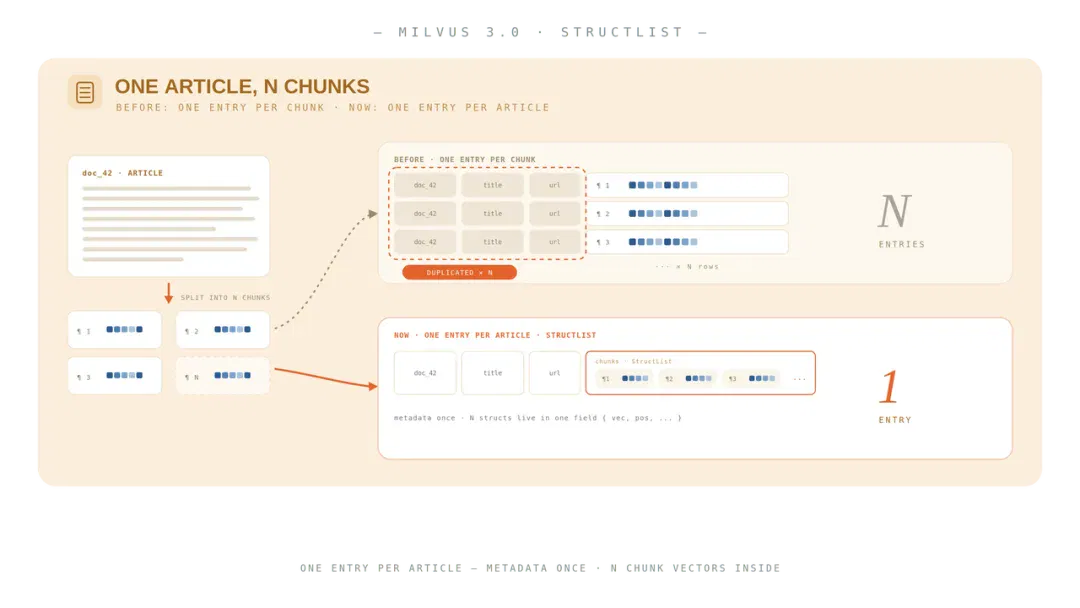
StructArray 允许一行数据中保存一个变长的结构化数组(内部可包含多个向量),带来两大优势:
1、实体标识统一:整个实体共享唯一 ID,权限与标签元数据无需在各个片段之间重复复制。
2、灵活的检索粒度:
为了解决多 Token 向量索引成本高昂的问题,Milvus 3.0 还提供了TokenANN、Muvera、Lemur等多种加速方案,在索引体积、训练成本与召回率之间提供多档权衡。
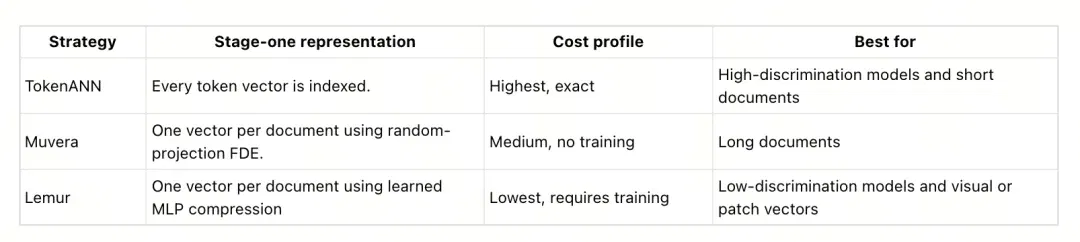
实测显示,Lemur 在大多数数据集上能将每篇文档压缩为一个向量,同时召回率能媲美或超越 TokenANN。但如果语料中的文档长度差异很大,TokenANN 或其他方案通常更稳妥。
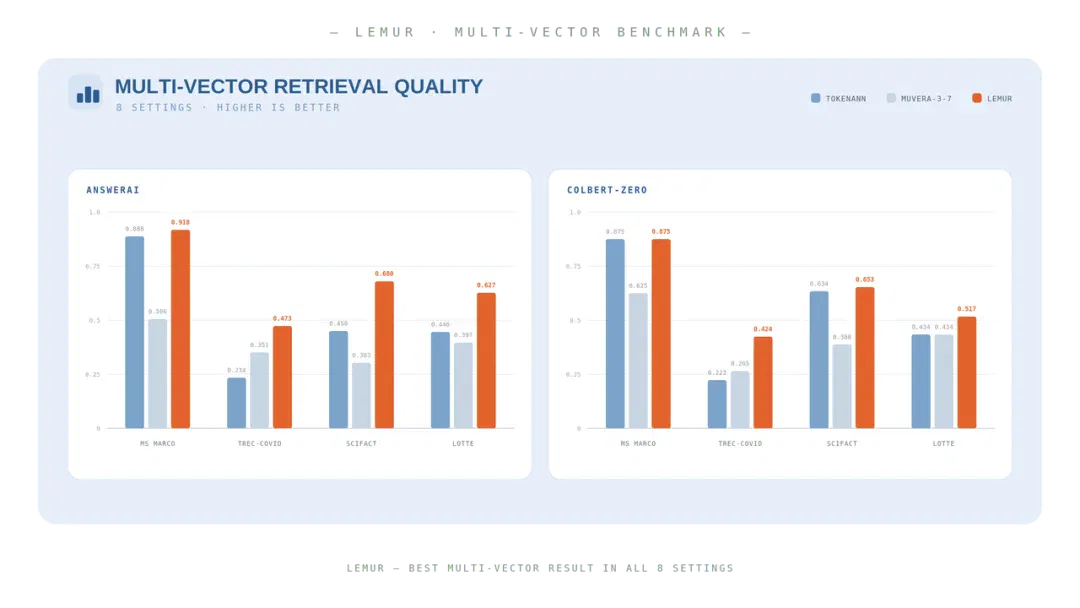
对于无法完整装入内存的大规模语料,Milvus 还支持 DISKANN,将 Embedding List 存放在磁盘上,以降低内存压力。
目前,Element-level Search 已在 Milvus 2.6 中提供。Muvera、Lemur 和 StructList 的过滤能力属于 3.0 新增。
(4)轻量化 BM25 索引与全新 SINDI 算法
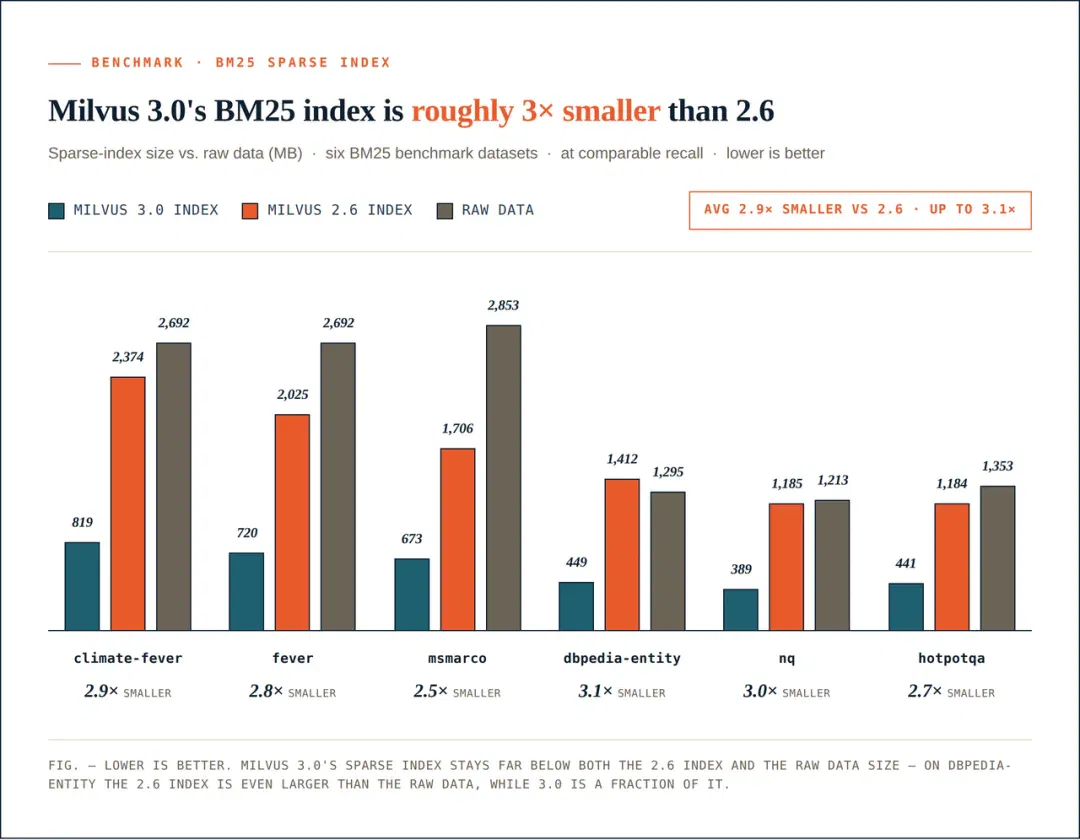
在 Milvus 3.0 中,Sparse Vector Search的存储占用得到了重磅优化:采用分块压缩的 Posting List(VByte + SIMD 解码),并引入量化技术将 Inner Product 存为 FP16、BM25 权重存为 U16。实测新索引体积仅为 Milvus 2.6 的 1/3 左右,显著降低内存占用与网络开销。
Milvus 3.0 还引入了一种针对 SPLADE 这类学习型稀疏向量优化的新检索算法。这类向量产生的倒排列表比 BM25 稠密得多,导致重度依赖剪枝的检索算法会把大量 CPU 时间花在"判断哪些可以跳过"上。SINDI 换了一条思路:将倒排项组织成紧凑的窗口,配合 SIMD 友好的得分累加方式批量处理;同时采用无损剪枝,保证检索结果不受影响。
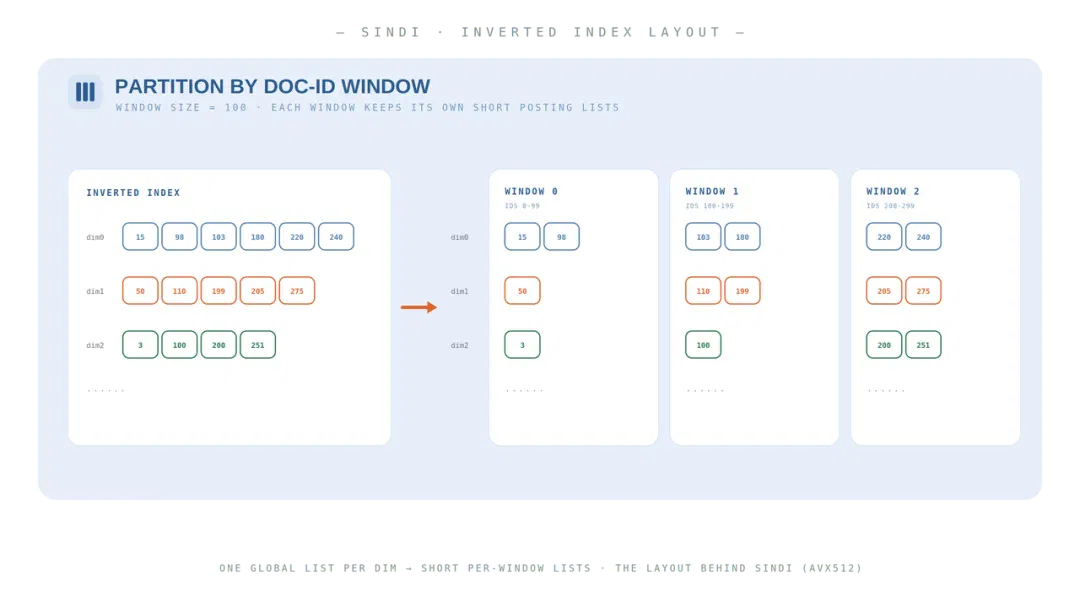
我们还扩展了 SINDI 的原始设计,加入原生 BM25 支持。这样,传统全文检索和 Learned Sparse Retrieval 都可以使用同一条经过优化的稀疏检索路径。
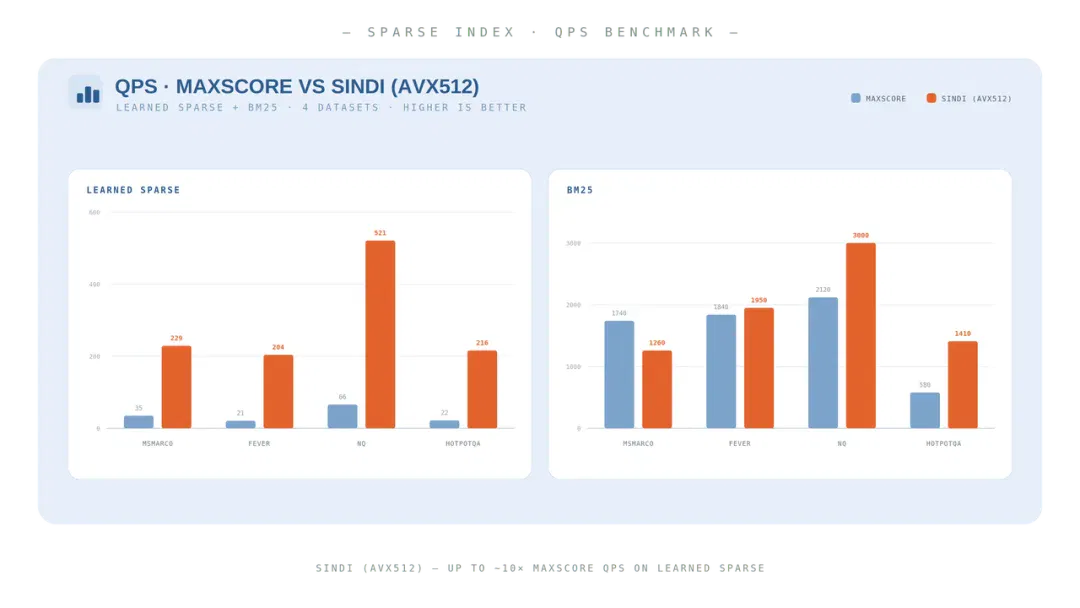
在四个 SPLADE 稀疏向量数据集的测试中,SINDI 的 QPS 最高可达到 MaxScore 的约 10 倍;即使在表现最弱的数据集上,也达到约 5 倍。
03
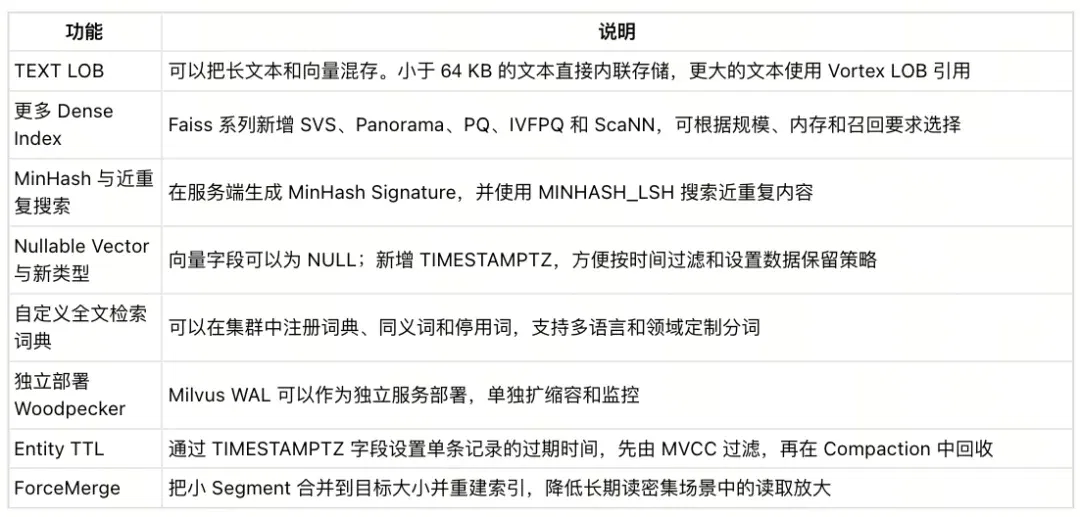
更多重磅增强一览
04
路线图规划
接下来,Milvus 将沿着 3.0 的架构方向持续深耕,进一步缩短“在线检索”与“离线数据迭代”之间的距离。让团队在搜索、分析、优化或服务向量数据时,再也不用频繁地将数据搬运到另一套独立系统。重点功能预告如下:
- 为 External Collections 补充谓词下推能力(Predicate Pushdown);
- 完善外部回填(External Backfill)机制;
- 加入更多 Spark 向量计算算子;
- 拓展支持更多开放表格式,如 Delta Lake 和 Apache Paimon。
One more thing
Milvus 3.0 和 Zilliz Vector Lakebase有什么异同
Milvus 3.0 实现了 Milvus 项目发布以来最重磅的架构升级,为生产级AI 检索和新兴的 Vector Lakebase 架构奠定了开源基础,该架构能以更高性价比将湖原生存储与高性能向量检索结合在同一数据源上
Zilliz Cloud 是由 Milvus 原厂团队打造的、面向生产级 AI 的全托管向量数据库 (Vector Database) 和向量湖库平台 (Vector Lakebase)。它与 Milvus 共享同一套分布式、湖原生架构,并 100% 兼容 Milvus API。其自研 Cardinal 引擎在同等召回率与资源消耗下比开源 Milvus 索引快 10×,具备可缩容至零的弹性算力,提供业界首个跨区域容灾能力、BYOC、以及最严格的企业级安全与合规(SOC 2、HIPAA、ISO 27001 和 GDPR),以及最高 99.99% 的 SLA。
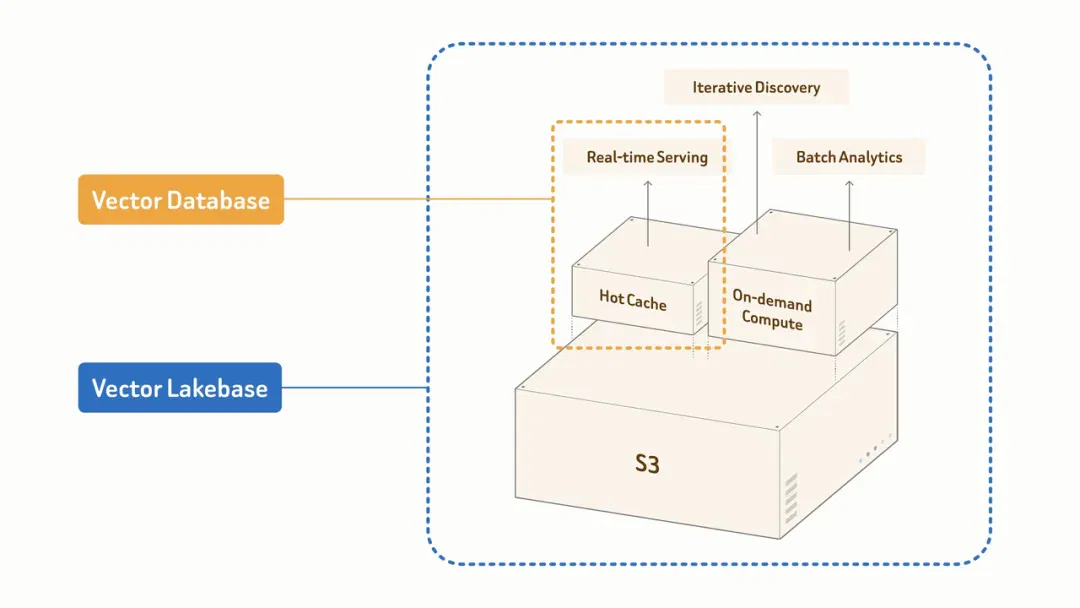
开发者可以自行部署开源版 Milvus,也可以直接使用全托管的 Zilliz Cloud——两者都能覆盖 AI 数据生命周期中的多类工作负载。
文章来自于微信公众号 “Zilliz”,作者 “Zilliz”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
官宣:Milvus-backup 0.6 发布,Milvus 备份恢复提速 1.6 倍 (opens in a new tab)
在 Milvus 集群迁移、故障恢复或测试环境搭建中,备份和恢复都是常见操作。但备份成功之后,数据距离能够正常查询,还需要经过导入、索引重建和加载等步骤。比如对大规模向量数据来说,索引重建尤其耗时。
1G内存检索2500万向量,Milvus中如何用FLAT在强标量过滤场景搞定毫秒响应? (opens in a new tab)
前几天在 Milvus 社区,一位做以图搜图的朋友提了一个问题:
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎 (opens in a new tab)
过去八九年,我们一直在做一件事:把向量数据库从一个很小众的系统方向,做成 AI 基础设施里的关键组件。
RAG效果不理想,怎么优化?Recall太低,是Milvus的问题吗? (opens in a new tab)
RAG 系统上线后答案出错,绝大多数团队的第一反应都是换更贵的模型、反复调试 prompt。
多轮对话时,RAG反复做重复召回,模型层与Milvus层分别如何解决? (opens in a new tab)
做 RAG 的团队,基本都会在多轮对话上吃过亏。