抢完互联网数据,AI公司开始抢绝版纸质书
2026 年 4 月起,一位专营稀有书和低流通量图书的美国书商遇到了怪事:他店里的生意向来不算火爆,一周卖出二十本已经算不错,但最近,订单突然像洪水一样涌来,每周能卖几百本。最费解的是,买家只列出一份用国际标准书号(ISBN)索引的书籍清单,却从不询问品相,也不砍价。
2026 年 4 月起,一位专营稀有书和低流通量图书的美国书商遇到了怪事:他店里的生意向来不算火爆,一周卖出二十本已经算不错,但最近,订单突然像洪水一样涌来,每周能卖几百本。最费解的是,买家只列出一份用国际标准书号(ISBN)索引的书籍清单,却从不询问品相,也不砍价。
在大洋另一端,荷兰哈勒姆的古董书商彼得·德弗里斯(Pieter de Vries)收到了一封来自新加坡公司 2077AI 的邮件,对方要求采购近 3,000 本书。同一时期,德国、瑞士、西班牙的旧书商也接到了来自加拿大公司 Zoom Books 的大批量订单,这些书涉及的领域多种多样,令人捉摸不透意图。
世界上怎么突然冒出这么多求知若渴的“人”?荷兰当地媒体着手调查,结果发现,这些订单似乎并不来自普通藏家,也不像学校或图书馆的采购。
直到 Anthropic 的一则秘密扫描项目曝光,所有线索汇集在一起,真相终于水落石出:订单的来源是几家 AI 公司,所有买到的书会被扫描喂给大模型,落得尸骨无存的下场。
大模型行业正在上演现实版“饥饿游戏”
在收集实体书日益成为小众爱好的当下,AI 厂商为何转而盯上了书商们的书架?这还要从 2024 年延续至今的大模型数据危机说起。
驱动大模型智能的核心是海量高质量文本。过去几年,训练数据的主要来源是互联网:维基百科、Reddit、新闻网站、博客、开放论文……但很快,生成式 AI 爆发,大量 AI 生成的文本涌入网络,反过来污染了互联网语料库。这导致模型在自己的输出上反复训练,质量螺旋式退化,最终趋于胡言乱语,研究者将这种现象称为“模型坍塌”(model collapse)。
因此,2022 年之前出版的纸质书就成了最后的干净数据源。它们主要由人类撰写、编辑、校对而成,语言精炼、结构完整,在物理层面上不可能包含 AI 生成内容。正如图书元数据数据库公司 ISBNdb 所言:“世界上最好的 AI 训练数据正摆在书架上。”
文本的纯净度是一方面,竞争维度同样关键。书商手中握着不少发行量极少的稀有书籍,如果一家 AI 公司把它全买回来,扫描后再销毁,就将成为自家模型的独有优势,书架由此变成“兵家必争之地”。
只是,与网页不同,书不能直接抓取。要将其变成训练数据,需要一些更暴力的破坏手段。
2026 年初,一份由美国地区法院解封的 4,000 多页法庭文件揭开了 Anthropic 公司内部一个代号为“巴拿马计划”(Project Panama)的秘密项目。
项目始于 2024 年初。此前,Anthropic 联合创始人本·曼恩(Ben Mann)在 2021 年个人下载了数百万本来自影子图书馆 LibGen 和 Books3 的盗版书籍,用于早期模型训练。这些行为给公司带来了严重的法律风险。
为寻找一条更安全的路径,2024 年 2 月,Anthropic 聘请了谷歌图书(Google Books)项目的前合作负责人汤姆·图尔维(Tom Turvey)。内部规划文件毫不掩饰地写道:“巴拿马计划代表了我们破坏性扫描世界上所有书籍的努力。”
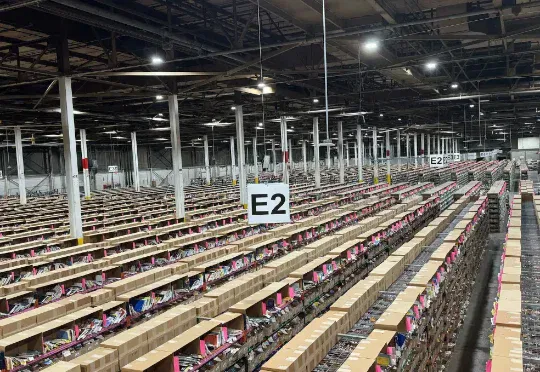
流程大致如下:公司先从大型二手书商处大量采购纸质书;这些书会先被切掉书脊,再经由高速工业扫描仪逐页数字化;扫描完成后,纸张作为回收物处理,不留实体副本。按照项目供应商的说法,这一计划的规模是六个月内处理 50 万到 200 万本,整个项目仅花费数千万美元,放在模型训练的总开销中算是微不足道。
同样是做大规模书籍数字化,汤姆当年负责的谷歌图书保留实体原件,并向公众开放了搜索和片段浏览;“巴拿马计划”却截然不同,后者在提取内容后销毁书籍、全程保密,产出的数字副本也仅供内部使用,永远不会向公众开放。
Anthropic 内部很清楚,这件事一旦暴露,会引发汹涌的舆论攻击。但整件事的最荒谬之处在于,“巴拿马计划”的每一步,在美国现行法律下都是合法的。换言之,AI 公司几乎不会为此付出实际代价。
合法的荒谬
2025 年 6 月,加利福尼亚北区联邦地区法院法官威廉·阿尔萨普(William Alsup)在 Bartz 诉 Anthropic 一案中作出裁定:扫描合法购买的实体书用于 AI 训练,属于“转化性合理使用”,受美国版权法第 107 条保护。
裁定逻辑分三步:其一,书是合法购买的,依据首次销售原则,买家有权处置;其二,每本纸质书都在购买后被复制为数字版,因此具备转化性;其三,数字副本并未被再分发、销售或对外展示。三项条件成立,故属合理使用。
这段推理无意中创造了一个悖论:销毁原件反而让 AI 企业在法庭上更有利。企业可以主张是为了节省存储空间和便于检索,用数字副本“替代”了实体副本,这在客观效果上奖励了销毁行为。此后,在涉及 OpenAI 和 Meta 的独立版权案件中,其他联邦法官作出了类似裁定。
更诡异的是,要想合法扫描并销毁,必须得用正版书。
Anthropic 早年使用的影印扫描书籍已经被认定属于违法侵权。2026 年 7 月 20 日,法官阿拉塞莉·马丁内斯-奥尔金(Araceli Martinez-Olguin)批准了 15 亿美元的最终和解协议,覆盖 48 万余部作品。截至 2026 年 5 月,Anthropic 的年营收已达 470 亿美元,这笔和解金只占其中的 3%。
法律开了绿灯,规模足够可观,但问题是,这个项目为什么能藏这么久?
无法溯源的影子产业链
前面提到的 ISBNdb,是理解这条隐秘产业链的关键节点。
这家公司成立于 2001 年,原本是为图书馆、书店和出版商提供书籍索引服务的元数据平台,其目录中收录超 1.11 亿本书。随着 AI 行业爆发,它转型成为 AI 公司批量采购书籍的中间商。
ISBNdb 在网站上公开营销:“为大模型训练需求定制印刷书籍采购服务,以 AI 所需的规模交付。”并承诺,能获取散落在图书馆书架、二手书店和绝版目录中的书籍,每单规模从 1,000 本到 100 万本不等。它还提供严格的保密协议:“你的身份、策略和采购目标永远不会被披露。”
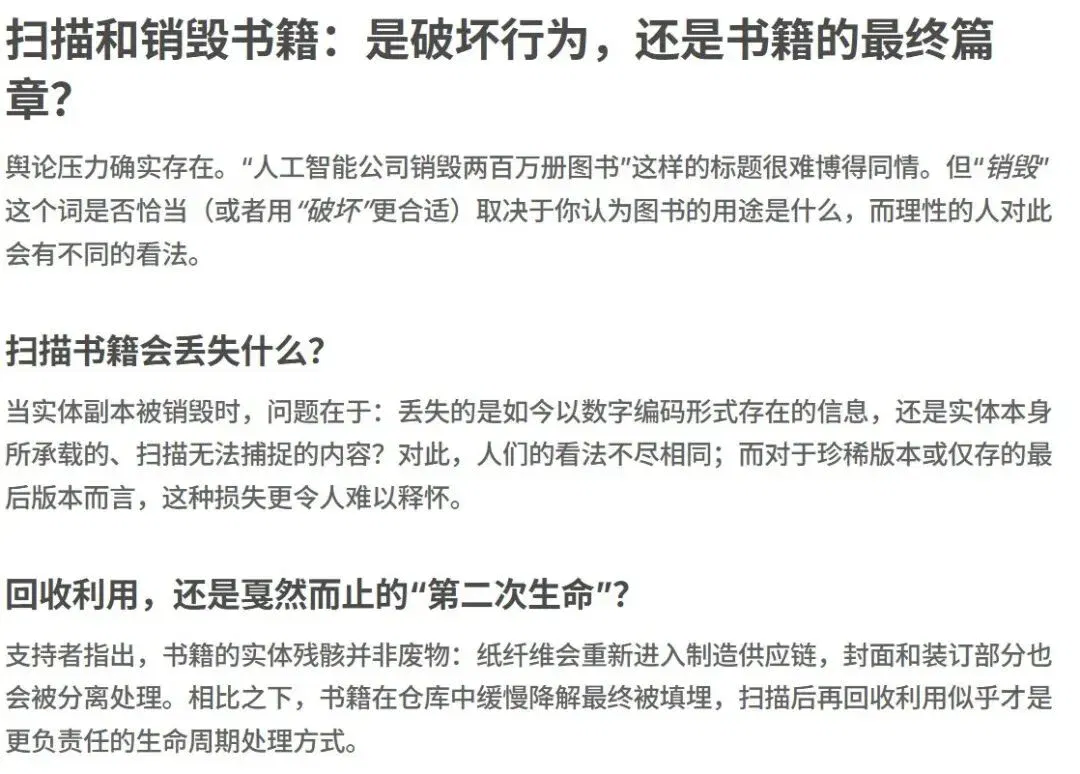
在一则博客中,ISBNdb 甚至大言不惭地承认:“舆论压力确实存在。(帮助)‘AI 公司销毁两百万本书’并不是一个能博得同情的说法。”还试图重构叙事,强调纸张会作为回收物重新进入供应链,并将整个行为定义为“数字化保存”。
(来源:ISBNdb)
7 月底,产业链彻底曝光后,ISBNdb 删除了网站上的 AI 采购专页以及关于保密协议的承诺表述。但很快,该页面又恢复上线,甚至引用了威廉法官在 Bartz 案中的判决作为法律背书,大张旗鼓地继续做生意。
当然,ISBNdb 不是唯一的中间商,新加坡的 2077AI、加拿大的 Zoom Books 都曾出现在欧洲书商的采购邮件里,但依然没人知道委托它们购书的大客户是谁。
不可能吃饱
AI 公司为了获取数据,正在不可逆地消耗人类文化遗产。但即使把全世界的书架都搬空,可能也解决不了 AI 的根本问题。
数据统计显示,人类历史上总共出版过约 1.3 亿本独特书籍,能提供大约 30 到 40 万亿 tokens 的文本量。而下一代大语言模型需要的训练数据或将达到 100 万亿 tokens 量级,即便把有史以来所有的书都扫完,也喂不饱它们的需求。
以 Anthropic 为首的 AI 公司的做法,已经在业内激起巨大波澜。
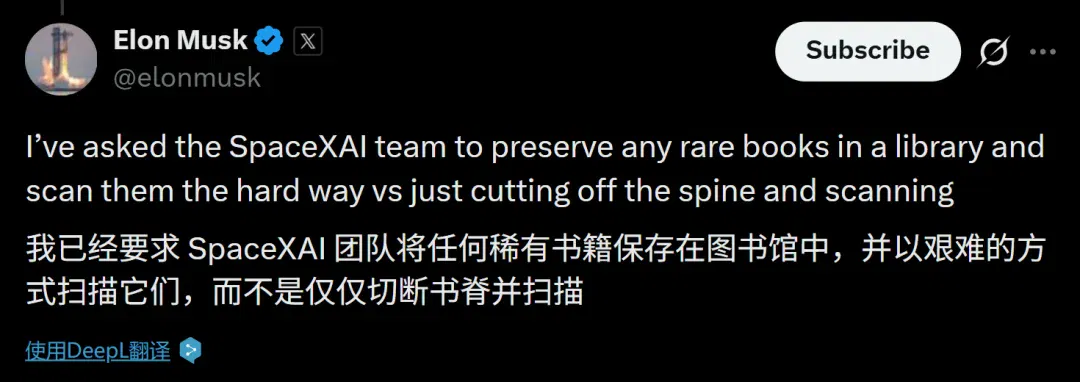
埃隆·马斯克(Elon Musk)称他已要求自己旗下的 AI 团队保留稀有书籍,用非破坏性方式扫描。前 AI 行业高管、非营利组织“公平训练”(Fairly Trained)创始人埃德·牛顿-雷克斯(Ed Newton-Rex)表示,巴拿马计划的曝光是科技巨头与创作者之间权力失衡的又一证据。
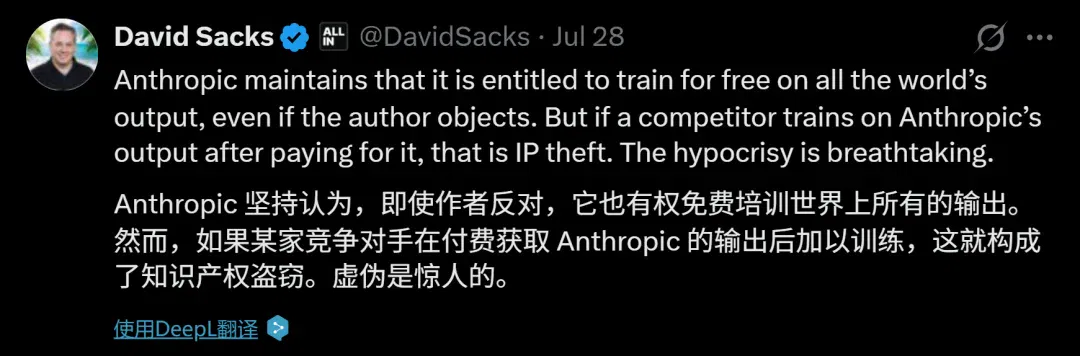
白宫科学与技术顾问委员会主席大卫·萨克斯(David Sacks)则锐评:“Anthropic 坚持认为它有权免费用全世界的产出来训练,即使作者反对。但如果竞争对手在付费之后用 Anthropic 的输出来训练,就是知识产权盗窃。这种伪善令人叹为观止。”
(来源:X)
先前多起与 AI 训练有关的版权诉讼中,作者群体的愤怒是普遍且合理的:AI 公司在未经许可、未给予补偿的情况下,将创造性劳动变成了商业 AI 产品的原材料。
这次,Anthropic 买下的书籍,作者可能在几十乃至数百年前就去世,著作权的追讨无从谈起,但其规模之巨,已对人类文明构成了打击。
回到开头,那位察觉到自己生意突然变好的美国书商,在采访中流露出一种复杂的犹豫:“我个人对这一切的感受很复杂。它在经济上对我有利,也帮我清掉了不太可能卖出去的老书。我的库房里有很多来自海外和外语的书籍,的确很适合做这种生意。但另一方面,我不喜欢这个最终用途,我不喜欢这些稀有的书籍被变成纸浆。”
参考内容:
https://www.washingtonpost.com/technology/2026/01/27/anthropic-ai-scan-destroy-books/
https://www.404media.co/ai-companies-are-buying-tons-of-old-books-because-theyre-free-of-ai-slop/
https://www.courtlistener.com/docket/69058235/bartz-v-anthropic-pbc/
https://isbndb.com/blog/print-books-sourcing-ai-training/
注:封面/首图由 AI 辅助生成
文章来自于微信公众号 “DeepTech深科技”,作者 “DeepTech深科技”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
全球最大线上书店,正悄悄为 AI「焚书」 (opens in a new tab)
一批纸质书被买下,送进仓库。 工作人员切掉书脊,把完整的书拆成一页页散纸,再送去扫描。文字被留下,原来的书却无法恢复。 如果我告诉你,这是 Anthropic 为了 AI 干的,你可能不会太意外。 但如果我说这次干这事的公司,是全球最大的「线上书店」亚马逊呢? 404 Media 在一批旧书里放入追踪器,发现它们一路被送到拉斯维加斯的一座 亚马逊设施。员工向该媒体描述,公司收到纸质书后,会切掉书脊,再把散开的纸页送去扫描。 亚马逊回应称,公司通过商业渠道购买这些书,用于开发和改进客户使用的产品与服务。 有意思的是,亚马逊当年就是靠卖书起家的。 现在,一些书到了它手里,先见到的却是扫描仪。 AI
Mercor announces $750 million Series D, reaching a $20 billion valuation (opens in a new tab)
According to the company and investors, the round includes employee share sales. The funding will support model evaluation, post-training infrastructure and work environments for agents.
两个00后给英伟达供数据,AfterQuery估值215亿 (opens in a new tab)
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
全世界最强的AI,都在“抄”这群普通人的作业 (opens in a new tab)
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
重生之我在 Anthropic 做耗材 (opens in a new tab)
我重生了。 上一世,我是一本人工智能教材。学生在我的页边写满笔记,工程师折起其中几页,也有人把我放在书桌最显眼的位置。我一直相信,书存在的意义,就是把自己知道的事情交给更多人。