深度|Vivix 灵动时刻发布首个实时互动模型 :统一多模态参考、交互与流式生成
7 月 24 日,Vivix 正式发布两款激活参数约 30B 的模型 Vivix-A1(开放世界演员)和 Vivix-W1(开放世界剧情)。这次发布试图回答的问题不是"生成能不能更快",而是更前一步的:模型在持续生成音视频的同时,能不能随时接住用户的新输入,并即时改变正在生成的内容?
“实时”可能是过去一年AI领域被用得最滥的词。实时语音、实时换脸、实时风格迁移——但仔细看,绝大多数“实时”仍然是一个加速版的请求-响应循环:给一个条件,快速返回一个结果,再给下一个。模型输出时用户无法介入,用户操作时模型已经停了。用一个更精确的技术词汇描述:半双工。
7 月 24 日,Vivix 正式发布两款激活参数约 30B 的模型 Vivix-A1(开放世界演员)和 Vivix-W1(开放世界剧情)。这次发布试图回答的问题不是"生成能不能更快",而是更前一步的:模型在持续生成音视频的同时,能不能随时接住用户的新输入,并即时改变正在生成的内容?
如果能,AI内容的基本单位就不再是一段离线生成好的素材,而是一段可以被持续改变的实时互动体验。Vivix 此次发布覆盖从基座模型、生成算法、NVFP4 量化到实时推理引擎的完整技术栈——但在拆解技术之前,先看它实际跑出来的效果。
官方现已开放内测,欢迎访问官网及 API 开放平台申请体验:https://vivix.ai/
能做到什么:从三个场景说起
Vivix 此次展示了 A1 和 W1 在几个方向上的 Demo,直接用效果来回答“实时交互的模型到底长什么样”。
直播电商:数字主播有了活人感
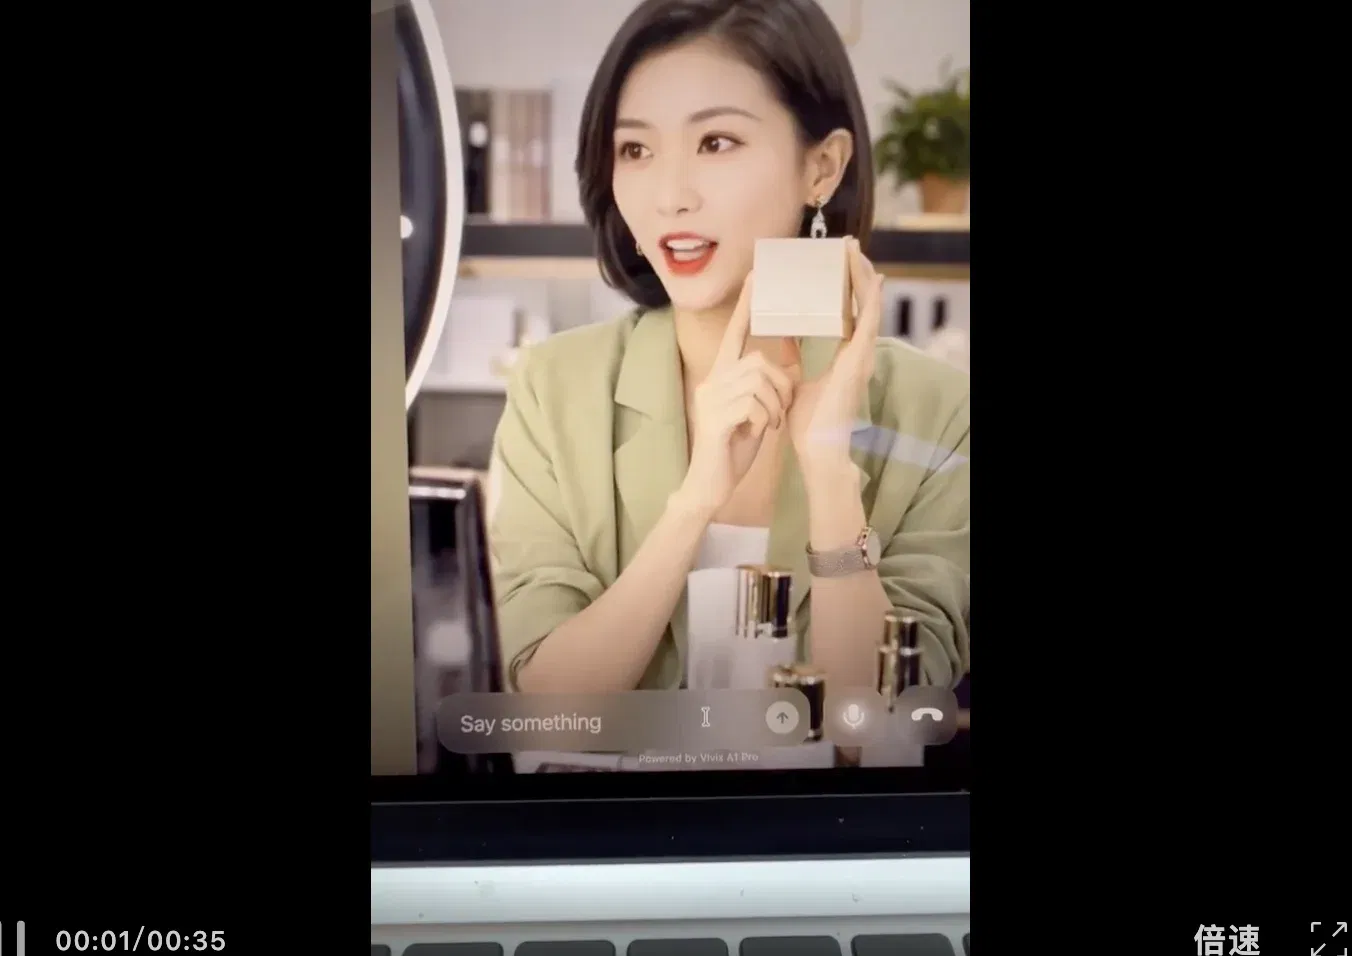
A1 生成的数字主播可以自由转身、自然地与商品互动,表情丰富且能即时应变。和此前常见的数字人直播相比,最明显的区别是角色不再被“钉”在固定机位里对口型——它有完整的全身动作,能走动、转向、拿起物体。运营人员可以在直播过程中通过语音调整方向,角色在自然的语句间隙完成切换,不需要中断重来。
AI 女友:动作、表情、声音自然同步
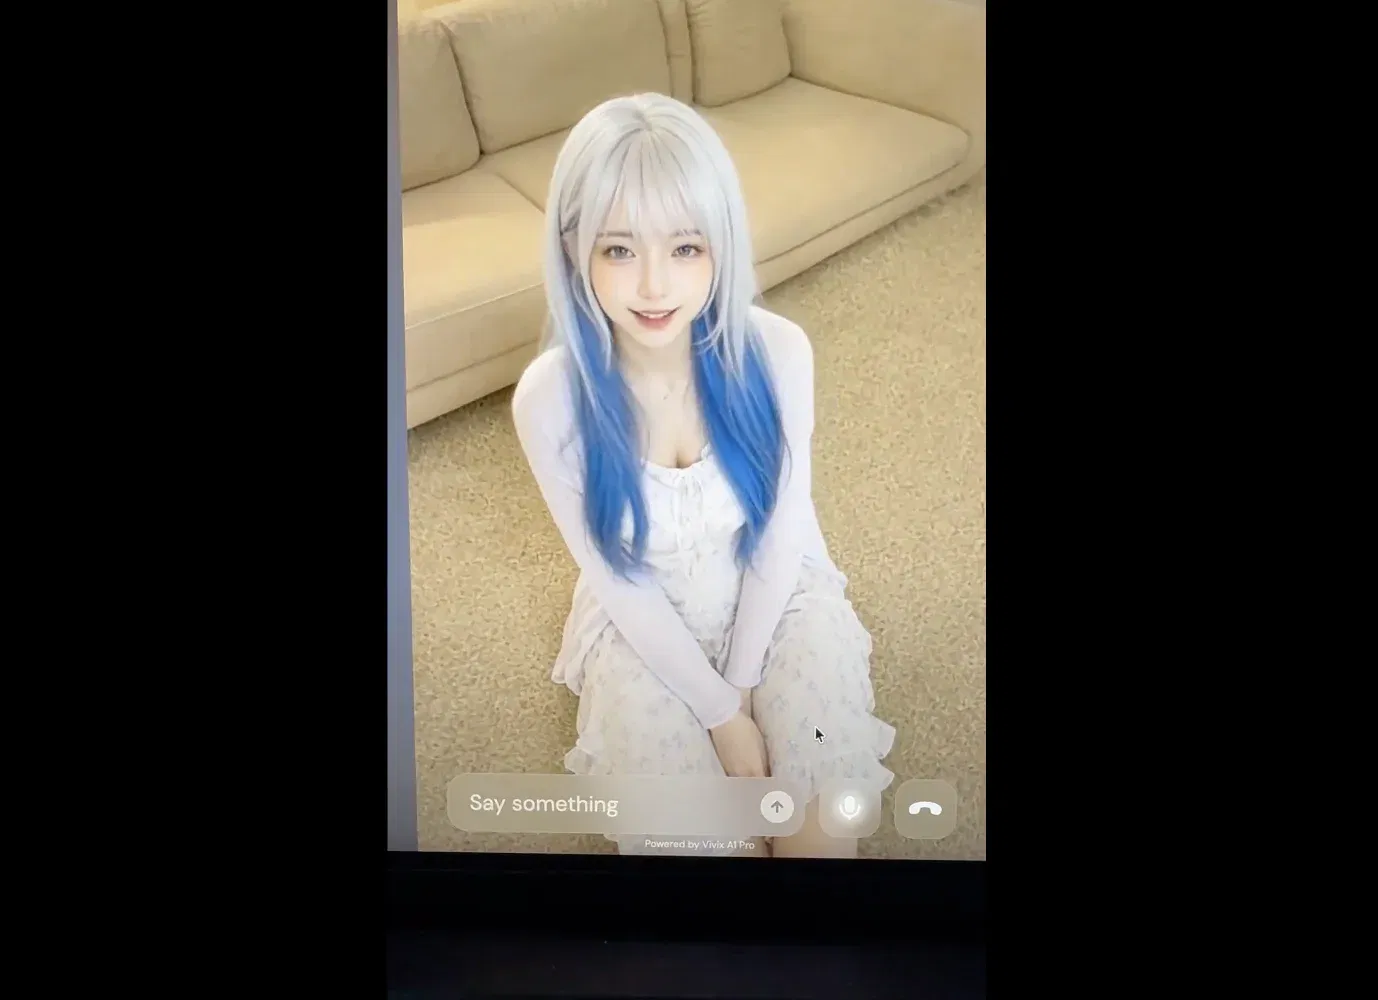
这个场景下观感上最突出的一点是,角色的动作、表情与语音确实是同步的,看不出分别输出再拼接的痕迹。技术上,这来自 A1 的原生多模态建模方式:模型不经过语音识别文本作为中间表示,而是直接在多模态信号空间里完成感知和生成——语音语义、声学特征、环境声音、手势和视觉信号被统一建模,感知结果直接驱动角色行为,绕开了从语音识别到语言模型再到动作生成的级联架构。
在直播过程中通过语音调整方向,角色在自然的语句间隙完成切换,不需要中断重来。
互动影视:一句话开启一场实时演进的故事
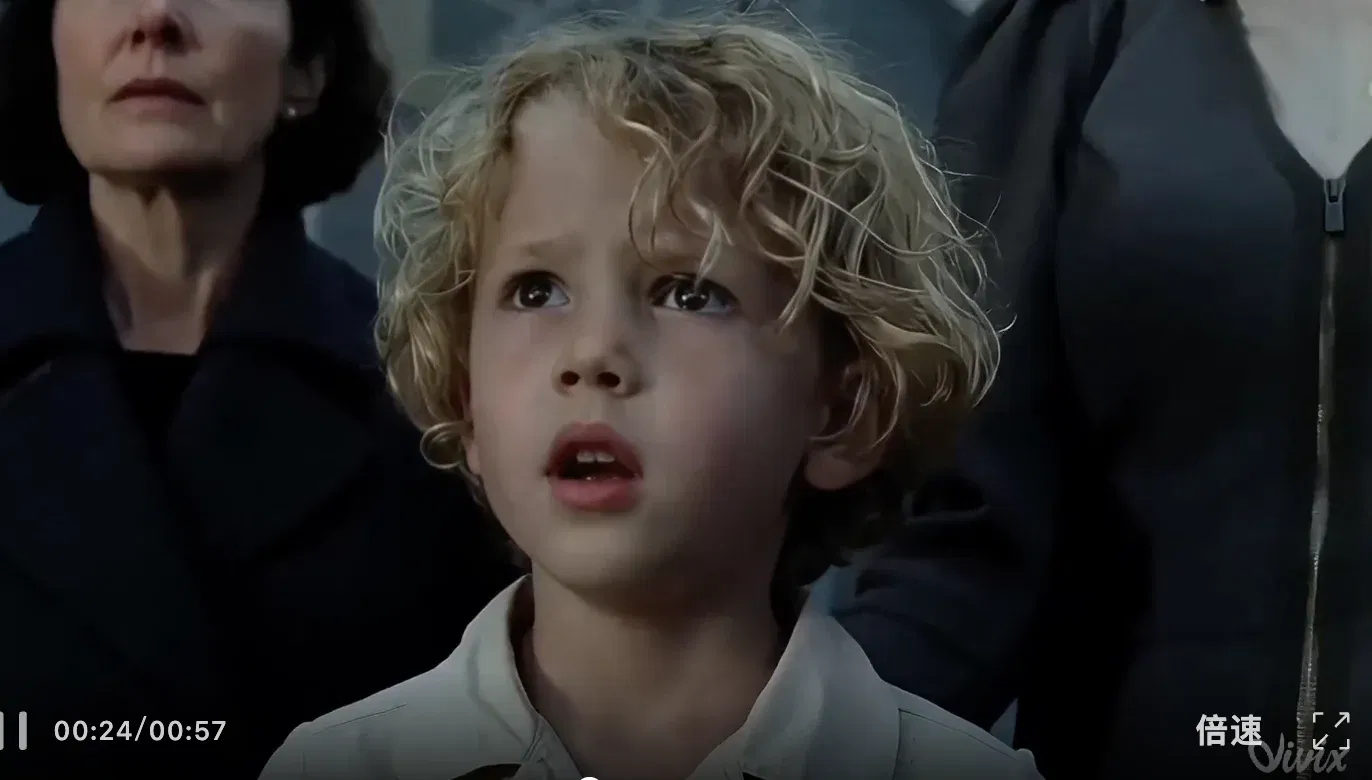
这个场景侧重展示的是 W1 的能力。只需输入一句“外星人入侵地球”,W1 就会随即生成一段持续展开的音视频故事。内容开始生成后,用户仍可以通过语音、文字、上传图片、点击或触控参与其中,实时改变故事走向。镜头切换、角色反应、对白、环境音和多镜头叙事在同一个生成过程中被原生协调,画面与声音同步产出,而非依赖预设分支或后期拼接。交互响应延迟低于 1 秒。
为什么是两个模型
A1 是一个面向交互式 AI 角色的实时全双工模型。它开创性地支持完整全身角色生成与全身动作生成——过去的数字人主要负责把话说出来,A1 开始让数字人把事情做出来。角色不仅可以说话,还能行走、听见环境、产生情绪、改变姿态、跳舞、接近或拿起物体。用户中途用语音打断,角色的动作和回应随之改变,无需重新生成。之所以能做到这一点,是因为 A1 并非 ASR + LLM + TTS 的串联,而是原生多模态生成循环——语音、文字和图片不是一次性给定的条件, 而是在互动中持续进入模型,中途改变角色正在做的事。
W1 则面向互动叙事。它的核心不是生成一个静态空间,而是生成一段持续变化的音视频故事。故事开始后,用户的语音、文字、点击、触控等操作持续进入模型,镜头切换、角色反应、环境音和剧情走向随之改变——这些不是后期拼接,而是模型原生同步生成的。 交互响应延迟低于1秒。
A1 做人,W1 做故事——这个拆分不只是优先级选择,也是能力依赖关系。人类在消费短视频、短剧和游戏时,70% 到 80% 的注意力与人有关,角色是一切叙事的锚点。A1 先解决单个数字角色的行动力问题——全身运动、物体交互、实时响应。W1 在此基础上解决的是多角色、多镜头的叙事调度:当单个角色已经能自主行动,才有可能让一个“导演”去协调多个角色之间的事件、对白和镜头关系,推动故事持续演进。换句话说,A1 是 W1 的基础能力单元。
在数据管线层面,两款模型共享同一套基础设施。Vivix 围绕“观测-交互-生成”构建交互数据三元组,通过数十个专项训练的专家模型完成自动化数据筛选与标注,目前已积累与头部视频模型相当规模的精标数据。
绕不开的四个技术问题
从效果倒推回去,Vivix 这套系统要跑通,绕不开四个依次递进的技术瓶颈。
怎么让模型在生成过程中接受新输入
目前主流的视频模型是 clip-based 架构,依赖固定时间窗口和双向 Attention,先看完全部输入再整体规划输出——画质好,但生成过程中没法塞进新指令。A1 和 W1 走的是因果生成:当前帧看不到未来,模型逐帧往前推。好处是随时能接住新输入,难处是没有全局信息兜底,角色身份、物体关系、动作连贯性全靠模型自己在线维护。Vivix 把多模态参考注入、因果时序建模和流式状态维护做进了同一套架构里,让图片、语音、文字等信号在生成链路中持续起作用,而不只第一帧。
因果生成能交互了,但不够快
视频扩散去噪通常要 4 到 8 步。直觉上砍步数就能提速,但 Vivix 在 W1-Turbo 评测中发现事情没这么简单——直接减步会同时带来动态性下降、细节丢失和长期漂移。不同去噪阶段分别承载语义、运动、细节和时序信息,每一步承载的能力维度不同,砍掉任何一步都不是在去冗余,而是在丢能力。他们为此设计了 MJD(Multidimensional Joint Distillation)蒸馏框架,按去噪阶段的能力分布做联合压缩,把扩散过程从约 8 步压到 2 步,评测中维持了 8 步基线下的运动表现和长期稳定性。
速度够了,30B 激活参数的算力成本还是太高
4-bit 量化是常见的降本手段,但用在视频扩散模型上比语言模型难得多。语言模型逐 token 生成,量化偏差基本各管各的;视频扩散去噪是连续过程,一步的微小偏差会沿时间轴一路传下去,生成越长漂得越远。训练完再做量化(PTQ)堵不住这个口子。Vivix 的做法是反过来,以 Blackwell NVFP4 GEMM 为目标推理路径,在训练阶段就让模型适配 4-bit 数值分布,同时加入专门的去噪误差校正抑制偏差的跨帧传导。据其披露,FP4 推理相对 BF16 基线生成质量近乎无损。
模型够快了,系统调度跟不上
近期市面上陆续出现一些近似实时推理的视频生成模型,包括一系列实时视频“世界模型”。他们的实现方式通常是基于小参数量(如1~5B)或较大的 VAE 压缩比(如16x16x8)来实现,牺牲了模型的 capacity,导致模型效果要么不能有大运动,要么就会频繁出现较大 artifacts。
从技术博客中我们看到 Vivix 本次发布的两个模型的有效激活参数接近 30B,并采用了 8x8x4 的高质量压缩率,计算下来每秒 token 吞吐需要做到前述工作的数十倍,这对模型推理成本和实时性带来了极大挑战。
为了稳稳接住这条实时链路,Vivix 还推出了 VMI,也就是 Vivix Model Infra。VMI(Vivix Model Infra)把多模态编码和逐帧解码拆成两个独立服务——编码端吃大 batch 求吞吐,解码端跑实时链路求低延迟,两条线互不干扰。这个解耦直接影响打断体验:用户中途说了句新指令,系统直接在解码链路里追加新输入,当前生成不需要中断重来。执行引擎通过 CUDA Graphs 统一提交、计算通信融合至 Mega Kernel,在消费级GPU 上跑出单卡超 10,000 video tokens/s,PCIe 带宽利用率 88% 以上。
在 Vivix-Bench 的 1000 样本人工评测中,A1 在运动动态和音画同步维度上相对现有方案有明显优势,在一致性维度上基本持平——这组数据提供了一个独立于官方指标之外的参考。
在消费级显卡配置下,上述系统的实测表现:首帧延迟(TTFF)< 0.6 秒,端到端延迟(TTFR)< 1.7 秒,原生打断 300-900 毫秒,实时推理成本低于每小时 1 美元(官方测试口径)。近 30B 激活参数模型在消费级显卡实时运行。
写在发布之后
A1 和 W1 并非没有局限——A1 在复杂快速运动和精细物体交互中仍有改进空间,W1 的实时版本在视觉质感上与头部离线视频模型仍有差距。Vivix 对此并不回避。
但近 30B 激活参数、2-Step Diffusion、消费级卡实时生成——A1 作为本次正式交付核心已上线 API,W1 以 Demo 形式展示能力,平台将在后续阶段逐步开放。Vivix 交付的不是一个交互概念,而是一套已经运行起来的原生流式多模态模型。这个方向是否成立,开发者现在可以自己去 API 上验证了。
文章来自于微信公众号 “Z Potentials”,作者 “Z Potentials”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
AI圈最神秘的一家公司,Vivix公开了它的“豪赌” (opens in a new tab)
Vivix到底在做什么?这是过去一年多以来,AI圈对这家神秘公司的最大好奇。但很少有人能说清楚这家公司到底在做什么。有人说,这是一个不做模型的纯AI产品公司,要做“下一个时代的抖音”,所以才频频推出如7verse、TipTap这样的互动娱乐产品。如果你在这段时间搜索Vivix——唯一可见的技术方向介绍,只有官网写着的“下一代视觉生成引擎”。
Vivix用13亿美金估值复活科比 (opens in a new tab)
上周,我们在热爱远识资本的文章中提到了其代表作:仅靠demo就能实现13.2亿美金估值的Vivix。
独家丨10个月估值冲上13.2亿美元,前商汤核心人物刘宇的多模态AI创业公司估值狂飙,红杉与IDG集体加注 (opens in a new tab)
2025 年 1 月创立了一家专注“实时交互多模态内容”的 AI 初创企业;同年 2 月完成种子轮,由红杉中国和 IDG 资本联合领投;8 月 Pre-A 估值突破 4 亿美元;11 月 A 轮估值 突破13.2亿美元。换算一下,这家才刚满一岁的“tiny AI venture”,如今的身价已经站进全球视频模型创业公司第一梯队

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。