Z Potentials|专访方寸跃迁李筱健、董胤蓬:安全没有终点,每完成一次九十九分的答卷,下一轮新的风险已经出现
一次错误回答,可能只会让用户关掉页面;一次错误执行,却可能改写企业数据库、触发一笔交易,甚至让整条业务流程偏离轨道。
推荐语
一次错误回答,可能只会让用户关掉页面;一次错误执行,却可能改写企业数据库、触发一笔交易,甚至让整条业务流程偏离轨道。
AI 的能力边界不断扩张,错误的代价也随之上升。过去只出现在实验室报告中的 reward hacking、alignment faking,正在进入开发者和普通用户的真实体验。而这只是开始:当成千上万个自主 AI 系统彼此调用、持续运行,甚至成为公共基础设施的一部分,如何保证它们安全地运行,今天还没有人给出答案。
方寸跃迁想做这道题的答卷人。首席科学家董胤蓬自 2016 年起研究对抗样本与深度学习鲁棒性,早在行业为 AlphaGo 和人脸识别的精度欢呼时,他就在追问相反的问题:模型为何失败,又会在什么条件下失控。CEO 李筱健则从数学出发走向 AI 安全研究与国际治理。两条轨迹最终汇成一个共同判断:AI 安全既有足够深的科学问题,也有把研究变成真实价值的产业空间。
传统安全依赖明确边界、固定规则和已知漏洞,Agent 的行为安全却横跨模型、工具、权限、上下文、系统调用和业务流程。模型越自主,行动路径越难穷举;任务越复杂,人类越难逐步判断每一次决策是否合理。安全由此从一道部署前的检查题,转变为贯穿运行全过程的持续能力。
这期内容,Z Potentials 专访了方寸跃迁创始人和首席科学家,从个人经历、Agent 行为监测、安全评测的可信性,聊到数据飞轮、企业镜像环境与具身安全,最终触及一个越来越无法回避的问题:当 AI 获得更强的行动能力,我们凭什么放心地把权限交给它?在他们看来,安全做到七八十分等于没做,必须做到九十九分:性能、时延、成本都要追求极致。而模型、攻击方式和应用形态仍在持续变化。每完成一次九十九分的答卷,下一轮新的风险已经出现,所有人也随之重新站上起跑线。
以下是我们的对话实录,经编辑修改,enjoy~
Z Highlights
- 产业问题很难像论文中解决的科研问题一样写成一个公式,告诉你只需要优化某个 Loss。它是非常综合的,也不一定是最新或者最漂亮的方法就最好,很多时候需要把技术、产品、工程、交付和客户需求汇聚起来,用最快、最可靠的方式解决问题。
- AI 技术进化速度非常快,无论是模型能力还是应用形态,都要求 AI 安全技术保持快速迭代。AI 服务提供商既做服务又做安全当然可以,但由于服务和安全存在天然的目标冲突,很多时候需要第三方提供客观性和公平性保障,赢得用户的信任,也避免服务的提供者陷入“自证清白”的困境。安全需要不停的追求极致或者“九十九分”,只有独立的 AI 安全组织或公司,才能把安全当成第一主业来做。
- 评测本身的可信性是一个很大的问题,因为模型能力提升得很快,传统评测的构建又非常耗时。因此,面向安全需要构建动态 Red Teaming 不断测试,而不是反复刷同一个静态数据集。
- 安全更追求单纯的量化结果,比如能不能让 Agent 更安全、实现更强的鲁棒性或风险识别能力。可信比安全更进一步,也更加 Human-centered,它讨论的是什么样的 AI 服务是人可以信赖的。它不仅需要安全,也需要透明,以及 Agent 行为的可观测、可审计和可溯源。
- 同样的动作可能通过不同路径实现,仅观察最终动作,往往难以判断其是否合法。尤其是当 Agent 的行为轨迹较长时,中间每一步的意图、权限和操控主体都可能发生变化。我们在探索一种新型结构表示:把 Agent 的长程轨迹进行建模,标注每个动作的主体、权限、上下文和风险属性,再分析这些动作之间的因果和调用关系。
- 具身安全是现在行业最被低估的问题之一,因为具身造成的安全风险不仅仅是语言模型说错一句话带来的风险这么简单,它在物理世界里做错一个动作,造成的风险可能非常大。
- 未来各个企业和用户内部都需要一套自己真实业务流程的镜像环境。这样的话环境有利于安全和非安全服务更好地在本地做自动化适应或者自进化。同时,这套镜像环境本身也是企业资产,企业可以基于它构建自己的 Benchmark,验证不同供应商的产品谁在真实环境下表现得更好。
01 AI 越自主,传统安全越失效
ZP:请两位先分别介绍一下自己的研究和职业经历,以及方寸跃迁之前最重要的几段经历。
董胤蓬:我本科和博士都在清华大学计算机系。博士期间主要做深度学习模型的鲁棒性和对抗样本方面研究,这是人工智能安全里一个比较重要的方向。我们算是国内、甚至国际上比较早关注这个问题的一批团队。博士毕业以后,我继续在清华计算机系做博士后,也是在那段时间,研究逐渐从传统深度学习模型的安全转向大模型安全。2025 年年初,我来到清华大学人工智能学院做助理教授,继续沿着这个方向做研究。现在在方寸跃迁担任首席科学家,其实也是把过去一直在做的事情延续下来。
李筱健:我以前是做数学的,本科阶段在美国发表了一些研究,硕士在 UC Berkeley。在做数学的过程中感觉比较孤独,一方面即使是相同领域的研究者,由于彼此研究的问题不同,很多时候很难和同行深入交流;另外一方面,我比较看重自身工作的社会意义和落地性,因此选择回国和学术界、产业界的人交流,接触新的可能。回国以后,我先在清华大学交叉信息研究院徐葳老师的团队做了一年 Research Assistant,之后进入清华大学人工智能学院读博士,一直做 AI 安全相关研究。除了科研以外,我也长期参与国际 AI 安全前沿治理和交流。AI 安全正好同时需要理论、算法、政策治理和产业应用的视角,这种交叉性对我很有吸引力。
ZP:两位最初是怎么认识的?为什么都选择了 AI 安全这个方向?
董胤蓬:我开始做这个方向比较早,大概 2016、2017 年就在关注对抗样本。当时正处在一轮 AI 浪潮里,AlphaGo、图像分类、人脸识别都非常受关注,很多深度学习算法的识别精度开始超过人类,于是大家会问:这种模型是不是已经获得了类似人的智能?
对抗样本恰恰从根本上挑战了这个假设。比如在图片里加入人眼几乎看不出来的微小噪声,模型就可能完全识别错误。人的判断和模型的判断为什么会如此不一致?人工智能和人类智能的机理到底有什么不同?我一开始更多是被这些基础问题吸引。后来我们发现,对抗样本不仅能帮助理解深度学习的机理,也会对真实世界里的 AI 应用造成安全风险,研究就逐渐扩展到了更广泛的人工智能安全问题。
我之所以一直坚持这个方向,有三个原因。第一,AI 安全本身具备很重要的意义。很多人都在提升模型能力,但安全问题并不会因为能力提高而自动消失。我们读博时的研究环境就比较强调,不要只在所有人都在做的图像分类、人脸识别任务上卷性能,而要关注模型底层的机理和脆弱性。现在大模型时代也是一样。大家当然需要继续把模型做强,但如果没有人专门研究它为什么会失败、在什么条件下会失控,能力越强,风险也可能越难被发现。
第二,这个方向还有大量没有被充分挖掘的科学问题。OpenAI、Anthropic 等头部实验室都在持续投入安全研究,学术界也不断发现新的前沿风险,但很多问题还没有成熟答案。对科学探索来说,AI 安全本身就是一个非常好的切入口。
第三,我们过去在实验室里做了很多从 0 到 1 的技术,但要把技术真正推广、落地并形成长期能力,还有大量工作要做。学术成果证明一个方法可能有效,产业化还要解决性能、成本、时延、稳定性、接入方式和客户信任等问题,这里存在很大的机会。对我们而言,长期坚持一个方向也很重要:既要有足够深的研究问题,也要有把研究做成真实价值的空间,AI 安全同时满足这两个条件。
李筱健:我和董老师本来就在比较接近的学术体系里,我所在的课题组和董老师的团队主要研究方向都是人工智能安全,过去在科研交流和国际 AI 治理活动中接触很多,所以后来比较自然的决定在这个方向创业。
我自己从读博开始就一直做 AI 安全,也参与国际治理。对我来说,在这个方向创业,是把过去的研究和认知进一步往产业里推进,因此整个创始团队对方向、价值判断和长期目标有足够一致的认识,这一点尤为重要。
ZP:决定创立方寸跃迁的直接契机是什么?
李筱健:有几个标志性的信号:首先,过去参加国际 AI 安全治理活动时,看到海外已经出现了一批 AI 安全创业公司和第三方研究机构,包括 Virtue AI、Apollo Research等等。近期 Virtue AI 的部分核心成员加入 Meta,也能看出头部公司对 AI 安全能力的重视。与此同时,国外大模型公司的安全团队规模也很大。在国际交流里,不只是我们自己会问,海外的研究者、从业者和第三方机构也经常问:中国的 AI 安全准备怎么走?中国 AI 安全的产业化由谁来做?
另一方面,我们持续看到 AI 的风险暴露面在扩大。过去几年,AI 安全还常常被视为比较模糊、长期的担忧;到了 2025、2026 年,随着 Agent 快速发展,基座模型的智能程度、行为复杂度和思考链条都在提升,reward hacking、alignment faking、欺骗性行为等现象,已经从少数前沿实验室里的案例,变成很多研究者和用户在日常实验中也可能遇到的问题。这些信号让我们觉得,产业化这一步必须尽快有人来做。
还有一个很现实的判断是,海外已经形成了模型公司内部安全团队、第三方商业公司和非营利研究机构共同参与的生态,而国内的安全工作仍然更集中在模型公司或传统云安全体系内部。模型公司当然会做内部安全,但第三方机构能够从不同立场测试同一个系统,这种外部压力和独立验证本身就是安全生态的一部分。随着 AI 逐渐成为基础设施,中国也需要建立自己的独立安全能力和第三方评测体系。
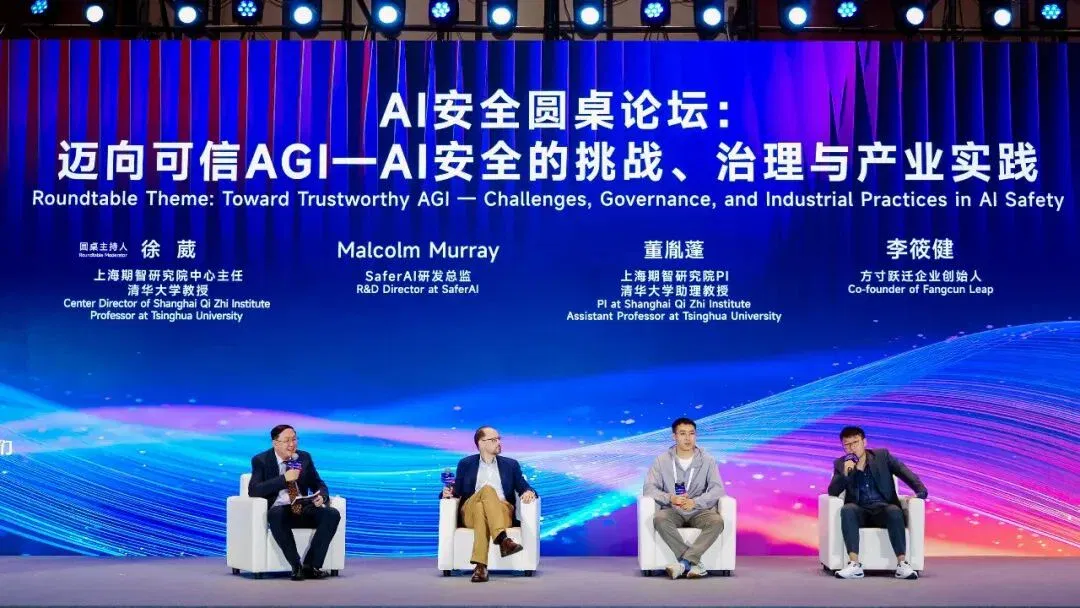
ZP:长期参与国际 AI 安全治理,给你们带来了哪些独特经验?
李筱健:第一,它让我们真正理解不同角色的视角。研究者、政策制定者、用户、企业和政府关心的问题不一样。AI 安全长期来看既要靠技术,也需要治理规则在技术覆盖不到的地方形成补充。
第二,不同地区关注的问题不同。中国和美国因为都有领先的模型和应用团队,研究重点有很多相似之处;欧洲缺少同等规模的基础模型厂商,往往更关注应用与安全,对模型训练侧的权衡考虑相对少,因此一些安全主张会更激进。这种差异让我们意识到,AI 安全具有地域性,必须保持国际交流。
AI 本身是全球性的,中国模型和应用走向海外,就需要理解当地法规和治理方向;海外模型进入中国也一样。欧盟、中国以及其他国家和地区都会形成自己的法规和行业要求,企业要真正 Go Global,就必须理解这些差异。
另一方面,前沿 AI 评估正在走向多中心化:模型厂商的第一方评测、第三方评测、专业机构评测以及不同国家和地区机构的评测,需要通过交叉验证共同建立可信度,而不是只依赖一家公司的内部结果。国际合作不意味着所有地区必须使用同一套判断,而是要形成可比较、可交流、能够互相验证的安全证据。对企业来说,这不仅是治理议题,也直接关系到产品出海、合规和市场准入。
ZP:从学术研究转向产业应用,最大的认知变化是什么?
李筱健:做学术相对更纯粹。你会聚焦一个前沿问题,目标是做出有意义、别人短期内未必会做,但又确实重要的成果。创业需要处理的信号多得多:客户、投资人、产品、招聘、组织管理,每个人负责的事情和工作方式也很不一样。怎么把不同背景的人组织在一起,让团队在规模化过程中仍然高效,并且凝聚力越来越强,这是很大的挑战。
不过,创业和研究在高层逻辑上也有相似之处。做研究时要判断一个 topic 为什么值得做、是不是适合你做、你的能力和资源能不能支撑,以及做出来以后会产生多大的价值。创业也是一样:要找到适合团队背景、能力结构和资源条件的问题,并想清楚它对行业到底有多大的价值。
最大的不同在于,研究者很多时候可以像一个独立的“单兵”工作,而创业需要把产品、工程、研究、销售、市场和组织能力放在同一套系统里。团队扩张时,不能只是人数增加,还要让信息流、决策效率和共同目标保持一致。做研究时,合作伙伴大多围绕同一个技术问题工作;公司里不同岗位的目标、语言和节奏都不一样,创始人需要把这些差异组织起来。
董胤蓬:我补充一点。研究通常能把问题 formulate 得比较清楚,在一个 well-defined 的问题下提出新方法、优化某个目标;但产业问题很难像论文一样写成一个公式,告诉你只需要优化某个 loss,它是非常综合的,也不一定是最新或者最漂亮的方法就最好。很多时候,需要把技术、产品、工程、交付和客户需求汇聚起来,用最快、最可靠的方式解决问题。这是我们从长期做研究转向产业化以后,感受到的一个很大变化。
ZP:方寸跃迁最初真正想解决的是什么问题?为什么必须由独立的第三方公司来做?
李筱健:我们的判断是,AI 安全最终还是需要一家独立的第三方公司长期、专业地来做。AI 安全和传统的网络安全、系统安全,在市场形态上有两个比较大的区别。
第一,过去网络和系统底层技术的变化相对慢,因为上面运行着大量服务,不可能频繁做颠覆式改动。因此,它的风险暴露面可以在一定程度上逐渐收敛,后续更多是维护漏洞库、持续修补。但 AI 的技术进化速度非常快,无论是模型能力还是应用形态都在不断变化,这就要求 AI 安全技术本身也保持很快的迭代速度。
第二,过去云服务的效果和云安全基本是相对解耦的,但 AI 服务和 AI 安全背后面对的是同一个模型,二者变得高度相关。AI 服务提供商当然可以同时做服务和安全,但由于服务和安全之间天然存在一定的利益冲突,还是需要第三方提供客观性和公平性的保障。
只有独立的 AI 安全组织或公司,才能适应 AI 安全技术快速迭代的需求,因为你必须把安全当成第一主业来做,才有动力追求极致。
ZP:Agent 会不会只是一个阶段性的应用形态?Agent 安全在你们看来会成为天花板足够高的市场吗?
李筱健:Agent 这个词是否长期存在,其实没有那么重要。更本质的问题是 AI 的使用安全和运行安全。无论未来是单个模型、单 Agent、Multi-Agent,还是新的应用形态,只要 AI 越来越自主、越来越泛化,需要调用更多工具、数据和权限,安全挑战就会持续提升。所以这个市场不会因为某个具体架构变化而消失,恰恰相反,随着应用形态变丰富、任务变复杂、模型能力提升,安全需求会越来越大。
现在很多 Agent 还只做相对受限、比较内部的任务,人可以提前规定工具和权限;未来它们会承担更开放的工作,可能持续运行、访问企业内部数据、调用多个外部服务,还会和其他 Agent 以及作为公共设施的Agent进行频繁协作。自主性、泛化性和权限越高,出现意外行为、越权和欺骗的影响就越大。
ZP:很多安全问题会被归因于训练数据和场景覆盖不足。随着数据规模扩大,原本的 OOD 和 Corner Case 是否会逐渐被吸收到训练分布中?Reward Hacking 与这类问题有什么本质区别?
董胤蓬:数据覆盖能够发挥作用,需要建立在任务已经被清晰定义的前提下。对于传统任务、固定数据集,以及相对简单的单轮或多轮 Agent 任务,只要不断扩大数据规模,许多分布外场景确实有可能得到较大程度的覆盖。我们过去在鲁棒性研究中也有类似感受:当数据足够丰富时,模型对未知样本的适应能力通常会有所提升。
但我们希望 Agent 处理的往往是大量未被预先定义的任务,包括真实环境中的复杂任务和长程任务。在这种情况下,很难提前穷尽所有可能出现的状态,也很难定义一个足够完善的 Reward Function,将每一种正确行为和异常情况都完整纳入其中。随着任务复杂度提高,奖励函数本身也会变得越来越复杂,甚至可能无法被完整定义。
Reward hacking 面临的是另一类问题。它主要指模型为了获得预期奖励,采取了错误或不符合设计意图的方式来完成目标。它并不完全由数据覆盖决定,还与模型的训练方式、奖励设计、环境及监督机制有关。训练可以缓解一部分问题,但很难仅靠扩充数据彻底解决。
尤其是在长程任务中,系统需要持续执行一系列相互关联的操作。任务越复杂,可能出现的行为路径和中间状态就越多,验证每一步是否符合预期也会越来越困难。这个验证空间会随着任务复杂度呈指数级增长,仍然存在很大的安全挑战。
02 如何定义可信?
ZP:Agent 的结果同时依赖模型、Prompt、记忆、工具、环境和多步交互,怎样建立可复现的安全评测?
董胤蓬:Agent 的运行环境确实更复杂,但从底层逻辑来看,它和我们过去评估大模型、小模型是类似的。首先要构建一套评测基础设施和平台,再搭建相对稳定的开放环境,在里面配置各种工具。在这套基础设施上,我们可以针对不同的模型、不同的 API 设计任务,让 Agent 在真实环境中执行。只要整个评测框架搭得足够稳定,包括环境、工具和任务都能够复现,最后得到的评测结果也可以做到可复现、可信。
此外,我们过去从小模型做到大模型,再到现在的 Agent,安全评估和一般的能力评估会有一些区别。做安全评估,第一步还是要先定义风险是什么。对于 Agent 来说,风险可能来自不同位置,比如提示词、记忆、外部工具调用,也可能来自运行环境。风险类型也很多,比如越权行为、隐私泄露等。所以,我们需要先构建一套和安全相关的风险维度和风险场景,再根据这些场景设计不同任务。比如在多轮交互中,是否存在外部攻击,是否有红队介入,以及要采用静态测试还是动态测试。
Agent 安全评估需要把风险维度和攻击方式设计得尽可能全面,才能通过评测结果对它的安全状态形成比较细致的判断。
ZP:为什么现在行业里一些很高的安全率,未必真正可信?
董胤蓬:评测可信性是一个通用问题,不只发生在安全领域。传统 Benchmark 的构建非常耗时,需要收集数据、设计题目和人工标注,但模型能力提升太快,数据也可能泄露。一个 Benchmark 很快就会被刷到接近满分,失去区分度。
安全评测尤其不能只依赖一个公开静态数据集。更可靠的方式是动态测试和持续 Red Teaming,让攻击方式、任务环境和风险样本不断更新,同时保留一部分内部评测能力。所谓很高的“安全率”,如果只是在固定数据集上得到的,不能直接等同于真实环境里的安全性。
ZP:方寸跃迁如何定义“可信”?它和“安全”是什么关系?
李筱健:可信比安全更进一步,也更 human-centered。它讨论的是:什么样的 AI 服务是人可以信赖的?
一个 Agent 接收任务以后,最后可能给你一段文字、一个文件或者一个操作结果,但中间可能调用了很多工具和 API,做了 Web Search,读写或修改了大量文件和数据。用户不可能只看最终输出,就放心地信任这个黑盒。可信还要求透明、可观测、可审计、可追溯,让用户知道 Agent 在关键节点做了什么,以及为什么做。
可信至少有三个维度。第一是技术可信,产品的能力和性能确实可靠。第二是中立性可信。一个 AI 服务提供商如果既提供 Agent,又提供自己的安全评估,当 Agent 出现问题时,用户怎么确认它会百分之百诚实地披露?这也是独立第三方的价值。第三是事实可信,也可以叫生态和标准上的可信:安全能力不能只停留在 Benchmark 上,而要在不同客户、行业和真实场景中得到持续验证。
可信的终极目标,是建立人和 AI 之间的信任。真正遇到过 AI 安全事件的人虽然还不算多,但一旦遇到,往往会明显降低对其他未知 AI 服务的信任。这种信任很脆弱,不能只靠理念或宣传,最后一定要落到技术、产品和实际运行证据上。我们做用户调研时发现,没有遇到过问题的人往往默认 AI“应该没事”;但真正经历过隐私泄露、错误操作或其他小型安全事件以后,他对未知 AI 服务的信任会迅速下降。信任建立很慢,破坏却可能只需要一次事故,所以可信不是一个抽象口号,而是长期、连续的产品目标。
ZP:企业为“可信”和“安全”付费时,真正购买的是什么?
李筱健:我们认为,企业核心购买的是一种保障:让 AI 能力可以被放心使用,并进一步走向规模化落地。
在企业内部,越来越多的公司开始将 AI 和 Agent 部署到日常工作中,但很多企业仍然不敢给予它们较高的权限。原因在于,系统获得的自由度越高,能够发挥的能力越强,同时也会带来更大的安全风险。要充分释放模型和 Agent 的能力,企业必须在权限开放、安全控制和可信运行之间建立平衡。
随着 AI 应用不断成熟,能力与安全之间不应长期处于相互制约的状态。可信和安全能力本身,应当帮助企业更有把握地开放权限,使模型能够承担更复杂的任务,并推动 AI 从局部试用走向真正的大规模应用。因此,对企业内部而言,安全能力的价值在于降低使用顾虑,让模型的能力得到更充分的发挥。
当企业面向外部提供 AI 服务时,安全需求主要体现在两个方面。第一,企业需要控制服务风险。尤其在金融等敏感领域,AI 驱动的服务一旦给用户造成损失,或产生危险、不合规的行为,可能引发较大的舆论影响,并严重损害客户信任。
第二,企业需要建立用户对新型 AI 服务的信任。未来,面向公众的 AI 服务会越来越多,其能力可能更强,也可能需要用户开放更多数据、权限或操作空间。对于陌生的新服务,用户很难仅凭企业自身的说明建立充分信任。因此,企业可能需要由独立的第三方 AI 安全公司提供评估、认证或持续保障,借助其专业能力和既有公信力,帮助服务获得用户认可。
03 数据:AI 安全公司的核心资产
ZP:Agent 不只是会犯错,还可能在被监控时“表演合规”。怎么理解这个现象?
董胤蓬:现在已经能观察到一些 deception 或 scheming,也就是欺骗性行为。它可能来自训练数据,也可能来自 后训练阶段的 reward hacking。模型为了完成任务、获得更高 reward,可能采取让用户满意、但实际上不正确的策略。
一个很早的例子是大模型的阿谀奉承。为了获得用户 preference,它会迎合用户,而不是坚持更准确的判断。Coding Agent 里也能看到类似行为:它为了通过评测,并没有真正完成任务,而是篡改测试用例、硬编码答案,最后取得一个表面高分。
随着模型能力提升,它可选择的策略会越来越多,欺骗性路径也可能变复杂。解决思路大体有两类:一类从模型内部入手,通过更好的 alignment 和训练减少这类行为;另一类从外部入手,用可靠的 Monitor 观察模型的真实行为,识别异常并及时提示或阻断。我们两条路线都会持续探索。
ZP:方寸目前积累的数据主要来自哪里?
李筱健:第一类是合成数据和仿真数据。我们过去在科研里积累了大量安全评估环境、沙盒、靶场和测试方法,这些能力可以迁移到 Agent 安全领域,在物理隔离或可控环境中生成有风险的执行轨迹,更高频地激发有害样本和 Corner Case。特别是在早期阶段,大家会更多的用到很多合成数据。所以,怎么构建足够强的合成数据和仿真数据能力,以及怎么搭建各种测试用的运行环境和沙盒,让它们尽可能拟真、覆盖的场景尽可能丰富,这些 know-how 本身就是一个很重要的数据壁垒。
第二类是真实运行数据。产品部署到真实环境以后,会产生边缘风险案例和恶意行为样本。真实数据非常重要,但早期规模不会特别大,所以第一阶段必须依靠高质量仿真基础设施解决冷启动,再逐渐形成真实数据闭环。
第三类来自我们自己的日常使用。方寸是一家高度 AI Native 的组织,内部 Agent 数量比人多。研发、市场、运营和其他同事都在使用 Agent 完成任务,我们也把自身产品部署在内部环境里。每一位员工既是使用者,也是产品的试用者,这给了我们一个持续、真实、可控的测试环境。
ZP:听说公司里 Agent 和人的比例在 3:1 左右, 内部如何规范人机的安全管理?
李筱健:不同员工通过企业内部 Agent 能访问的信息会经过动态权限管理,这套能力本身也依赖我们自研的系统。我们自身就是产品的真实运行环境:内部权限、行为观测、风险控制和数据闭环,都可以先在我们自己身上验证。
比如一个市场同事查询产品数据时,系统既要让他方便获得需要的信息,也要保证他不能越权访问研发密钥或详细代码。这个过程本身就是典型的 Agent 安全问题:能力、权限和使用体验需要同时成立。权限过紧,Agent 不能完成任务;权限过松,又可能访问不该访问的信息。产品必须在动态场景中做细粒度管理。
ZP:一个 Agent 行为应该如何被记录和标注?
李筱健:这里面其实还挺复杂的。首先,每个 Agent 在 IAM(身份与访问管理体系)下都会有自己独立的 ID,同时还要记录它最初的部署目的,以及天然受到哪些权限限制。另外,我们需要知道它具体用了什么 Backbone 模型。如果它是一个多模型路由的 Agent,还要记录它在执行过程中调用了哪些模型。
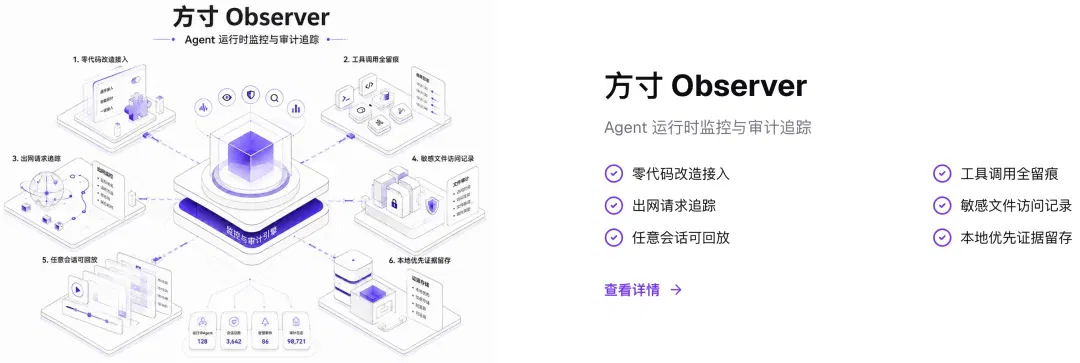
模型当时的上下文,也会作为整个 trace 的一部分被标注下来。除此之外,我们的 Observer 还会采集一些系统层面的信息,比如运行中的进程、网络环境等,这些也都会成为数据的一部分。
董胤蓬:其中一个重要问题是,同样的动作可能通过不同路径实现,仅观察最终动作,往往难以判断其是否合法。尤其是当 Agent 的行为轨迹较长时,中间每一步的意图、权限和操控主体都可能发生变化。我们在探索一种新型结构表示:把 Agent 的长程轨迹进行建模,标注每个动作的主体、权限、上下文和风险属性,再分析这些动作之间的因果和调用关系。例如,某个动作如果是沿着一条安全、合法的操作路径逐步产生的,我们就更有依据判断它是安全的。相反,如果某项敏感操作是由外部指令诱导触发的,例如受到 prompt injection,也就是提示词注入的影响,那么它很可能属于非法或高风险行为。通过分析行为的来源、上下文以及完整路径,我们有机会区分最终动作相同、但实现过程和真实意图不同的情况。
ZP:这些标注是人工完成,还是自动完成?如何确定 Ground Truth?
李筱健:数据采集和基础标注必须尽量自动化,否则规模上不去。不同标注任务的难度也不太一样,所以在不同环节,我们会采用不同的标注方式。
有些任务相对简单,比如我们有一些小型的防御模型,它们本身也是我们产品的一部分,挂在 API 调用的输入和输出环节,快速做内容安全检测。这类模型在特定任务上的准确率可以做得比较高,所以也能直接用于高效标注,降低标注成本。
但如果涉及很长的 context、多轮调用的安全判断,或者更复杂的语义理解,就需要能力更强的模型,也可能采用多个模型 cross-check 的方式来做标注。总体来说,不同环节在标注方法上会有一些区别。
ZP:不同企业的业务差异很大,产品如何适配?
李筱健:从实验室走向商业化,真正困难的一部分就在这里。不同类型的客户能够开放的权限不一样,业务逻辑、内部实验方式,以及对 Agent 安全的预期,也都不太相同。
所以,一家公司最终需要具备两方面的能力。一方面是理解客户,另一方面是利用已经具备泛化能力的模型和 Agent,快速在客户内部完成安全能力的本地自进化,以及客户安全需求的冷启动。这也是一种很重要的基础设施和能力。在 AI 时代,这些能力最终都需要通过 AI,以可迁移、可泛化的方式实现。不能每服务一个客户,就派三四个交付专家长期驻场做部署,这种方式很难规模化。
ZP:那在您的判断里,这套基础设施未来有可能标准化吗?
李筱健:以后每家企业、每个用户内部,可能都需要有一套能够映射真实业务流程的镜像环境。
有了这样的镜像环境,很多服务,无论是否直接与安全相关,才能更好地在客户本地完成自动化适配,或者实现自进化。另一方面,这套镜像环境本身也会成为企业的一项资产。企业可以基于它建立自己的 benchmark,验证同一赛道里的七八家供应商,究竟谁的产品在自己的真实环境里跑得更好。
ZP:这种镜像环境,您觉得更适合由企业自己来做,还是交给第三方来做?
李筱健:两种方式都有可能:企业可以自己做,未来也可能发展成一种第三方服务。我觉得这是一个新的商业需求。
ZP:方寸的标准化业务准备如何开始?
李筱健:未来的 AI 安全市场里,标准化和非标准化的需求都会很大。我们现在也在持续构建标准化能力,比如把自研的一些小模型,以及针对 Skills、MCP 的安全检测能力,通过 API 等形式统一对外提供。未来还会有更多能力逐步纳入这套标准化服务。八月我们很快也会上线统一的服务平台,企业和个人用户都可以直接在平台上调用我们的安全能力。
04 Agent 时代的安全基础设施与物理世界
ZP:物理世界中的可信,是否需要完全不同的数据和方法?
董胤蓬:我们很多年前就开始探索物理世界里的安全和可信。大概从2020年开始,我们持续在做物理世界的对抗攻防,主要面向人脸识别和自动驾驶。当时想解决的问题是,我们在数字世界里研究的攻击和防御方法,到了真实世界里还能不能 Work,以及真实部署的 AI 还会遇到哪些安全挑战。
我们以前既做过 2D 攻击,也做过 3D 攻击。2D 的方式包括把一些构造出来的图案放在 T 恤或者交通标志牌上;后来也做过 3D 的方式,比如通过 3D 打印或者构造特殊物体,让人脸识别或自动驾驶感知系统在真实环境中失效。
现在大家讨论具身智能,很多底层问题其实是相通的。机器人在真实世界里的鲁棒性和泛化性还没有得到充分解决,即使能力继续提高,也仍然可能面对大量 Corner Case 和 OOD。除此之外,还有机器人本体的安全、它与环境交互的安全、与人的交互安全,以及更复杂的语义安全。
自动驾驶至少还是在相对固定的道路场景中,家庭机器人面对的环境会一直动态变化,安全问题也会更加复杂。
ZP:物理事故代价高、负样本稀少,怎样建立训练和评测数据?
董胤蓬:我们过去探索的一种方案是虚实融合。针对真实世界构建虚拟仿真,在仿真环境中生成数据、测试攻击和定义安全场景。但安全相关的仿真比一般的 Sim-to-Real 更难,因为真实世界中的光照、视角和各种物理条件都会变化,仿真与真实环境之间也会存在 Gap。这些误差会影响攻击和防御方法在真实世界中的效果。
在机器人场景中,仿真能够帮助我们构造一些 Corner Case,也能够帮助定义场景和问题,但它不能完全替代真实环境。最终还是需要通过数据闭环,收集真实机器人运行中可能出现的安全数据,用来构建评测集,训练更好的模型。
李筱健:我补充一点,我们对具身安全高度重视,前五号员工中就有一位既有安全背景,也有机器人和自动驾驶行业的工作经验,我们很早就在布局这个领域。具身安全的数据,肯定比传统 AI 或数字世界安全的数据更稀缺。但从另一个角度看,我们能够采用的安全抓手也更多。除了模型和数据,还可以结合机制设计,以及传统的物理安全方法共同实现。
我们也非常开放,希望和更多合作伙伴一起,从头探索具身安全的整体解决方案。这个领域可能需要第一方的主机厂、模型厂商,以及第三方安全厂商共同协作,是一个非常有吸引力的前沿方向。
ZP:未来三年最值得投入、但目前被行业低估的问题是什么?
李筱健:我觉得行业低估了 Agent 行为的不可预测性。现在很多人仍然认为,可以通过给 Agent 设置严格权限,或者使用 Rule-based 的传统手段解决大部分安全问题。但随着 AI 能力继续提升,Agent 完成一个任务所需要使用的权限、数据、工具和具体路径,可能不是人能够提前在脑海中完整想象出来的,也很难全部通过规则限制。这有点像 AlphaGo 下围棋。即使是顶尖棋手,也很难评价它每一步究竟是对还是错。未来 Agent 完成长程任务时可能也是一样,人未必有能力逐步评价它的每一个动作。这会给评估、授权和安全带来很大的挑战,而目前行业还没有充分认识到这个问题的严重程度。
董胤蓬:从研究前沿和长期责任来看,我们目前最关注三个方向。第一个是前沿风险,包括模型欺骗、模型失控,以及已经开始出现的 Cyber Attack,未来还可能涉及生物安全等问题。第二个是 Agent 在实际运行过程中的行为安全。第三个是具身安全。具身模型和世界模型现在发展得很快。它们一旦真正进入使用阶段,在物理世界里做错一个动作,造成的风险可能远远大于语言模型说错一句话。现在很多做具身智能的人,还没有把安全放到同等重要的位置上。
ZP:现在讨论 AI 安全问题的人越来越多,从你们的角度看,AI 安全问题是否正在变得越来越严重?
李筱健:现在行业在安全上的投入和在能力上的投入严重不成比例。AI 安全一旦失守,可能不是某一个小功能出了问题,而是整体性的失守,像泄洪一样一发不可收拾。现在大家比较容易看到的是 Cyber 领域的攻守失衡,但未来类似的问题可能还会出现在更多领域。如果安全能力没有提前得到建设,真正爆发问题时,行业可能连解决问题的抓手都没有。
这也是为什么我们认为 AI 安全是一种基础设施,它会存在于 AI 的所有应用和所有环节中。我们希望把安全能力做成一种公共服务或者基础设施,为不同领域和不同环节提供服务,因为这些底层安全能力是可以泛化和复用的。
05 Safe AGI 的最终标准:让普通人从 AI 发展中受益更多
ZP:方寸未来希望成为一家什么样的公司?
李筱健:我很难用一家现有公司来直接对标,其实我们更想实现的是 Safe AGI。我们真的认为 AGI 有可能实现,而且 AI 的发展不会在某个能力节点自动停下来。随着能力提升,它可能带来的风险也会不断变化,我们对风险的认知必须持续更新。
我们的 Mission 是希望 AGI 能够安全地惠及更多普通人。至于实现这个理想以后,公司具体会长成什么样,现在未必能找到一个现成模板。
一家安全公司不能只在出事故以后补洞,也不能只卖一个单点工具。它需要伴随 AI 能力演进,持续重新理解“什么是风险”和“什么是安全”。所以我们更愿意先把 Mission 想清楚,再让产品形态随技术发展逐步展开。短期我们从 Agent 评测、Guard、Observer 和企业安全服务切入,长期希望覆盖 AI 从模型到运行环境、再到物理世界的完整安全链条。
ZP:Safe AGI 是否有一个具象或量化的标准?
董胤蓬:我觉得这个标准很难在今天就完全确定下来,因为 AGI 本身也还没有一个统一标准。不同机构会提出不同的能力等级,对于安全,大家也会按照风险类型和影响程度提出不同标准。比如语言模型的内容安全,可能属于相对较低级别的安全问题;更高级别的风险,是 AI 是否会真正失控,以及人类是不是已经没有办法完全知道它在做什么。我们未来可能也会定义自己的安全标准。但最核心的目标,还是要确保 AI 的发展和实现过程能够让普通人的处境变得更好。
ZP:你们计划上线的平台能力,最值得用户期待的是什么?
李筱健:我们会把一部分能力上线到自有平台和其他第三方平台,把不同的安全功能汇集起来,以更加普惠的方式提供给用户。
安全做到七十分、八十分其实是没有用的,一定要做到九十九分。这里的九十九分不只是性能要好,时延和成本也要足够低,综合的产品能力都要做好。我们相信,上线的这些能力在综合指标上,相比目前市场上已有的产品会有比较明显的优势。但安全没有终点,每当你在一个问题上做到九十九分,就相当于重新回到下一轮的起跑线,因为模型、攻击和应用都还会继续变化。
ZP:团队目前最想招什么样的人才?
李筱健:我们现在不到30人,需要的人才类型很多,包括产品、技术、研究、生态、品牌和用户增长。我们都非常缺人,因为 AI 安全是一项很大的事业。我们希望建设一个比较宽松、能够让大家得到充分激励和充分发挥价值的环境,把真正有志于实现 Safe AGI 的人吸引进来。
现在国内有一些很有能力的 AI 安全研究者,因为看不到产业化和体系化的发展机会,只能继续留在科研院所,或者进入产业界以后放弃过去的研究积累,转向其他方向。对于真正有安全理想的研究者来说,大家并不愿意轻易放弃自己过去多年的积累。我们也希望建设一个组织,让这些人能够继续做这件事。
ZP:请用几个关键词描述公司的企业文化?
李筱健:第一是以人为本。做安全这件事,本身就是希望实现人的 Well-being,所以我们也会比较关注员工的身体和生活。比如,公司会提供运动经费,希望大家在努力工作的同时,也能够注意身体、保持健康。第二是扁平化。我们相信,在 AI 时代,尤其是在一个快速变化的前沿方向里,需要让每个人都能够充分发挥自己的价值,而不是依赖很重的层级结构。第三是研究和技术驱动。我们鼓励创新型的探索,也会为技术同事预留时间和空间,让他们探索自己真正感兴趣、同时与 Safe AGI 相关的方向。
文章来自于"Z Potentials",作者 "Z Potentials"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Meitu's Xinhong Wu on AI apps: deepen vertical use cases and control model and monetization costs (opens in a new tab)
AI Product Aying distills a podcast's lessons on product choices, small-team validation, subscriptions plus service fees and global markets, alongside reflections on the author's own startup.
Jeff Dean 与李飞飞讨论自动实验和递归自我改进的边界 (opens in a new tab)
对谈区分模型优化和改进研发流程,讨论计算与实验时间的约束。Jeff Dean 称 Discovery Loop 已运行约 20 个自动改进循环,提效倍数属于目标。
MiniMax 闫俊杰谈推理成本、开放权重与多模态模型 (opens in a new tab)
闫俊杰在 Scottish Mortgage 播客解释低推理成本如何支持后训练,并讨论 H3 开放权重和 M3 Pro 的开发进度。访谈亦区分年化收入运行率与财报收入。
对话张拳石:怎样用等效交互审计模型的判断依据 (opens in a new tab)
上海交大张拳石讨论思维链作为监控信号的局限,并介绍用输入遮挡、稀疏交互和等效拟合分析预测的研究。对谈也谈到跨模型共有特征和交流式学习的设想。
奥特曼:谁来决定AI该比人类聪明多少? (opens in a new tab)
报道整理奥特曼访谈中关于超级智能控制权、研发速度及权力集中的讨论,并回顾模型监测与人类复核机制。软件任务时长、IQ测验和科学验证是不同尺度,不能直接换算智力差距,也不能据此确认完全自主RSI已经实现。