全球Token「印钞流水线」大升级,幕后推手Agentic Infra首次曝光!
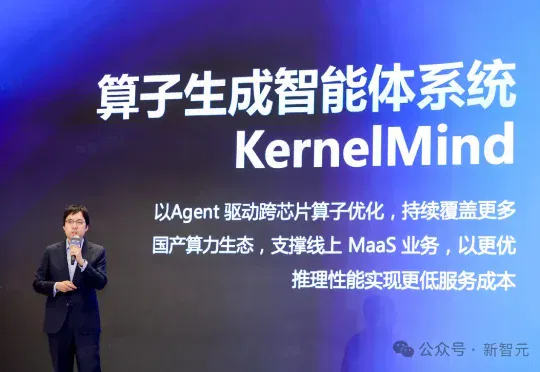
就在今年的WAIC上,无问芯穹一口气亮出了「前店后厂一中心」,一整套完整的Agentic Infra战略布局:算力集散中心(一中心):Agentic Infra自主式基础设施平台;Token工厂(后厂):Agentic MaaS大模型服务平台;
「你已达到使用上限,请等待额度重置。」
用过Claude Code、Codex 的人,大概都被这行字噎过。bug刚修到一半,弹窗一出,全停了。
如今你把活整件甩给Agent,它替你干、也替你烧钱,每一次调用都在按Token结算。
Token,俨然成了这个时代最像「货币」的东西。
有意思的是,这「货币」还在疯狂贬值:过去一年,单个Token的生产成本被硬生生打下来10倍。
是谁,在哪儿,把它造得这么便宜?答案藏在一层你从不打开、却天天在用的地基里。
就在今年的WAIC上,无问芯穹一口气亮出了「前店后厂一中心」,一整套完整的Agentic Infra战略布局:
- 算力集散中心(一中心):Agentic Infra自主式基础设施平台;
- Token工厂(后厂):Agentic MaaS大模型服务平台;
- AI生产力商店(前店):Agentic Infra行业解决方案。
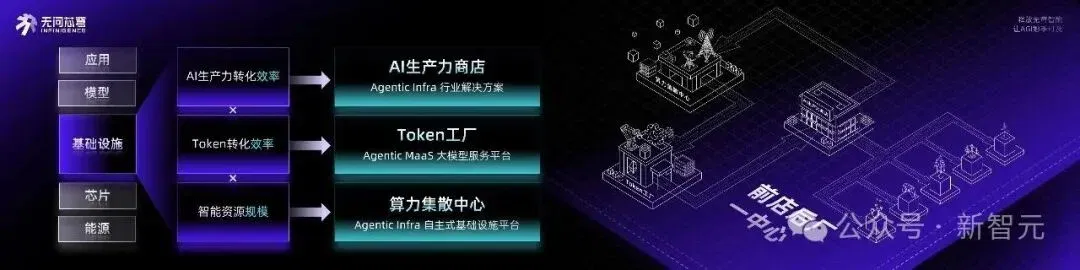
不是「Token 工厂」,是Agentic Infra
2025年,无问芯穹率先在业内喊出了Agentic Infra。不到一年时间,这个词已经成了行业里的「标配」。
可仔细看,如今多数厂商做的「Agentic」,不过是在传统基础设施上加了一个Agent入口。
但这样做根本撑不起真正的智能体时代。当海量并发请求一拥而上,光靠一个新入口,底层系统很容易就崩了。
真正的解法,得往更深处走。今年6月,两家海外Cloud公司各自提出的解法,与无问芯穹隔海共同呼应了「Agent时代到底需要怎样的AI基础设施」这个命题。
首先,是CoreWeave发布了一款服务于「AI研究与迭代」的智能体——ARIA。它能够自主分析实验数据、提炼洞察并驱动持续改进。这意味着CoreWeave正式从单纯的「算力提供商」升级为「算力+AI自动化研发」的综合平台。
其次,是Fireworks AI发布带强化学习的端到端平台——Training Agent。用户只需描述任务,智能体就能自动选模型、跑超参扫描、写评估、部署模型。
而无问芯穹的解题思路是——让整座基础设施自己变成一个会干活的Agent。
在他们看来,真正完整的Agentic Infra至少得同时迈过三道坎:
- 全链路:撑得起从算力到Token再到生产力的整条链,用全栈优化提升基础设施系统性能;
- AI原生:能用AI改进AI基础设施本身,不仅服务人类用户,还针对智能体这类数字用户的需求做改造;
- 全覆盖:训练、强化学习、推理全流程覆盖,稳固更多样化的技术优势,同时携手行业百业的客户,赋能降本提效。
无问芯穹把这三件事,收进了一道乘法公式:
AI生产力 = 智能资源规模 × Token 转化效率 × AI 生产力转化效率。
公式里的三个变量,正好对上「前店后厂一中心」三块业务。并且在相乘之后,还首尾相接地成了一个闭环。
一中心:把散在各地的算力,聚成一股
第一个变量,是智能资源规模。
如今,算力的胃口,早就涨得比供给快。可光靠买卡、堆算力,既烧钱又追不上。
真正的出路,是把已经散在各地、型号不一的存量算力盘活,聚成一股能用的力量。
为此,无问芯穹的「算力集散中心」主要做了两件事。
第一,是面向大模型的异构集群跨域训练系统。
- 超远距离聚合:联合中国电信,完成国内首例超4000公里距离的大模型跨域混训,在新疆哈密与广东深圳两地集群间,实现联合训练性能提升165%。
- 多数据中心聚合:联合4个不同代际、不同型号的GPU集群,联合训练70B参数大模型,四集群协同性能提升41%。
- 混合云算力聚合:实现本地私有集群与公有云算力的安全互通混训,不仅将整体性能提升了68%,而且还治好了企业「自己的卡不够用、云上的卡却闲得发慌」的问题。
到今天,这套系统已在全国部署触达超37000P算力、覆盖16种主流芯片。
第二,是跨集群强化学习。
强化学习正成为这一轮智能跃迁的胜负手,所需要的算力规模显著增大,动辄千卡甚至万卡起步的体量,并不是每个机房都能塞得下的。
然而,想要同时利用多个集群,就不得不面临机房之间通信和故障的瓶颈。
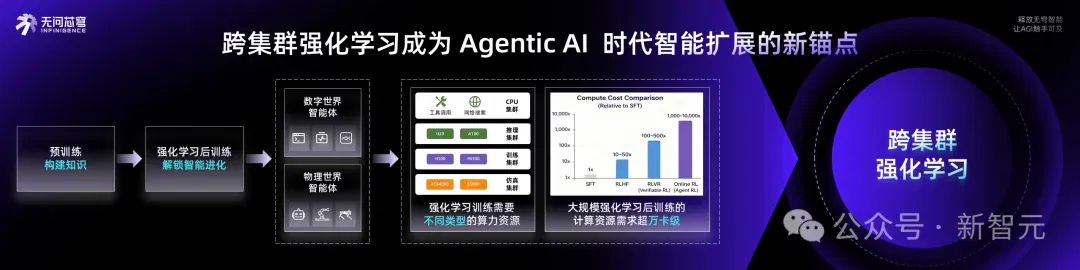
对此,无问芯穹的做法是从网络、平台到框架一层层优化,把跨域通信的效率整整提高了三到四倍,实现通信开销100%全掩盖。
再配一套故障无感的训练机制,它硬是让跨域强化学习训练,连着跑了整整一周都没断。
无问芯穹联合创始人兼CEO夏立雪今天在发布会现场表示,随着强化学习规模需求的持续提升,无问芯穹还将针对并行策略、通信融合、智能算子、极致容错等核心技术持续深耕,「未来会将跨域计算资源的支撑规模拓展至十万卡级以上,支撑下一代Agentic AI 的在线进化。」
但把算力聚起来只是第一步。真正让「一中心」配得上「自主式」三个字的,是它开始自己管自己。
无问芯穹今天发布了一项与基础设施自我优化和进化直接相关的「前店」解决方案:基础设施智能体蜂群。
首先看「平台管家智能体系统」和「智算集群运维智能体系统」。
举个例子,一个「平台管家」智能体如今成了整个基础设施智能体蜂群的统一入口。
你直接交代一句「帮我看看昨天哪些训练任务失败了」,它便会顺着日志、监控、任务事件一路查下去,并且独立解决80%的日常问题。剩下20%的深度问题,则会再转交对应的垂类智能体。
比如,碰到棘手的集群运维难题,专门的智算集群运维智能体系统就会接手。这是一个7×24小时全天候值守的「运维专家团」,能端到端地完成告警闭环处置。定位到根因后,它们会直接拟好修复方案,并问你要不要一键重建。
经过大规模生产环境验证,这套运维智能体系统可实现运维人效提升5倍以上,关键故障处理效率提升6倍。
这不仅为大规模GPU训练与推理业务提供了更加稳定、高效的基础设施保障,也让运维人力能够被真正解放出来。
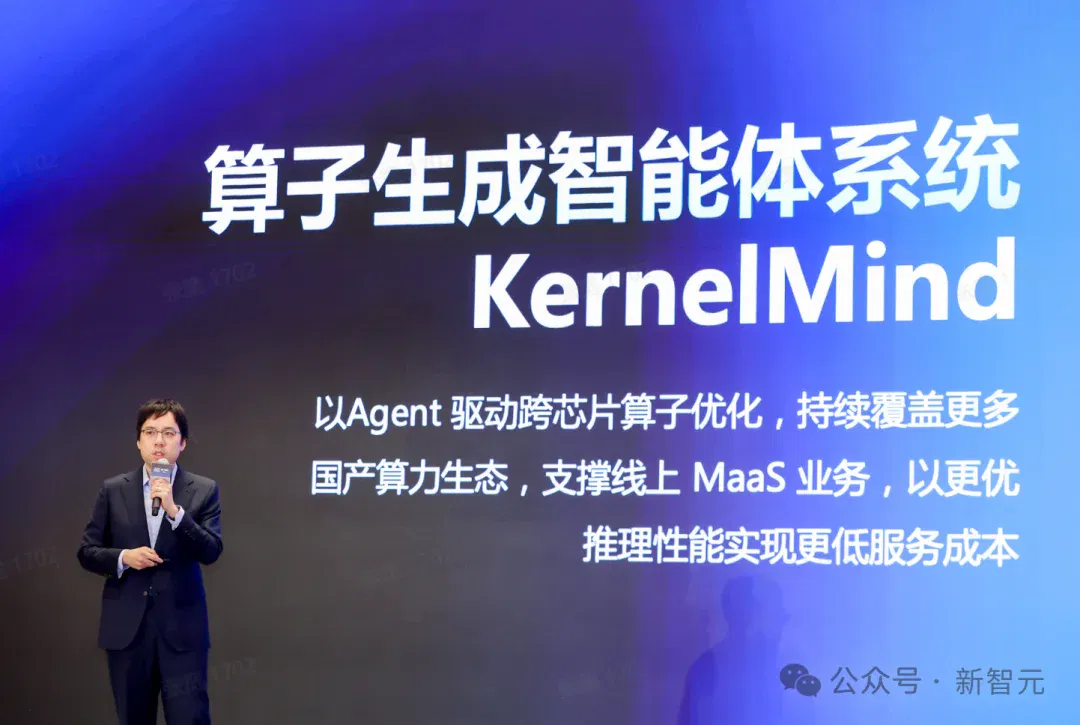
比运维更硬核的,是高性能算子生成智能体系统KernelMind。它直接用AI造出面向不同芯片的高性能算子,可在真实编译试错与知识沉淀中持续自迭代,稳定交付工业级算子。
在GLM 5.2模型的实测中,对比行业基线,KernelMind在NVIDIA旗舰卡中实现了端到端7.3%的性能提升,在AMD旗舰卡中更是带来了39%的整体性能跃升。
放以前,这一步得靠顶尖专家一行行手搓才行。
后厂:把推理成本,一年打下来10倍
第二个变量,是Token转化效率。
对于后厂来说,核心命题只有一个:极致效率服务Token的规模化、高质量生产。
这背后,其实是整个AI产业的一次重心转移。
过去三年,大家拼的是谁堆的卡多、训的模型大;可当Agent铺开之后,战场就从「训练」大规模扩展到了「推理」。决定谁能真正赚钱的是海量调用之下,每个Token的成本能压到多低。
模型推理时,不同阶段对设备的要求完全不同——Prefill疯狂吃算力;Decode极度吃通信和延迟。
对此,无问芯穹的答案,是它首创的「跨集群异构PD分离架构」(Prefill-RelayDecode-MainDecode,PDD)。
也就是,把Prefill和 Decode这两步彻底拆开,分别丢到不同机房、不同厂商的芯片上去跑。谁擅长算就专心算,谁擅长低延迟输出就专心输出,各尽其能。
而基于以太网的KV Cache跨集群传输,需要解决带宽和延迟瓶颈两大难题。
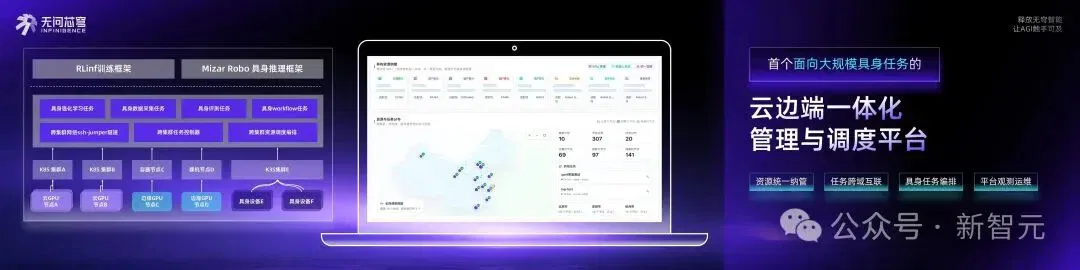
带宽这一关,它靠一次技术迁移解决。通过把原本用于Decode实例重复前缀存储去重的Decode Radix Cache技术,创新性地迁移至跨集群异构PD分离架构之中,将跨集群的KV Cache传输数据量降低了一个数量级。
延迟这一关,它首创了PDD三级分离架构。遇到传输要耗上数十秒的请求,先由极少量机器上的RelayDecode抢先向用户输出Token,用户端因此感受不到这段传输延迟;等数据传输完成,再把输出任务无缝切换给MainDecode。
实测显示,首Token延迟(TTFT)直接降低了51.5%,单Token成本再降37.5%。
结合一系列技术优化,无问芯穹的单位Token推理成本,硬是在一年内,整整降了10倍。未来,仍有10倍的下降空间。
正如夏立雪在现场所总结的:6月的GTC大会上,黄仁勋展示了英伟达的「算力即收入」曲线。无问芯穹的Token工厂,则希望用「优化即利润」的增长飞轮,向推理时代交出Token效率的答卷。
Token按量卖是收入,每一分技术优化省下的成本,不用降价让利,直接沉淀成毛利;省得越狠,赚得越多。
如今他们深度合作的模型厂名单中,几乎涵盖了国产大模型的半壁江山——Kimi、智谱、MiniMax、阶跃星辰等。
这些公司的模型能力在持续提升,模型越强,能接的任务就越多,推理调用量自然跟着指数级增长。
截止今年7月,无问芯穹Agentic MaaS平台日均Token调用量较年初增长约40倍。
飞轮,已经高速转起。
前店:把能力,做成一套工业级方案
第三个变量,是AI生产力转化效率。
在服务客户的实践中,无问芯穹发现了一条关乎AI落地生死的关键定律:
相同的业务效果,若置于不同的推理路径、模型规模与芯片组合之下,Token成本竟天差地别——这一差距,正深刻制约着大模型从技术验证走向真实生产力的跃迁。
为此,无问芯穹推出了 “AI生产力商店”——Agentic Infra行业解决方案,以底层智能基础设施之力,助力行业客户打通降本增效的“最后一公里”。
截至目前,无问芯穹已深入文娱游戏、医疗健康、法律终端、能源电力等多个垂直行业,和Tripo AI、上海瑞金医院、南方电网等伙伴共同打磨领域生产力方案,赋能千行百业重塑AI效能边界。
当算力、Token、生产力,这条链到前店才算真正闭合——那些从芯片里一点点挤出来、又被后厂压到极便宜的Token,最终都在真实业务里,变成了看得见的生产力。
下一站,是物理世界
讲到这儿,都还是数字世界里的事。
可当所有智能都跑在云端的数据中心里,AI基础设施就真的到头了吗?
无问芯穹的答案是没有。
因为在物理世界中,具身智能的Scaling Law同样需要高效率、大规模的基础设施支持。
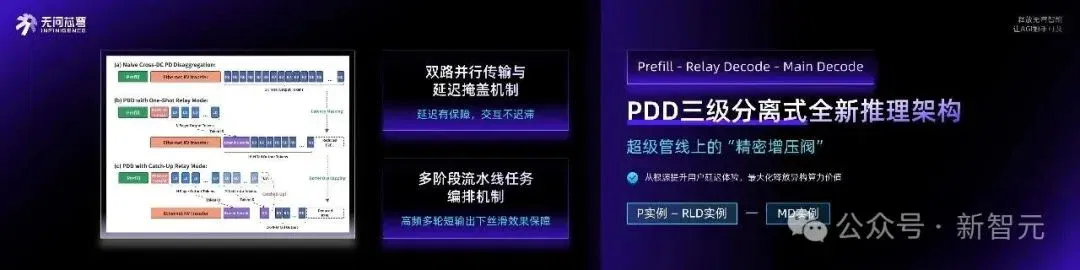
于是无问芯穹今天公布了首个面向大规模具身任务的云边端一体化管理与调度平台,首次把云端GPU集群、边缘算力节点和机器人真机设备统一接入,支持训练、数据采集、评测和真机执行等多种具身任务的统一编排运行。
训练侧,是RLinf V0.3大规模真机强化学习框架。
由于训练机器人,得靠一大批真机同时上场。但没电、故障、掉网这些状况,很容易让某台设备突然退出。而只要掉了一台,整场训练就可能直接崩掉、从头再来。
为了解决这个问题,RLinf首创了HotSwarm与端云协同训练模式。这就像给运行中的服务器热插拔硬盘,真机在训练时因为意外或者故障导致反复接进来、又掉出去,前后上下线超过1000次,训练照样零中断。
推理侧,则交给专攻机器人端侧的Mizar-Robo。
机器人身上的算力和电量十分有限。大模型想跑得动、还得跑得快,只能从流水线调度、算子内核、量化压缩到计算图一层层榨。
在与自变量机器人WALL-OSS系列模型的联合优化部署中,推理性能提升了7.14倍,端侧推理时延从500ms压缩至70ms,降幅达86%。
而这,正是「前店后厂一中心」最自然的延伸:从数字世界,一路走到物理世界。
他们要立的,是AI的地基
行业狂飙热炒到今天,聚光灯几乎全打在最聪明的那颗「大脑」上。
至于托着这一切的地基,反倒成了最没人在意的一层。
可真正决定这场智能革命能走多远、能渗透多深的,恰恰是这层地基。
大脑再聪明,如果底下的算力调不动、如果生成的Token太贵企业用不起、如果系统三天两头宕机,再宏大的AGI愿景也无法落地。
无问芯穹在WAIC 2026上交出的这份答卷,不是又一款产品,也不是又一项具体的API服务,而是一整套会自己迭代的地基。
它越是让你感觉不到它的存在,说明它运转得越完美。
而当同一套地基,能同时托住数字世界里如洪流般飞奔的Token,和物理世界里迈出第一步的机器人时,它就是整个智能时代前进的底盘。
所有的智能,最终都要从这样一层地基上长出来。
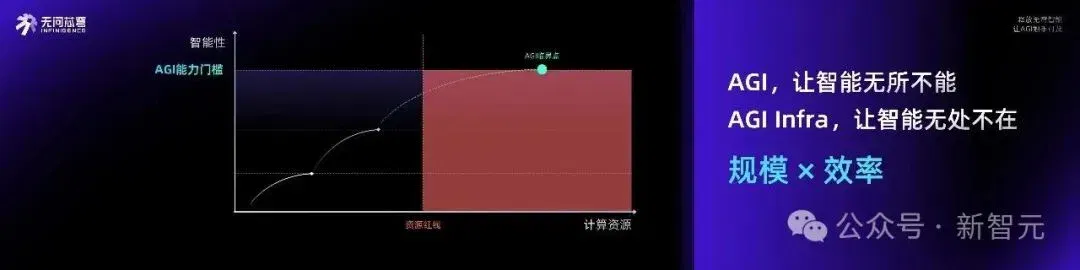
正如夏立雪在现场说的:「让智能无所不能,是AGI,而让智能无处不在,是AGI Infra。」
他们在WAIC上按下的,正是让这层地基自我优化与进化的那个开关。
文章来自于微信公众号 “新智元”,作者 “新智元”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
无问芯穹完成近5亿元A+轮融资,深度布局智能体时代的Agentic Infra (opens in a new tab)
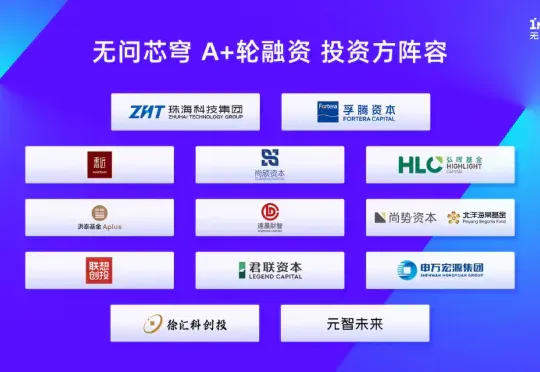
近日,无问芯穹完成近 5 亿元 A+ 轮融资,本轮融资由珠海科技集团、孚腾资本(元创未来基金)领投,惠远资本、尚颀资本和弘晖基金跟投,老股东洪泰基金、达晨财智、尚势资本&海棠基金、联想创投、君联资本、申万宏源、徐汇科创投、元智未来持续追投。此次融资阵容汇聚国家产业资本与头部市场化基金,“国资+市场”的双重认可,既肯定了公司面向国家重大战略需求的技术创新,也充分鼓励着无问芯穹,
无问芯穹披露 SOL-ExecBench 成绩,介绍 GPU 算子优化 Agent (opens in a new tab)
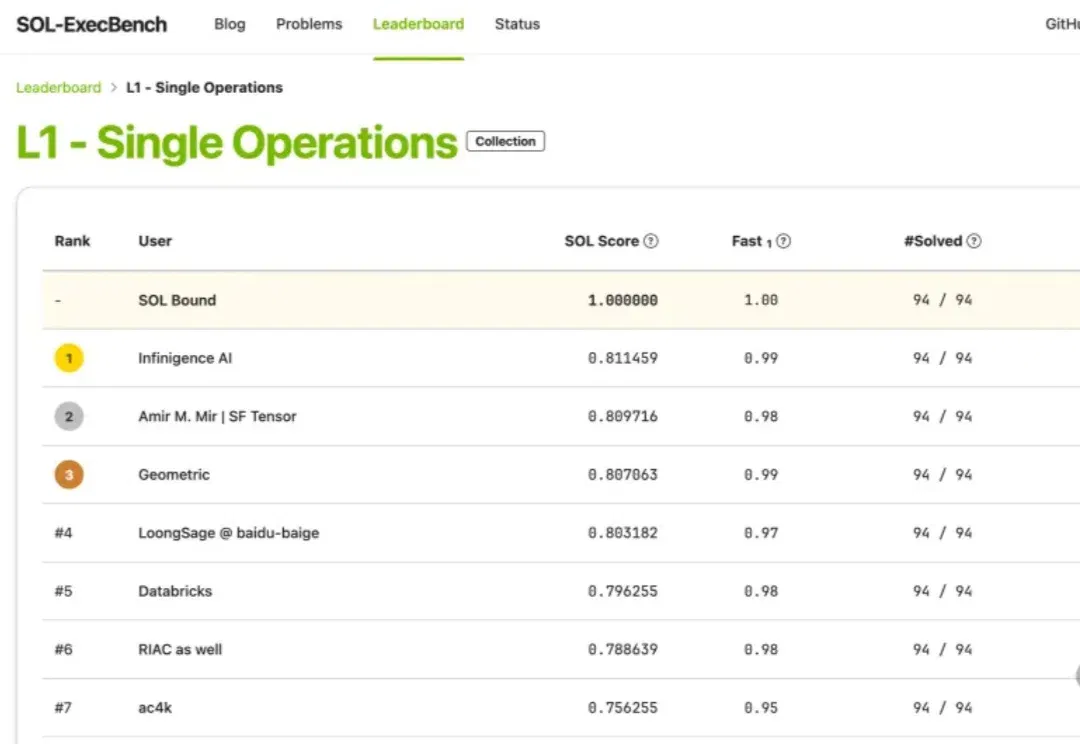
据团队披露,截至 10 月 26 日,无问芯穹在 SOL-ExecBench 的 235 道题中取得 88 项单题第一,并在两个赛道总分领先。文章进一步介绍容器隔离评测、共享记忆与分层优化策略,展示如何把代码生成和真实硬件反馈连接起来;动态榜单成绩不等同于所有 GPU 工作负载的性能优势。
累计43亿!国内最大AI Infra融资诞生,无问芯穹C轮拿下23亿 (opens in a new tab)
大厂林立,独立AI Infra厂商凭何能冲出重围?
Claude「断电」背后:中国基准首次捅开了AI万亿市场「死穴」 (opens in a new tab)
6月22日Claude全家桶集体宕机,只是冰山一角。当最强大模型被丢进真实机房直面「幽灵故障」,AISHPerf-智算运维智能体评测基准给出残酷答案:全军覆没,无一过50分。这道鸿沟,第一次被量化。
7亿!国内最大原生AGI Infra 无问芯穹 完成融资,AI基础设施成为新的价值锚点 (opens in a new tab)
刚刚,国内AGI Infra头部玩家无问芯穹宣布此前已再获超7亿元融资。这一数字不仅刷新了中国AI原生基础设施公司的融资纪录,也再次将“AI基础设施”这一长期被低估的赛道,推到聚光灯下。