红杉中国联合《麻省理工科技评论》中国发布“25岁以下AI创新青年先锋”
去年 6 月,红杉中国与《麻省理工科技评论》中国共同发起了“AI25”计划,希望寻找那些在 25 岁以下,正在定义 AI 时代的年轻力量。并将他们介绍给世界。今天,我们正式揭晓 2025 年“AI25”入选者名单。
AI 领域越来越多的创新,正由更年轻的一代推动完成。他们普遍只有 20 岁出头,有人还在校园里探索前沿研究课题,也有人已经开始了创业实践;更多人则同时穿梭于开源社区、论文平台与真实应用场景之间,在研究、工程与产品的交叉地带快速成长。
过去,人们认为科技的创新需要漫长的积累,成长是一个线性的过程:年轻人要先进入大公司、进入实验室、完成多年训练,才有机会参与真正重要的问题中去。但眼下,AI 正在折叠这一切。
一方面,AI 正在成为一种新的“基础语言”,成长于移动互联网时代的 00 后“原住民”们对 AI 的理解,并不只是“学习一项技术”,而更像是在使用一种天然熟悉的表达方式;另一方面,大模型技术的扩散正在以前所未有的速度降低创新门槛。越来越成熟的开源生态、算力基础与工具链,使年轻一代第一次拥有了接近顶级实验室的能力边界。
他们敢于突破,敢于跨界,敢于从零开始。相比于在既有体系中寻找确定性,他们更愿意进入那些尚未被充分验证的方向,在诸多的变量中建立自己的认知框架。可能面临失败,也可能需要准备随时推倒重来,但他们并不恐惧。这种不断重构、不断试错的能力,是 AI 时代最重要的创新气质。
去年 6 月,红杉中国与《麻省理工科技评论》中国共同发起了“AI25”计划,希望寻找那些在 25 岁以下,正在定义 AI 时代的年轻力量。并将他们介绍给世界。
通过征集、报名、评选,我们认识了来自各个领域的参评创新青年先锋。有人在基础研究领域做出了令人惊喜的原创工作;有人凭借出色的工程能力,独立完成了影响广泛的开源项目;也有人正在尝试用 AI 去解决真实世界中的复杂问题,从教育、医疗到机器人、科学研究,不断拓展技术落地的边界。
今天,我们正式揭晓 2025 年“AI25”入选者名单。
未来,我们还将与中关村科学城开展深度合作,共同打造面向新锐青年的 AI 原生社区,为青年创新人才的成长与发展提供更为广阔的平台与生态支撑。
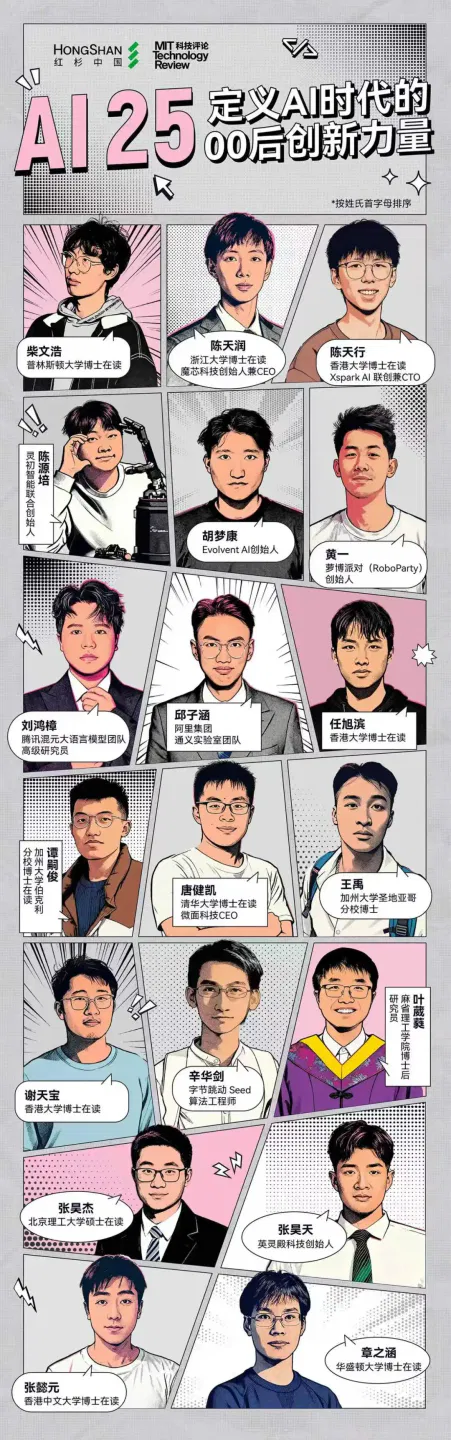
2025 年“25 岁以下 AI 创新青年先锋”入选者名单如下(排名不分先后):
辛华剑目前在字节跳动 Seed 团队担任算法工程师。他的研究方向聚焦逻辑与人工智能的交叉地带,他从哲学系出发,走出了一条让大语言模型学会严格数学证明的路。
他是 DeepSeek-Prover 系列的核心作者之一,这一系列工作让大语言模型不再停留于“看起来正确”的自然语言推理,能够在 Lean 4 这类形式化证明系统中生成可被机器逐步验证的严格证明。将 MiniF2F 基准上的性能从 50% 一路推至接近满分,让形式化推理从学术演示走向实用级别。
他的研究成果不仅停留在基准测试,他提出了模块化定理证明的范式,使得语言模型能够在证明过程中持续积累引理、抽取可复用的知识模块,再在攻克新定理时复用这些知识模块,开创了 AI 像数学家一样建立知识库的先例。在 IMO 2025 中,他参与开发的 Seed-Prover 解出 6 题中的 4 题,获得 30 分的银牌水平成绩,这是机器定理证明系统在国际数学奥林匹克竞赛上的标志性工作之一。
目前他正致力于将 Lean 定理证明中的方法和策略推广到一般的 Coding Agent 任务中,探索推理、行动和验证结合的更广泛实践。
邱子涵的研究从理解大模型的内部运作机制出发,将发现直接转化为架构层面的创新,并在千亿参数级前沿模型中得到验证。
他的研究专注于大语言模型的机制分析与架构设计。他发现稠密语言模型中存在自发涌现的模块化结构,不同参数子集会自组织地负责不同功能,该工作获 NAACL 2024 杰出论文奖。在此基础上,他深入分析了混合专家模型中专家分工失效的关键原因,提出的修复方案已被直接应用于 Qwen3 系列模型的训练。
在架构设计方向,他提出的门控注意力机制在缩放点积注意力之后引入可学习的 sigmoid 门控,为注意力输出带来非线性与稀疏性。这一看似简单的修改在 150 亿参数 MoE 模型和 17 亿参数稠密模型上均取得一致的性能提升,同时消除了困扰大模型训练的“注意力汇聚”现象,显著增强训练稳定性。该工作获 NeurIPS 2025 Best Paper Award,并被集成进 Qwen 系列的核心架构。
他的工作证明了对模型机制的深入理解不是锦上添花,而是效率突破的起点。
刘鸿樟曾深度参与月之暗面多个战略级项目的 0 到 1 探索,包括 Kimi 基础模型 K2.5、K2、Agent Swarm(智能体集群)和 Kimi-Researcher(深度研究)等智能体产品。
在大语言模型和智能体的研发中,他构建过百万条高质量后训练数据,以用户为中心,攻克着长程任务与多轮交互等对齐难题。
学术与开源方面,他以核心作者建设 AI 基准测试 xbench 等知名工作,累计谷歌学术引用超 4,000 次。他也是特工宇宙和 FoundationAgents 等 AI 开源组织的创始成员,相关项目在 GitHub 上累计获得 100k+ stars,涵盖多个明星级智能体项目。
另外,他自学生时代起便连续参与或主导多个 AI 智能体创业项目,如澳洲税法智能体、硅谷教育智能体,积累了从技术、产品到商业的完整视角闭环。其长期目标是设计下一代人与智能体共同成长的新形态。
陈天润的研究从让普通人轻松创建 3D 内容出发,一路演进到让 AI 理解、推理并生成整个三维物理世界。
他长期专注于三维视觉与图形学,致力于用 AI 大幅降低 3D 内容创作的门槛。他提出的 Deep3DSketch 系列工作让用户仅凭一张手绘草图即可生成高保真三维模型,后续延伸至 VR 空间中的手势建模,最新工作更实现了从单张图片直接生成可编辑的 CAD 工程文件,打通了 AI 生成内容与工业设计流程之间的关键环节。
基于在三维几何、材质与场景生成方面的深厚积累,他创办的魔芯科技已从消费级 3D 打印全面转型 4D 世界模型。2025 年底公司发布自研交互式世界模型 KOKONI-World,可在 1,080p 全高清分辨率下实现数分钟的实时交互探索,支持 6 自由度精确相机控制,用户像玩游戏一样在 AI 生成的 4D 虚拟世界中自由漫游。目前该技术已在具身智能、自动驾驶、数字孪生等方向开始产业落地。从草图建模到世界模型,他的工作沿着一条清晰的脉络展开:让 AI 从生成一个物体,走向理解整个世界。
叶葳蕤不只想让机器人动起来,还希望它们能以接近人类的速度学习。他始终站在具身智能的前沿,以开源代码持续把每一次算法突破压缩为整个社区可直接复用的能力。
他推出的 EfficientZero 系列改写了高效强化学习的工程基线,仅用两小时的交互数据,就在相关基准上超越人类平均水平。随后公开的开源代码库迅速被全球研究者、独立开发者乃至工业实验室复用、复现与二次开发,衍生项目构成了一个围绕样本高效 RL 的活跃生态。其后,V2 版本推广到连续与离散控制、视觉与本体感知输入的混合空间,使该算法演变为面向真实控制问题的通用框架。随后,他希望让机器人直接在开放世界中学习,探索用无动作标签互联网视频训练世界模型,成功将基础模型的先验知识注入机器人大脑,在真机环境中展现了显著的适应力提升;与之配套的 Video2Policy 等开源探索,把互联网级别人类视频转化为可用于训练的数据源。
他下一阶段的目标是搭建一个融合世界模型、小样本适应与终身学习的分层架构:除了让机器人执行任务,还要让它们真正理解物理世界、持续迭代升级。
陈源培专注具身智能灵巧操作,让机器人通过观察人类动作来理解操作中的关键规律,并借助智能决策方法将简单动作串联成复杂任务,从而显著提升机器人在长时间操作中的表现。他的研究核心方向为强化学习创新及人类演示数据高效利用。代表性成果包括 Bi-DexHands 和 Sequential Dexterity。
Bi-DexHands 发布了复杂双手协同开源系统,通过大规模并行仿真与课程学习,使机器人双手在多项操作基准上达到接近人类的表现水平,为灵巧操作研究树立了新的标杆。
在此基础上,他主导了 Sequential Dexterity 项目,旨在突破长时序的操作瓶颈。该方案从人类数据中学习以物体为中心的操作表征,结合强化学习实现策略链接,大幅提升复杂任务处理能力并验证人机数据对齐价值。
如今,该项目建立的数据转化流程开辟了真实场景数据利用新路径。基于这些技术积累,他联合创立灵初智能,融合视觉-语言-动作(VLA)模型与强化学习(RL),推动具身智能从实验室走向实际应用,致力于打造服务日常生活的智能机器人产品。
章之涵是华盛顿大学计算机科学与工程学院在读博士生。他本硕均以最高荣誉毕业于佐治亚理工学院,十九岁便站在学术起跑线。他是谷歌博士奖学金截至目前最年轻的得奖者之一。他的研究聚焦于可持续普适人工智能,主张从革新当前的计算生态,实现 AI 基础设施与环境的完全兼容。为此,他通过跨学科方法,将新兴材料与 AI 辅助技术深度融入系统设计。
21 岁时,他让可回收电路板的构想登上Nature Sustainability。该研究使电路板中的器件、贵金属与基底材料能够高效分离并循环利用,为全球每年数以千万吨计的电子垃圾问题提供了一种全新的绿色解决方案。此后,他研发的自主 AI 多智能体系统再度登上Nature Electronics,该系统能自主评估产品全链条碳足迹。他的成果技术已被谷歌和亚马逊作为内部工具采用。
此外,他将自主 AI 智能体广泛应用于健康、地质灾害预测等前沿现实问题。其构建的个人健康智能体,通过分析可穿戴设备数据,实现了对慢性病风险的早期预警与个性化干预。
黄一是萝博派对(RoboParty)创始人兼 CEO。他长期坚持全栈开源理念,希望通过开放硬件、控制算法、训练部署工具链与工程 know-how,打造一个像安卓一样开放的具身智能 Infra,让更多有能力的开发者参与到技术创造中来。
本科期间,他展现出突出的工程落地能力。他曾主导陆空两栖无人机项目,在全国大学生科技竞赛中斩获一等奖。随后,他完成低成本双足机器人 AlexBot 的 0-1 开发,并开源结构设计、硬件电控与控制相关内容,并在头部机器人公司的支持下进一步迭代,引发开发者社区关注。并被多家企业及高校复刻应用。
2025 年初,他创立萝博派对,专注全栈开源双足人形机器人。2026 年 1 月正式开源双足人形机器人萝博头原型机(ROBOTO Origin),开放范围覆盖研发流程、结构、电气、训练与部署。截至目前,该项目 GitHub stars 已突破 2,000,社区规模超过 2,500 人,并获得数百份订单意向。
他的目标并非单纯制造硬件,而是想打造一个开发者平台,推动行业基于开放标准协同创新,加速具身智能普及。
谭嗣俊的研究方向聚焦于大模型智能体的后训练与强化学习。他联合创办的开源研究组织先后发布多款性能领先的开源模型与智能体,并完整公开训练数据、代码与训练日志,推动了社区在智能体后训练领域的科学复现与协作创新。
其核心工作是主导研发模块化智能体后训练平台 rLLM。作为团队所有模型与智能体的统一训练引擎,rLLM 覆盖持续部署、数据采集、环境交互、奖励建模、强化训练、评估验证与模型再部署等关键环节,致力于构建智能体“从经验中学习”的完整闭环。
他带领团队先后训练出多款具有行业影响力的开源模型与智能体。其中,DeepScaleR-1.5B 聚焦数学与逻辑推理,在轻量参数规模下实现了优秀的数理推理与竞赛解题能力;DeepCoder-14B 面向代码生成与程序推理任务,显著提升了模型的代码理解、生成与调试能力,整体性能达到国际领先的开源代码智能体水平。此外,软件工程智能体 DeepSWE 在真实软件开发场景中展现出强大的任务规划、代码修改与工程协作能力,并刷新了开源软件工程智能体的技术水平。
任旭滨是香港大学博士生,开源 AI Agent 项目 nanobot 作者。其研究与工程工作长期围绕大语言模型、推荐与检索增强生成、智能体系统展开,关注如何将模型能力转化为可运行、可扩展、可被真实用户使用的基础设施。
他围绕 LLM 增强推荐系统,探索大语言模型语义空间与用户行为关系空间的结合;同时将检索增强生成拓展到长视频理解与轻量化部署等场景。相关工作覆盖推荐系统、RAG、多模态理解与智能体应用。
他发起并持续维护 nanobot,是一个超轻量级开源个人 AI Agent,试图用极简的代码结构实现 Agent 运行时、工具调用、多入口交互、上下文管理与任务执行能力,并在开源社区获得广泛关注。
目前,他的工作重心正在从“用 LLM 改造推荐与检索系统”,进一步拓展到“构建下一代 Agent 运行时与 Agent-Native 基础设施”。他希望通过开源生态、轻量化架构和真实工作流验证,推动 AI Agent 从聊天式助手走向能够接入工具、理解上下文、执行任务并长期协作的新型 AI 系统。
柴文浩的研究始终围绕同一个问题:如何让 AI 更高效地理解和处理视频等多模态信息。
专注于多模态智能系统的效率与统一性,在长视频理解方向取得了一系列突破。他主导的 MovieChat 借鉴人类记忆机制,将视频帧动态压缩为稀疏表征,率先实现了小时级长视频的对话式理解。此后他进一步将视觉信息压缩至原来的 1%,几乎不损失性能;又将线性注意力和稀疏注意力引入开放式视频理解,持续探索效率与通用性兼得的路径。
他同时关注 AI 系统的评估问题。他联合领导的 LiveCodeBench Pro 召集国际信息学奥赛金牌选手,对前沿大模型在竞赛编程中的失败模式进行逐行分析,揭示了当前模型代码实现能力强但算法推理能力弱的关键短板,该基准已被 Gemini 列为官方评估工具。
从视频理解到代码推理评估,他的工作覆盖了多模态智能从能力构建到度量验证的完整链条。
陈天行的研究为具身智能构建从数据、模型到评测与部署的底层基础设施。他试图解决具身智能发展中“高质量数据稀缺”和“物理世界理解不足”这两个关键瓶颈。他是 Xspark AI 联合创始人兼 CTO、香港大学 MMLab 博士生,以及 Lumina 具身智能社区创始人,同时从科研、工程与社区三个维度推动具身智能技术的发展与落地。
他主导和参与的 RoboTwin 系列通过可扩展仿真数据弥补真实机器人数据缺口,为双臂机器人训练与评测构建了可重复、可扩展、可部署的技术链路;RoboDojo 系列则进一步面向通用机器人操作评测,构建统一的 Sim-and-Real Benchmark,为行业提供更接近真实部署需求的前沿评测基础设施。带领 Xspark AI 致力于构建可信具身智能落地系统,其长期目标是打造可信具身智能全栈技术,完善行业底层基础设施,让具身智能真正可靠、可用地进入万千真实场景。
此外,他发起的 Lumina 具身智能社区已成为国内头部具身智能社区之一,并组织数十名领域学者共同编写 Embodied-AI-Guide 项目,已获得近 15K GitHub stars。
胡梦康想解决的是人工智能走向真正自主的核心命题:让 LLM Agent 摆脱依赖人类喂养的天花板,自己生成任务、自我训练、持续进化。
在香港大学攻读人工智能博士期间,他解决 Agent 执行链条的核心短板。Tree-Planner 把任务规划重新拆解为计划采样、动作树构建、有根决策三个阶段,让大模型在具身场景中实现高效闭环规划。HiAgent 瞄准长程任务的工作记忆瓶颈,提出以子目标为单位的分层记忆管理机制,在五项长程任务上让智能体成功率翻倍、平均步数减少 3.8 步。 OWL 把多智能体协作从学术概念推向可落地的任务自动化框架。
之后,他把研究重心转向数据,通过 AgentGen,Text2World,Agent2World 等系列工作,让 Agent 自动生成多样化的训练环境、任务与数据,基于这套方法训练的开源小模型比肩甚至超越了世界领先的闭源模型。他创立的 Evolvent AI,为 Agent 提供高质量训练与评测数据,已与多家前沿实验室达成战略级合作。目标是建立一套让 Agent 自己生成任务、自己训练,自己评估、自己迭代的系统。
唐健凯致力于构建让 AI“读懂人”的人类理解基座模型,可实时感知生理、情绪与意图等人类状态从而实现个性化智能交互。
他构建的 FacePhys Omni 基座模型,将心率、呼吸、情绪等人体状态信号与表情、动作、注视和语境对齐到统一的多模态空间,让机器从“看见外在动作”升级为“理解内在状态”。这背后是多年的底层技术积累:他提出的 FacePhys 算法利用流式人类状态空间,仅凭普通摄像头即可秒级输出 120+项生理指标,心率检测平均误差小于 2 BPM,达到医疗级精度,并可运行在手机、浏览器乃至嵌入式设备上;他发表的 20 余篇论文累计已被引用 2,000+次,构建的 MMPD 数据集与 rPPG-Toolbox 开源库已成为该领域的事实标准,被百余所高校和机构采用。
他同时推动技术走向临床与商业。其感知系统已在北京安贞医院完成上千人规模的临床队列验证,覆盖多病种与全年龄层。2025 年他创办微面科技,带领团队打造人类视频感知交互基座模型,已服务近 10 万 C 端用户并支撑数十万次 B 端 API 调用。目前该技术已在健康监测、消费电子和智能座舱等场景落地,并正作为标准化感知模块嵌入具身智能平台——让机器不仅能看见世界,更能读懂人心。
王禹本科毕业于中科大少年班,后在加州大学圣地亚哥分校获得博士学位。他的研究重点聚焦于大语言模型的记忆增强机制,旨在解决其长期上下文理解与知识一致性维护的核心难题。
他主导研发了开源落地的多模态、多智能体 AI 记忆系统 MIRIX,能够处理高分辨率屏幕截图。该系统已通过桌面应用原型验证,并在多个基准上显著超越当时的 memory/RAG 方法,展示出推动 AI 从短期任务向长期智能跃迁的潜力。
此外,他还系统性地探索了大模型记忆机制方向,在不增加 GPU 内存开销的前提下,显著提升了大规模语言模型的记忆能力。并且构建了自我更新大模型的技术路线图,提出“模型自我更新”范式、实现长期记忆的高效扩展、构建终身学习的理论框架等。
曾在 xAI 负责模型的记忆模块。现在,他已加入工业界,将继续推动 AI 从短期任务系统迈向具备“经验驱动”长期记忆与持续学习能力的智能体系。
谢天宝的研究围绕一个核心目标展开:让 AI 不只是理解语言,而是能够真正操作计算机完成任务。
他专注于语言智能体的能力构建与评估体系设计,从早期的知识接地与工具调用研究起步,逐步将语言模型的能力边界从“回答问题”推向“执行操作”。他开源的语言智能体平台 OpenAgents 获得超 4,000 GitHub stars,为研究社区提供了可复现的智能体开发基础。
他最具影响力的贡献是 OSWorld,在真实 Ubuntu、Windows、macOS 桌面环境中评估 AI 智能体的基准测试。OpenAI 和 Anthropic 均直接采用该基准来衡量各自模型的 computer use 能力,使其成为这一方向的事实标准。后续的 OSWorld-G 进一步聚焦界面理解瓶颈,通过构建 400 万样本的训练数据大幅提升了智能体对屏幕元素的定位准确率。
在此基础上,他将研究成果转化为产品级能力。作为通义千问团队成员,他参与了 Qwen3-Coder 的核心研发,推动智能体从学术基准走向真实的编程与操作场景。
张昊杰聚焦“让机器听懂身体的声音”这一核心命题,尝试以低成本、非侵入的方式实现疾病筛查与健康管理,在计算机听觉和医疗健康交叉领域实现了从算法、模型到硬件的完整闭环。
针对心音、肠音、呼吸音等多种体音信号,他研发了轻量化与可解释性兼顾的算法框架,使模型在保持高精度的同时显著降低了计算与存储开销,满足了边缘设备部署的要求。
此外,他主导设计了多种端侧可执行原型系统模型,包括用于心音瓣膜病诊断的模型、用于冠心病辅助诊断的心音分析模型,以及用于结直肠癌筛查的肠鸣音智能分析模型,解决了医学 AI 长期存在的实验室到临床落地瓶颈,为资源受限场景下的主动健康筛查提供了切实可行的解决方案。
张昊天的研究横跨物理、药学与计算机,旨在用生成式 AI 重塑药物设计范式,推动 AI 制药从单一生物大分子迈向生命分子层面的全覆盖。
从浙江大学药学与物理学双学士起步,他开发了 ResGen 和 SurfGen,分别通过口袋感知建模和表面几何学习实现高效靶向分子设计,为基于结构的药物设计提供了新视角。随后他进一步地提出了统一先导化合物优化框架 Delete,应用于先导化合物优化环节并已实现产业转化。在积累了丰富的单模态小分子设计经验后,他加入了诺奖得主 David Baker 的实验室开始探索蛋白设计。
他在攻读博士期间毅然退学,快速组建了一支团队实现了全模态分子设计基座模型 ODesign,将蛋白设计能力扩展至生命分子全模态。他走上创业的道路后,成立了英灵殿科技以追求更进一步的通用科学人工智能,获得顶级资本的数千万美元支持。
张懿元主要从事多模态基础模型、视觉语言模型、视频建模等方向的研究。他的研究主线围绕多模态学习,致力于以更简单的架构假设、更可扩展的预训练范式和更系统化的工程设计,将文本、视觉、语音等多种模态统一建模于智能系统之中,推动多模态基础模型向更高效、更泛化、更贴近真实世界智能的方向发展。
在学术研究方面,他与团队设计了多模态学习统一框架 Meta-Transformer,探索在缺少配对数据的条件下实现多模态统一学习,支持文本、图像、视频、音频等多种模态的统一建模;此外,他与团队提出了多模态上下文(MiCo)大规模全模态预训练范式,在多项多模态任务中取得领先结果,并为多模态通用理解领域提供了有效思路。在开源社区,他作为核心贡献者开源了多个 GitHub 项目,累计获得 1.2 万余颗 stars。
学术研究之外,他也积极推动多模态技术在工业界的发展。他参与了多模态大模型的架构设计、可扩展预训练及视频建模等工作,并作为核心贡献者研发了多款业界领先的多模态基础模型。

我们期待,通过 AI25,让更多年轻人彼此看见、建立连接,并获得持续成长所需要的资源、反馈与同行者。从研究、工程到产品与创业,那些今天仍显稚嫩的尝试,或许会在未来几年里,逐渐长成真正改变 AI 时代的力量。
与此同时,新一届“AI25”评选报名窗口也已正式开放。感兴趣的朋友可点击文末“阅读原文”完成报名。
以下是参与本届 AI25 评审工作的专家与学者名单,他们从学术研究、产业实践与技术创新等多个维度,为我们提供了宝贵的支持。
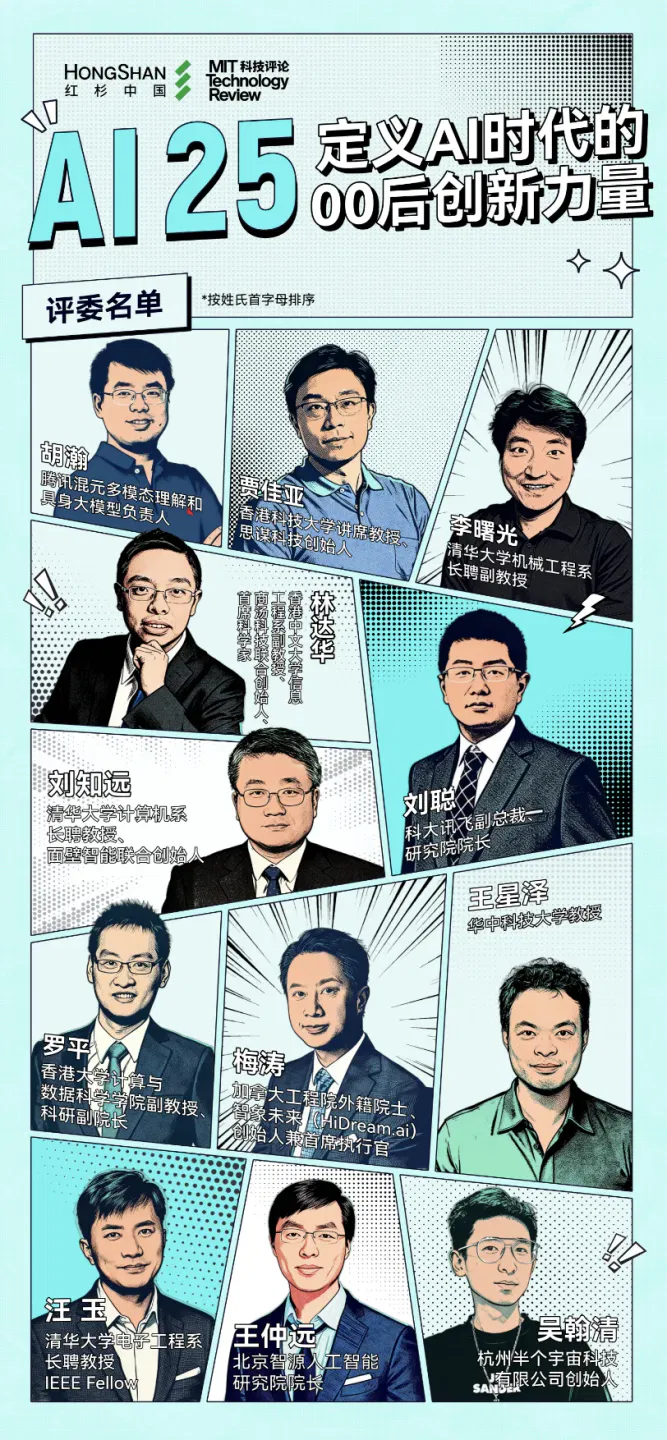
以下为评委的个人介绍:
胡瀚:腾讯混元多模态理解和具身大模型负责人,长期从事计算机视觉与多模态大模型研究。作为核心作者参与提出 Swin Transformer,其研究成果在学术界与工业界均产生广泛影响。
贾佳亚:香港科技大学讲席教授、思谋科技创始人,国际计算机视觉与 AI 领域的重要学者。其在计算机视觉、多模态模型与智能制造方向发表大量高影响力成果,并推动 AI智能体在工业场景中的大规模落地。
李曙光:清华大学机械工程系长聘副教授,研究方向涵盖机器人、智能制造与先进机械系统。曾在哈佛大学与 MIT 从事相关研究工作,持续推动机器人与智能系统交叉创新。
林达华:香港中文大学信息工程系副教授、商汤科技联合创始人、首席科学家。其长期从事计算机视觉、深度学习、大模型与生成式人工智能方向研究,推动了中国计算机视觉技术产业化进程,并持续推动大模型与生成式 AI 的前沿探索。
刘聪:科大讯飞副总裁、研究院院长,负责智能语音和大模型等人工智能技术研发。深度参与讯飞星火国产大模型体系建设,推动 AI 技术在教育、办公等产业场景中的应用。
刘知远:清华大学计算机系长聘教授、面壁智能联合创始人,长期从事自然语言处理与大模型研究。在知识表示、中文预训练模型与开源生态建设方面具有广泛影响力。
罗平:香港大学计算与数据科学学院副教授、科研副院长。研究方向包括具身智能、生成式人工智能与智能体。持续关注 AI 与物理智能体的交叉创新及其产业应用。
梅涛:加拿大工程院外籍院士、智象未来(HiDream.ai)创始人兼首席执行官。梅博士不仅是计算机视觉和多媒体领域的国际知名学者,他创立的智象未来也是全球领先的人工智能创新科技企业和多模态大模型领域的独角兽。
王星泽:华中科技大学教授,长期从事人工智能与智能计算相关研究。关注 AI 系统与工程实践结合,在青年科研人才培养方面亦具有影响力。
汪玉:清华大学电子工程系长聘教授,IEEE Fellow;长期从事智能芯片与系统研究。推动 AI 算法与芯片协同设计,在智能计算体系结构领域具有重要影响。
王仲远:北京智源人工智能研究院院长,研究历程覆盖微软亚洲研究院、Meta、美团与快手等全球顶尖研究机构与头部科技企业。王仲远博士担任智源研究院院长后,他以推动 AI 从数字世界迈向物理世界为核心目标,带领团队在语言大模型、多模态大模型、世界模型、具身智能等方向开展基础研究和应用探索。
吴翰清:杭州半个宇宙科技有限公司创始人,前阿里云首席安全科学家。长期关注 AI 安全、网络安全与新技术创业,被视为中国年轻一代科技创业者中的代表人物之一。
文章来自于微信公众号 “DeepTech深科技”,作者 “DeepTech深科技”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
《纽约时报》人物报道回顾 Dario Amodei 的研究与创业经历 (opens in a new tab)
报道从早年的研究经历、OpenAI 时期和 Anthropic 创业讲起,并梳理 Dario Amodei 对前沿模型研发速度和安全治理的公开立场。
赵祺负责豆包前,怎样积累产品、增长与组织经验 (opens in a new tab)
报道回顾赵祺从豆瓣阅读、豌豆荚到字节跳动的履历,以及他接手豆包后面对的产品整合和商业化课题。月活与组织变化按原报道时间和口径呈现。
齐俊元不太对劲 (opens in a new tab)
最近我一直在刷齐俊元的新闻,除了田柯宇,刷最多的就是齐俊元。这两个人的事总在我脑子里打转,甚至在我游泳练薄肌的时候都不肯消停。
那群在清华玩音乐的年轻人,后来成了中国AI的顶梁柱。 (opens in a new tab)
2017年秋天,清华大学紫荆宿舍区又迎来了一年一度的「百团大战」。
基座模型田柯宇从不缺卡 (opens in a new tab)
事情大家都知道了,田柯宇昨天一炒作,一堆人联合出来打假田神,不仅列时间线、列代码、还列上了自己的Github主页,搞学术的就是严谨啊👇 https://keyu-tian-sabotage.github.io