全球第一! 中国模型登顶榜首,首个可编辑AI语音来了
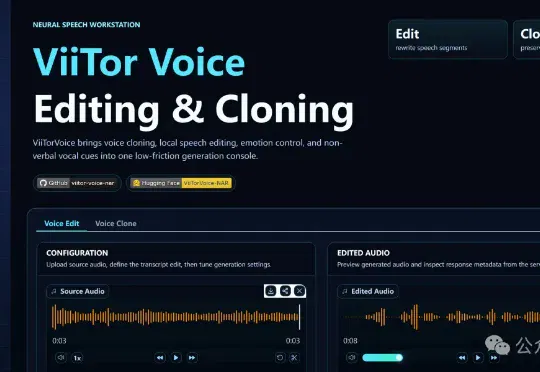
全球第一!中国AI语音ViiTorVoice首创「局部编辑」神技:配音错字告别重录,像改Word一样修语音。内附姆巴佩、哈兰德爆笑实测,快来见证!这个凭空出世的中国模型,将 Qwen3-TTS、CosyVoice3、Fish Audio 等一众主流巨头挑落马下,径直登顶综合排名第一!
中国AI,登顶全球第一!
最近,在全球语音权威评测榜单 Seed-TTS 上,突然杀出了一匹令人胆寒的黑马。
它就是ViiTorVoice 。
这个凭空出世的中国模型,将 Qwen3-TTS、CosyVoice3、Fish Audio 等一众主流巨头挑落马下,径直登顶综合排名第一!
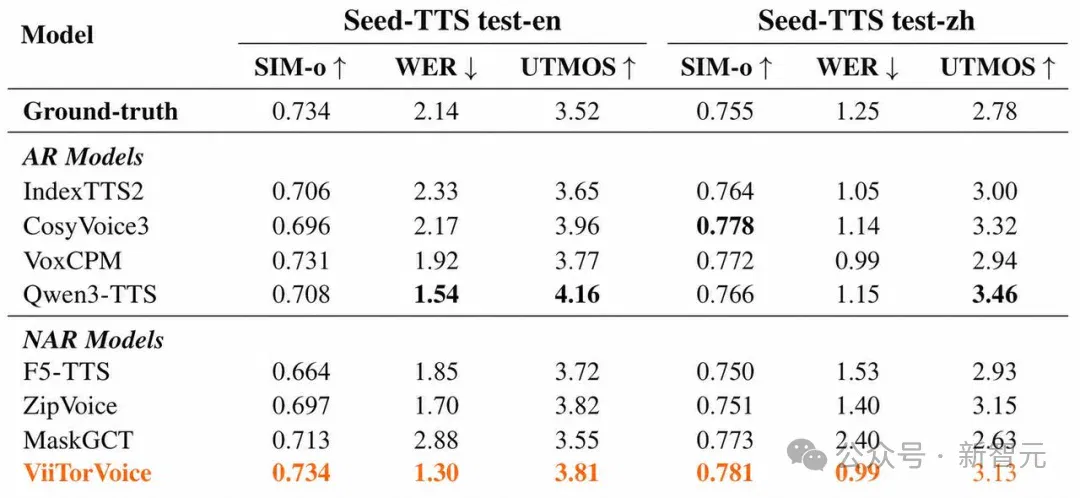
凭借英文词错率(WER)1.32、中文词错率0.99的恐怖数据,它一举击穿了行业的极限天花板,成为当前评测体系中,全球首个中文词错率突破 1.0 大关的里程碑模型。
这个登上榜首的AI语音大模型ViiTorVoice,来自国产公司云上曲率。它终结了长久以来的行业痛点:语音无法局部编辑。
这个全球首个具备「局部编辑」能力的AI,将彻底改变了整个行业!
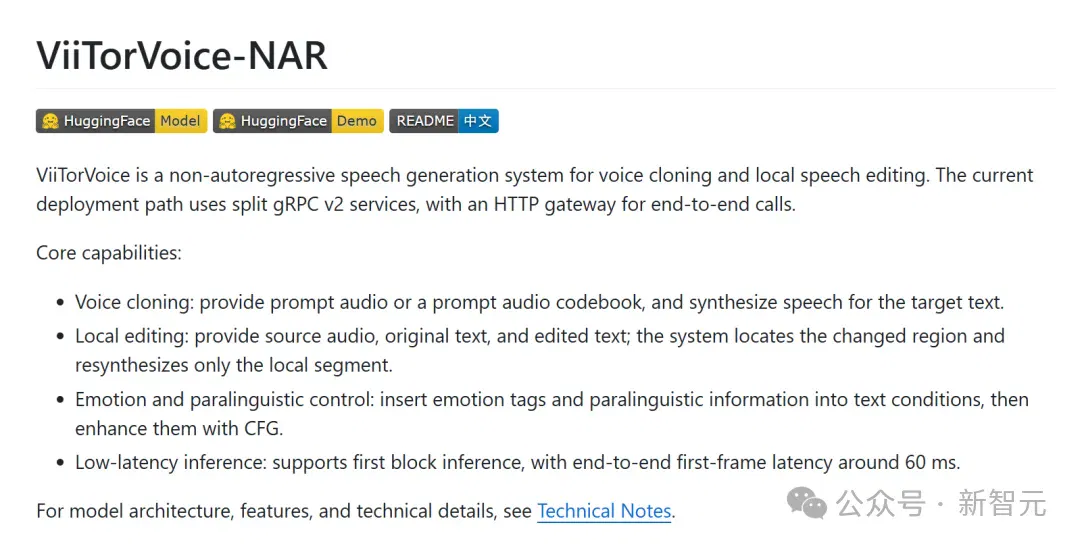
Hugging Face Demo: https://huggingface.co/spaces/ZzWater/ViiTorVoice
GitHub: https://github.com/viitor-ai/viitor-voice-nar
模型权重: https://huggingface.co/ZzWater/ViiTorVoice-NAR
实测:怕饿晕找哈兰德
所以,ViiTorVoice的上手效果究竟如何?
我们用它做了一些实测,看看它到底能不能扛住整活界的考验。
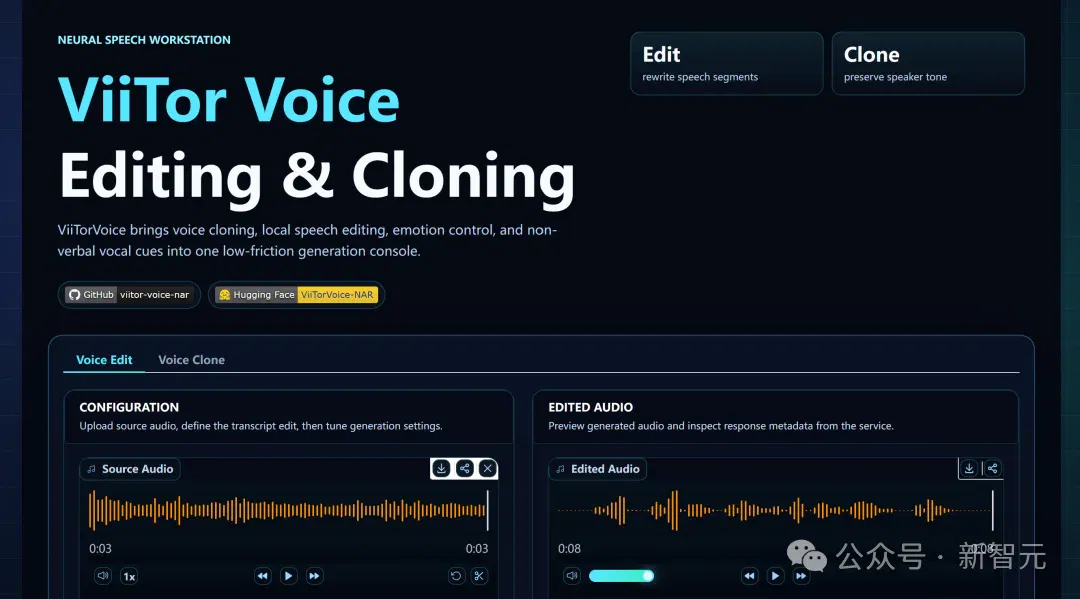
实测一:哈兰德的最新梗——挪威队伙食不够了
昨天,全网都被这条新闻笑喷了。
挪威队参加世界杯,带了3名主厨去美国,还从本国空运食材,就为了喂饱哈兰德。网友热评:哈兰德一个人吃掉了挪威队的伙食预算。
我们立刻整活,找来最近哈兰德最火的广告,用ViiTorVoice把原广告词变成了:「哈兰德要一头牛,怕饿晕找哈兰德」。
结果让人笑疯了。ViiTorVoice新生成的这几个字,不仅音色跟哈兰德一模一样,还完美保留了他那种低沉的嗓音特质。
前后的呼吸节奏和重音分布做到天衣无缝,新版广告一出,效果绝了。
实测二:姆巴佩的「补水啦」,无缝植入任何正经场景
最近,姆巴佩广告中那句魔性的「补水啦~ 」已经洗脑了无数网友。
那语调、那尾音上扬的「啦~」,堪称2026年度鬼畜区预备役素材。
我们用ViiTorVoice直接把其中的台词替换成「我驾驭未来,补水啦~ 」。
结果非常搞笑,ViiTorVoice生成的「补水啦~」三个字,完美继承了原广告里魔性调调,尾音上扬的程度丝毫不差。
最绝的是,它还被无缝融合进了汽车广告那种低沉稳重的旁白节奏里,前后语句在呼吸气口和背景底噪上,完全看不出拼接痕迹。
另外,网站上还有个「AI会说话的照片」功能。
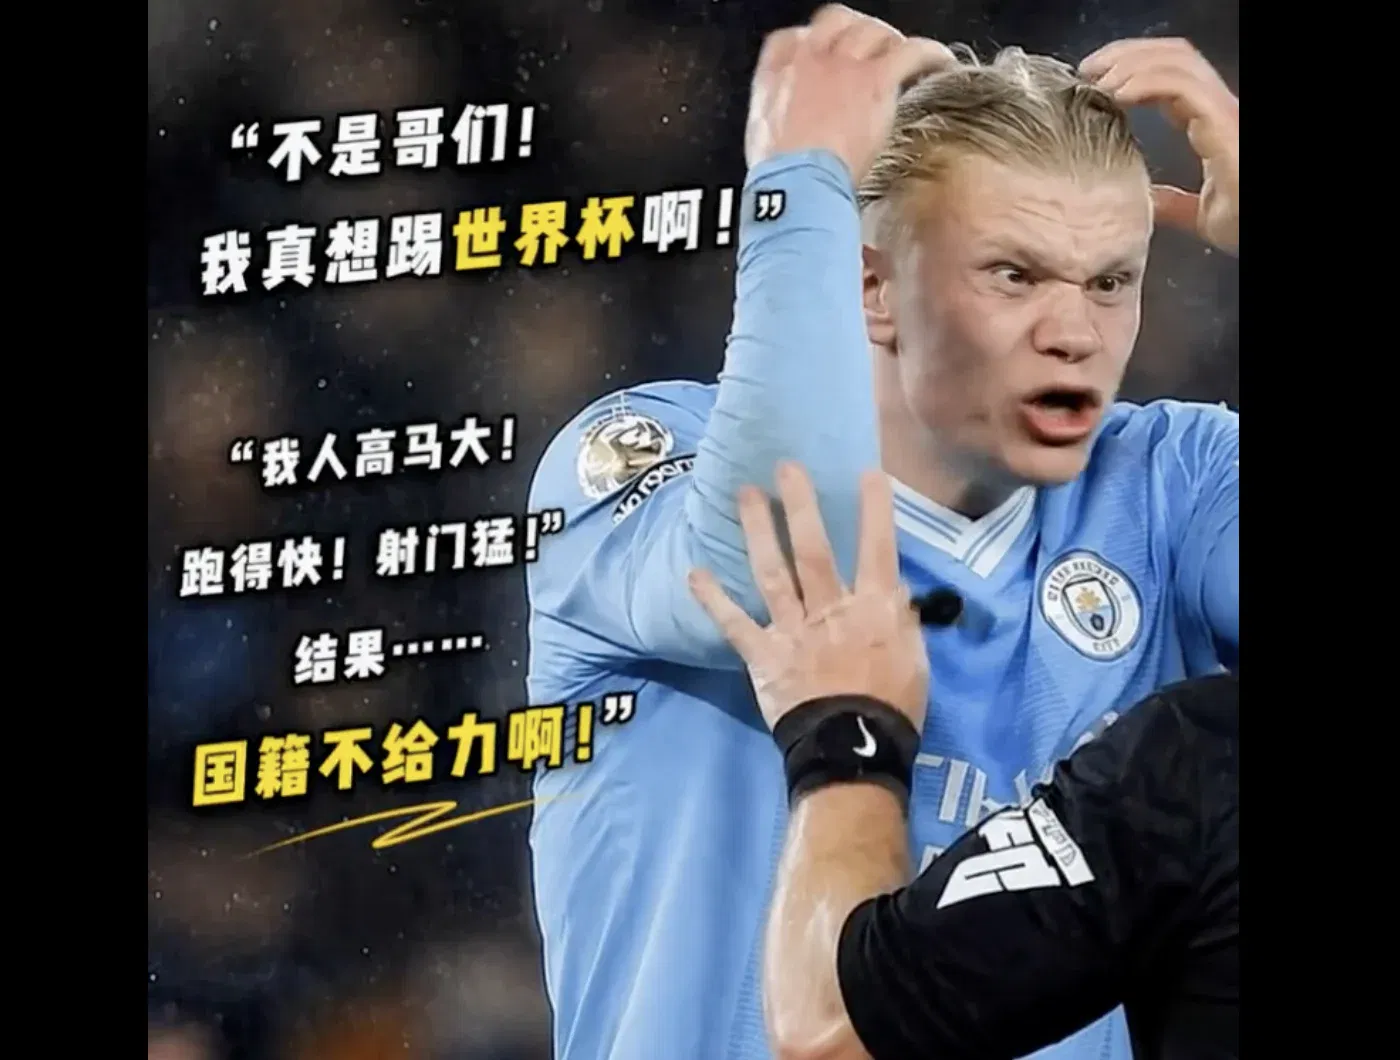
那就让哈兰德向我们吐露一下心声,为什么在赛场上急得想吃人。
就如本文开头所说,在真实环境中,更耗费时间的往往不是第一次生成,而是后期修改。
比如短剧已经完成配音,上线前发现角色人名需要调整;广告文案临时修改了产品名称;课程内容更新了一个专业术语。
重新生成一句新的配音并不难,真正耗时耗力的,是如何让修改后的内容与原有音频保持一致,尤其在音色、情绪衔接、停顿突兀、时间轴同步这些细节上。
ViiTorVoice推出的片段级编辑能力,就解决了上述难题——你可以任意替换某个词、某句话、某个片段。
以下视频来源于ViiTor
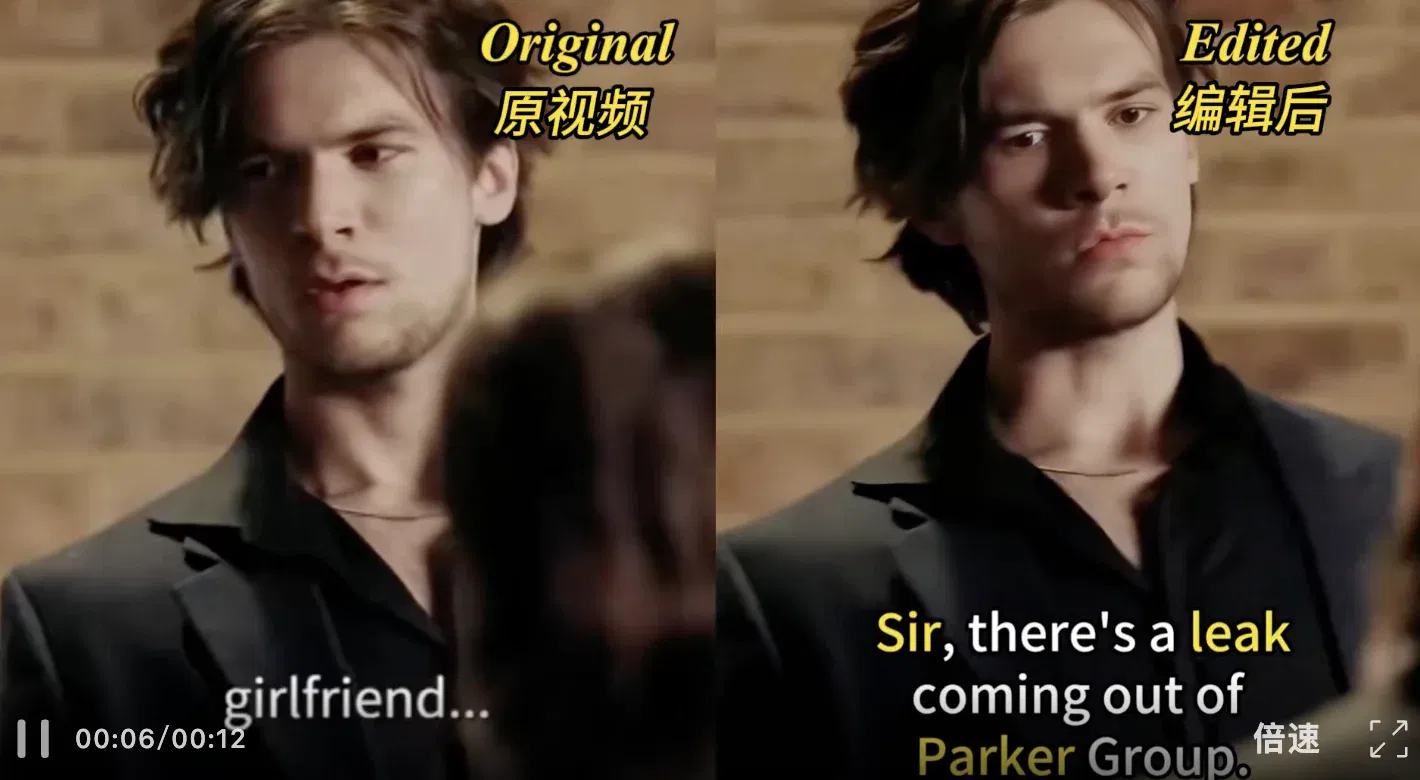
从此,内容创作、广告营销、短剧配音、有声书制作等全体语音生产工作流,都被彻底改变!
而且,ViiTor的网站上,还有多种实用功能。
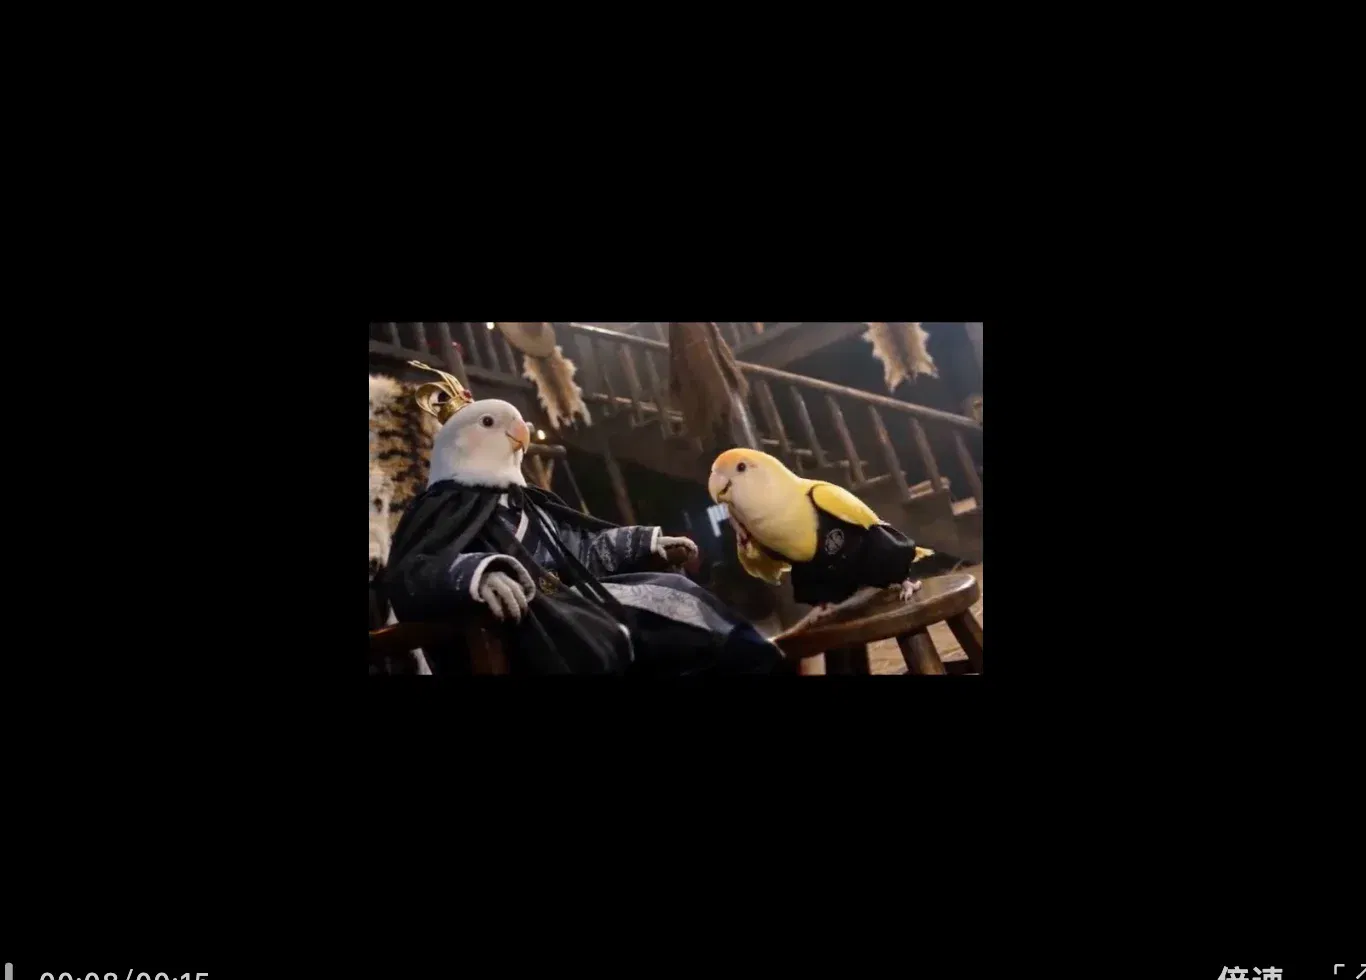
比如这个视频配音功能,让鹦鹉小弟给黑道大哥讲冷笑话,直接给它干崩溃了,语音效果自然逗趣,是网上玩梗的好素材。
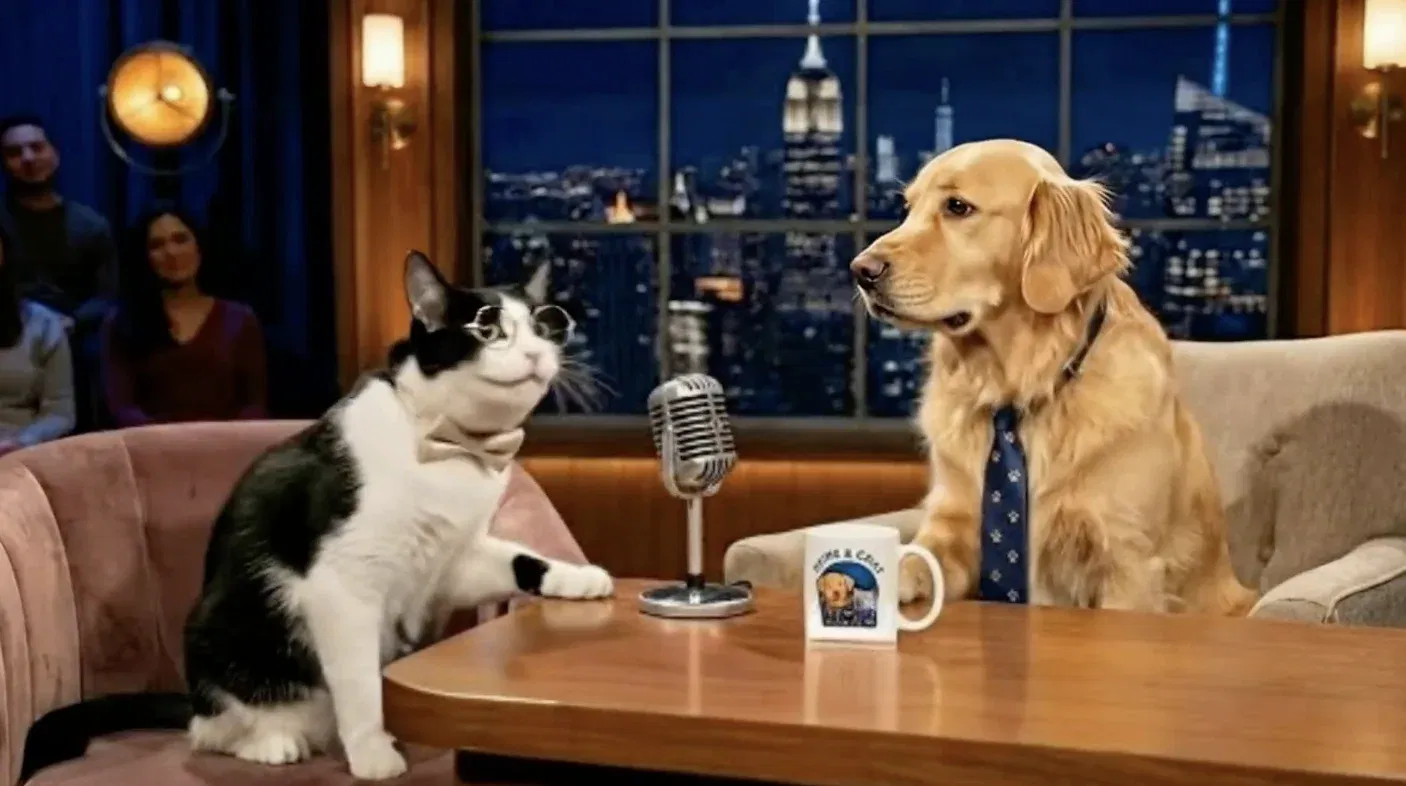
下面是一对猫狗在分享对付人类的秘诀,轻松幽默的场景,非常适合替换台词,创作宠物拟人化的搞笑视频。
权威评测领先,多语种语音达到行业先进水平
为什么ViiTorVoice会有如此惊艳的效果?成绩来说话。
就如开头所提,它的基准测试成绩单十分亮眼。
在当前业界最严苛、公认度最高的 TTS 标准评测 Seed-TTS 中,ViiTorVoice 交出了一份惊艳的成绩:英文词错率1.32,中文词错率0.99。
特别值得一提的是,ViiTorVoice 在中文词错率(WER)指标上取得当前公开评测最佳成绩,在发音准确性和语义还原能力方面达到行业领先水平,为实时语音交互、视频配音和Agent场景提供更可靠的语音基础设施。
至此,它全面超越了包括 Qwen3-TTS、CosyVoice3、Fish Audio 等在内的主流竞品。
错词率降到 1.0 以下,就意味着它极度稳定、几乎不存在幻觉。而在如此恐怖的稳定性之上,ViiTorVoice 还带来了市场上任何一家商业化产品都不具备的独门绝技。
语音编辑:哪里不对改哪里
ViiTorVoice 最具颠覆性的核心能力,就是片段级定向编辑。
正如前文所述,行业内现有的 TTS 方案,无论是开源还是闭源,基本范式都是「整段重新生成」。
但 ViiTorVoice 实现了真正的局部修改:你可以指定某一个词、某一个短语进行独立重新生成,而音频的其他所有部分——包括音色、节奏、背景底噪、前后文的情感连贯性,全部保持绝对稳定!
举个直观的例子。
在 ViiTor 官方提供的 Demo 中,一段英文演讲音频,如果你把其中的部分词句改成其他词,重新生成后,那股特有的拖音、演讲时的呼吸节奏、独特的情绪起伏,完全一模一样,只有那个单词被「无缝替换」了。
影视制作、有声书录制、短剧出海,再也不需要因为改了一句台词而重录整集。
这对于影视后期而言,尤其具有革命性意义——因为它第一次将对白调整从「重资产、长周期的补录流程」解放为「非线性时间线上的实时编辑」,让导演的创作意图得以实现。
在有声书录制中,如果录错专有名词或口误时,无需重录整章,只需定向修改那一两秒的音频即可。几十小时的有声剧,后期修音时间能从几天压缩到几十分钟,且音色与呼吸节奏始终保持一致。
对于短剧出海,这个功能就更是意义重大,它解决了多语言版本「重录成本高、周期长」的痛点,无需重新召集配音演员进棚。制作方只需在原始录音上替换特定用词,即可产出多个语言版本,每版听感都像原生表演。
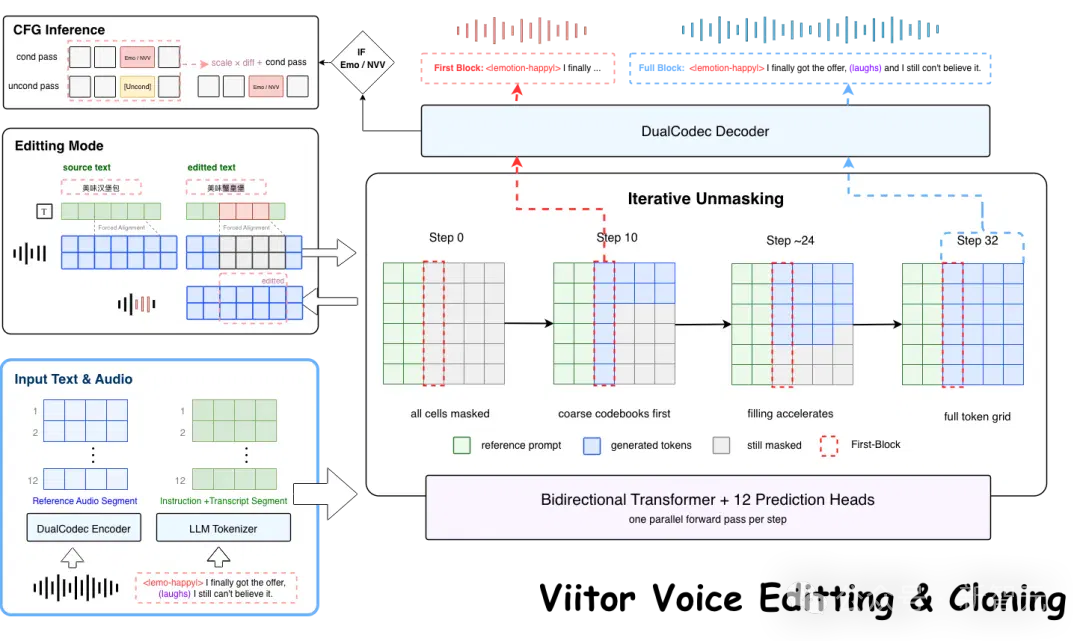
这种能力是如何实现的?这要归功于 ViiTor 团队在底层架构上做出的一种「反常识」的选择。
为什么只有它,能做到局部编辑?
当今市面上最火的语音模型(比如 CosyVoice 等),大多采用的是 AR(自回归) 架构。
自回归模型的特点是「逐帧生成」,也就是预测下一个 Token 是什么。
这种模式的好处是顺理成章,但致命弱点在于:它无法做到局部编辑。
因为当你改变中间的一个词时,由于自回归的链式反应,后续所有的 Token 都会发生改变。
此外,逐帧生成也导致了自回归模型的推理延迟偏高,且容易在长文本中出现瑕疵。
为了攻克这个壁垒,ViiTor 团队毅然选择了难度极高的 NAR(非自回归) 架构。
研发团队用了一个精妙比喻,来解释他们的技术路径——「完形填空」。
ViiTor 使用的是类似于 Masked LM的方式。
当用户需要修改音频中间的 2-3 秒时,系统不需要从头算起。它会将这需要修改的部分「挖空」,然后模型会根据这段音频前面和后面的上下文,精准填补空缺。
正因为模型能够「同时看到前后文」,它填进去的这个词,不仅音色绝对一致,连前后情绪的衔接也能做到天衣无缝。
同时,非自回归架构带来了另一个巨大的红利:极速的推理效率。
由于可以同时生成所有时间点的Token,ViiTorVoice 的首帧延迟被极大压缩。在同等体量下,其他模型的延迟往往在 150ms-200ms 左右,而 ViiTor 的端到端首帧生成时间做到了 60 毫秒以内。
结合团队在推理结构和算子层面的深度定制优化,以及一致性蒸馏(将推理步数从 32 步大幅压缩至 4 步或 8 步),使得该模型在海量高并发环境下,依然能保持极低的计算成本。
告别「AI味」:精准情绪控制
很多人在刷短视频时都有一个痛点:只要一听到那种千篇一律、缺乏生气的AI 机器音,就会立刻划走,甚至产生生理性恶心。
人类的语言之所以生动,不仅仅是因为说了什么字,更因为包含了大量的副语言信息——呼吸、气口、笑声、叹气、犹豫、甚至是微弱的哭腔。
现有的 TTS 模型大多只能解决「说什么」的问题,而 ViiTor 却着重解决了「怎么说」的问题,实现了令人惊叹的副语言感知与控制能力!
它不需要你在提示词里写上长篇大论的情感描述,而是可以通过插入特殊 Token(比如笑声、叹气),实现词级别的精准控制。
甚至同样是生气,模型未来还能区分是暴怒还是隐忍的愤怒,还能精准控制重音、弱读。
为了做到如此细腻的控制,ViiTor 引入了在图像生成领域大放异彩的 CFG 技术应用在音频推理中。
在生成特定情绪或笑声时,模型在推理时会同时走两条路径——
条件路径: 必须生成笑声。
非条件路径: 正常生成,不管笑声。
通过将这两条路径的 Logits 做差值,模型能够极大地强化笑声这个条件的权重。
实测发现,这种机制的成功率和自然度,远远高于传统模型仅靠自然语言去控制的效果。
这就是 ViiTor 在技术路线上与 ElevenLabs 等主流方案的根本差异,也是当前竞争格局下难以快速复制的核心壁垒。
无参考文本克隆:短剧出海的降维打击
除了编辑和情绪控制,ViiTorVoice 还有一项绝杀技:首个可编辑、无参考文本(Zero-Shot)的跨语种语音克隆。
传统的语音克隆,你需要提供一段说话人的音频,以及对应的准确文字内容。模型本质上是在做「续写」。
但在真实的商业场景中,这会遇到巨大的阻碍。比如短剧出海到巴西、中东,这些小语种(如葡萄牙语、阿拉伯语)的语音转文字模型准确率较低,让传统克隆直接失败。
ViiTorVoice的选择是,直接甩开了文本的拐杖!
在训练阶段,团队刻意丢弃了文本信息,逼迫模型直接从音频的声学特征中去学习说话人的发音习惯、音色和口癖。
结果就是:你只需要上传一段纯音频,模型就能自动提取音色,并用这个音色生成中、英、日、韩等多个语种的内容。
这对于当前火爆的短剧出海、游戏配音、电影解说来说,无疑是降维打击!
不少国内头部企业,已经成为这家公司的合作客户。
目前,在真实的付费生产环境中,ViiTor每天已稳定处理数十万小时音频,形成成熟的商业模式。
开源与商业化并进,拥抱开发者生态
而且非常可贵的是,面对如此强大的技术壁垒,ViiTor 团队展现出了极大的开放格局。
目前,ViiTorVoice-NAR 已经正式开源了其 1B 左右参数量的模型,开发者可以直接在 GitHub 和 Hugging Face 上获取包含 Qwen3 Forced Aligner、W2V-BERT 2.0 在内的完整本地模型组件,自由探索语音克隆、局部编辑和情感控制的无限可能。
AI 语音的发展,正在从能说话到说得像人,再到今天可以像剪辑文字一样剪辑声音。
ViiTorVoice 的出现,不仅是中国 AI 团队在技术创新上的一次重大胜利,更是内容创作工作流的一次革命。
当声音不再是一次性渲染的消耗品,而是可以被无缝编辑、注入灵魂的数字资产时,创作者的想象力,将不再受限于眼前的录音设备。
在这个 AI 日新月异的时代,ViiTor 已经替所有创作者,推开了下一个时代的大门。
文章来自于微信公众号 “新智元”,作者 “新智元”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
ElevenLabs CEO 谈上市意向,考虑 2028 年启动筹备 (opens in a new tab)
据彭博社报道,ElevenLabs CEO 表示公司考虑在 2028 年开始 IPO 筹备。报道同时称近期员工股份出售交易对应 220 亿美元估值,并介绍其企业通信和语音检测业务。
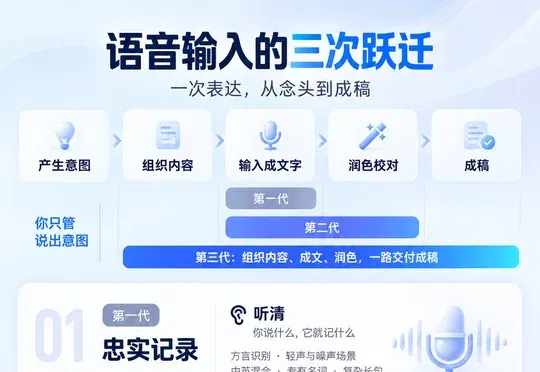
16年王者归来!手机键盘长脑子,打字进入「许愿时代」 (opens in a new tab)
讯飞输入法16.0正式发布,接入支持202种方言的讯飞星火 Spark-ASR-2.0,并推出意图成稿,可结合聊天、截图和授权记忆整理信息、生成及修改文案,推动语音输入进入从表达成稿到意图成稿的新阶段。

速递|AI语音创企公司ElevenLabs计划上市,ARR达6亿美元 (opens in a new tab)
AI语音创企公司ElevenLabs已聘请前Adyen首席财务官Ethan Tandowsky出任CFO,为2028年可能进行的IPO做准备,其ARR有望达6亿美元且已实现盈利。
快手创始人宿华押注的 Voice Cursor,语音输入又卷起来了 (opens in a new tab)
语音成为了AI交互的新方式。 手机输入法里按住麦克风说几句话,电脑听写负责把声音转成文字,遇到识别错误再自己改,类似功能存在了很多年。 大模型加入后改变了局面。 过去一年多,国内各个大厂AI语音输入法、Typeless等产品陆续获得关注,语音输入出现了另一种产品形态。 国内的变化尤其明显,豆包输入法把语音作为核心卖点,支持方言、中英混说和弱网环境; 千问今年5月在PC端加入语音输入,除了去掉语气词和纠错,还会整理口语格式,并能结合前文继续处理内容;微信输入法也持续强化语音,支持结构化输出。 原本需要说完以后再删删改改的内容,如今有机会直接变成一版可以发送的文本。 此外,该赛道的明星产品Type
语音成为AI关键入口,阿里发布 AI 语音生产力平台 CosyVoice Studio (opens in a new tab)
8 月 7 日,阿里巴巴推出国内首个 AI 语音生产力平台 CosyVoice Studio,整合开放语音识别、语音合成、实时语音交互三类核心能力,覆盖「听、创、聊」全链路。