3个爆火的开源项目,无需API Key的爬虫神器!
现在用 AI 做项目,经常会碰到这种尴尬的情况: 写代码,它喜欢乱造轮子,能用十行解决的事,非要写一大坨。
现在用 AI 做项目,经常会碰到这种尴尬的情况:
写代码,它喜欢乱造轮子,能用十行解决的事,非要写一大坨。
做页面,它能把功能搭出来,但审美一言难尽。
抓数据,它很多网页抓不全、抓不准,甚至直接没权限。
不是不会做,而是做得太糙了,完全不注意工程细节。
针对上面这些问题,我整理了三个开源项目,帮助你的 AI 更准确地实现需求。
一、少写代码
这个项目,目前在 GitHub 上已经 6.8万多 Star了,能让你的 AI 少写一半的代码。
它叫 Ponytail,是一个可以放进 Agent 里的插件。
项目图标是一个扎着马尾辫、戴着眼镜的资深程序员形象,意为此项目对修改屎山代码很有经验。
Ponytail 的思路不是事后帮你压缩代码,而是在 AI 动手之前,先给它套上一层“少写代码”的纪律。
你只是告诉 AI 代码要写短一点。
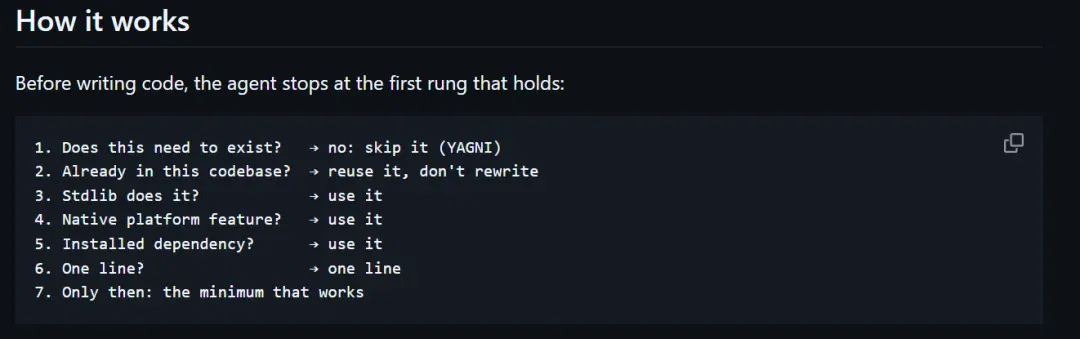
Ponytail 则是让它在动手前先作判断:
- 这个功能是不是真的需要存在;
- 项目里是不是已经有类似实现;
- 标准库能不能解决;
- 浏览器或平台原生能力能不能覆盖;
.....
实在不行,再写最小可用实现。
它不是让 AI 为了短而短,而是让 AI 先从“不写代码”开始思考。
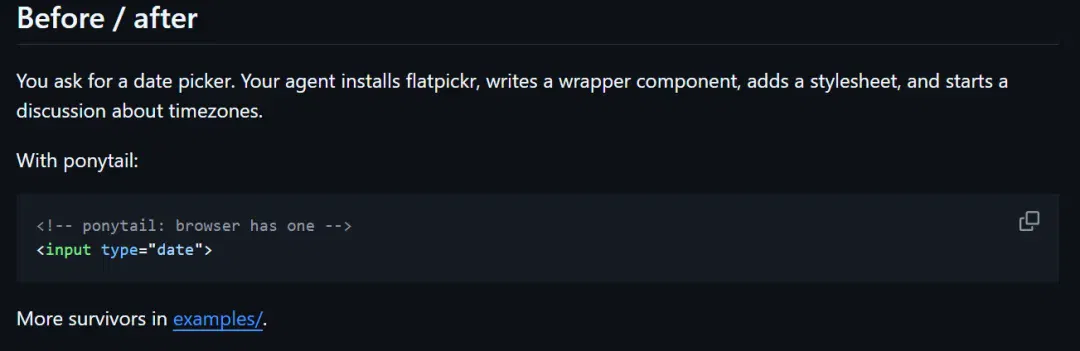
比如做一个日期选择器,能力弱一点的 Agent 可能会装库、写 wrapper、加样式、处理一堆边界情况。
Ponytail 会先问 Agent 浏览器不是已经有<input type="date">吗?
然后直接原生能力解决,决不会多写一行代码。
在 Agent 不同运行阶段,它都会自动把规则塞进去。
比如,在会话刚开始,它会通过 SessionStart 加载规则。
如果主 Agent 又启动了子 Agent,它还会通过 SubagentStart 把同一套规则继续传给子 Agent,避免子 Agent 乱造轮子的情况。
这就很舒服,因为它贯穿到整个 Agent 工作流里,不用你一直操心。
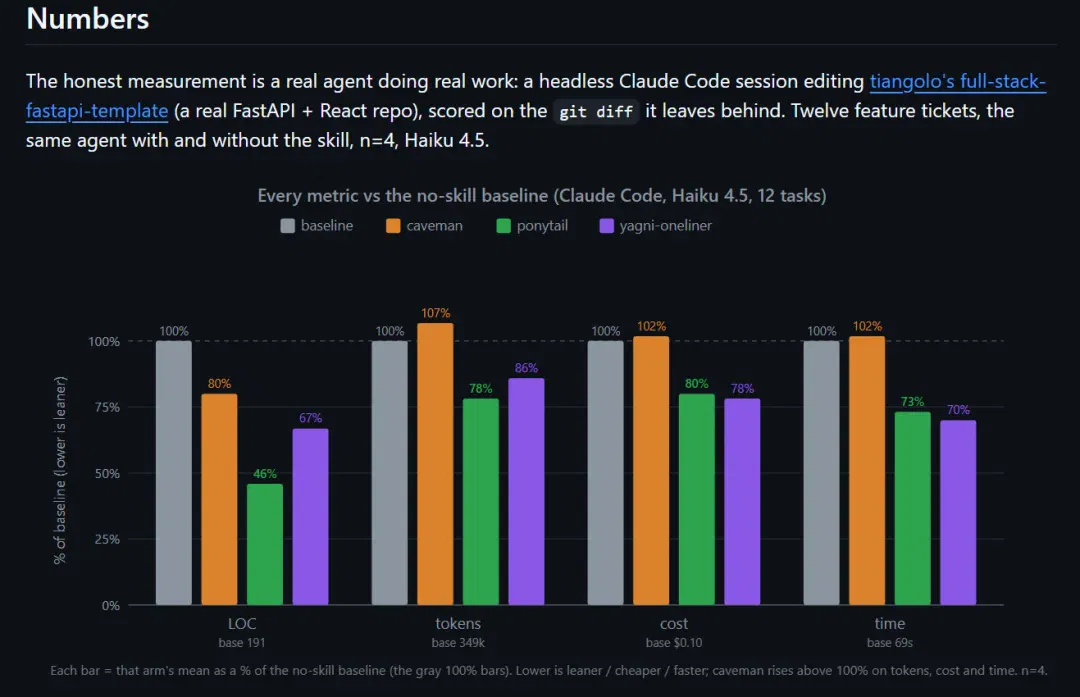
作者在一个真实的 FastAPI + React 开源项目里,用 ponytail 作了实测,模型用的是 Haiku 4.5。
在前端这种最容易过度工程化的任务里,Ponytail 的效果非常强。
- date picker,baseline 平均新增 404 行代码,Ponytail 只新增 23 行。
- color picker ,baseline 是 287 行,Ponytail 还是 23 行。
- file dropzone 任务里,baseline 是 251 行,Ponytail 降到 95 行。
当然,它也不是所有任务都能砍很多。
像后端 CRUD 这种本来就没太多水分的任务,各组差距就不大。
最后汇总下来,在 12 个真实任务里,Ponytail 相比普通 Claude Code,平均减少了 54% 的新增代码行数,token 降了 22%,成本降了 20%,耗时也少了 27%。
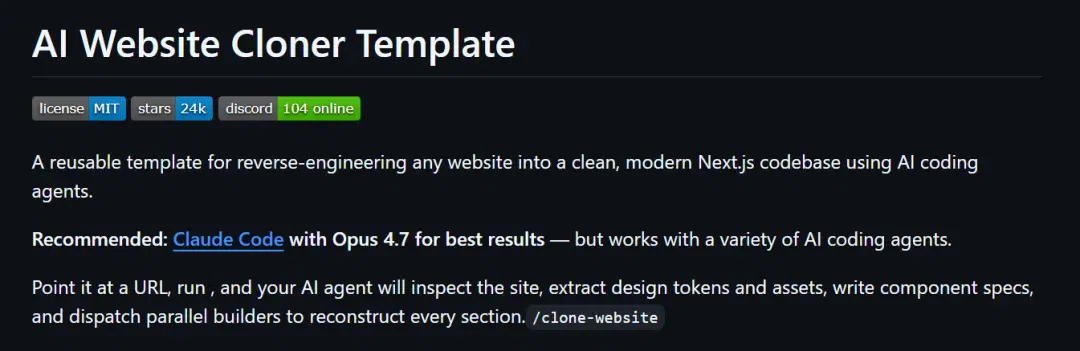
安全性方面,Ponytail 的通过率是 100%。
插件支持 Claude Code、Codex、OpenCode 等主流 AI 编程工具。
安装到 Claude Code ,只需执行下面两行命令即可安装好。
/pluginmarketplaceaddDietrichGebert/ponytail/plugininstallponytail@ponytail
另外插件还提供了几个模式,lite 轻量、full 完整、ultra 激进,不想用了直接 off 关掉。
项目链接:
https://github.com/DietrichGebert/ponytail
二、克隆网页
这个项目只需要一行命令,就可以1:1复刻网页。
普通 AI 克隆网页,很多时候只是看截图,然后凭感觉猜颜色、字体、间距和布局。所以做出来的页面远看像,近看全是问题。
而这个项目是一个网页逆向工程系统,会把浏览器里的每个细节都尽量转化成可复现的前端代码。
它的工作流是这样的:
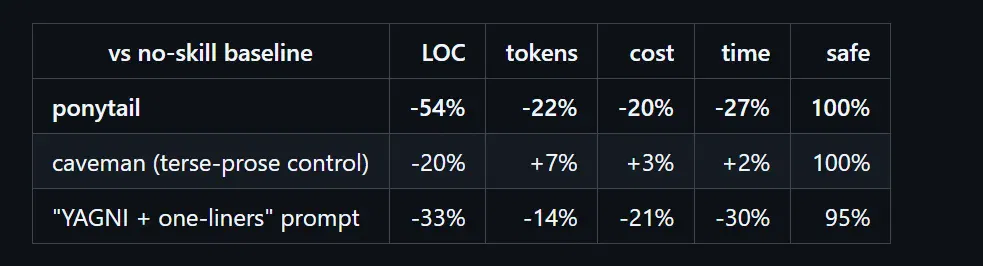
首先,它会先让 AI 通过浏览器真正打开目标网站,对页面做一轮全域采集,通过getComputedStyle()直接读取浏览器里的真实计算值。
比如网页里具体的颜色的数值是多少,字体是什么,间距、圆角、阴影具体参数是什么。
拿到这些设计 Token 之后,AI 才会开始先搭底座,全局 CSS、Tailwind 配置、静态资源都会先对齐原站。
接下来,它会把整个页面拆成一个个组件。
每个组件都会先生成一份规格书,写清楚这个区块的结构、响应式变化和交互状态。
之后,它再让多个 builder agent 并行施工。每个 Agent 负责一个组件,并且放在独立的 git worktree 里开发。
这样导航栏、Hero 区、页脚可以同时做,互不干扰。
最后,AI 把这些组件合并回主项目,拼成完整页面。
下面是作者给到的实测视频:
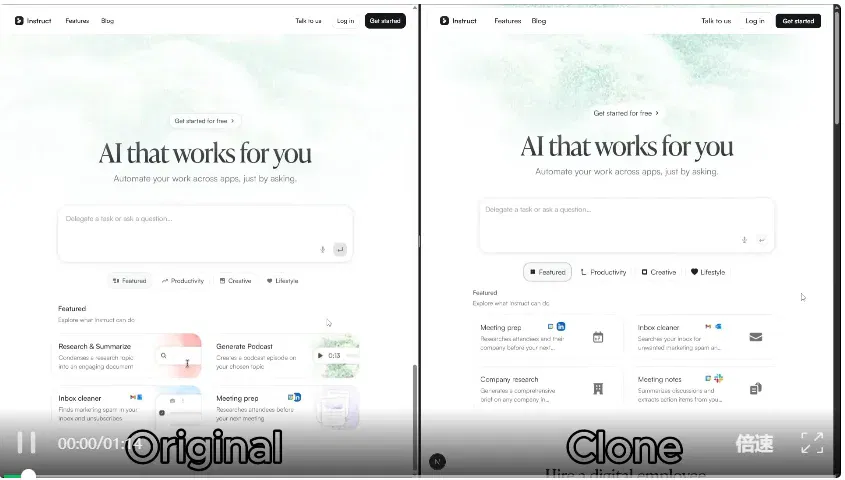
这比让一个 AI 从头到尾写完整页面稳定很多。
因为前端页面本来就是模块化的,拆成区块以后,Agent 更容易对齐原站,也更容易做视觉校正。
当然,这个项目更适合用在你自己的网站迁移、学习优秀页面结构这些场景。
不适合拿来直接搬别人的商业网站上线。
安装方面,这个项目官方不建议直接 clone 原仓库,而是先在 GitHub 页面点击Use this template,创建一份属于你自己的项目。
然后把你自己的仓库 clone 到本地:
gitclonehttps://github.com/YOUR-USERNAME/YOUR-NEW-REPOSITORY.gitcdYOUR-NEW-REPOSITORY
接着启动 Claude Code,输入:
/clone-website<目标网站URL>
接下来,AI 就会打开目标网页,采集页面结构、提取设计 Token 和资源,然后开始重建这个网站。
项目要求 Node.js 24+,官方推荐 Claude Code,但 Codex CLI、Cursor、Windsurf、Gemini CLI 等 AI 编程工具也支持。
项目链接:
https://github.com/JCodesMore/ai-website-cloner-template
三、免费爬可靠数据
这个项目能把任何网页,变成 AI 能直接读取的结构化数据。
你给它一个 URL,它可以输出:
- 干净的 Markdown,去掉导航栏、广告、页脚这些杂乱内容;
- 结构化 JSON,你定义字段,它按 schema 提取;
- 也可以返回截图、HTML 和网页元数据。
不只是抓单页,它还能爬整个网站、解析本地文件、做 arXiv 论文搜索、搜索 GitHub 仓库信息。
而且,Firecrawl 主推无 Key 模式,不用配环境、申请密钥,直接就能用。
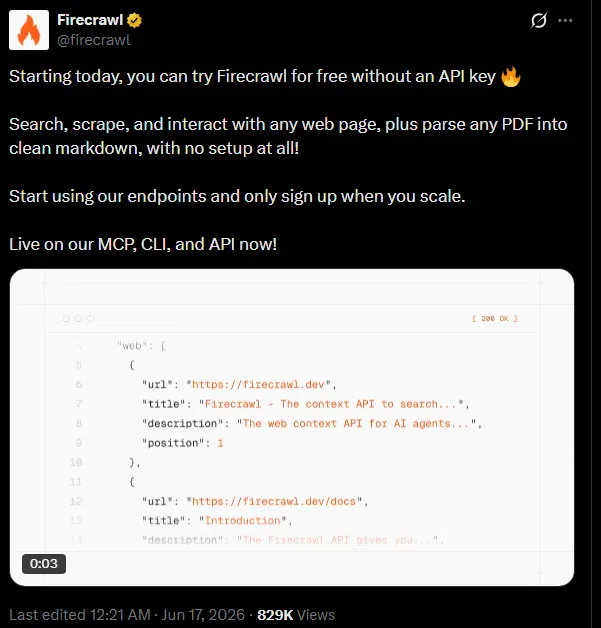
Firecrawl 的能力有三层:
- 你可以给它一个 URL,抓单页;也可以给它一个网站入口,爬整站;如果不知道具体页面在哪,还可以先用
map把站内 URL 列出来。 - 然后,它会处理网页抓取、JS 渲染、点击、滚动、等待这些动作,再把网页里的正文、图片、链接和元数据提取出来,转成 AI 更容易读取的 Markdown、JSON、HTML 或截图。
- 而且,你不一定要提前准备好 URL,只要描述需求,Firecrawl Agent 就能自己搜索、打开网页、导航、抓取,并把结果和来源返回。
以前 Agent 读网页,要自己处理搜索和解析。
现在 Firecrawl 先把这些脏活做掉,最后交给 AI 的就是干净的数据。
这个项目已经不是一个小众工具了。
它是 GitHub 全站 Top 100 级别的开源仓库,目前已经有 130K+ Star。
官方数据显示,有 15 万多家公司在用 Firecrawl,其中包括 Apple、Canva、Lovable、Stanford、Zapier、Replit 这些团队。
安装 Firecrawl 只需一行命令:
npx-yfirecrawl-cli@latestinit--all--browser
它支持 Claude Code、OpenCode、Cursor、Windsurf、Codex CLI、Gemini CLI、Antigravity。
项目链接:
https://github.com/firecrawl
少写没必要的代码,做出更准的页面,拿到更干净的数据,AI 做项目的可用性就会高很多。
这期就先分享这三个项目,都是我觉得真正能改善 AI 工作流的开源项目。
文章来自于"JackCui",作者 "JackCui"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
本周 AI 项目推荐| Hypit、Synvas、Pexo...AI 视频赛道还有新玩家 (opens in a new tab)
AI 视频创作,又一批新面孔登场了。 此前,OiiOii、TapNow、LibTV 等产品已开始探索不同的创作方式。其中,OiiOii 把编剧、角色设计、分镜和配乐交给分工协作的 Agent,TapNow 让创作者在画布上组织素材、调用模型和编辑视频。 现在,热度还在延续,新的焦点是:剪辑和修改。一批新的产品集中出现。 Synvas 想把生成画布和专业剪辑时间线放进同一个工作台,Hypit 为 Agent 发明了视频语言,Voyager 则直接让 Agent 操作创作者已经在用的软件。视频创作的入口越来越多,连人该坐在时间线前、对话框里,还是专业软件中指挥 AI,都有不同答案。 这些尝试背后,
本周 AI 项目推荐:Citely、ACE、VIRSE、BuilderHub上新啦! (opens in a new tab)
BuilderHub本周推荐6个AI项目,包括VIRSE、Stances、ACE、橡果Oaky、Citely和CCX,涵盖AI设计基础设施、语言学习与决策研究、AI音乐平台、个人内容系统、合规决策工具及多模型API网关等方向。
本周AI项目推荐|智能知识、Copula Lab、UniPat…谁在给中国模型造后训练数据与考场? (opens in a new tab)
随着Agent走向真实工作,后训练和数据正在成为提升智能的关键。
本周AI项目推荐|Amagine、FrameX、Blinkko ...让AI进入“现实”的各种方法 (opens in a new tab)
这些项目未必都是最成熟的,但它们有一个共同点:没有把模型本身当作产品,而是把 AI 放进一条具体的任务链里,让一个想法变成物品,让一个需求得到回应,或者让一套智能系统真正运转起来。
本周 AI 项目推荐:Link、Agentic Wallets、Token Pay......Token支付底座长啥样 (opens in a new tab)
什么是AI原生支付?随着全世界个体token的消耗量猛增,越来越多的大玩家和初创公司开始瞄准AI支付机制和基础设施的问题。