OceanBase湖库一体,重新定义AI数据库
AI时代苟日新,日日新,又日新,数据库也是如此。
AI时代苟日新,日日新,又日新,数据库也是如此。
主流数据库的发展经历了几次重要演进:从最早的OLTP数据库,到OLAP从其中分离出来成为数据仓库,再到大数据系统。长期以来,数据库架构主要围绕人类应用、确定性交易和结构化数据分析设计。
今天,新的变化正在发生。
AI Agent不再只是读取数据、回答问题,而是开始调用工具、生成代码、执行任务、修改状态,甚至参与业务流程。数据库的使用者,正在从人类应用扩展到大量自主运行的Agent。
这带来一个根本问题:当成千上万个Agent同时读写、搜索、试错、回滚和生成上下文,数据库还应该是过去的样子吗?
我认为,答案是否定的。
首先AI正在同时改变三件事:
- 数据库的使用者,从应用扩展到Agent;
- 数据库管理的数据,从结构化数据扩展到涵盖结构化、半结构化与非结构化的多模态数据;
- 数据库承载的工作负载,从事务和分析扩展到搜索、上下文工程与AI应用。
因此,AI数据库不是传统数据库增加几个AI函数,也不是向量数据库补上SQL能力。它要解决的是AI进入生产系统后的数据基础设施问题。
多模态数据需要在统一底座上被管理,在线服务和离线计算需要融合,Agent需要获得实时、可信、连续的上下文,读写、试错、回滚和治理中保持数据库级一致性与可靠性。
这不是一次功能增强,而是在AI时代重新定义数据库的技术架构。
AI时代,数据库走向一体化
我们先看行业发生了什么。
Databricks和Snowflake从湖仓和数仓系统出发,不断补充OLTP的事务能力;OceanBase和Oracle从交易库出发,持续提升OLAP和大数据能力;MongoDB、Milvus、Elasticsearch从专用库出发,连续增强通用数据库的能力。
不管出发点如何,不同路线都正在向一个能够同时处理交易、分析、搜索、向量以及AI计算的统一数据底座演进。
其中OceanBase一直坚持走一体化设计思路。
最早我们开始做分布式OLTP,解决了在线交易的扩展性和可靠性。后来我们又在OLTP基础上加入了实时OLAP支持,消除了TP到AP的数据搬运。去年,我们发布了多模一体化,把向量、全文、JSON、GIS等能力带进同一个数据库引擎。
直到今天,我们正式发布OceanBase湖库一体的AI数据库,是沿着这条路继续往前走:把库里的实时事务能力、湖上的开放存储和开放计算能力,放到同一个数据底座里。
什么是湖库一体
我理解的湖库一体(OceanBase Lakebase),不单单停留在数据库外接一个数据湖,也不能只是给湖仓补几个在线查询接口。要让它进入生产系统,至少要合并三条边界:
第一,数据形态要统一。结构化数据、半结构化数据、非结构化数据、向量、图、全文索引,不能分散在不同系统里各管一份。它们应该在同一套表语义下被管理。
第二,计算路径要统一。SQL查询、实时分析、混合搜索、Spark ETL、Ray上的AI计算,应该围绕同一份数据工作,而不是靠不断导出、转换、中间落盘来协作。
第三,治理边界要统一。元数据、权限、行级控制、审计、版本、生命周期,必须对所有数据类型一致生效。否则结构化字段有权限控制,向量检索却绕过了权限,这样的系统进不了企业生产。
这也是OceanBase Lakebase的设计出发点:
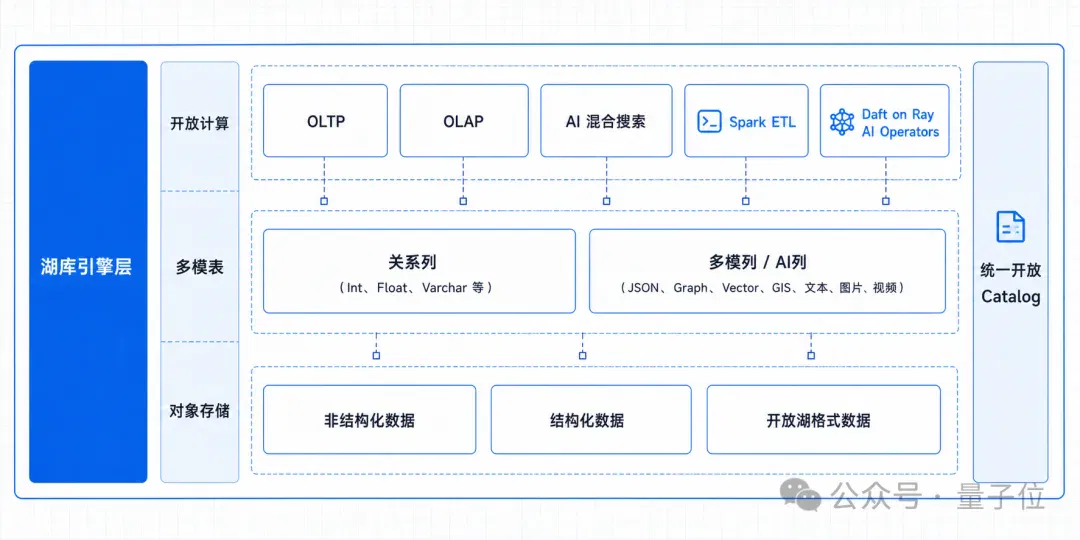
底层使用存算分离的设计架构。数据存在对象存储上,计算层独立运行。AI Agent的工作负载本质上是突发式的——每一个Agent都可能在任何一天流量激增,每一天都可能有一个小型的双十一。存算分离让计算层能够独立伸缩,负载上来瞬间扩容,空闲时缩到零。
中间用多模表统一结构化、半结构化、非结构化数据以及多模态数据。
上层支持开放计算。除了原有的SQL计算(OLTP、OLAP、AI搜索),也支持Spark处理ETL、Daft on Ray处理AI加工。把这些计算引擎统一在同一份数据之上,是湖库一体区别于传统数据库的核心设计目标。
湖的价值在开放、弹性和成本。库的价值在事务、一致性、低延迟和治理。AI时代需要把这两组能力合在一起。
此外还有一个关键价值容易被忽视——实时性。
传统做法里,数据加工是离线的,加工完的结果还要搬回在线系统才能服务应用,中间有T+1甚至更长的延迟。
湖库一体直接把离线加工和在线服务统一在同一份数据上:Spark ETL的产出,SQL引擎立即可查;模型推理生成的向量,混合搜索立即可用。不再有“加工完了还要等同步”的窗口期。
这里实时性不是靠加速搬运实现的,而是靠消除搬运实现的。
多模表:AI数据库的核心数据结构
OceanBase的第二个关键点在多模表。
原来的关系数据库,底层是一张关系表——里面有Int、Float、Varchar,所有列都是结构化数据。
今天的AI数据库,底层应该是一张多模表。
多模表既包括原有结构化数据的关系列,也包括非结构化数据的多模列与AI列。非结构化数据,可以在外部Embedding或者打标之后以向量或者文本的方式写入到多模表,也可以直接以LOB的形式写入到多模表。
OceanBase支持非常灵活的LOB存储:
- 如果LOB对象比较小,直接在行内存储,节省IO;
- 如果LOB对象比较大,切片后存入对象存储,行内只保留每个切片的位置信息;
- 如果LOB对象特别大,支持引用外部对象存储中的已有文件,数据库只存储元数据。上层应用看到的仍然是一张表。
在多模表之上,我们还设计了AI列。它可以理解成表上的实时计算列:数据写入后,自动触发Embedding、打标等模型计算,并把结果写回表里。这里最重要的是事务一致性语义。比如一批音频写入后,要么全部完成Embedding和打标,要么全部失败,不能出现部分成功、部分失败的情况。
混合搜索:搜索作为AI数据库的一类负载
有了多模表,接下来是在其上执行AI工作负载。AI数据库里面,查询的基本模式从关系查找进化为混合搜索——在同一张表里完成关系过滤、全文搜索、向量搜索、图搜索以及AI计算。
为什么单纯的向量搜索不够?
向量搜索在AI数据库里是最常见的一种计算方式,但在实际场景里,我们往往首先需要通过关系过滤将全局数据缩小为一个更小的候选集(例如“只看最近30天的订单”),再在候选集上做向量、全文、图的混合搜索。
数据库先缩小范围,模型只处理高价值候选,这样推理成本更低、结果更准、链路更可控。
我们判断,在AI时代,搜索会与OLTP、OLAP一样回归数据库本体,成为数据库的一类负载。
性能上,我们也做了系统的评测验证。
结果显示,使用HNSW算法,在768维和1536维的测试场景下,同等召回率条件下OceanBase的向量搜索性能远领先于Milvus、Elasticsearch和pgvector。
在混合搜索维度,使用MS MARCO数据集评测,OceanBase混合搜索的性能相比Elasticsearch提升30%以上。
开放计算与统一Catalog
Agent的数据链路不止是SQL查询——还有ETL加工、AI推理、多模态理解。
原先的做法,往往是采用多个不同的系统,比如Kafka做接入,Flink做流处理,Spark做批处理,HDFS做持久化,ClickHouse做分析,HBase做宽表,Elasticsearch做搜索,Presto做联邦查询。
OceanBase湖库一体设计解决的就是这个问题。
底层通过基于对象存储的多模表,实现多套计算引擎之间的数据共享,即一份数据同时服务所有计算引擎。OceanBase的SQL引擎处理在线查询和事务;Spark处理PB级批量ETL;Daft on Ray处理AI推理,从而解决多套系统之间的数据一致性以及计算延迟的问题。
为了同时支持这么多开放计算引擎,我们需要一个统一开放的Catalog来管理数据。表、视图、Schema、Lineage、行级权限、列级授权,都应该在这里统一管理。
OceanBase AI数据库的所有操作在进入系统之前,都需要经过统一元数据与权限控制面做一层过滤,避免数据越权访问。目前我们已支持了最细粒度的行级权限控制(RLS)。
为Agent设计:版本控制与弹性规模
为了让Agent真正进入生产系统,数据库还必须给它一个可隔离、可回滚、成本足够低的操作环境。
通过Fork Database,可以秒级创建一个完整的数据库副本,就像在GitHub里拉一个分支。即使PB级数据库也能在秒内完成fork,且只占增量空间(Copy-on-Write,未修改的数据块指向湖上同一份存储,不产生物理拷贝)。
拉完分支之后,可以在分支上做各种AI的开发、测试和实验。实验成功就提交,实验失败直接回滚,基本上没有代价。
配合DIFF和MERGE,Agent就获得完整的数据版本控制能力——Fork建分支,DIFF看差异(精确到行和值),MERGE按策略合回。这不是类比Git,而是SQL级的原生实现。
另一个维度是规模。AI的Agent数据量将会是海量的,未来可能有千亿级甚至万亿级Agent在并行运行,每一个Agent都有自己的Schema、自己的表,这会导致Schema爆炸的问题。
传统数据库为“少库+海量数据”优化,一个集群承载几十个库、每个库数十亿行。Agent场景则完全相反:千万个Agent,每个只有几百行,但实例数量是天文级的。
OceanBase的逻辑表设计,是让每一个Agent看到的是一张张独立的逻辑表,但存储在底层是同一张物理表格,通过逻辑层抽象解决Schema爆炸。
Fork Database解决独立环境,逻辑表解决实例规模。两者协同才能让单个Agent安全试错、海量Agent低成本并行运行。
上下文层:让AI理解企业与用户
光有引擎还不够。AI数据库的引擎和应用之间还缺一层——上下文。
上下文层分为两个部分。数据上下文,围绕数据的语义和数据的治理展开,让AI理解企业。应用上下文,围绕Memory和RAG展开,让AI理解用户。
在记忆维度,Agent 的记忆不能简单地堆上下文,而是一个可进化的结构化资产。为此我们研发了PowerMem,以及基于PowerMem的云上产品seekdb M0。
PowerMem构建在AI数据库之上,记忆的检索本身就是一次结构化过滤+语义相似度的混合查询。更关键的是它支持记忆的自进化,包括经验的自进化以及技能的自进化。
我们在同一轨迹、同一模型下使用AppWorld公平蒸馏实验做了验证,唯一变量是蒸馏和检索方案。结果表明,seekdb M0方案的通过率达到39%,Hermes只有22%;完成相同任务时,M0的步骤是6.2步,Hermes是10.4步;整体Token消耗降低32%。
在语义维度,高质量的数据语义让AI应用真正能够理解企业。OceanBase OSI要解决的不是再造一套BI语义,而是把指标、口径、原始数据、上下文图谱、本体层统一起来。
- 最底层是语义层,包括指标、口径、原始数据等,基于Ant-OSI语义层标准设计,兼容OSI开放标准,并在蚂蚁集团得到了大量实践验证。
- 中间层是上下文图谱,大模型基于上下文图谱推理,提升准确率。
- 最上层是本体层,统一业务语义与底层数据库语义,做到全局语义与局部语义的平衡。核心理念是”语义即代码”,做到数据语义一次定义,BI渲染报表、Agent生成SQL、治理工具做血缘分析,读的是同一份定义。
我们基于OceanBase OSI也开发了OceanBase DataPilot产品。在不同行业的客户POC测试中,客户反馈准确率远好于业界其他产品。
这背后不是模型的差异,而是语义上下文的质量差异——当AI拥有准确的业务口径定义,从自然语言到SQL的翻译准确率会本质性地提升。
一套技术栈降低工程复杂度
所有这些能力加在一起意味着什么?最直接的答案是:组件数量的大幅减少。
如果采用传统方案,企业需要5到10个系统来融合处理多模态数据,且多个系统缝合带来一系列问题,包括:CDC延迟、ETL失败重试、多套独立运维、多套权限体系、多套监控告警,等等。
通过OceanBase湖库一体引擎,能够实现多合一,通过一份数据保证一致性,通过离在线融合保证实时性。
小结:湖库一体的AI数据库
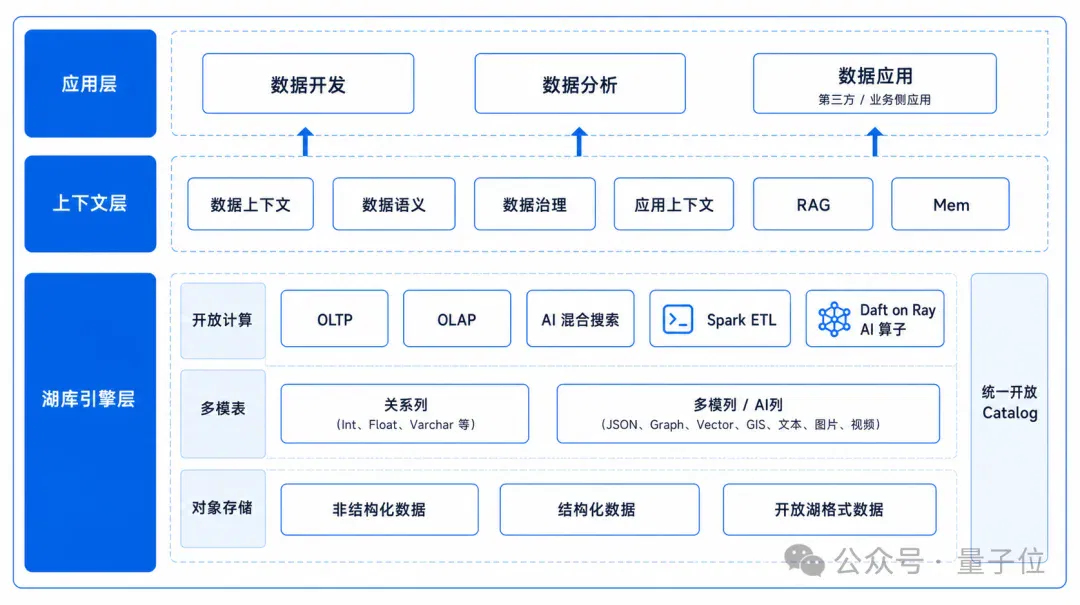
如果把这些能力放在一起看,OceanBase AI数据库的架构可以概括为三层。
最底层是湖库引擎——多模表运行在对象存储之上。通过多模表和对象存储,支持各种开放计算:OceanBase的SQL计算(OLTP、OLAP、搜索)以及Spark ETL和大模型AI计算。
中间是上下文层——数据上下文让AI理解企业,应用上下文让AI理解用户。
最上层是我们开发的应用Agent——面向数据开发工程师的数据开发Agent,和面向业务分析师的数据分析Agent。
根据我们多年的Know-how经验,要让企业真的把AI用起来,最重要、最基本的一步,是通过一个一体化的AI数据库,让企业把自己的数据管理起来。只有管理好自己的数据,才能让企业的AI更准、更省、更快、更安全。
湖库一体的AI数据库,这就是我们面向AI Agent时代给出的答案。
文章来自于"量子位",作者 "OceanBase CTO 杨传辉"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
深度|3000万个闪应用背后,OceanBase讲了一个中国版Databricks的故事 (opens in a new tab)
在蚂蚁灵光上,用户说一句话,30秒就能「手搓」出一个闪应用:一个记账本,一个报名页面,一个打卡工具。上线四个月,这样的应用已经积累了3000万个。
三行代码就能手搓一个AI应用!蚂蚁OceanBase开源其首款AI数据库 (opens in a new tab)
AI时代,真是啥都要快。 三行代码构建一个AI应用,现在就这样被蚂蚁OceanBase游刃有余地实现了。 熟悉数据库的朋友都知道,OceanBase是蚂蚁集团于2010年发布的一款全自研的国产企业级分布式关系数据库。 历经15年迭代升级,如今它不仅在权威测评中稳居国产数据库第一梯队,其稳定性更是经过了“双十一”等高并发场景的持续验证。 悄悄补充一句,OceanBase还在现场秀出了最新成绩单——全球客户数已突破4000家,连续五年年均增速超100%,服务覆盖16个国家和地区、60多个地域、240多个可用区。 而且截至今年5月,经过四年开源实践,OceanBase已形成拥有超过25000名开发者
Vector Lakebase对比Lakebase以及向量数据库,如何选型? (opens in a new tab)
这篇文章想回答几个大家更关心的基础问题:Vector Lakebase 能解决你的什么问题,什么场景下用它最合适,如何用好Vector Lakebase 。
万字深度|做了8年向量数据库后,我们决定为Milvus重构AI时代的存储引擎 (opens in a new tab)
过去八九年,我们一直在做一件事:把向量数据库从一个很小众的系统方向,做成 AI 基础设施里的关键组件。
GUI都流行四十年了!数据库操作怎么还和DOS一样难搞? (opens in a new tab)
今天在讲Milvus的Attu之前,我们先来唠一段计算机行业的八卦。