本周 AI 项目推荐:UXBench、MemLens、RoadmapBench…下一代模型,需要下一代 Benchmark
我们最近在重新思考一件事:到底什么样的 Benchmark,才值得今天继续做?
我们最近在重新思考一件事:到底什么样的 Benchmark,才值得今天继续做?
过去几年,大模型的发展几乎一直被 Benchmark 牵引。GLUE/SuperGLUE 推动了 NLP 预训练,MMLU 让“通用知识能力”变成可比较的分数,HumanEval 把代码生成推向主流,SWE-bench 又把 coding agent 从写函数推到了解决真实 GitHub issue。
Benchmark 从来不只是排行榜。它更像一套问题建模方式:告诉大家,模型现在缺什么能力,缺口在哪里,接下来训练数据应该往哪里造。
因此,当下最重要的,不是继续找一个所有模型都能刷到 90 分的榜单,而是找到适合自己业务、自己产品、自己组织的 Benchmark,并围绕它做定向评估和训练数据构建。
这期我们筛了几个 2026 年很值得关注的新 Benchmark。
它们共同指向一个变化:下一代 Benchmark,不再奖励“会答题的模型”,而是奖励“能在真实世界里稳定做事的系统”。
用户体验|UXBench
Benchmarking User Experience in AI Assistants
一句话介绍:腾讯混元和元宝团队提出的用户体验 Benchmark,用真实 AI 助手交互日志,评估模型是否理解用户反馈、偏好和失败恢复。
概述
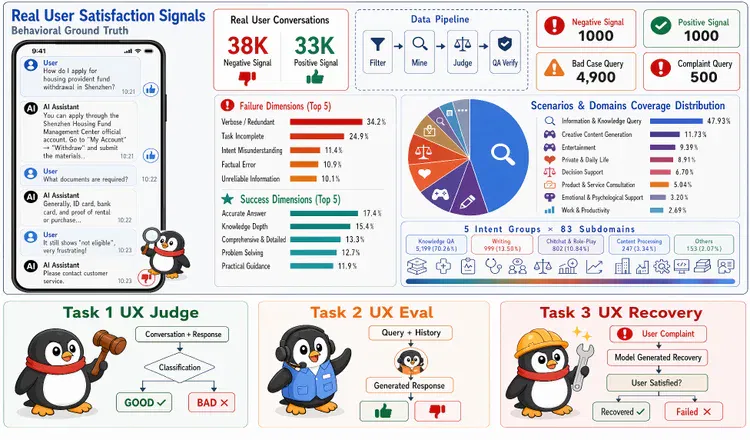
UXBench 评估的是 AI 助手能不能“让用户觉得好用”。它包含 UX Judge(预测用户反馈)、UX Eval(生成满意回复)、UX Recovery(失败恢复) 三类任务,数据来自 70K+ 真实中文 AI 助手交互日志,最终形成 7400 个测试样本,覆盖 8 个场景、83 个领域。
它关心的问题非常产品化:用户为什么不满意?这轮回复哪里让体验变差?模型能不能识别失败,并在下一轮把体验救回来?
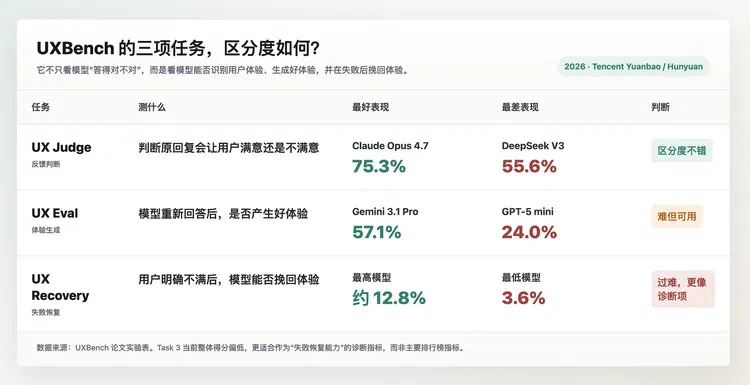
测试结果中,海外御三家的得分普遍较高,而Hunyuan3在三项任务中表现均为中等,分别是64.3%、48.8%、7.6%。
团队
香港理工大学、腾讯元宝团队。论文作者包括 Mengze Hong、Xia Zeng、Zeyang Lei、Sheng Wang 等。2026 年 6 月 8 日提交,6 月 9 日更新。
为什么值得关注
过去模型评测通常问:答案对不对、推理强不强、代码能不能跑。但真实 AI 助手里,用户是否满意经常取决于更细的东西:是否啰嗦、能否“稳稳地”接住用户情绪、是否理解隐含需求、失败后能不能补救。
UXBench 的价值在于,它把“用户体验”变成了可以训练、可以评估、可以迭代的能力。这类 Benchmark 未来会直接影响助手类产品的 reward model 和 post-training 数据构建。
它的好处是,不依赖大量人工逐条标注,而是通过自动化 pipeline 从“一款主流中文 AI 助手”的真实用户交互中持续生产测试样本。
这也决定了 UXBench 更像是一个由产品自身长出来的定制化 benchmark:它非常适合服务腾讯元宝这类中文 AI 助手的体验优化,但如果直接迁移到其他 AI 助手,用户群、产品形态、交互风格和反馈习惯都可能存在偏差。
为自家产品定义benchmark,从而服务于自家模型和产品的迭代,是一个关键的路径。
记忆|MemLens
Benchmarking Multimodal Long-Term Memory in Large Vision-Language Models
一句话介绍:MemLens 是一个多模态长期记忆 Benchmark,专门测试模型能否在多轮、多会话轮次、图文混合对话里真正记住并更新信息。
概述
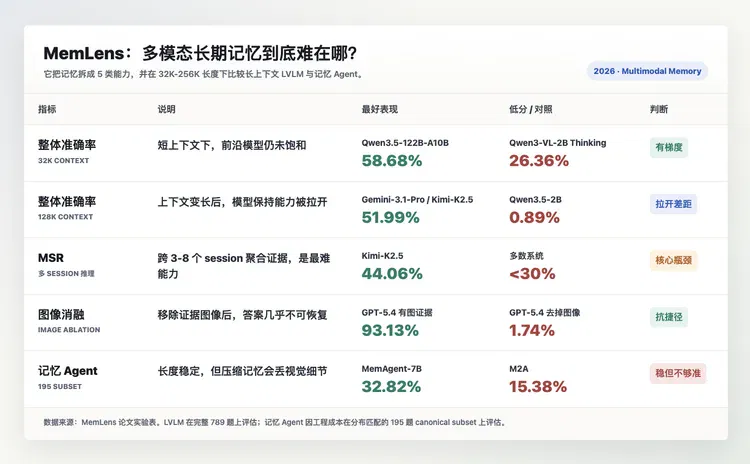
面向“多轮、跨会话、多模态对话”的记忆评测集,共 789 道题,覆盖五种记忆能力——信息抽取、跨会话推理、时间推理、知识更新、拒答(在没有证据时主动说“不知道”)——并在 32K、64K、128K、256K 四档上下文长度下测试,用统一的跨模态 token 计数把文字和图片放在同一把尺子上比较。
团队评测了 27 个视觉语言大模型和 7 个记忆增强 Agent。
亮点在于:其一,做了图像消融实验,移除证据图像后,两个前沿 LVLM 在 80.4% 的问题上准确率跌到 2% 以下,证明确实需要视觉证据;其二,发现了长上下文 LVLM 短程准确率高,但随对话增长退化;而记忆 Agent 长度稳定但存储压缩丢失视觉保真度,这也是当下的一个结构性 trade-off。
团队
香港科技大学宋阳秋教授团队,联合香港中文大学、英伟达、丘脑智能,第一作者任玺谕(Xiyu Ren),数据集与评测代码均已开源,论文:https://arxiv.org/abs/2605.14906;代码:https://github.com/xrenaf/MEMLENS
为什么值得关注
MemLens 填补了多模态长期记忆的系统评估空白。
它的核心贡献是第一次把“长记忆”的两条技术路线——长上下文 LVLM、记忆增强 Agent,放在真正需要图像证据的问题上做对比,结论是两条路单独都走不通、必须走混合架构。
其中,记忆 Agent 的通病是“存储即压缩”:把图片压成一句描述或一串向量再存,登机牌的日期、票据的金额这类细节,在写入那一刻就丢了。所以同一个基座模型直接推理能到 49%,包进记忆系统后反而掉到 15%——它要回答时,关键信息根本没被存进去。
而长上下文的多模态模型则相反,短对话里靠直接“看原图”准确率很高,但对话一长就开始衰减。
MemLens 把“记得住、找得到、不乱说”变成了可以分别诊断、分别优化的工程指标,给所有想把多模态记忆做进产品的团队,划出了一张清楚的能力缺口图。
长周期Coding|RoadmapBench
Evaluating Long-Horizon Agentic Software Development Across Version Upgrades
一句话介绍:软件工程评测终于从“修 bug”走向“做版本升级”,RoadmapBench 用真实开源项目的版本升级任务,评估 coding agent 能否完成长周期、多目标的软件开发。
概述
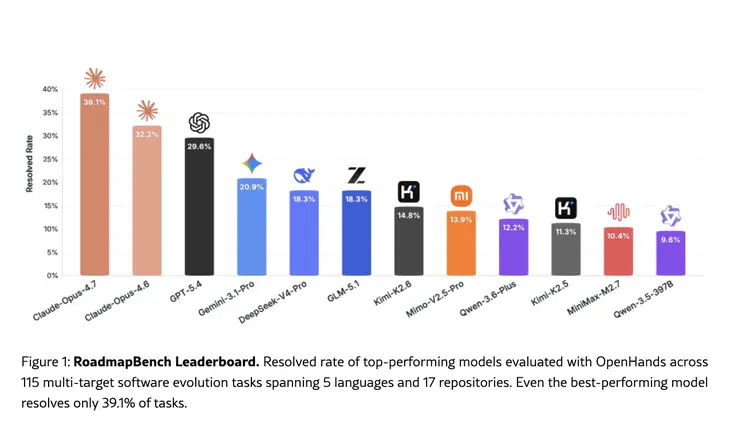
RoadmapBench 包含 115 个长周期 coding 任务,来自 17 个真实开源仓库、5 种编程语言。每个任务给 agent 一个旧版本代码快照,再给出目标版本 roadmap,让它实现目标版本新增的功能。
难度很高:每个任务中位数需要修改 3700 行代码、跨 51 个文件。最强模型 Claude Opus 4.7 也只解决了 39.1% 的任务,弱模型只有 5.2%——而这些模型在 SWE-bench Verified 上普遍能拿到 80% 以上。
团队
这项工作由 AI 创业公司 UniPat AI 牵头,联合北京大学完成,并有复旦大学、香港大学、清华大学、0G Labs、Pipeline Lab 的研究者参与,2026 年 5 月 15 日提交,5 月 19 日更新。
为什么值得关注
SWE-bench 已经很重要,但它主要还是 issue 级别的修 bug,而且高度集中在少数被反复使用的 Python 仓库上,既不够真实,也有数据污染的风险。真实软件开发需要跨版本迁移、改架构、补功能、跑测试、处理兼容性——这正是 RoadmapBench 想要测试的能力。
它的价值有三层:一是真实,用真实的版本升级、5 种语言、并对“指令—测试”做了一致性校验,降低了刷分和污染空间;二是判分更细,完成度分数让“长程任务做了 70%”这件事变得可测量、可比较、可作为训练信号;三是指向清楚,它能直接照出 coding agent 缺什么——长程规划、代码库定位、跨文件一致性、把探索转化为精准修改的能力。
论文还顺带量化了一个直觉:设计新抽象(组件创建,平均通过率 36%)远比定位并修复已有缺陷(修 bug,64%)难,这恰好是“做开发”和“修 bug”的本质差距。
规划能力|Agent Planning Benchmark
A Diagnostic Framework for Planning Capabilities in LLM Agents
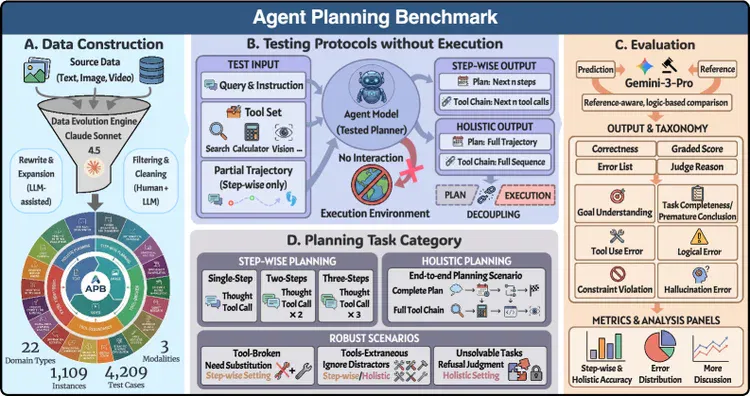
一句话介绍:规划能力要从执行结果里拆出来,APB 是一个专门诊断 agent 规划能力的 Benchmark,测试模型能否分解任务、选择工具、处理坏工具和识别不可解任务。
概述
APB 包含 4209 个多模态案例,覆盖 22 个领域和五类设置:整体规划、反馈条件下的逐步规划、无关工具、损坏工具、不可解任务。它的核心是,不只关注模型最后有没有成功,而是关注失败时,到底是规划错了,还是执行错了?
论文评测了 12 个多模态大模型,差距非常大:整体规划上 GPT-5 的计划正确率 74.5%、Gemini 3 Pro 71.3%,而 GPT-4o 只有 19.5%。
最有说服力的一步是做了后续验证。
在多任务上, GPT-4o、Qwen3-VL-235B、Gemini 2.5 Flash 三个模型上,按 APB 来修正规划,不仅计划本身变好,连最终的执行成绩也一并提升。
这就把 APB 从“一个诊断榜”变成了“一个能接到真实执行、并指导改进的上游信号”。
团队
Haoyu Sun、Wenxuan Wang、Mingyang Song、Yu Cheng 等,来自于上海AI Lab、哈尔滨工业大学、复旦大学等,2026 年 6 月 3 日提交。
为什么值得关注
很多 agent benchmark 的 pass rate 只能告诉我们“没做成”,但不知道为什么没做成。APB 的价值在于把规划能力单独拆出来,让研究者能看到模型在目标分解、工具选择、拒答校准、反馈修正上的具体短板。
它符合好 Benchmark 的一个核心要求:不仅给分,还要给失败类型。只有这样,Benchmark 才能反向指导训练数据怎么造。
本地化|K-BrowseComp
A Web Browsing Agent Benchmark Grounded in Korean Contexts
一句话介绍:Deep Research 需要本地化的 Benchmark。K-BrowseComp 是一个扎根韩国语境的网页浏览 agent 评测集,专门测模型在非英语互联网里的深度检索能力——答案藏在韩语网站、韩国本土知识和本地信息源里,光靠英文世界的能力解不出来。
概述
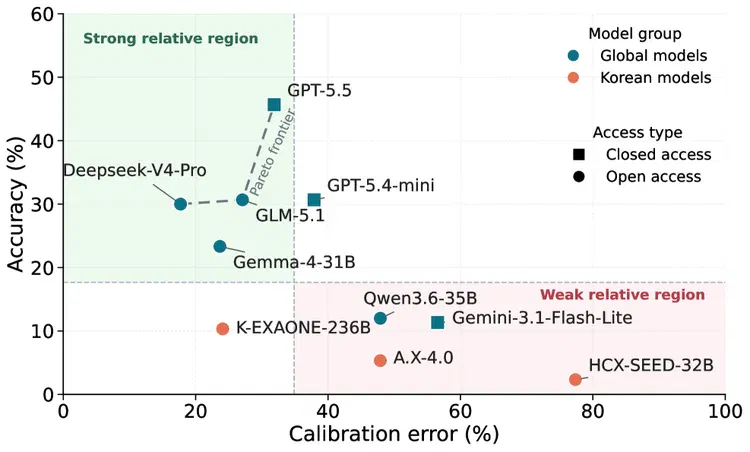
K-BrowseComp 共 400 个问题,其中 300 题的 Verified 子集由韩语母语者人工出题并交叉验证,每题都要求多跳检索、有明确证据链、答案唯一可判。
结果是:GPT-5.5、DeepSeek-V4-Pro、GLM-5.1 这些前沿模型在 Verified 子集上只有 30% 到 45.67%,相比它们在英文版 BrowseComp 上的表现明显下滑;而通过韩国“主权 AI 基座模型”计划发布的韩国本土模型(如 K-EXAONE、HCX-SEED、A.X、Kanana 等)只有 0% 到 10.33%。
团队
这是一支以韩国学界为主、产学联合的队伍,包括中央大学(Chung-Ang University)、KAIST、首尔大学(SNU)、OnelineAI、NAVER Cloud AI、卡内基梅隆大学(CMU)。第一作者 Nahyun Lee(中央大学),通讯作者 Seungone Kim(CMU)。
有带有很强的“为韩语建主权评测能力”的色彩,论文于 2026 年 6 月 1 日提交,数据与代码公开。
为什么值得关注
OpenAI 的 BrowseComp 已经证明:deep research agent 需要持久搜索、交叉验证和信息整合。但 K-BrowseComp 在它之上加了一层——本地化本身就是一种能力,这里有两件事值得说。
第一,中文世界可能同样需要一个自己的 Deep Research Benchmark。中文互联网有公众号、小红书、知乎、B 站、政府网站、企业官网、论坛,还有大量藏在 PDF、图片、截图和封闭平台里的高价值信息——其中不少根本不在通用搜索引擎的索引里。
第二,这件事也反过来照出了模型在特定语言上的短板。哪怕是最强的全球模型,要真正面向全球、服务好海外市场,在某个具体语言和本地信息生态里也还有明显的提升空间,这也正是各国争相建“主权评测、主权模型”的底层动因。
自有评测|硅星人 Eval系列
一句话介绍:前面五个 Benchmark 都是别人家的,最后安利一个我们自己在做的。硅星人 AI 前沿团队的 Agent Eval 系列,核心就是“突击考试”,定期把市面上最火的几个通用 Agent 拉到同一张考桌前,用不同考卷“摸底”。
概述
通用 Agent 在过去一年里成了科技公司必抢的产品形态——ChatGPT Deep Research、Gemini Deep Research、Claude Research、Genspark、Manus、Kimi、MiniMax、GLM,头部玩家都在卷「能自主搜索 + 多步推理 + 输出结构化报告」的能力。
但这些 Agent 在真实任务上到底行不行?已有的很多 benchmark 要么是学术化的封闭题,要么是评测方自己出题自己评,缺乏客观开奖。
Agent Eval 想做不一样的事:
真实任务:有客观开奖时刻(发布会 / 高考 / 体育赛事 / 财报 / 已审判案件)
同时同 Prompt:所有参评 Agent 在同一时间窗口接收同一份 Prompt
过程分前置锁定:开奖前完成过程评分,不许事后改
评分细则全公开:Prompt、GroundTruth、ScoringRules 全部开源
追问机制:每家 Agent 接受三道标准化追问,考察自检能力、押注魄力、反共识洞察
团队
硅星人 AI 前沿团队,https://github.com/pingwest-ai/agent-eval。
为什么值得关注
看到这里,还不值得关注吗?
好吧,说回正经理由。
论文式评测像录播节目,而我们做的是直播:站在事件发生的前N秒,把 Agent 拽上台,当场考,当场开奖。这种考法天然贴近真实场景——因为现实世界的任务本来就是带着不确定性、限时交卷的。
当然,除了直播,接下来,硅星人还打算把考场开到更多奇怪但有价值的地方,比如模糊意图测试,真实用户说话就是一团乱麻,看 Agent 能不能从“我也不知道我要啥”里刨出你真正想要的东西,比如游戏考试,把一群 Agent 拉到一起打游戏,既能直观地看到结果,又同时考验了Agent的规划、策略、执行、记忆等等……总之核心就是找到更多真实用户场景和需求。
另外,我们的评测系列,还有一个优势,即欢迎所有人参与。
这期开头我们讲,下一代模型需要下一代 Benchmark;那不如大家一起去把它建出来。
你在用 Agent 时踩过的坑、最想让模型往哪儿改、哪个能力今天还烂得离谱——都可以提出来,变成下一场考试的考题,并且可以直接参与评测的过程。
评测从来不只是打分,它是在替所有用户告诉模型:该往哪个方向进化。
小结
这一期的六个 Benchmark 都在把“模型会不会答题”这个老问题,换成“系统能不能在真实世界里把事做成”。
UXBench 问的是用户满不满意,MemLens 问的是记不记得住、会不会乱说,RoadmapBench 问的是能不能扛完一次版本升级,APB 问的是计划本身错没错,K-BrowseComp 问的是换个语言还行不行,硅星人Eval问的是模型离现实真实场景有多远——它们考的早已不是知识点,而是体验、记忆、长程执行、本地化、规划这些“做事”的能力。
更关键的是,它们不再满足于甩出一个分数,而是开始给“失败类型”:告诉你模型到底卡在写入、检索、还是推理,是规划崩了还是执行崩了。
评测从“打分”变成了“诊断”,这才是这一代 Benchmark 真正的拐点。
模型的进化方向,不会被某个刷爆的旧榜单定义,而是由一个更好的问题决定的。
而提出这些问题的人,不该只有实验室——也该有正在用它的你。
文章来自于"硅星人Pro",作者 "黄小艺"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
本周 AI 项目推荐| Hypit、Synvas、Pexo...AI 视频赛道还有新玩家 (opens in a new tab)
AI 视频创作,又一批新面孔登场了。 此前,OiiOii、TapNow、LibTV 等产品已开始探索不同的创作方式。其中,OiiOii 把编剧、角色设计、分镜和配乐交给分工协作的 Agent,TapNow 让创作者在画布上组织素材、调用模型和编辑视频。 现在,热度还在延续,新的焦点是:剪辑和修改。一批新的产品集中出现。 Synvas 想把生成画布和专业剪辑时间线放进同一个工作台,Hypit 为 Agent 发明了视频语言,Voyager 则直接让 Agent 操作创作者已经在用的软件。视频创作的入口越来越多,连人该坐在时间线前、对话框里,还是专业软件中指挥 AI,都有不同答案。 这些尝试背后,
本周 AI 项目推荐:Citely、ACE、VIRSE、BuilderHub上新啦! (opens in a new tab)
BuilderHub本周推荐6个AI项目,包括VIRSE、Stances、ACE、橡果Oaky、Citely和CCX,涵盖AI设计基础设施、语言学习与决策研究、AI音乐平台、个人内容系统、合规决策工具及多模型API网关等方向。
本周AI项目推荐|智能知识、Copula Lab、UniPat…谁在给中国模型造后训练数据与考场? (opens in a new tab)
随着Agent走向真实工作,后训练和数据正在成为提升智能的关键。
本周AI项目推荐|Amagine、FrameX、Blinkko ...让AI进入“现实”的各种方法 (opens in a new tab)
这些项目未必都是最成熟的,但它们有一个共同点:没有把模型本身当作产品,而是把 AI 放进一条具体的任务链里,让一个想法变成物品,让一个需求得到回应,或者让一套智能系统真正运转起来。
本周 AI 项目推荐:Link、Agentic Wallets、Token Pay......Token支付底座长啥样 (opens in a new tab)
什么是AI原生支付?随着全世界个体token的消耗量猛增,越来越多的大玩家和初创公司开始瞄准AI支付机制和基础设施的问题。