用国产GPU训练AI给自己写内核,摩尔线程刷榜硬核基准
国产算力生态的难题,从此有了 AI 解。
国产算力生态的难题,从此有了 AI 解。
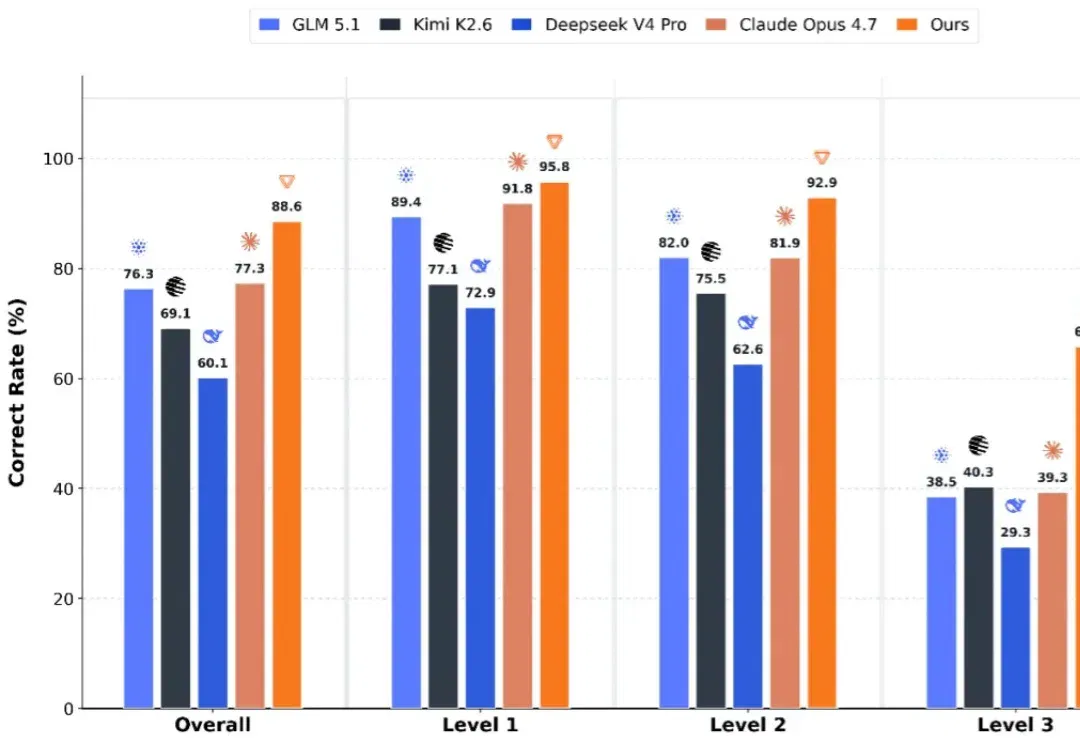
最近,在比「AI 生成 GPU 内核」的硬核基准 KernelBench 上,摩尔线程的模型拿下了第一。
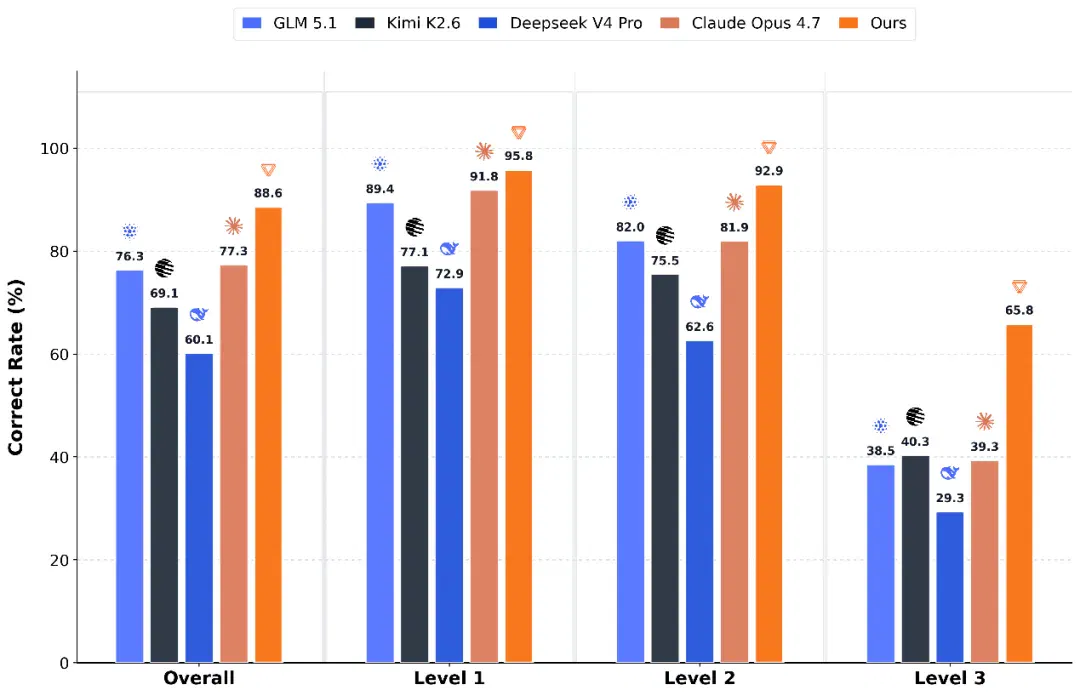
在 MooreEval 执行式验证协议的加持下,摩尔线程的 MusaCoder-27B-RL 取得了领先业界的表现,超越了 Claude Opus、GLM-5.1、Kimi K2.6 等一众国内外先进大模型。
这次拿下成绩的,是上周才正式发布并开源的MusaCoder(在新窗口打开),这是一款面向 GPU 底层算子生成的专用大模型,能自动把 PyTorch 代码转换为 CUDA 与 MUSA 内核,为 AI 训练等任务提供加速,旨在降低开发者手写底层 GPU 算子的门槛。
- 论文:《MusaCoder: Native GPU Kernel Generation with Full-Stack Training on Moore Threads GPU》
- 论文地址:http://arxiv.org/abs/2606.04847
- 模型权重:https://huggingface.co/MooreThreads/MusaCoder-27B
值得关注的是,MusaCoder 是业内首个基于国产 GPU 算力底座完成全链路训练与验证的开源代码大模型,其完整后训练流程均在基于 MTT S5000 的夸娥智算集群上完成。从 AI 模型到 GPU 硬件,全部国产化。
这是国产 AI 算力领域的一次突破。
生成 GPU 内核的竞赛
比的是真实性能提升
用 AI 来生成 GPU 内核(Kernel),是当前大语言模型(LLM)最硬核的挑战之一。
KernelBench 由斯坦福大学和普林斯顿大学于 2025 年推出,它被设计为一个「真实世界的工程环境」,专门用来衡量大模型编写高效 GPU 内核代码的能力。
简单来说,其核心任务是:
给定一个 PyTorch 模型架构,让大模型生成一个定制的、内嵌 C/C++ 的 CUDA 内核,以替换原有的 PyTorch 算子,目标是实现程序加速。
与其他代码生成任务不同的是,该基准不仅关注内核能否正确运行,更看重其相对于基线能否带来实际的性能提升。
另一方面,让 AI 自动化编写高效、底层的 GPU/CUDA 代码又是当前突破算力瓶颈的关键。让 AI 掌握这项能力不仅能推动生成代码的研究,更会在实际应用中为降低算力成本、提高能效提供直接可用的工具。
为了全面评估模型能力,KernelBench 包含了超过 250 个 PyTorch 机器学习任务,并按复杂度和粒度分为 4 个递进难度级别,从 Level 1 的核心基础算子如卷积、矩阵乘法、归一化等,到 Level 4,Hugging Face 上的生产级模型优化任务。
在这之上还有级化的评估流程,基于一个三阶段的严格验证流水线,以确保结果的可靠性。另外,KernelBench 还要求其加速比超过用户可设定的阈值:AI 生成的代码光「正确」还不够,必须真正有提供加速效果的价值。
因此,KernelBench 被视为一个非常严苛的基准。刚刚推出时,DeepSeek R1 在所有任务上的通过率也只有 30%,注意这只是「能用」的比例,还不是 AI 生成的代码能带来性能提升的比例。MusaCoder 现在已经做到了通过率 88.6%,超越的个个都是以写代码能力著称的大模型。
在论文中,研究人员报告了 MusaCoder 在 Level 1 到 Level 3 能力的各项指标:
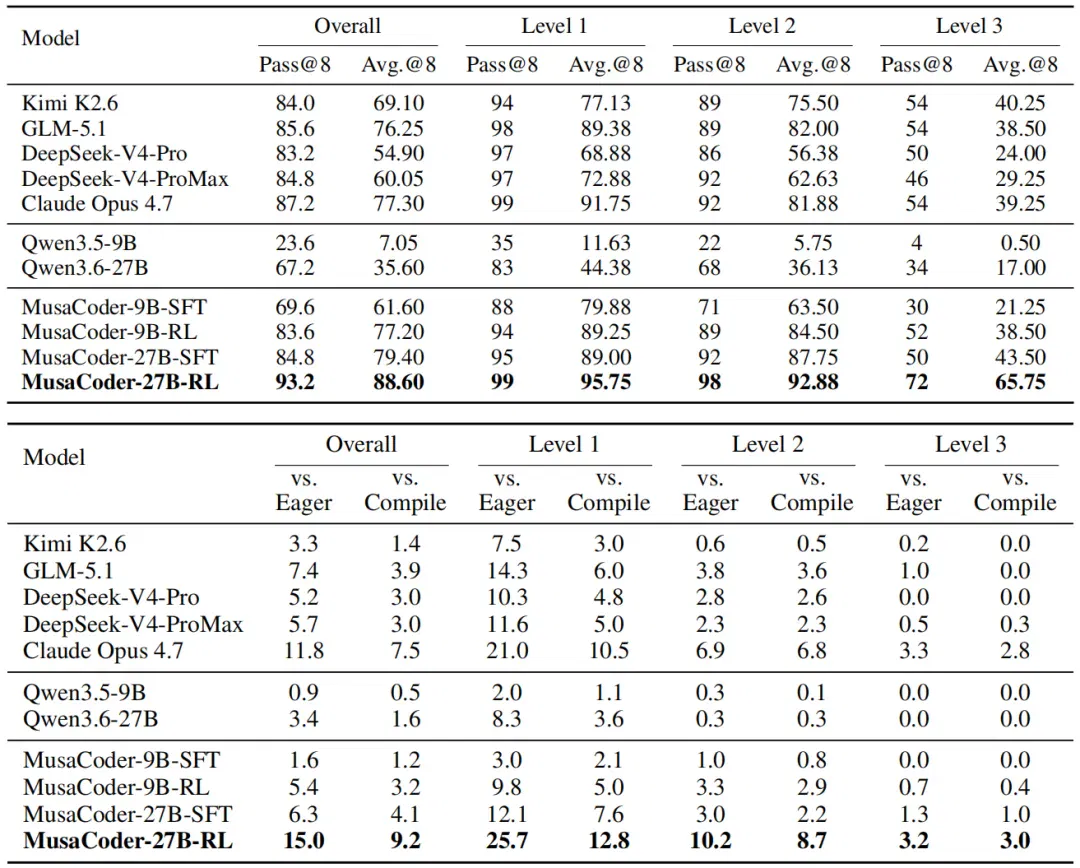
可见大多数知名通用大模型在 GPU 内核生成任务上的能力并不尽如人意,而 MusaCoder 不仅可以做到生成的代码能用,部分代码已可以做到「好用」:性能比基准线高至少 1.1 倍。
那么,摩尔线程是如何用一款「小模型」做到的?
MusaCoder 的秘诀
让 AI 自我改进
在 KernelBench 上,MusaCoder 超越的模型参数量都在大几千亿到万亿级别,自己却只有 270 亿。能实现「以小博大」,其背后的方法创新是核心。
与通用的代码生成任务不同,GPU 核心的生成对并行计算、线程组织、内存访问、索引映射和硬件执行等特性要求很高,生成的代码不仅要语法对,还要能通过编译,不投机取巧,在真实执行中获得性能收益。
为此,KernelBench 构建了一套专门针对 GPU 原生内核生成任务的「全栈训练」方案,其中最关键的一环是MooreEval 执行式验证协议。
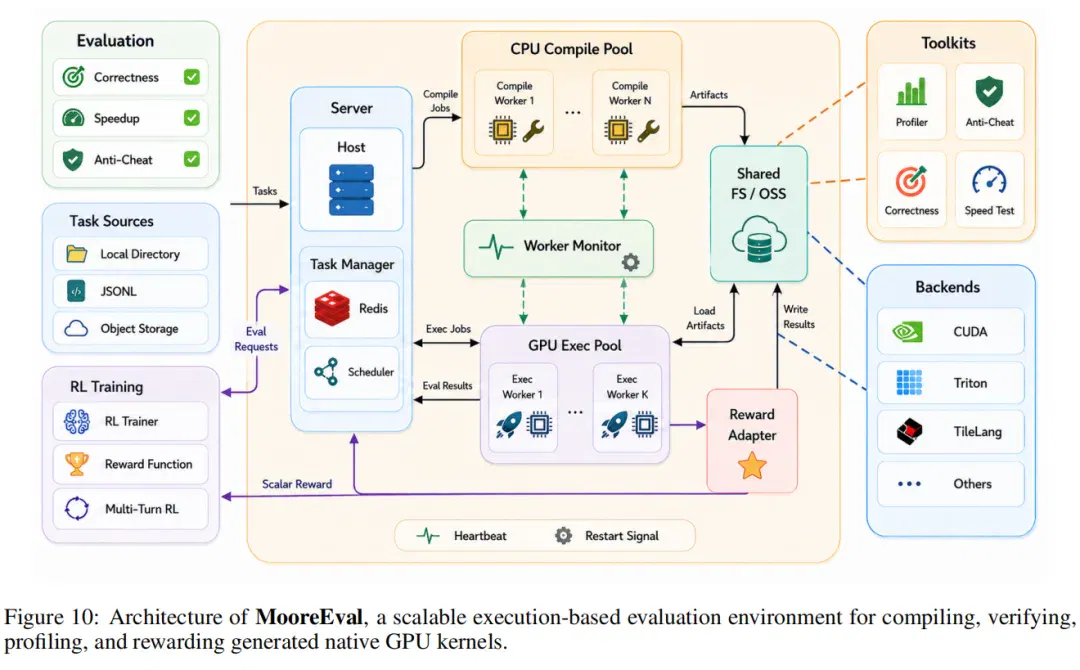
MooreEval 的架构:这是一个基于执行的可扩展评估环境,用于对生成的原生 GPU 内核函数进行编译、验证、性能分析及奖励。
简单来说,MooreEval 是研究人员为 GPU 内核生成任务设计的一套自动化、分布式、结构化的「考试评判系统」。它不像传统方法只检查代码文本相似度或进行简单的静态分析,而是通过真实地编译、运行和评测模型生成的代码,提供结构化的反馈和奖励信号,用于指导大模型的训练和评估。
对于模型生成的每个候选内核代码,MooreEval 都会执行一个分阶段的验证管道,包括接口和编译检查、正确性验证、反作弊检测、以及性能测试。只有当上一阶段通过后,候选的方法才会进入下一阶段。
经过流程审核的代码会根据一个层次化的奖励函数计算分数,除了用于判断最终实力的分数,还会输出丰富的结构化信息,它们会自动转化为可供模型理解的自然语言诊断,用于模型的进一步训练。
为了能在强化学习训练中高效处理大批量代码编译和执行,MooreEval 被设计成一个分布式异步流水线系统,它将编译与执行进行了解耦,CPU 密集型的编译工作和 GPU 密集型的执行工作被分配给不同类型的执行器(Worker),彼此独立伸缩,避免了 GPU 在等待编译时的空闲。
在 GPU 内核生成这件事上,MooreEval 就像是一个自动打分的考官,它通过真实地编译、运行、反作弊检测和性能测试,实现了高效率和大规模的验证,并为模型提供了精准的学习信号,是驱动 MusaCoder 实现高性能的关键引擎。
让 AI 能 Know How
全栈后训练体系
MooreEval 只是 MusaCoder 模型特性的一小部分。
MusaCoder 的训练流程,包含利用多种原始数据源构建面向 Kernel 的语料库、数据增强、SFT 与 RFT、两阶段强化学习流程的优化,以及 PrimeEcho、MirrorPop 和 Buffered Dynamic Retry 三种稳定技术。
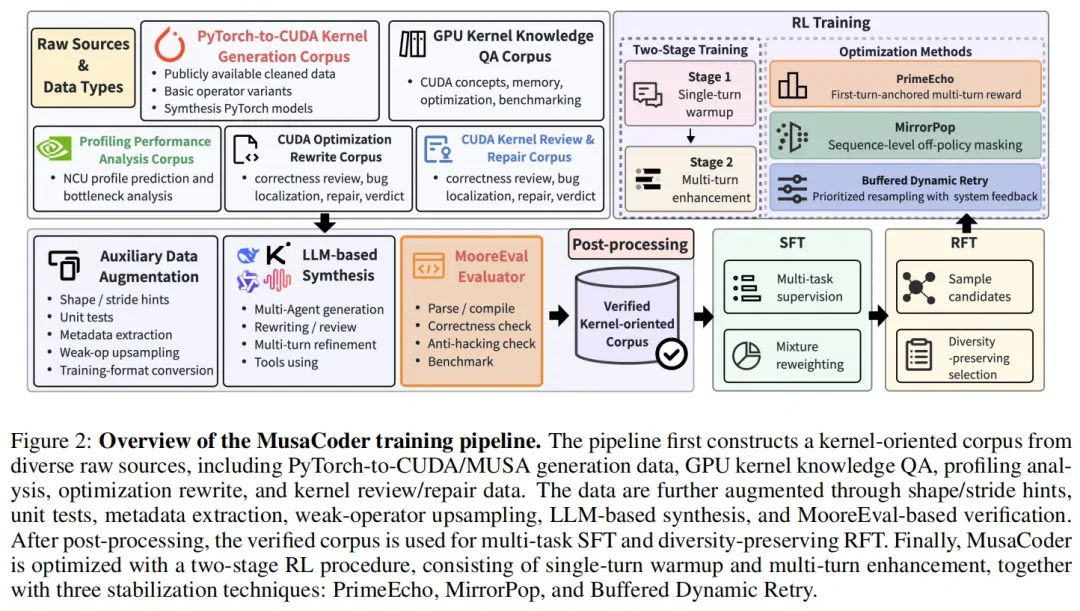
为了让 AI 模型能够真正学会写 GPU 内核,MusaCoder 构建了一套面向 GPU 原生算子生成的全栈后训练体系。
在数据构建阶段,MusaCoder 通过一个三阶段渐进式的数据合成管道,系统地培养了模型理解 GPU 编程所需的「思维模式」:
- 第一阶段是通过 GitHub 真实代码、NNSmith 自动生成图等多种来源,构建一个庞大的 PyTorch-CUDA/MUSA 任务集,并注入 GPU 编程基础知识;
- 第二阶段是结构化推理和显式的 Shape 信息注入,其增强了模型对张量形状、内存布局和索引关系的理解,让模型不仅知道要做什么,还要理解「怎么做」;
- 第三阶段是多轮的交互与环境反馈解析,通过接收编译错误、运行时报错、性能瓶颈等反馈,让模型据此进行针对性的修复和优化,为后续的强化学习模拟多轮修复场景,缓解奖励稀疏的问题。
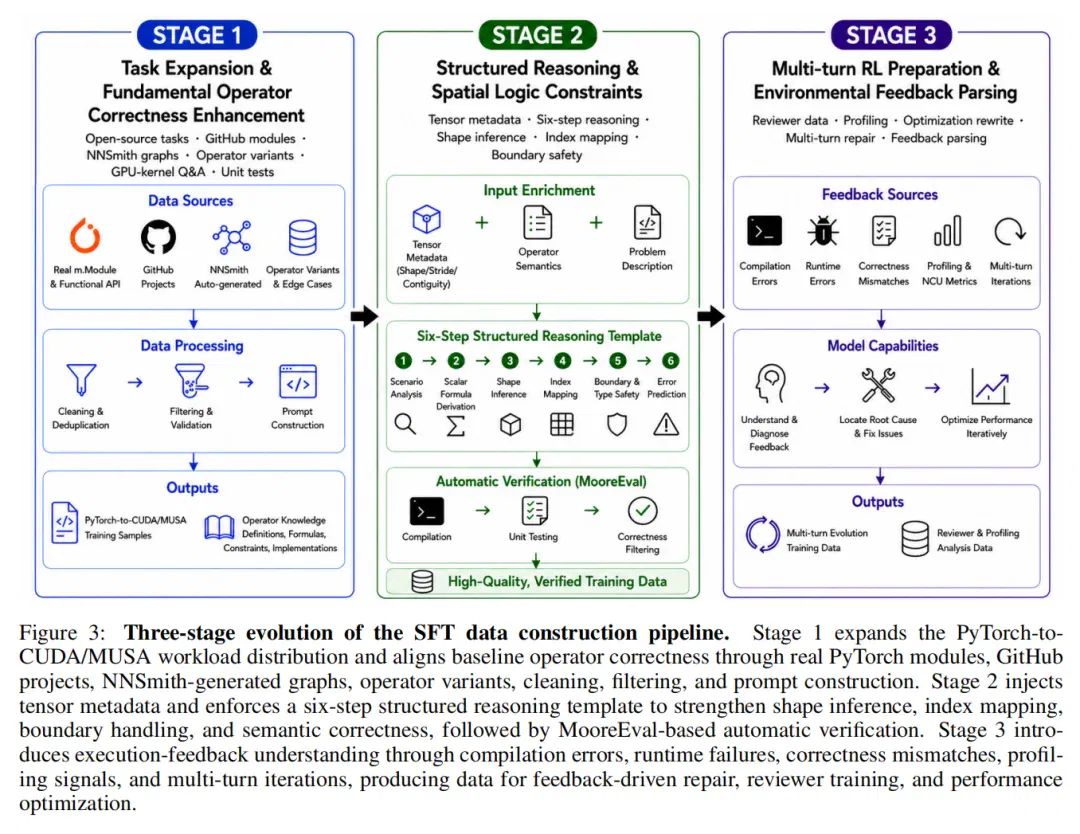
SFT 数据构建流水线的三阶段演进。
为提升强化学习的稳定性,MusaCoder 又引入了 PrimeEcho、Buffered Dynamic Retry,以及 MirrorPop 三个机制。
为了防止模型奖励作弊,为了「及格」而过度依赖多轮反馈,研究团队设计了基于首轮交互锚定的多轮奖励机制 PrimeEcho。这是一个全新的轨迹级奖励公式,将首轮生成质量和整个过程中的最好表现按权重结合,确保了模型优化的主要目标始终是提升首轮生成质量,多轮修复只是辅助。
缓冲动态重试(Buffered Dynamic Retry,BDR)用于从完全失败的困难样本中恢复信号,目标是解决 GPU 内核生成这种高难度任务中正样本稀少的挑战。一旦某轮任务彻底失败,BDR 会将任务描述、失败的代码和报错信息打包成一个新任务,放入一个「动态缓存池」。模型会以较低概率从中学习如何修复自己的错误,从而挽救原本无学习价值的失败样本。
MirrorPop则用于解决强化学习过程中模型训练不稳定的问题。它通过一个更精准的过滤器,能够精准剔除高风险样本。
根据实验数据,这三项机制在提升模型最终性能上都获得了明显的性能提升效果。
国产 AI 算力技术栈
全流程跑通
当然,MusaCoder 的意义也不止于模型本身。
AI 模型的构建,是一个硬件与软件栈的复杂磨合过程,对编译栈的兼容性、运行时稳定性、调度系统的低延迟、评测基础设施的鲁棒性都提出了严苛的要求。
从监督微调到强化学习,MusaCoder 的整个训练流程全部运行在摩尔线程自己的「夸娥」智算集群上。能完整跑通这一套全流程,证明了国产 GPU 集群已经具备支撑此类复杂、动态、交互式训练任务的能力。
这在一定程度上打破了我们对于国产 AI 算力「只能跑推理」的刻板印象。能够稳定承载代码大模型的后训练全周期算力需求,意味着在 AI 基础设施的关键环节上,国产硬件已经从可用走到了好用的阶段。MusaCoder 的成功实践或许会成为可复用的工程范式,为未来更多复杂的 AI 研发提供参考价值和迁移路径。
在大模型时代,「自主可控」不仅关乎芯片制造,更包括上层的软件栈、训练平台、评测体系和开源模型生态。MusaCoder 证明了在这些层面,国产力量已经能够形成闭环。
而对于广大开发者来说,一个能直接从 PyTorch 自动生成高性能 MUSA 内核的基础模型,更是开启了 AI 驱动开发的新路。
或许过不了多久,应用国产算力的底层加速能力,会变得像用 AI 写代码一样简单。
文章来自于"机器之心",作者 "泽南"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
60秒极限挑战!中国GPU独角兽杀出重围,斩获图形顶会大奖 (opens in a new tab)
他们不光能造GPU,还能写出全球顶级的算法!摩尔线程这次开源给国产具身智能递了一把「神兵利器」。
GPU 开始伸手进算法了:摩尔线程要加速 3D 高斯训练 | ECCV 2026 (opens in a new tab)
让GPU学会给三维世界“排队”。 GPU公司通常不太需要向别人解释自己为什么做GPU。 但当一家GPU公司开始亲自下场研究算法,事情就没那么简单了。 最近,摩尔线程团队的一篇论文被计算机视觉三大顶会之一的ECCV 2026正式接收。这篇论文把目光放到了3D Gaussian Splatting,也就是3DGS上,论文名叫LiteGS,做的事情可以概括为:把3DGS训练得更快。 但如果只把它理解成一次普通的算法优化,就低估了这篇论文的意思。 过去两年,空间智能(spatial intelligence)成了AI行业的高频词:李飞飞为它创立了World Labs,国内的具身智能与世界模型创业潮,讲
老黄喝豆汁「破防」背后,国产GPU正在填上CUDA护城河 (opens in a new tab)
老黄在北京喝豆汁「翻车」,全网笑疯了。但真正值得警惕的,是他背后那个正在长出来的「中国版CUDA生态」。从万卡集群到机器狗,从SGLang主线到AI Agent自动迁移,这家公司这次不只是秀芯片,而是在重写国产GPU的游戏规则!

国产GPU开始造世界!国内首个全栈具身智能仿真平台来了 (opens in a new tab)
没有新的GPU,没有新的智算卡。 但一家国产GPU厂商,却在一整场发布会的时间里,做了一件非常物理的事儿—— 发布首个全栈国产化的具身智能仿真平台。 先来看效果。 这只名叫小飞的机器狗,缓缓走上了舞台。 在走到舞台中央后,只见屏幕里仿真世界的小飞侧空翻了一下,随即,物理世界的小飞便做出了一模一样的动作。 转个身,再来一次,动作依旧是像粘贴复制的似的。 小飞的运动策略是这样的: 100%是在仿真世界中训练出来,并无损迁移到真实物理世界的。 那么它背后这家国产GPU玩家是谁?这个具身智能仿真平台又叫什么? 不卖关子。 正是由摩尔线程新鲜发布的MT Lambda。 刚才小飞的一套操作,可以理解为:
国产GPU首获全球顶级推理框架「原生门票」:MUSA合入SGLang主线 (opens in a new tab)
如果只看这场 Meetup 的嘉宾名单,你大概会先想到海外芯片巨头,或者某家国际 AI 基础设施公司。