一次三篇!李飞飞的空间智能公司,发论文了
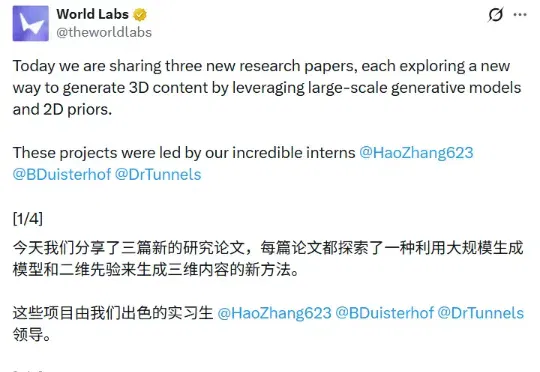
今天,由李飞飞联合创立的空间智能公司 World Labs 在同一天发布了三篇技术论文!三篇论文分别由公司内部实习生主导完成,研究方向各异,但共享同一个核心命题:借助已在海量图片数据上训练成熟的 2D 生成模型,降低 3D 内容生成的难度门槛。
今天,由李飞飞联合创立的空间智能公司 World Labs 在同一天发布了三篇技术论文!
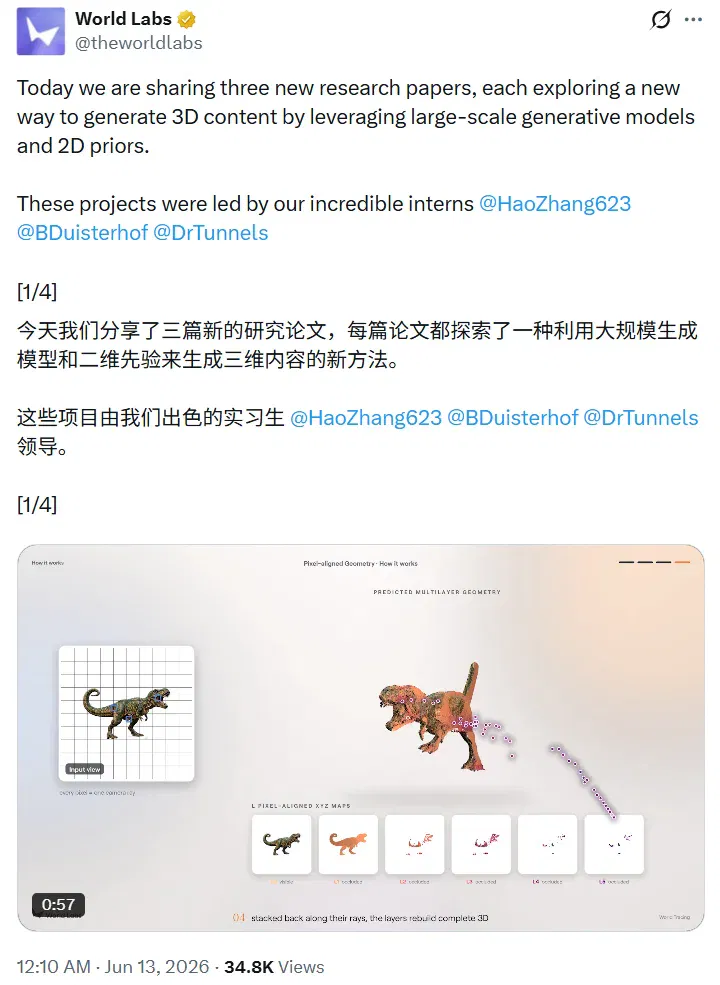
三篇论文分别由公司内部实习生主导完成,研究方向各异,但共享同一个核心命题:借助已在海量图片数据上训练成熟的 2D 生成模型,降低 3D 内容生成的难度门槛。
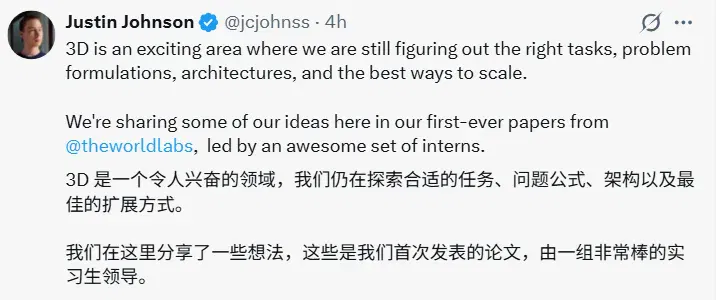
值得注意的是,正如 World Labs 联合创始人 Justin Johnson 所言,尽管该公司此前已有成果展示,但这三篇论文确是该公司的首批论文(first-ever papers)。
回到这三篇论文的主题:3D 内容生成。这是一个长期以来「说起来简单、做起来极难」的领域。
现实世界是三维的,但训练数据绝大多数是二维的(包括照片、视频、图像),而不是带有体积、深度和遮挡关系的完整空间结构。一旦转入三维,训练数据骤减,几何一致性的维护变得指数级复杂。
过去数年,研究者们已经找到了一条可行路径:不从头训练 3D 生成模型,而是将 2D 扩散模型的强大先验能力迁移到 3D 生成任务中。
World Labs 这次发布的三篇论文,分别从不同角度延伸了这条思路。
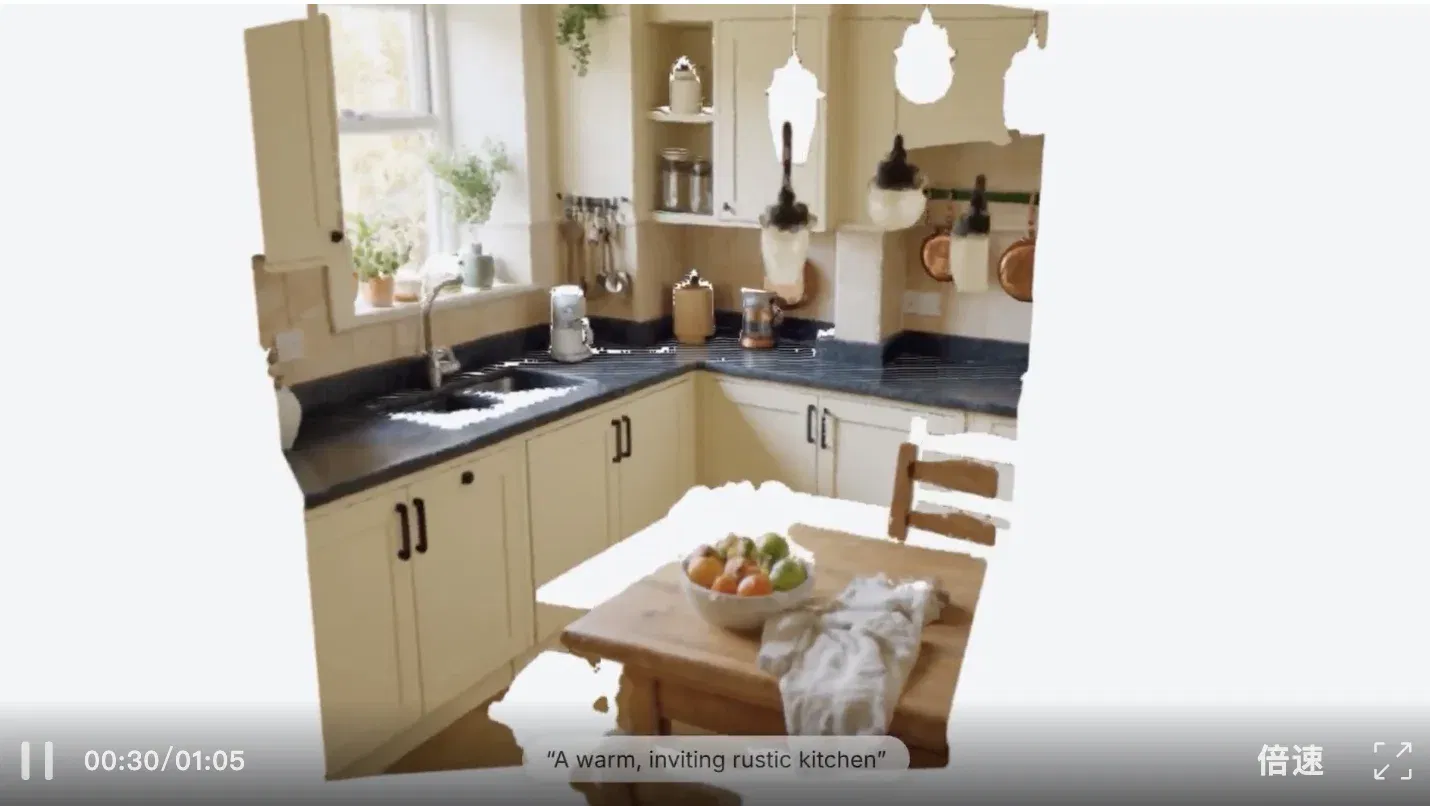
三项研究的具体切入点各有侧重:
- World Tracing解决的是「从单张图像恢复可见表面之外的完整三维几何」问题;
- Modality Forcing探索的是「如何让一个文生图模型同时具备深度感知和 3D 推理能力」;
- Flex4DHuman则将问题延伸到时间维度,尝试从普通单目视频中提升出可合成的动态 4D 人体。
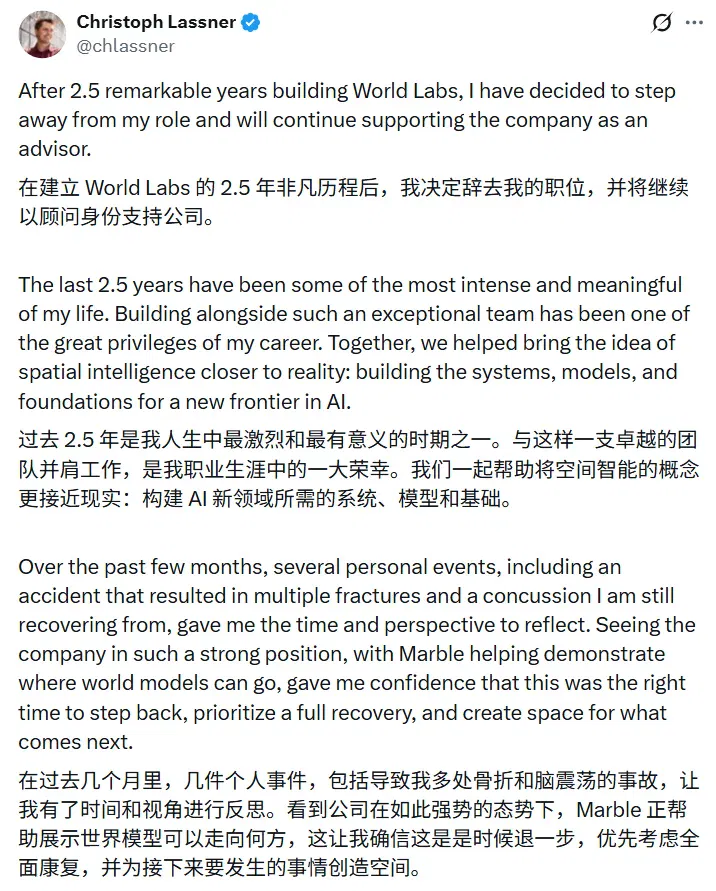
值得注意的是,就在论文发布的同一天,World Labs 联合创始人 Christoph Lassner 在社交媒体上宣布因病将离开公司,为这场学术亮相增添了一丝人事变局的注脚。
下面我就来具体看看 World Labs 的首批论文。
World Tracing
让每一个像素,都指向一个完整的 3D 世界
如果你手中只有一张照片,你能从中恢复多少三维信息?
常识告诉我们:很有限。照片只是现实世界在某一时刻、某一视角下的投影,深度信息丢失,遮挡面后方的空间完全缺席。当前主流的单图转 3D 方法,通常面临一个两难困境:要么做深度估计(精确但只能恢复可见表面);要么做生成补全(想象力丰富但结果往往偏离原始图像的视觉细节)。
World Tracing方案试图同时消解这两种缺陷。
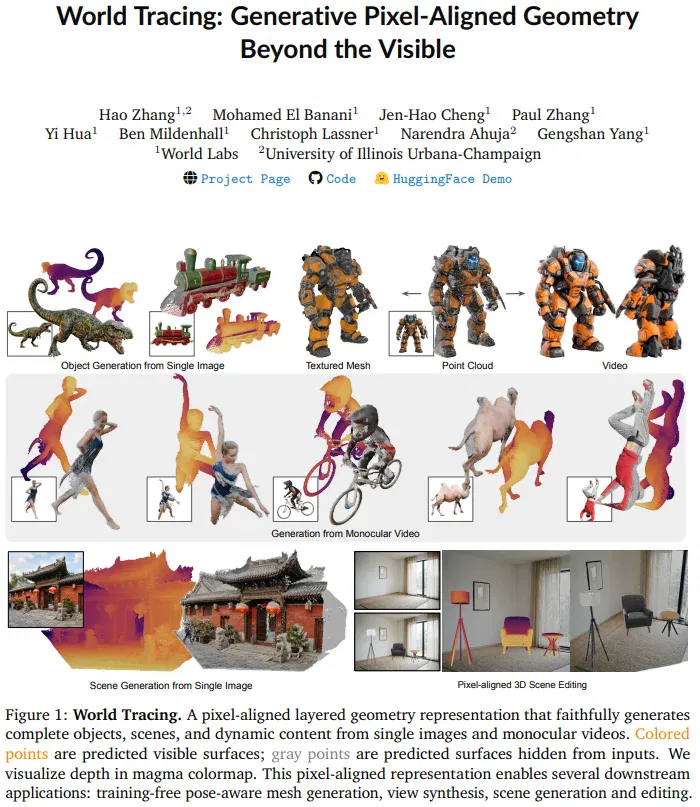
- 论文标题:World Tracing: Generative Pixel-Aligned Geometry Beyond the Visible
- 论文地址:https://arxiv.org/abs/2606.13652
- 项目地址:https://haoz19.github.io/world-tracing-page/
论文由 Hao Zhang 主导,团队成员包括 World Labs 联合创始人 Ben Mildenhall、Christoph Lassner、Gengshan Yang 等人。
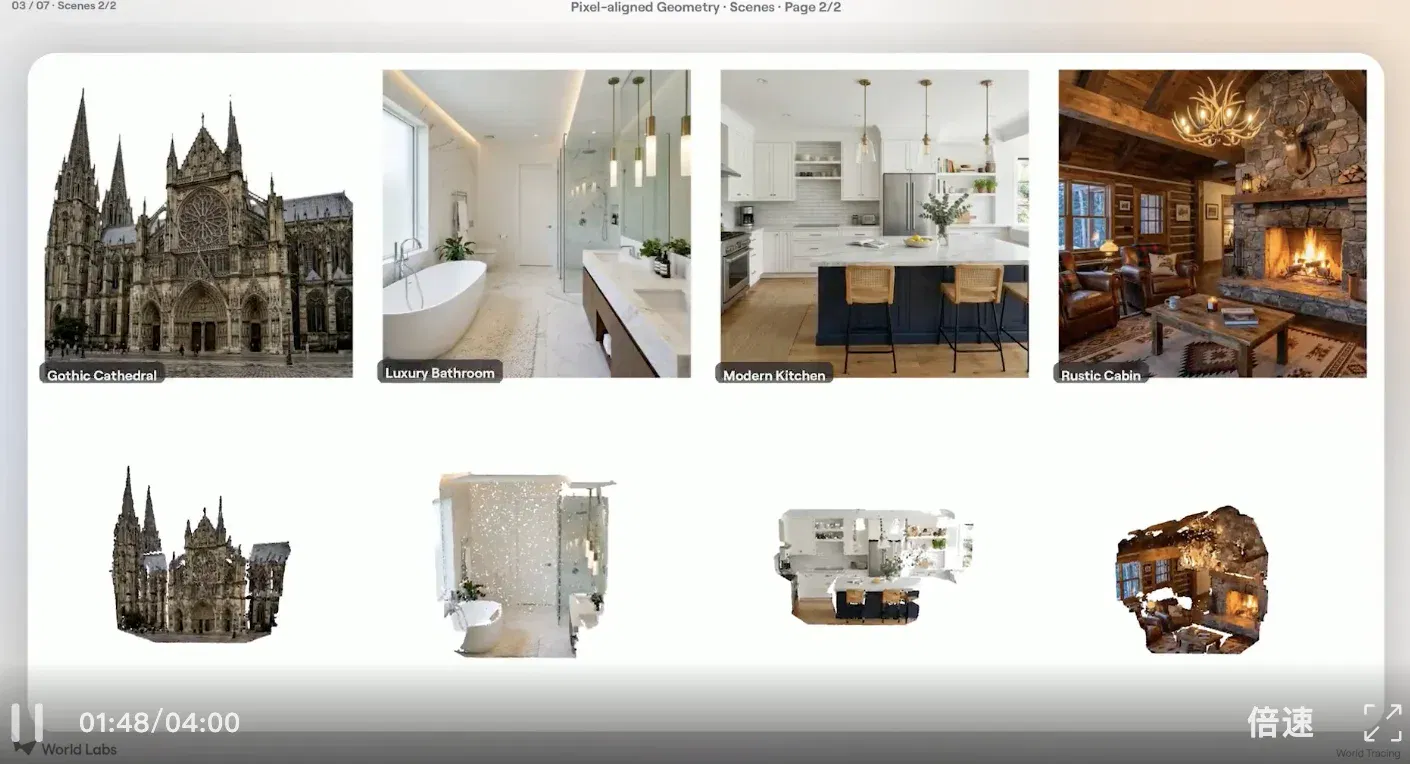
核心思路是:将每一个输入像素视为一条射线,沿着这条射线预测一组有序的三维坐标点——第 0 层是可见表面,之后各层依次是沿该射线方向的被遮挡几何体。论文将这种表示称为「pixel-aligned multilayer geometry representation」(像素对齐的多层几何表示),具体实现为一个多层 XYZ 坐标张量(multilayer XYZ stack)。
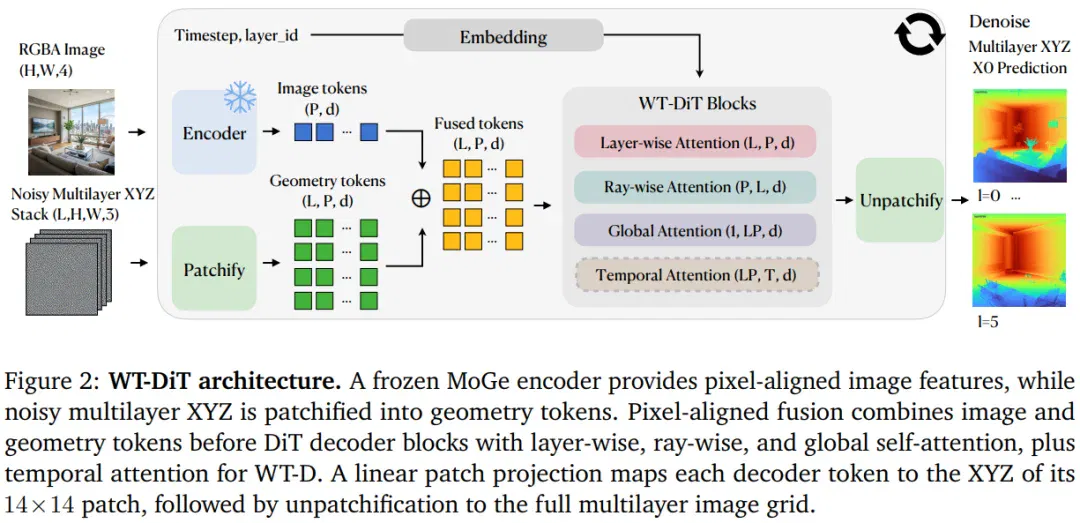
换句话说,World Tracing 给每个像素对应的不只是一个三维点,而是一叠有序的三维点,记录了这条视线穿越场景所经过的所有几何层:第 0 层是直接可见的表面,更深的层则逐步揭示被前景物体遮挡的隐藏几何体。
这就像是把相机比作一支铅笔:普通深度估计只能画出物体的轮廓线,而 World Tracing 试图画出这支铅笔穿透纸张时,另一面的样子。
预测这种「深度堆叠」本身是极高难度的任务,因为遮挡面的几何信息根本没有出现在图像中,模型必须依赖对现实世界空间结构的「常识」来进行推断。
为此,研究团队采用了扩散模型来对这组有序深度值建模。扩散模型天然适合处理带有不确定性的分布式预测,而非给出单一确定答案。
更关键的是,整个预测过程始终对齐于原始输入图像的像素坐标。可见表面的深度被精确地「锚定」在图像信息中,而不可见部分的补全则在这个约束框架下进行生成。这使得最终的三维重建既忠实于输入图像,又具备完整的空间结构。
论文中展示的案例覆盖了静态物体、室内外场景,乃至动态世界建模。团队还发布了论文代码、项目主页和 Hugging Face 在线演示,让外界能够直接测试这套方法对任意图像的处理效果。
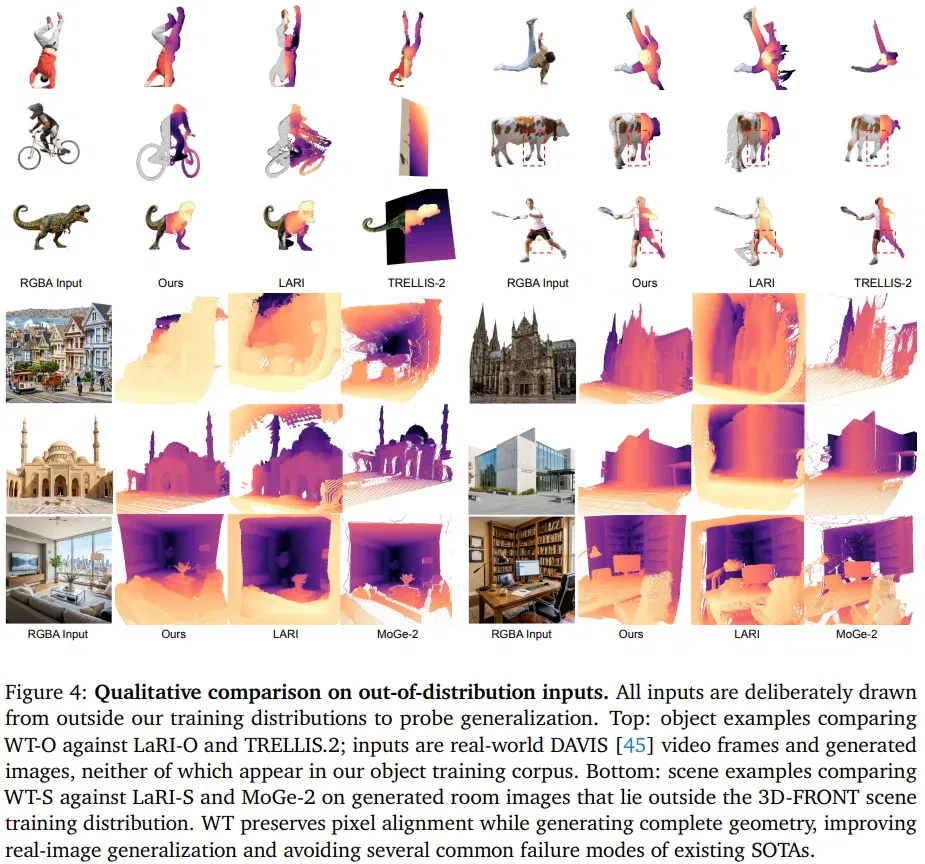
对于 World Labs 这样以「空间智能」为核心产品方向的公司来说,World Tracing 的意义在于:它提供了一种从单张图像出发、直接恢复丰富三维结构的技术路径,而不需要多视角输入或昂贵的三维数据标注。这与 Marble 产品「从图像生成可探索三维世界」的核心承诺高度一致。
Modality Forcing
一个模型,同时理解颜色、文字和深度
深度估计和图像生成,在传统上是两个完全独立的任务,分别需要专门的数据集和独立训练的模型。前者需要精确的深度标注(LiDAR 扫描或双目视觉),后者依赖海量图文对。两套任务的数据规模相差悬殊——图像生成模型见过数十亿张图片,而深度模型的训练数据量通常只是零头。
这种不对称,催生了一个自然的问题:能否让已经在海量图文数据上训练成熟的文生图模型,直接学会对深度的感知?
Modality Forcing给出了一个肯定的回答,并走得更远。
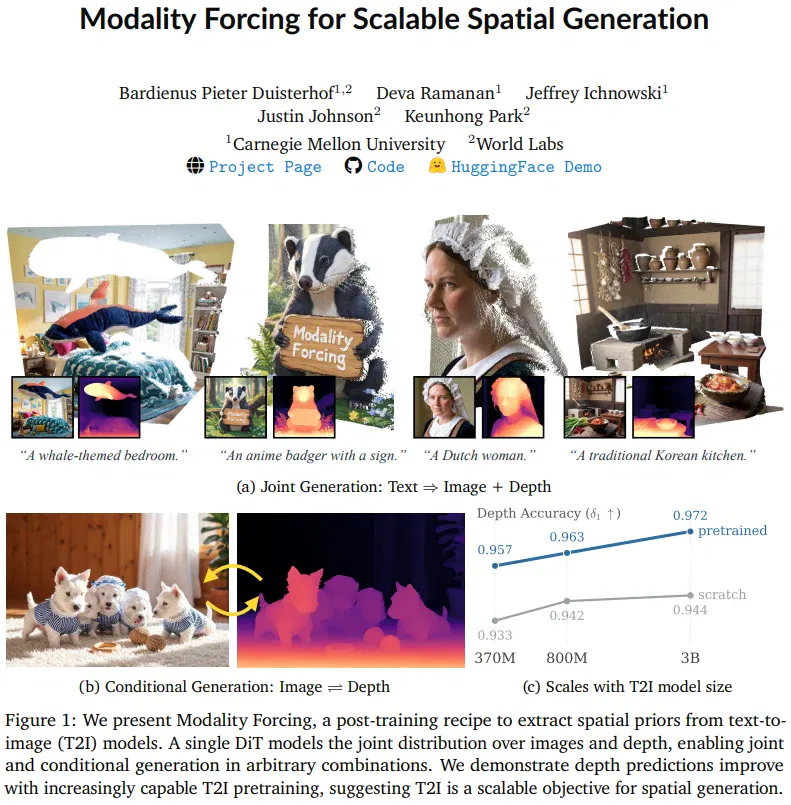
- 论文标题:Modality Forcing for Scalable Spatial Generation
- 论文地址:https://arxiv.org/abs/2606.13676
- 项目地址:https://modality-forcing.github.io/
这篇由 Bardienus Duisterhof 主导的 World Labs 实习研究,核心主张是:文生图是一种可扩展的 3D 推理预训练目标,只要用对训练策略,同一个模型可以在 RGBD 生成、深度估计和深度条件图像生成三项任务之间自由切换。
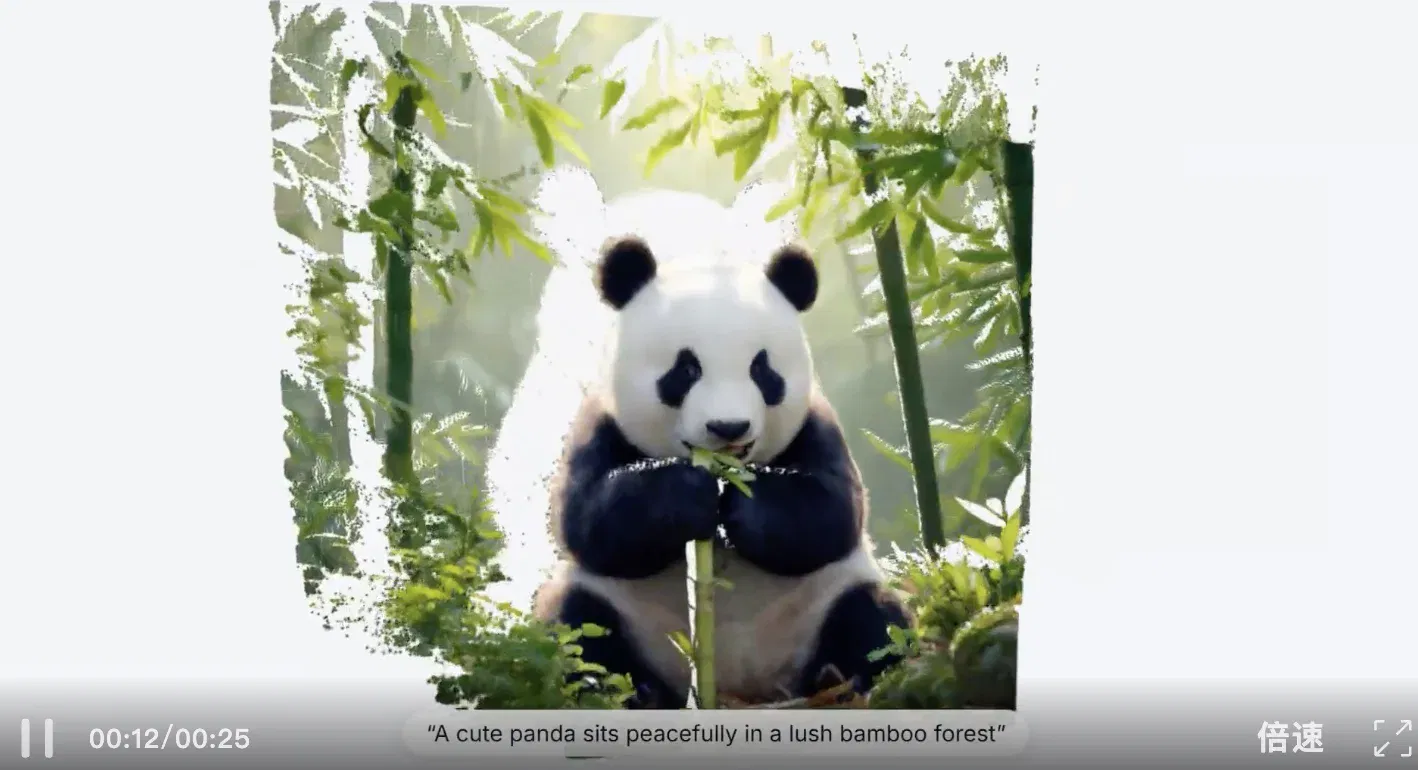
论文提出的方法名为「Modality Forcing」,其核心机制是:给 RGB 和深度两种模态分别分配独立的扩散噪声时间步(per-modality noise levels)。
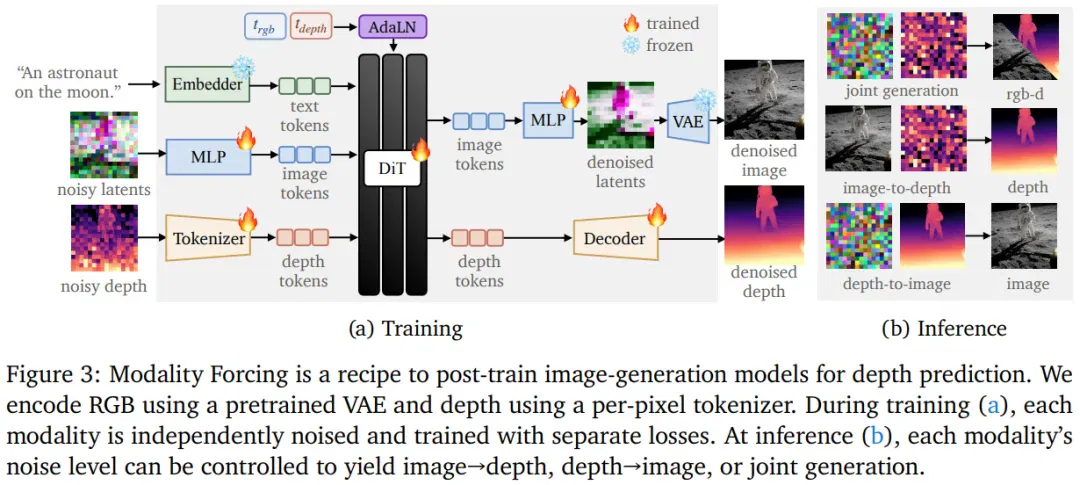
训练时,RGB 和深度各自被加入不同程度的噪声,同时接受各自独立的损失监督;推理时,只需固定某一模态的噪声步为 0(即视为已知条件),对另一模态完整去噪,便可实现图像→深度(I2D)或深度→图像(D2I)的条件生成;两者均加噪则为联合生成。
由于深度在像素空间(而非 VAE 隐空间)中直接扩散,模型可以从仅含稀疏深度标注的真实世界数据中学习,不再局限于依赖密集标注的合成数据集。
这种思路的优势在于:不需要额外引入独立的深度网络,也不需要为每个任务单独设计架构分支。一个预训练的文生图模型,通过 Modality Forcing 微调之后,就具备了对场景几何的直接感知能力。
从技术路径来看,Modality Forcing 与近年来流行的多任务扩散模型研究(如 Marigold、Depth Pro、Lotus 等)方向一致,但其独特之处在于对「生成」与「感知」两类任务的统一处理。深度估计通常被视为一个判别任务(给定图像,输出深度值),而文生图是一个生成任务。
Modality Forcing 的贡献在于证明:这两种任务之间的边界比想象中模糊得多;生成能力的积累,可以直接转化为感知能力的提升,反之亦然。
对 World Labs 来说,这项研究的意义延伸到产品层面:Marble 的 3D 世界生成需要对场景深度的精确理解。一个同时具备生成和感知能力的统一模型,将使 3D 世界的构建更加自洽,避免深度估计模块和生成模块之间的累积误差。
Flex4DHuman
从一段手机视频,「升维」出可合成的动态人体
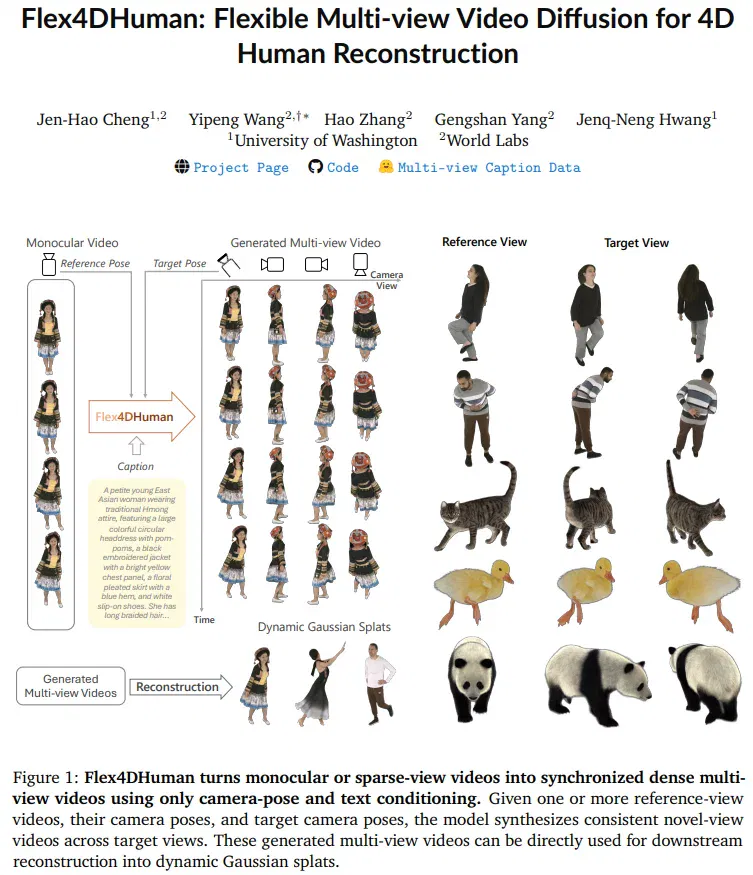
如果说前两篇论文处理的是静态或通用场景,Flex4DHuman则将挑战聚焦于一个更具体但同样重要的子问题:如何从一段普通的单目视频(比如手机拍摄的日常视频),重建出动态人体的完整四维结构,即三维空间+时间维度。
这个问题的难点在于「单目」两个字。多目摄像系统可以通过视差直接测量三维坐标,但单目视频丢失了这种几何约束。从单目视频重建运动中的三维人体,本质上是一个欠约束问题:同一段视频序列,理论上对应无数种可能的三维运动轨迹。此前的方法大多依赖优化过程,计算耗时,且难以泛化到训练集以外的姿态和外观。
Flex4DHuman 由 Yipeng Wang 担任项目负责人,第一作者为 Jen-Hao Cheng,工作在 World Labs 实习期间完成。
- 论文标题:Flex4DHuman: Flexible Multi-view Video Diffusion for 4D Human Reconstruction
- 论文地址:https://arxiv.org/abs/2606.13655
- 项目地址:https://andy-cheng.github.io/Flex4DHuman/
方法以阿里巴巴的 Wan 2.1(一个 1.3B 参数的文本生成视频 DiT)为基础进行微调,核心改动只有一处:将原有的时空位置编码替换为一套五轴位置编码(five-axis positional encoding),在原有的空间坐标和帧序索引之外,额外引入视角槽索引和连续 SE(3) 相对相机几何,使模型在注意力机制内部直接感知相机之间的相对位姿关系。
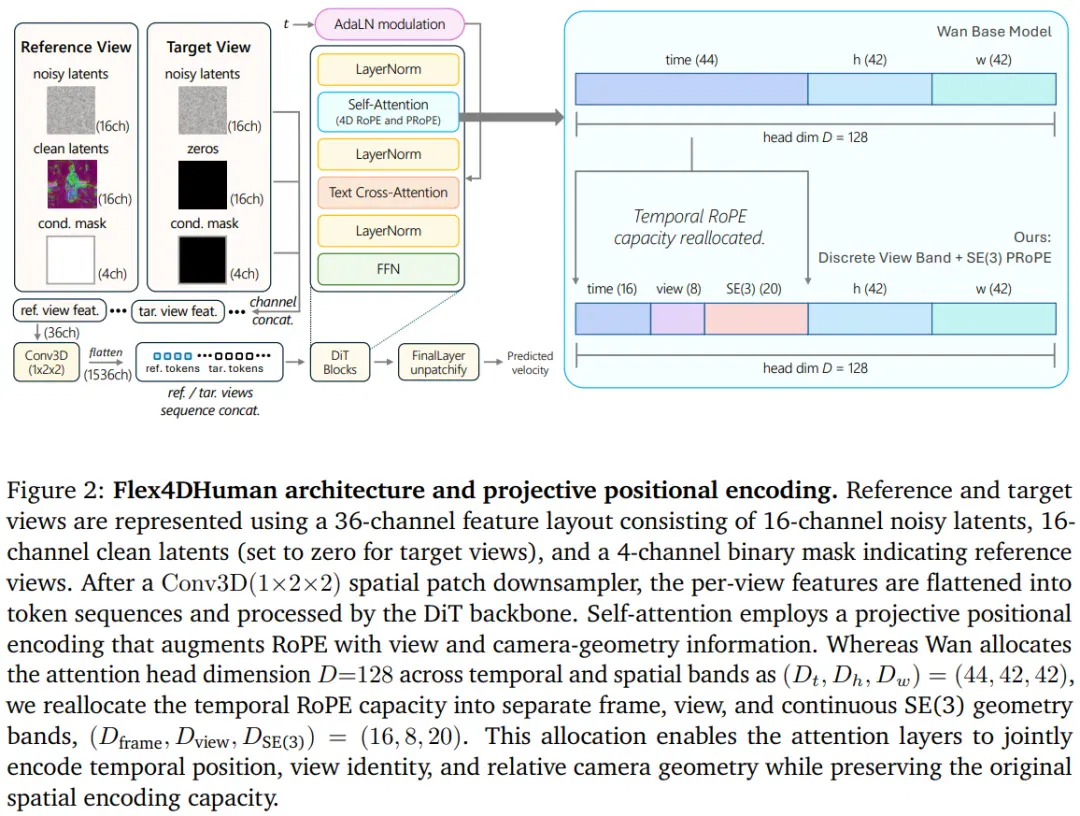
这个设计带来了一个关键优势:不需要骨架估计(skeleton)、深度图或法线图等显式几何先验,仅凭相对相机姿态就能驱动多视角视频的同步生成。这与此前主流方法(如 Diffuman4D 依赖 SMPL 骨架、MV-Performer 依赖深度和法线渲染)形成鲜明对比。
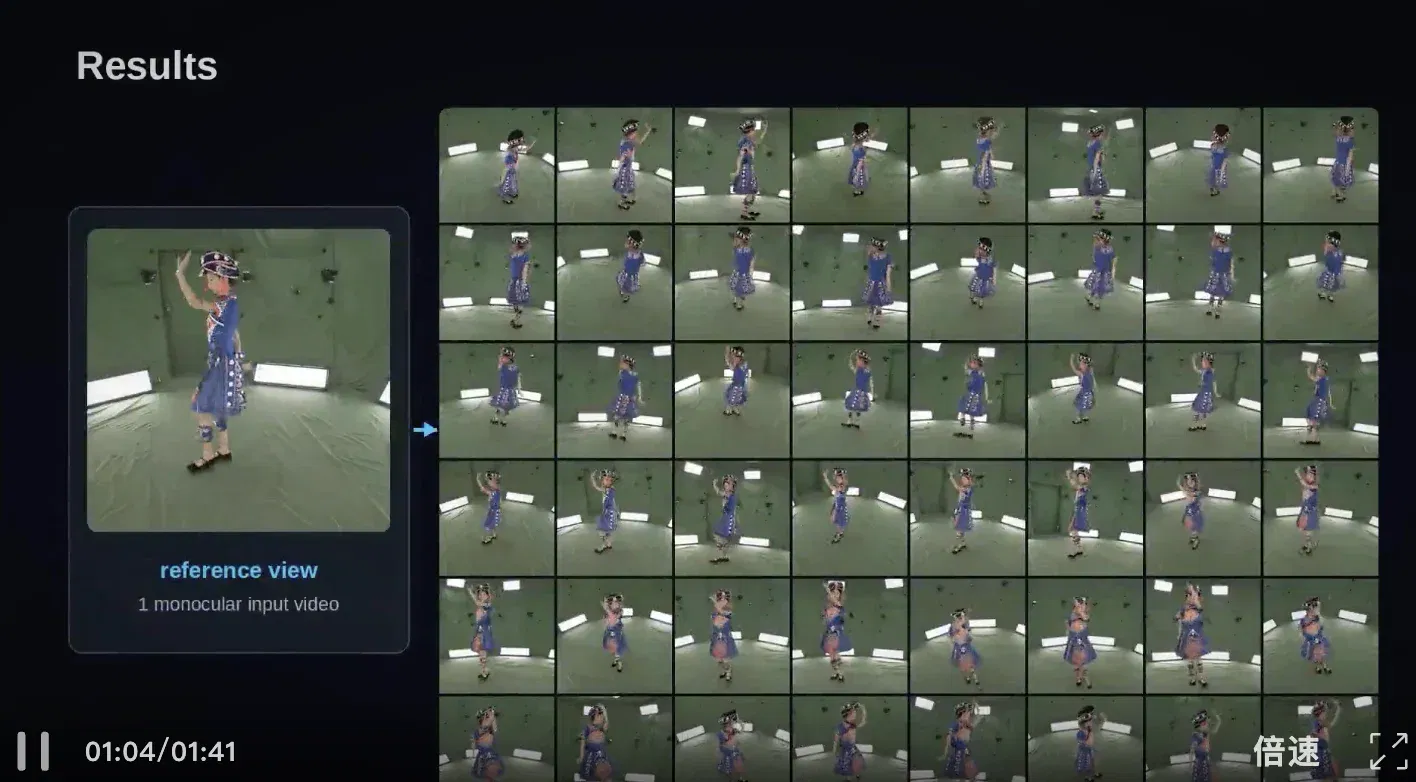
给定一段单目参考视频和目标相机姿态,模型直接输出在时间上同步、视角上一致的多视角视频序列;再将这些多视角视频送入 FreeTimeGS 重建管线,即可得到动态 4D 高斯表示(4D Gaussian Splats)。
这套流程将视频扩散模型的强大外观先验与 4D 高斯的高效渲染能力结合起来,使得从一段跳舞视频或行走视频出发,可以将其中的人物「升维」为完整的动态 4D 资产,再合成进任意 3D 场景。这对于数字内容创作、虚拟制片和 AR/VR 应用具有直接价值。
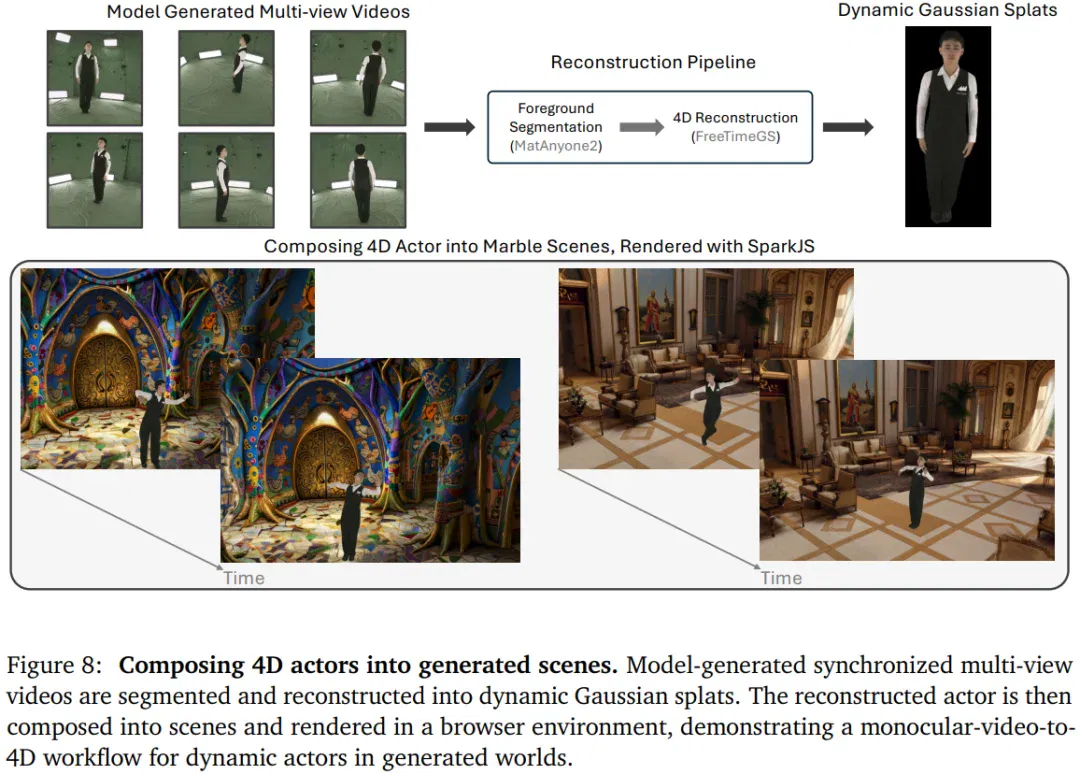
论文还验证了方法超出人体的泛化性:同一个模型经过少量微调后,可以推广到多物种动物的多视角生成,在跨物种零样本测试中仍保持较强性能,表明方法的核心设计不依赖人体特有的几何假设。
论文在 DNA-Rendering 和 ActorsHQ 两个基准上进行了评测。与同样基于单目参考视频的 Diffuman4D-mono-skeleton 相比,Flex4DHuman 在 DNA-Rendering 上 PSNR 提升约 9.3 dB;在零样本的 ActorsHQ 测试集上,PSNR 也高出对手约 3.4 dB。
从更宏观的视角来看,Flex4DHuman 代表了「2D 视频数据赋能 3D 世界建模」这一技术路线的一个典型样本。手机视频是人类日常生产最多的数据形式,如果能够高效地从中提取四维信息,将极大扩展 3D 世界模型的训练数据来源。
联创 Christoph Lassner 宣布离职
就在三篇论文发布的同一天,World Labs 联合创始人Christoph Lassner在 X 平台发帖,宣布自己将离开公司,开启下一段旅程。
Lassner 是 World Labs 四位联合创始人之一,另外三位分别是李飞飞、Justin Johnson 和 Ben Mildenhall。他长期从事计算机视觉与计算机图形学交叉领域的研究,专注于从 2D 图像和视频中恢复可用的三维内容。
在加入 World Labs 之前,Lassner 的职业轨迹覆盖了多个行业前沿。他曾在初创公司 Bodylabs 工作,该公司后被亚马逊收购,专注于基于图像的三维人体建模;在亚马逊期间,他主导开发了 Amazon Halo 智能手环的三维体型估算系统,用户仅需手机自拍,即可获得精确的三维身材模型。此后,他先后在 Meta Reality Labs Research 和 Epic Games 主持研究团队,深耕神经渲染和 NeRF(神经辐射场)相关技术,2022 年 Meta Connect 大会上展示的实时辐射场渲染演示,正是他所在团队的成果之一。他还开发了 Pulsar 渲染器,一种基于球体基元的可微分渲染器,后来成为 PyTorch3D 的后端组件之一,在学术界得到广泛应用。
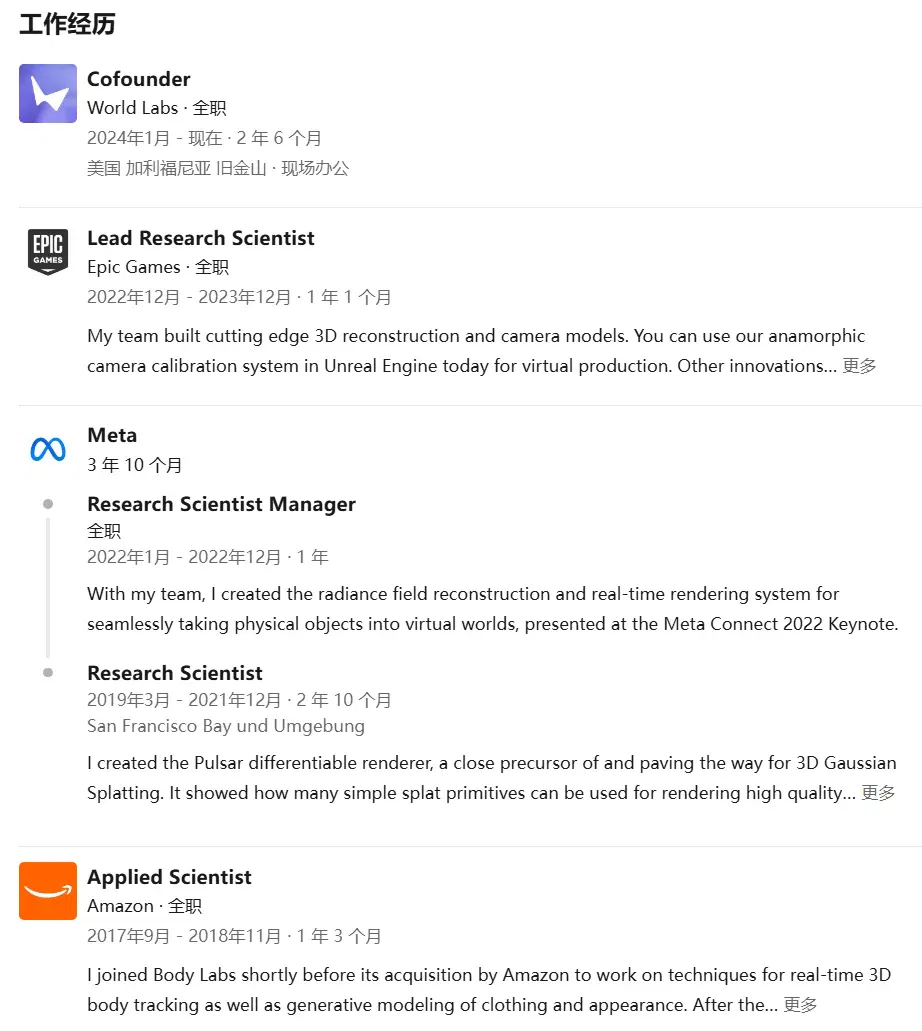
Lassner 于 2024 年初与李飞飞等人共同创立 World Labs。公司于同年 9 月从隐身状态中走出,以约 10 亿美元估值完成 2.3 亿美元融资,投资方包括 NVIDIA、AMD、Adobe 和 Databricks 旗下风险投资机构。2026 年 2 月,World Labs 完成了由 Autodesk 领投的 10 亿美元新一轮融资,估值跃升至约 50 亿美元。
三篇论文的致谢列表中均出现了 Lassner 的名字,这意味着他在职期间积极参与了这些实习研究项目。
对于离职的原因,Lassner 在公开声明中做了坦诚的说明:过去几个月里,他经历了数起个人事故,其中包括一次造成多处骨折和脑震荡的意外,目前仍在恢复中。这段强制休息的时间让他有机会重新审视自己的处境,并做出了退出日常运营职务的决定。他同时表示,将继续以顾问身份支持公司,并对李飞飞、Justin Johnson 和 Ben Mildenhall 在这一决定过程中给予的理解和支持表达了感谢。
在向公司内部团队发送的信件中,Lassner 写道,他「深信 World Labs 以及我们正在构建的事业的重要性」,公司目前所处的强劲位置让他确信此刻是交棒的合适时机。他表示,自己下一步的计划尚不明确,但「对即将到来的事感到兴奋」。
结语
三篇论文同日亮相,对 World Labs 而言是一个值得记录的时间节点。这家公司自 2024 年创立以来,主要以技术博客和产品的形式与公众见面:Marble 世界模型的内测与公测、World API 的开放、Spark 2.0……而这次是公司首次以 arXiv 预印本形式正式发表学术论文。
这次的集体亮相,联合创始人 Justin Johnson 在 X 上的评论或许最能说明其背景意涵:「3D 是一个令人兴奋的领域,我们仍在摸索正确的任务定义、问题形式、模型架构,以及最佳的扩展方式。我们在这里分享一些想法,由一批出色的实习生主导完成。」
语气谦逊,但方向很清晰:World Labs 正在将「空间智能」的研究路线推向更深处,并愿意在这一过程中与学术社区分享自己的思考。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战 (opens in a new tab)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。