一周3.3k star,微软开启Skills自我进化!像训练神经网络一样训练技能
从大模型的提示词到智能体的 Skills,看着进化了,但又没有完全进化。
从大模型的提示词到智能体的 Skills,看着进化了,但又没有完全进化。
在智能体应用中,越来越多的程序员开始花大量时间写 CLAUDE.md、Codex 的 skill 文件、各种 Agent 的 system prompt。
手写这些技能文档,本质上是一种试错的手工活。写一版,跑几个任务看看效果,觉得哪里不对再改,改完再跑。这个过程和之前手调 prompt 没有本质区别,只是对象从一句话变成了一整份文档。
这件事其实挺荒诞,我们本来是想让更智能的 AI 帮我们干活的,结果现在反过来,我们在花大量精力教 AI 怎么干活。
这个问题似乎迎来了终点,微软在本周开源了 SkillOpt,一个把 Agent 技能文档当作「可训练参数」的文本空间优化框架,让技能文档自我进化。
- 官网链接:https://microsoft.github.io/SkillOpt/#idea
- Github 链接:https://github.com/microsoft/SkillOpt
- 论文链接:https://arxiv.org/abs/2605.23904
核心思路很简单,不训练模型权重,只训练那份指导 Agent 行为的自然语言文档。在 7 个目标模型、6 个基准测试、3 种执行环境(直接对话、Codex、Claude Code)的全部 52 个评测组合中,SkillOpt 训练出的技能文档全部达到最优或并列最优。
Skills 也能优化训练
SkillOpt 的核心洞察可以用一句话概括:Agent 的技能文档就是它的「外部权重」,既然内部权重可以用梯度下降来优化,外部权重也应该有一套系统化的训练方法。
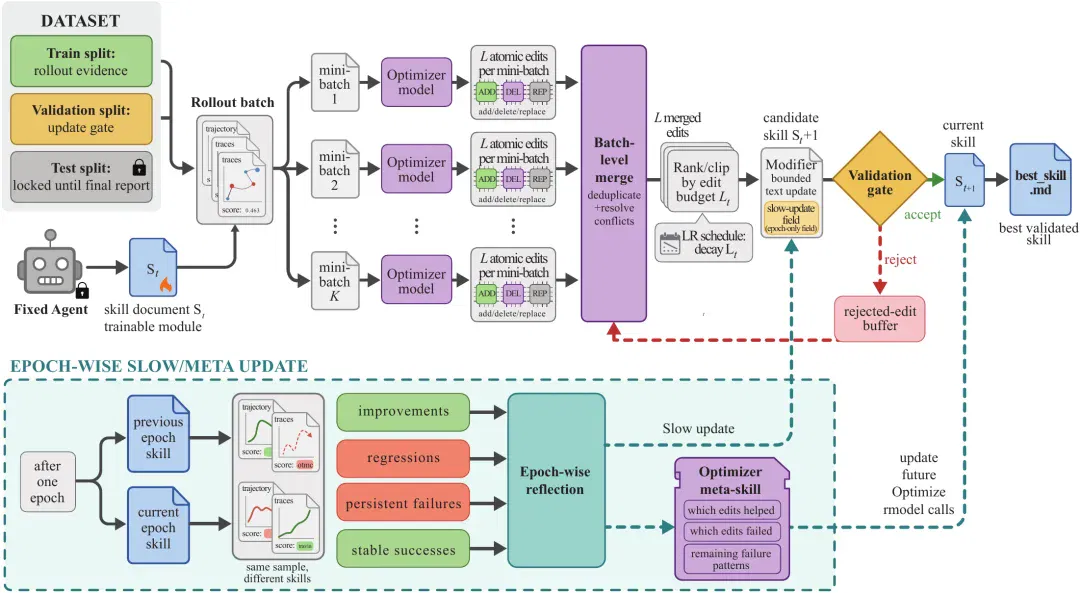
SkillOpt 流程。冻结的目标模型使用当前技能执行;优化器模型提出有界的修改;保留的验证决定候选是否成为新的当前技能。
训练循环:前向传播、反向传播、参数更新
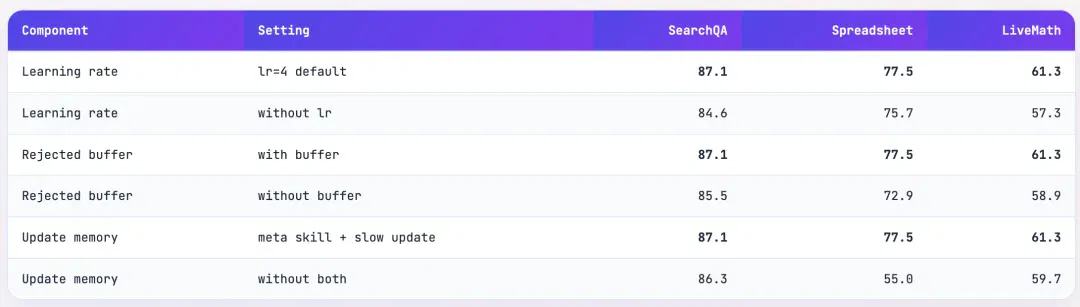
传统深度学习的训练循环是:前向传播算 loss,反向传播算梯度,用梯度更新权重。SkillOpt 把同样的逻辑搬到了文本空间:
- Rollout(前向传播):冻结的目标模型拿着当前版本的技能文档去执行一批任务,记录完整的执行轨迹,包括消息、工具调用、验证反馈、最终得分。这一步产出的是「证据」,相当于神经网络的前向传播结果。
- Reflect(反向传播):一个独立的优化器模型分析这批执行轨迹。关键设计是,失败案例和成功案例被分开反思。失败的 minibatch 用来发现「哪些操作规则需要修正」,成功的 minibatch 用来确认「哪些现有规则在起作用,不能动」。这一步相当于计算「文本空间的梯度」,告诉系统技能文档该往哪个方向改。
- Edit(参数更新):优化器模型基于反思结果,提出对技能文档的结构化编辑操作:添加新规则(add)、删除失效规则(delete)、替换需要修正的规则(replace)。
- Gate(验证门控):候选的新技能文档必须在一个 held-out 的验证集上跑一遍,只有性能严格提升时才被接受。这一步防止过拟合,确保每次更新都是真正的改进。
整个循环跑多个 epoch,每个 epoch 内跑多个 step,和训练神经网络的节奏完全一致。
文本学习率:防止灾难性遗忘
训练神经网络时,学习率太大会导致灾难性遗忘,模型学了新东西就忘了旧东西。SkillOpt 在文本空间遇到了完全相同的问题:如果一次编辑改动太大,可能把之前学到的有效规则覆盖掉。
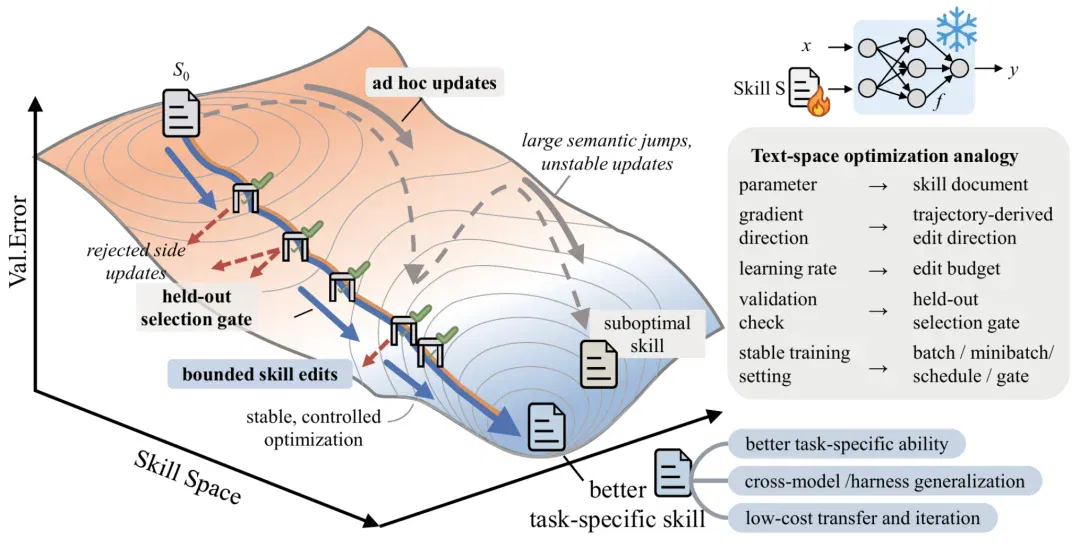
解决方案是引入「文本学习率」(textual learning rate):每一步允许的编辑操作数量有上限。论文中默认设置为 lr=4,即每步最多 4 个 add/delete/replace 操作。这个约束迫使优化器每次只做小幅调整,保持训练稳定性。
消融实验验证了这个设计的必要性:去掉学习率约束后,SearchQA 上的性能从 87.1% 降到 84.6%,SpreadsheetBench 从 77.5% 降到 75.7%,LiveMath 从 61.3% 降到 57.3%。
被拒绝编辑的缓冲区:负反馈记忆
另一个精巧的设计是 rejected-edit buffer。当一个编辑提案被验证门控拒绝时,它不会被简单丢弃,而是进入一个缓冲区。优化器在后续的反思阶段可以看到这些「失败的尝试」,从而避免重复提出类似的无效编辑。
这相当于给优化器提供了负梯度信息:不仅知道该往哪走,还知道哪些方向已经试过了走不通。
消融实验同样证实了它的价值:去掉 rejected buffer 后,SpreadsheetBench 从 77.5% 骤降到 72.9%。
慢更新与元技能:长期记忆机制
SkillOpt 还引入了两个跨 epoch 的记忆机制:
- Slow Update:每个 epoch 结束时,对整个 epoch 内所有被接受的编辑做一次纵向对比分析,找出跨 step 的一致性模式,产出一次更大范围的更新。这类似于深度学习中的学习率 warmup 或周期性大步更新。
- Meta Skill:优化器自身也有一份「元技能」文档,记录它在优化过程中积累的经验(比如「对这个 benchmark,关注工具调用的格式比关注推理步骤更有效」)。这份元技能在 epoch 间持续更新,让优化器本身也在进化。
关键的是,这两个机制只在训练时存在。部署时,目标模型只需要那份最终的 best_skill.md,不需要任何额外的模型调用或记忆模块。推理时的开销为零。
52 项评测全面领先
主实验:7 个模型 × 6 个基准 × 3 种环境
SkillOpt 的评测覆盖面相当全面:
目标模型包括 GPT-5.5、GPT-5.4、GPT-5.4-mini、GPT-5.4-nano、GPT-5.2、Qwen3.5-4B、Qwen3.6-35B-A3B,从最强的闭源模型到 4B 参数的小模型都有。
基准测试覆盖 6 个不同类型的任务:SearchQA(问答)、SpreadsheetBench(代码生成 / 电子表格操作)、OfficeQA(工具增强问答)、DocVQA(文档视觉问答)、LiveMathematicianBench(数学推理)、ALFWorld(具身智能体)。
执行环境包括直接对话、OpenAI Codex、Anthropic Claude Code 三种主流的 Agent 执行框架。
在全部 52 个(模型 × 基准 × 环境)评测组合中,SkillOpt 达到最优或并列最优。
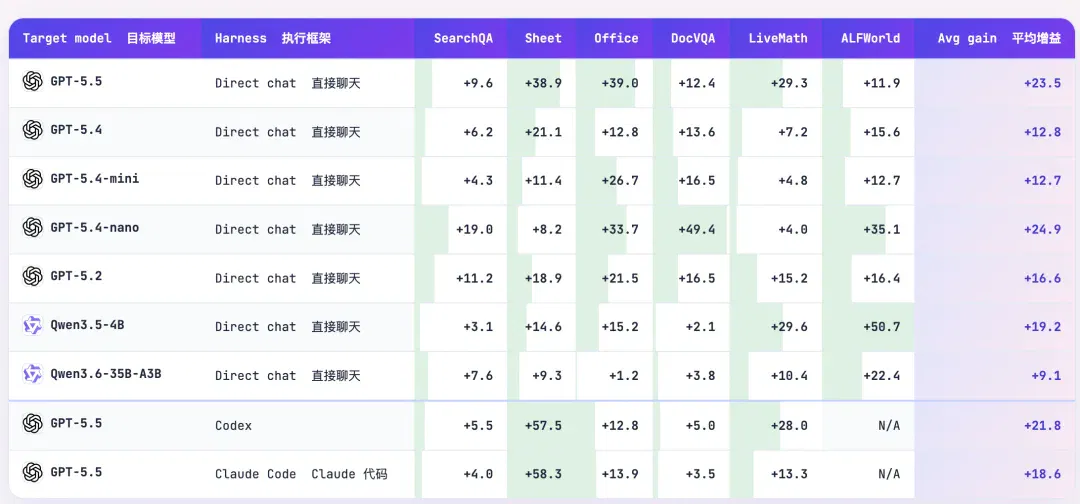
几个亮点数据:
- GPT-5.5 直接对话模式:平均提升 + 23.5 分,其中 SpreadsheetBench 提升 38.9 分,OfficeQA 提升 39.0 分
- GPT-5.4-nano(最小模型):平均提升 + 24.9 分,DocVQA 提升 49.4 分,ALFWorld 提升 35.1 分
- GPT-5.5 + Codex 环境:SpreadsheetBench 提升 57.5 分
- GPT-5.5 + Claude Code 环境:SpreadsheetBench 提升 58.3 分
小模型的提升幅度反而更大,这说明技能文档对能力较弱的模型帮助更显著。一份好的操作手册,对新手的价值远大于对专家的价值,这个直觉在 AI Agent 上同样成立。
对比实验:碾压所有基线方法
SkillOpt 对比了 6 种基线方法:无技能(no skill)、人工编写技能(human skill)、LLM 一次性生成技能(LLM skill)、Trace2Skill、TextGrad、GEPA。
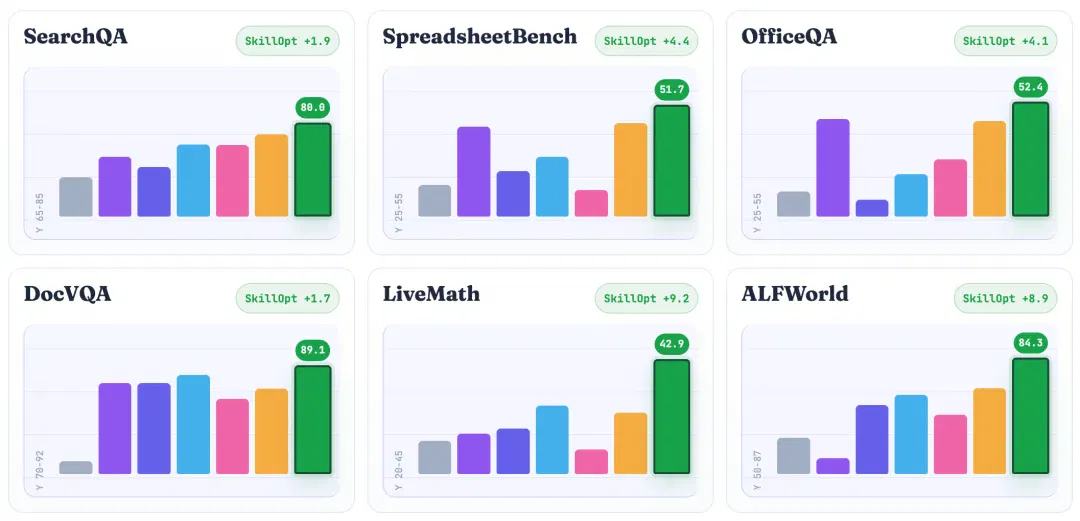
在每一个 benchmark 上,SkillOpt 都超过了最强的基线方法:
- SearchQA:超过最强基线 + 1.9 分
- SpreadsheetBench:超过最强基线 + 4.4 分
- OfficeQA:超过最强基线 + 4.1 分
- DocVQA:超过最强基线 + 1.7 分
- LiveMath:超过最强基线 + 9.2 分
- ALFWorld:超过最强基线 + 8.9 分
值得注意的是,TextGrad 和 GEPA 都是已有的文本优化方法,SkillOpt 对它们的优势说明,系统化的训练循环设计(学习率、验证门控、负反馈缓冲)确实比松散的自我修正更有效。
迁移实验:一次训练,多处部署
SkillOpt 训练出的技能文档表现出很强的迁移能力:
- 跨模型迁移:在 GPT-5.4 上训练的 LiveMath 技能,直接迁移到 GPT-5.4-nano 上使用,提升 15.2 分。不需要针对小模型重新训练。
- 跨环境迁移:在 Codex 环境中训练的 SpreadsheetBench 技能,直接迁移到 Claude Code 环境中使用,提升 31.8 分。这意味着你在一个 Agent 框架里优化好的技能文档,换到另一个框架里依然有效。
- 自优化:即使用 GPT-5.4-nano 同时作为目标模型和优化器模型(自己优化自己),SpreadsheetBench 上仍然提升了 10.4 分。这说明 SkillOpt 的训练循环本身提供了足够的结构化约束,即使优化器不比目标模型更强,也能发现有效的改进方向。
- 部署极简:最终部署时只需要一个 best_skill.md 文件。不需要优化器模型,不需要记忆模块,不需要任何额外的推理开销。
技能进化的可视化:从失败中学习
论文中展示了一个 ALFWorld 任务上的完整训练过程,目标模型是 GPT-5.4-mini,优化器是 GPT-5.5。
初始技能文档是一份简洁的 ALFWorld 操作指南。经过 4 个训练 step 后,技能文档中新增了这些规则:
- 「将任何通用的目标容器实例视为有效」
- 「维护一个严格编号的已搜索集合,不重复检查已观察过的位置」
- 「在某一类位置连续多次未命中后,扩大搜索范围」
这些规则都是从失败轨迹中自动提炼出来的。比如第三条,来自 Agent 在某些任务中反复搜索同一类位置却找不到目标物品的失败经验。优化器观察到这个模式后,提出了「扩大搜索范围」的规则。
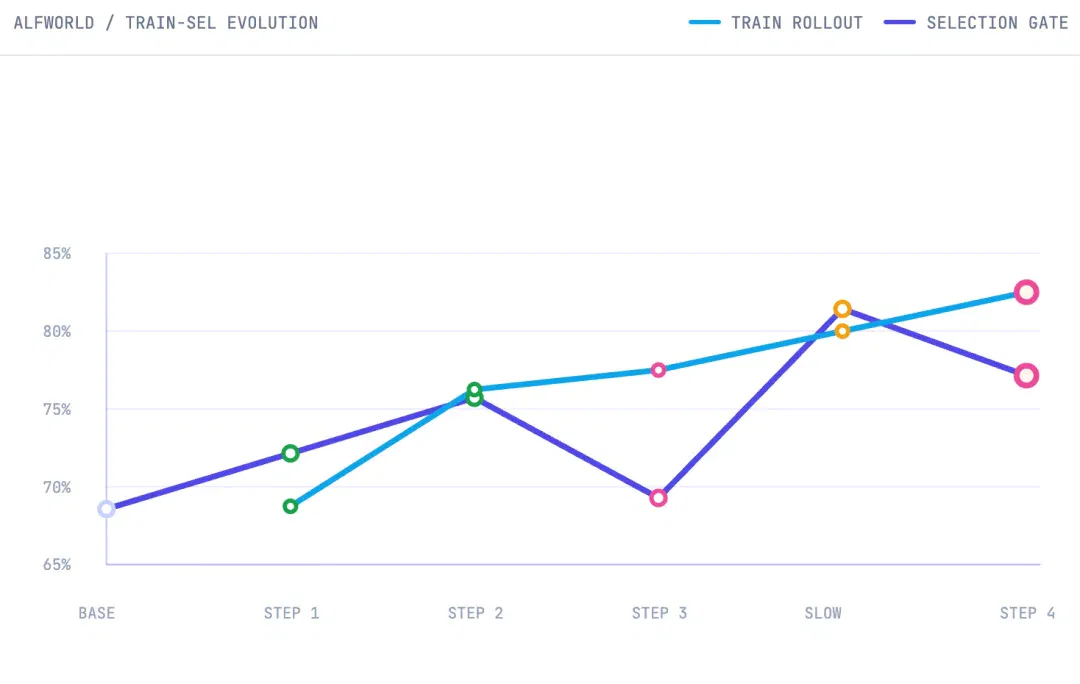
最终效果:ALFWorld 测试集的 hard 难度从 70.9% 提升到 85.8%。
整个过程中,Step 3 的编辑一度导致验证集性能下降,但被 slow update 机制救回。Step 4 的训练集得分更高,但验证集没有提升,因此被门控拒绝。这种「提出假设、验证、接受或拒绝」的循环,和人类科研的方法论如出一辙。
SkillOpt 告诉我们,智能体的一切都是可以自我学习的。
人类在 AI 工作流中的角色又往后退了一步。未来,我们会把更多的认知负担转移给机器。
文章来自于"机器之心",作者 "机器之心编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
开源「提示语管理.skill」,就为快速选出最适合你的Prompt(附25个深度思考提示语) (opens in a new tab)
今年我攒了一堆思考类的提示语。 满满25个,有经典的苏格拉底式提问、第一性原理和对抗性审查、双向钢人论证,Anthropic哲学家的寓言记忆法,条条都好用。一般来说我有两条路来存提示语,方法一把有用的点拆出来放到Agent.md,这样可以全局生效但是真存不了太多,塞多了模型就开始阿巴阿巴了。方法二就是存到备忘录,然后用快捷键唤醒复制粘贴,缺点就是贴到对话框之后还要删删改改的。 这个问题困扰了我蛮久的。 问题不在存储,每次都是到了要用的那一秒,我根本就没有想起来自己存过什么,还是要打开备份重新过一遍。要不就是发出去了才想起来,早知道加上某个提示语就不会聊成这样了。 转折发生在我用Matt Poc
晕…这年头还有说人话的AI不 (opens in a new tab)
不er,只有我一个人看不懂AI现在的说话方式了吗?
我给 codex 装的最有用的 skill,是反过来盘我的 (opens in a new tab)
装完 codex,很多人在输入框里敲的第一句话是这样的:帮我做个 XX 网站。
几千人催我蒸馏的X冷启动Skill,开源了! (opens in a new tab)
大家好,我是袋鼠帝 几天前我尝试做了一个相对粗糙的视频,是关于我开源的仓颉Skill的 没想到居然爆火了!(全网将近50万播放)。
电报体 Skill:号称省 65% Token,实测只有 8.5% (opens in a new tab)
我把那种号称能省 Token、要求 AI 尽量少说话的 Skill,叫做“电报体 Skill”。