发现了个宝藏 AI 算力平台TokenLX ,内置 190+ 模型!
最近和几个做 AI 出海的朋友聊天,大家已经很少去聊哪个模型又刷了榜。谈论最多的,是哪个模型调度平台好用、实惠、安全。 这话题我是一点都不意外。毕竟前不久全球大佬都在扎堆往 AI 这个方向挤。老话说得
最近和几个做 AI 出海的朋友聊天,大家已经很少去聊哪个模型又刷了榜。谈论最多的,是哪个模型调度平台好用、实惠、安全。
这话题我是一点都不意外。毕竟前不久全球大佬都在扎堆往 AI 这个方向挤。老话说得好:无利不起早。
但市场目前的状态用鱼龙混杂来形容都算温和。不少三方中转站都会来一手“狸猫换太子”,不仅如此,还有数据被窃取的风险。
所以懂出海和 AI 的正规军在什么时候入场,成了大家一直在等的事。
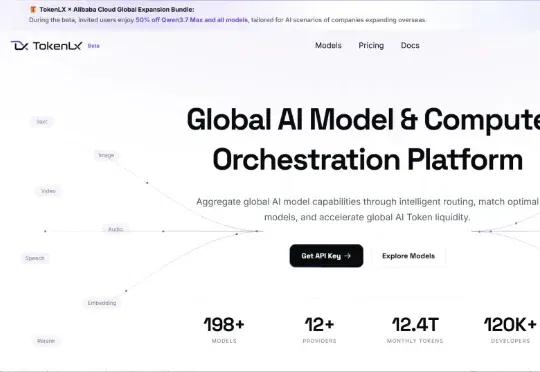
今天看到一个叫 TokenLX 的平台想干这件事。简单来说,它是一个专门帮做出海业务的公司和开发者,把用 AI 这件事变得简单、省钱,且安全。
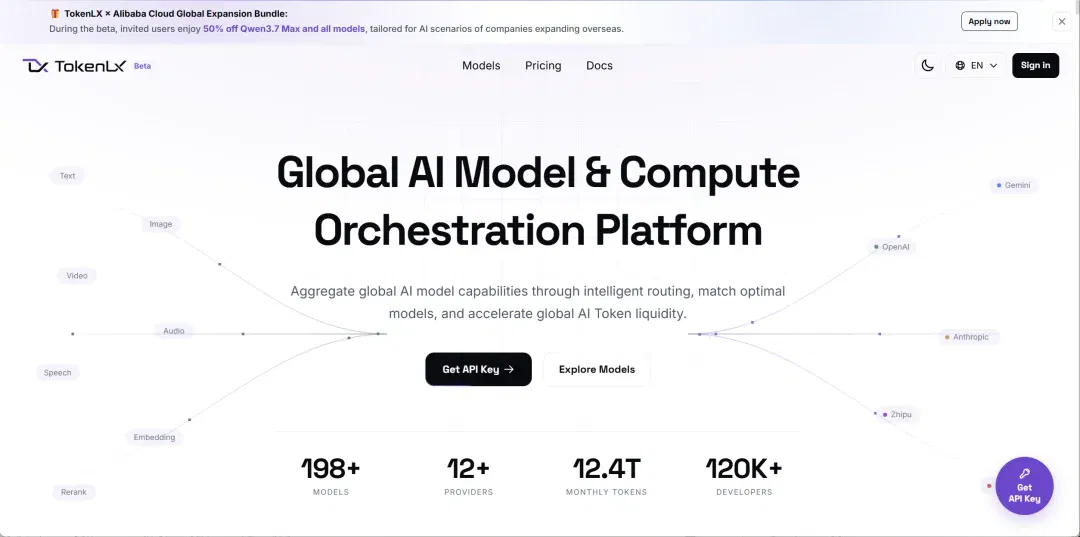
tokenlx.ai
改两行代码,把全球模型收进一个口袋
对于开发团队来说,最怕的就是无意义的折腾。今天为了多模态能力去看新的接口文档,明天为了省钱又去重构底层的调用逻辑,每多接一家,系统的稳定性就多一层隐患。
TokenLX 做的第一件事,是把11 家供应商的 190 多个模型(涵盖文本、图像、视频、音频等 7 种模态),全部统一到了一个入口。
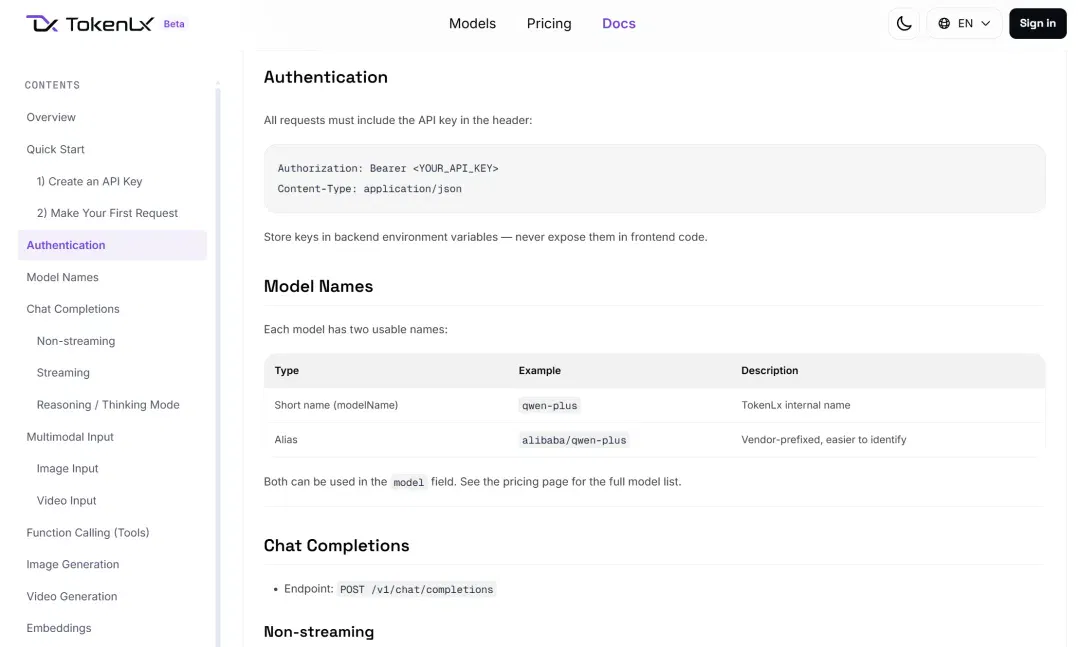
看他们的开发者文档,接入方式很统一。如果你原本用的是标准的 OpenAI SDK,你不需要改变任何核心业务逻辑。
第二,上游某家大模型如果出现网络波动或者服务故障,TokenLX 的分布式多供应商基础设施会自动切换到其他健康的通道,整个过程无缝衔接。你不需要再去记几十个平台的密钥,也省去了在后台写复杂的容灾切换逻辑。
第三,TokenLX 同时提供智能路由引擎:就是根据任务复杂度、上下文长度、输出要求,自动匹配最适合的模型,根据动态策略来指派给便宜轻量还是复杂推理模型响应,做到最经济的Token方案。
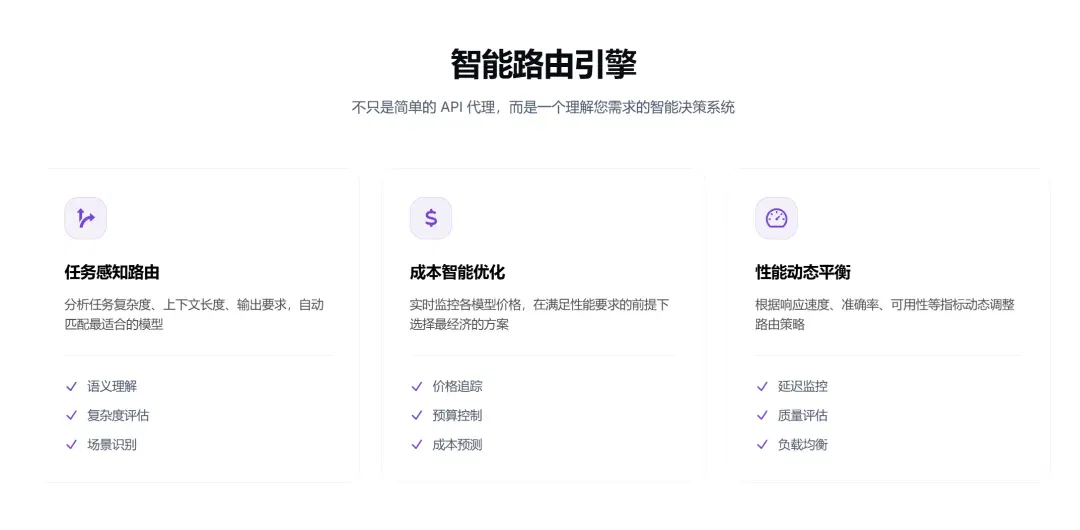
TokenLX 还会有啥黑科技
如果 TokenLX 仅限于此,可能还不值得我写这篇文章。看了下这个平台背后是易点天下,国内头部的出海数字营销平台。他们内部有一套自研 Token 预算降本法。
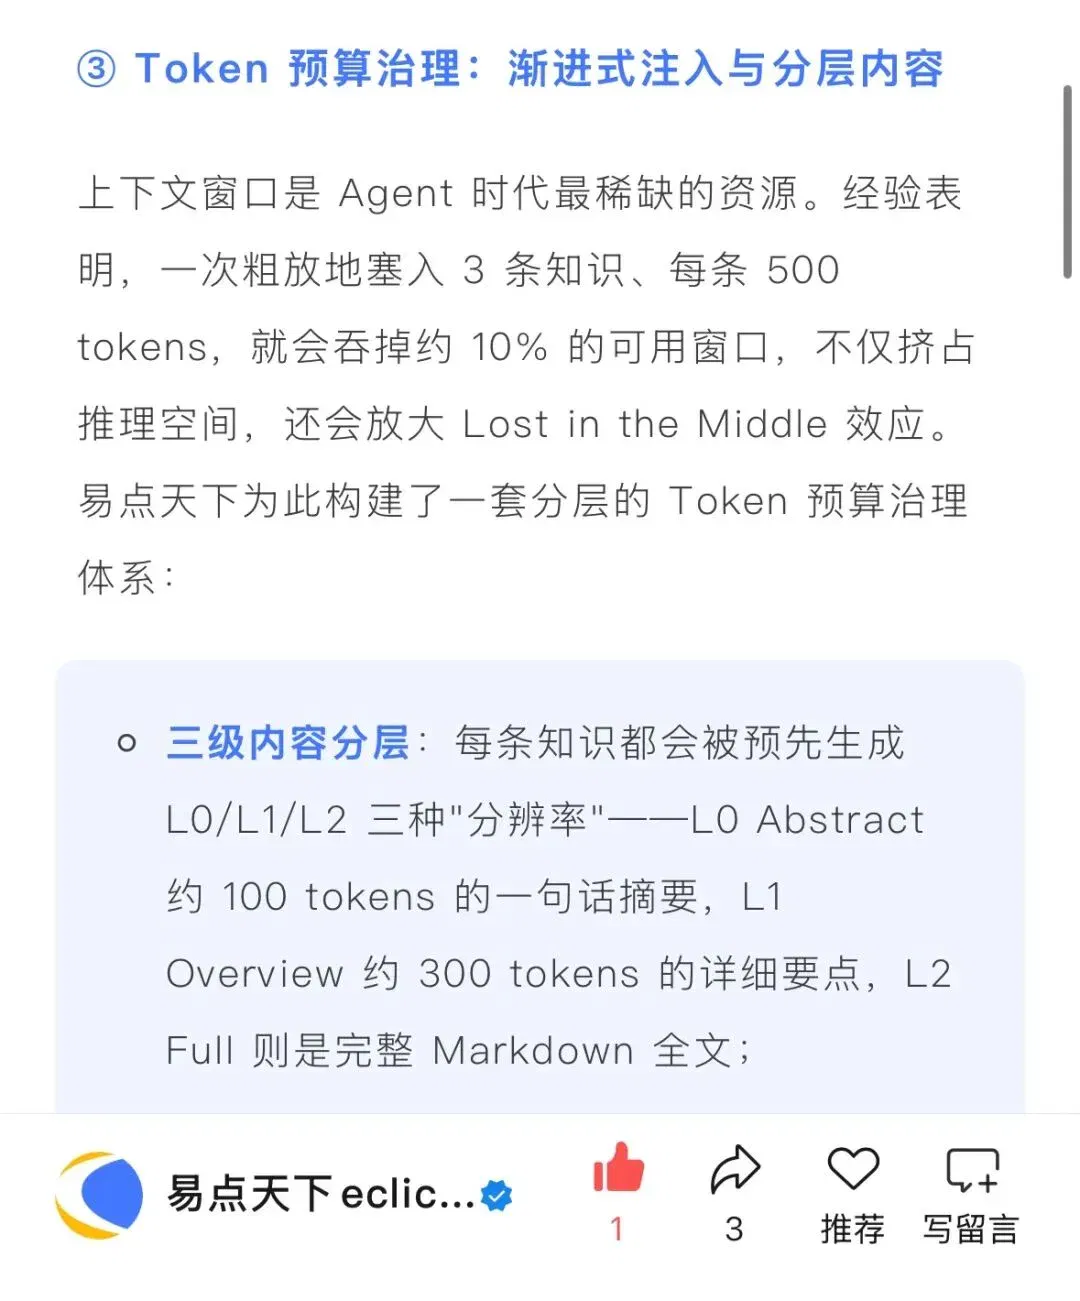
根据他们的技术分享,内部 Agent 经过六层上下文体系、渐进式注入与分层内容,单次注入的 Token 消耗可以下降约 80%,不知道在测试过程中会不会应用起来。
他们技术分享的完整工程体系是这样的:
1、意图判断与动态压缩:系统设计了一条六层上下文体系的信息管线进行动态压缩,让 Agent 在长期任务中既能记住关键线索,又能有效过滤噪音。
2、主动注入与记忆检索:系统在 Agent 生命周期的关键节点内置三类钩子,根据用户意图自动检索相关记忆并分层注入,避免 Agent 重复踩坑。
3、渐进式工具加载:Agent 并不需要把几十个工具说明全部背在身上。它先带着核心描述运行,需要时再动态唤醒对应工具,又省下了大把用来理解工具定义的 Token 费用。
最终的表现是,重复性问题的处理时间大大缩短,最重要的是月底的算力账单也比之前少得多。
在它的底层防御架构里,Agent 只负责处理它擅长的判断,而白名单准入、资源限额、敏感操作的人工审批(HITL),全部由严谨的规则代码在底层进行物理兜底。
这些能力是否有机会平移到 TokenLX 上,这也是它区别于普通模型聚合站最值得关注的地方。尤其是有出海需求的企业。
写在最后
总而言之,它是一个有自己独家功能的 AI 算力调度平台,是给出海企业、开发者准备的基础设施。
试用资格需要申请,我会长期关注它的功能迭代进展。如果你去它的官网看,能看到清晰的模型价格和接入文档,也可以直接提交试用申请。
目前内测期间,受邀用户专享 Qwen3.7 Max 及全系模型限时五折。
文章来自于微信公众号 "莫理",作者 "莫理"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
元气森林创始人投的AI云厂商,冲刺IPO! (opens in a new tab)
靠盘活4600个节点,做到“中国第一”。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。