在回北京的火车上,我看完了姚顺宇的 AI 播客,大为震撼
一周前,张小珺录了一期和姚顺宇的播客。 姚顺宇,28 岁,清华物理系特奖出身,斯坦福物理博士。本科做凝聚态理论(给开放量子系统建过一套描述框架),博士又跨去做高能理论物理,觉得领域里「老登」太多,于是在 2024 年 9 月转去做 AI,加入 Anthropic 干 Claude。 一年后跳槽 Google DeepMind,直接参与了 Gemini 3 Deep Think 这个模型的研发。 这期 4 小时播客里大部分判断,都来自他自己的一线实际工作经验和自己非常独特、独立的思考。 这期节目我一直没找到完整时间听,4 小时太长了。 直到前天我去外地办事,回来的时候赶上了一班晚上 12 点回北
一周前,张小珺录了一期和姚顺宇的播客。
姚顺宇,28 岁,清华物理系特奖出身,斯坦福物理博士。本科做凝聚态理论(给开放量子系统建过一套描述框架),博士又跨去做高能理论物理,觉得领域里「老登」太多,于是在 2024 年 9 月转去做 AI,加入 Anthropic 干 Claude。
一年后跳槽 Google DeepMind,直接参与了 Gemini 3 Deep Think 这个模型的研发。
这期 4 小时播客里大部分判断,都来自他自己的一线实际工作经验和自己非常独特、独立的思考。
这期节目我一直没找到完整时间听,4 小时太长了。
直到前天我去外地办事,回来的时候赶上了一班晚上 12 点回北京的火车。车厢里很安静,大家睡的四仰八叉,我戴上耳机,从头听到了尾。
中间几乎每 10 分钟就要一个亮点。
姚顺宇这个人讲话非常直给,很多事情他几乎是用一种白话的口气,就把行业里大家「心照不宣」的部分点破了。这也是我目前在国内看到的播客内容里,首次有种「原来我们也有这么有独立想法和思考的人」。
我边听边在备忘录里记,下了火车整理出13 个值得关注的点,分享给大家。
1. 预训练这条路,根本没有走到头,还充满无穷的想象力
外面这两年一直有个声音:「预训练撞墙了,Scaling Law 不灵了」,几乎成了行业共识。最有名的一次背书是 2024 年 12 月,Ilya 在 NeurIPS 上公开宣布「预训练即将终结」,把数据比作 AI 的「化石燃料」,说人类已经撞到了「peak data」。
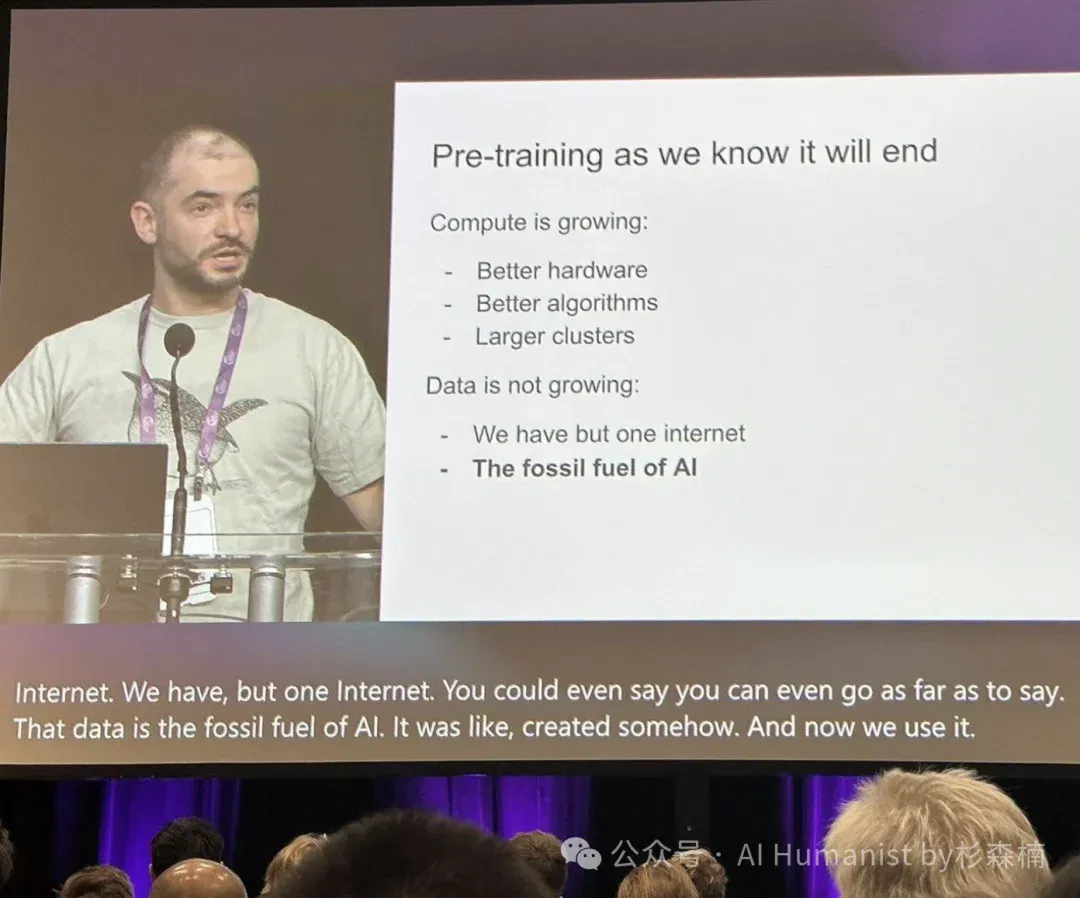
这话一出,全行业疯狂转引,所有人都开始把后训练和强化学习当成下一根「金条」。
但姚顺宇直接说没有,未来 4 个月也看不到撞墙的迹象。这让我感觉很欣慰,因为,无论对于不对,总该有些独立的声音出来。
他说一个人觉得规律到头无非三种可能,一是适用范围真的到头,二是某个条件不满足(比如数据不够),三是:「其实他这个工作哪里有一个 bug,他自己没发现。」
他的判断是,绝大多数撞到墙的人,是因为第三种。bug 没修,就以为是规律不灵了。
外面流行的叙事是「金矿快挖完了,所以大家都转去做后训练」。但在 Anthropic、Google、OpenAI 这种内部,预训练在过去几个月反而越来越强。其次,这御三家在「修补 Bug」上有着成体系的机制,所以这加速了预训练。
一线研究员和外界的认知,差出一整个量级。
2. Scaling Law,是经验规律不是科学规律
这个点我以前没仔细想过,听完真的愣了几秒。
经验规律就是我观察了一堆数据,总结出一条公式,但我并不知道为什么是这条公式。科学规律是我能解释清楚它的微观机制,知道它为什么成立、什么时候会失效。
姚顺宇举的例子是:「热力学第一定律、第二定律,在当年被发现的时候,也都是经验规律。后来随着时间发展,我们慢慢知道了它的微观机制,它才慢慢变成了科学规律。」
也就是说,今天我们用的 Scaling Law,相当于 18 世纪的热力学。它能用,它能预测,但它的微观机制至今没人完全说清楚。
整个 AI 行业,底层是建立在一堆「我们也不知道为什么会这样」的经验上的。这跟普通人想象中的「精密、严谨、有完整理论支撑」的 AI,差得很远。
3. AI 研究员,其实是在摸黑走路,「信念」史无前例的重要。
张小珺问姚顺宇:你们怎么处理 bug?
姚顺宇的回答让我印象很深 ——
「我感觉这更像是一个信念的问题。当你遇到一个 bug 觉得它不能解除,你就会说这个到头了。当你遇到一个 bug 觉得这个肯定可以解决,你就觉得这还没到头。」
「信念」。
一个搞前沿科学的人用这个词,我是没想到的。
我以前以为大模型训练,至少在 OpenAI、Anthropic、Google 这种地方,是一种「按部就班的工程过程」。听完才发现完全不是这么回事。前沿研究员每天面对的,是一堆没人见过的现象、一堆解释不清的实验结果,每一步都得自己判断这是 bug 还是规律本身的边界。
判断错了,可能整个项目方向都跑偏。判断对了,可能再往前推一大步。
外面看着光鲜,里面是很黑的。一群非常聪明的人,靠经验、靠直觉、靠信念,在一片没有路标的地方往前摸索。
4. 不能为了让自己看起来牛逼,就牺牲全局
姚顺宇原话是 ——
「AI 这个事儿本来也不太需要脑子,真的不太需要脑子。需要什么?我觉得这个行业最重要的特质就是靠谱。就是做事细,然后对自己做的事负责任。」
一个 Google DeepMind 一线研究员公开说自己这行「不需要脑子」。这话搁国内 AI 圈,几乎不会有人敢这么讲。
他的逻辑是 AI 是个巨大的系统,预训练、后训练、数据、infra、评估,每一环都有大量细节。一个研究员只盯自己手上的指标好看,不考虑改动对全局的影响,整个系统就会出问题。
举个他给的例子:你做强化学习,做出一个算法,纸面上比别人好 1 个点。但如果你没想清楚是不是用了更多 training flops、是不是用了不一样的 data、比的是 training 指标还是加上 sampling 之后的指标,这 1 个点很可能就是假的。
所以靠谱在这里的意思是:不能为了让自己看起来牛逼,就牺牲全局。
个人英雄主义的时代已经过去了。
5. 姚顺宇 90% 的代码都是 AI 写的,普通人就不要装逼了
这一点是我笑得最大声的一段。
姚顺宇 ——
「保守估计可能 90% 的 code 是模型产生的。不保守的可能就是 99% 或者 100%。」
姚顺宇说他平时实现一个 idea,会同时开好几个 AI 帮他试不同的想法,让 AI 帮他监控实验、看结果。他自己花时间在「设计逻辑」「给模型 context」「review 输出」上。
写代码已经从「敲键盘」变成了「判断」。
90% 这个数字一线研究员说出来很轻描淡写,但放在国内的 AI 讨论里看,就显得有点割裂。😅
我现在在很多社区里看到一种风气:很多人在强烈抵制 Vibe Coding,认为 AI Coding 出来的都是大量的「屎山代码」。
兄弟,全世界一线最强的 AI 研究员,自己写的代码占比已经只有不到 10%。这是基线。
90% 对一线研究员来说就是日常,普通人写代码就别装自己是古法编程者了。
6. Anthropic 和 OpenAI 还有戏看,Coding 是血海
姚顺宇这一段是我整期听下来最兴奋的部分,他给出了一个明确的判断:Coding 这个事,注定是一个赢家通吃的市场。
两个原因。
一是,优秀程序员写代码的风格是相似的。简洁、干净、有合理抽象、结构清楚,业内有共识。AI 模型在这个赛道训练,目标比社交、推荐这种「千人千面」的产品要清晰太多。天花板很容易被卷到一起。
二是,数据来源也是相似的。GitHub 是所有公司绕不过去的训练数据池,每家公司能拿到的「燃料」差不多,剩下的拼烧法。
姚顺宇直接评论 Anthropic 和 Cursor 的关系:
「现在和 Anthropic 已经进入了一个非常微妙的关系……Cursor 试图训练自己的模型……如果在竞争中输掉的话,是比较麻烦的。因为代码这个事情,很容易出现的一个场景就是赢家通吃。」
意思已经很明白:Coding 战场不只是 Anthropic 和 OpenAI 在互掐,Cursor、字节、Google,所有人都得在这一个赛道里挤破头。
一旦决出胜者,第二名几乎没有意义。
7. Openclaw 不是大厂做不出来,是大厂不愿意做
Openclaw 火了之后,外面有一种叙事:「大厂都被一个开源小项目按在地上摩擦了」。这种叙事确实很爽,给了很多独立开发者信心。
但姚顺宇直接说没这回事 ——
「我感觉这个事情在业外的讨论好像比业内的讨论更激烈。可能在公司内部也有人已经做了类似的这种实验或者这种 demo,只是可能并没有作为一个产品去很认真的宣发。」
也就是说,大厂内部早就有 Openclaw 类似的 demo,只是没发出来。
为什么没发?一个大厂要把这种产品送到公众手里,需要解决一堆事:不能让用户为了跑这个东西,再去买台新电脑、法律风险要审清楚(模型可能拿到用户电脑的所有权限)、不能因为产品瑕疵砸了品牌、还要给它分配稳定的算力资源。
这些事对个人开发者统统不是事,「反正是个开源项目,带 bug 又如何」。但对 Google、Anthropic 这样的公司,每一条都是必须要先行解决的。
所以 Openclaw 的爆火,不算技术上的范式突破。它的意义在于给业内人展示了一种可能性,让大家看到原来可以让模型同时控制很多个不一样的子任务,做出 long horizon 级别的工作。
事实上 Openclaw 的作者后来也回到了 OpenAI。
8. 壳的命运:Cursor 没逃出去,Mid Journey 算逃出去了
国内这两年聊得最多的概念之一,就是「套壳」。AI 创业基本都从套壳开始。姚顺宇说,一个壳要想活下来,只有两条路——
「一种是逃得足够快,我增长速度足够快,以至于在模型公司反应过来的时候,我其实已经占领了大量的用户心智。另一种方式就是这市场足够的小,小到模型公司根本懒得去管。」
第一种路他点名了 Cursor。
Cursor 是 AI 原生场景里增长最快的创业公司之一,但即便是 Cursor,今天也已经没逃出 Anthropic 的引力圈。Anthropic 自己有了 Cloud Code,Cursor 又试图做自己的模型,姚顺宇用「麻烦」两个字形容它现在的处境。
第二种路他举的例子是Mid Journey。
它能活下来,恰恰是因为这个市场对大厂来说不够大、不值得花精力。「靠小活下来」。他还顺嘴提了一句 Lovart:「他们有机会」。
所以国内每一个 AI 创业者都得想清楚:自己走的到底是哪条路。
第三条不存在。
9. 蒸馏是心照不宣的事实,姚顺宇可能是第一个点破的人
蒸馏这件事,互联网上骂了几年了。但所有讨论都停留在猜测和段子的层面,没人正面承认过。所以导致大家一直争论不休。
这一直是个黑盒。姚顺宇这次直接点破了 ——
「我觉得蒸馏这个事存在是一个心照不宣的事实。但是蒸馏它也有不同的方式,就是也有硬蒸和聪明的蒸两种不一样的选择。」
什么是硬蒸?——
「最简单的例子就是我从 Claude 里面取出一堆它生成的 token,然后强行在上面做训练。如果干这样的事儿,商业上也不是很道德,治理上来说也比较愚蠢。」
什么是软蒸?——
是把别的模型当辅助、当评价者,融汇到自己的训练系统里。他说软蒸反而是技术上很有趣的事,从某种意义上中国实验室成了 multi-agent 训练的先驱。
更让人意外的是他明确提出了国内某厂商是硬蒸的,某厂商疑似硬蒸过,具体的厂商名字被消音了,我研究了一晚上口型,算是猜出来一点。大家,也可以发挥下想象力 🤔:
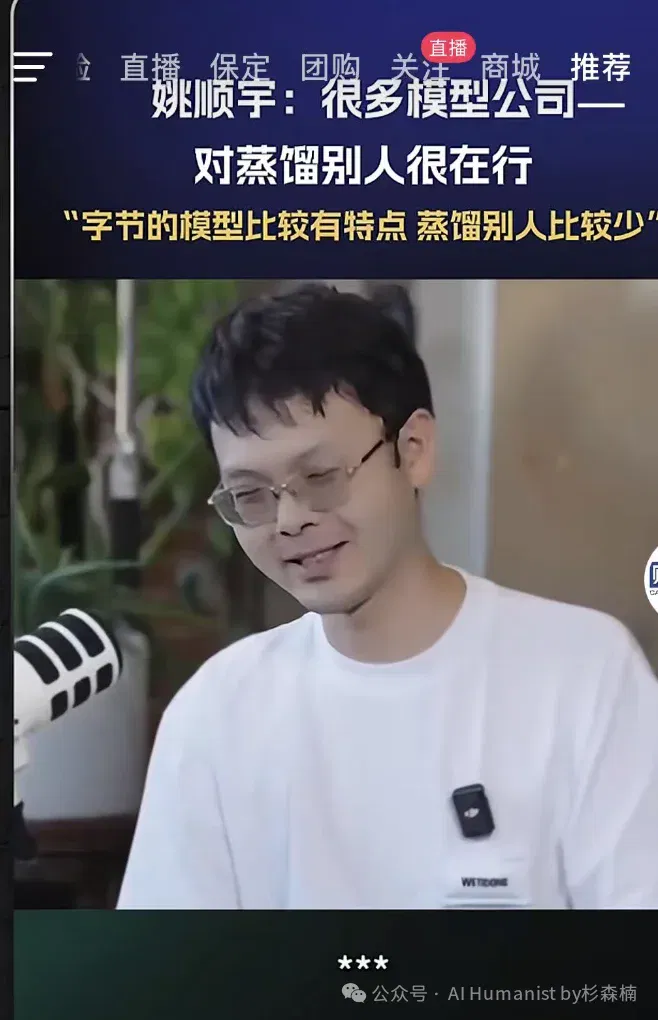
「心照不宣」四个字背后的东西,这一次终于被一个一线研究员说出来了。
10. 原来苹果是真的想研究 AI ,只是单纯的能力不够
苹果作为全球市值最大的公司,AI 战略却一直拉胯。
Siri 在发布会上喊了 N 多年,但实际能力始终被吐槽。外面解读很多,「不在乎」「在憋大招」「隐私限制」。
颇有一种「哥们只是没好好学而已」的状态。
但这回,姚顺宇给了一个很清醒的视角 ——「至于现在它是不是重视,首先我也不知道。你要让我猜,我肯定觉得是重视。但你要让我解释它为什么从外界来看没那么重视,我的唯一猜测就是,如果你外界来看就显得很重视,还做不成,那就显得很蠢。」
苹果对 AI 是重视的,只是不敢明面承认。承认了之后做不出来,就更难看了。
那为什么做不出来?
背后的关键判断在这里——Siri 助手这个产品定位,可能从一开始就笼聚不起来真正顶级的 AI 人才。顶级研究员要的是 Anthropic、Google DeepMind 那种「把模型能力推到极限」的事,是 frontier model。Siri 这种产品助手类的工作,对最顶尖的研究员没有吸引力。
可以说,苹果的真正问题,出在了人才虹吸这件事上。
11. 人形机器人,连 GPT-1 时刻都还没到
国内春晚上人形机器人扭秧歌,海外宇树、特斯拉 Optimus 整天刷屏,似乎人形机器人马上就要进入千家万户了。
姚顺宇说 ——「机器人的模型可能更多的处于 Future Engineering 的时代。一个给定的环境、给定的场景,去优化这个场景,大家是知道怎么做的。但是没有很强的泛化性。」
泛化性是指训练一个模型,让它在 A 场景里能做一件事,它能不能自动迁移到 B、C、D。语言模型今天能用,最关键就是有泛化性。
机器人完全没到这个阶段。
姚顺宇给了个类比:人形机器人现在大致相当于「Transformer 出现之前的语言模型」。连自己的 Scaling Law 都没有发现。
也就是说,整个机器人行业,连 GPT-1 时刻都还没到。
每次看到有人喊「人形机器人元年到了」,可以想想这一段。
12. 姚顺宇身上,藏着一种「对难的兴奋感」
整期听下来,你能够很明显地发现姚顺宇话语之间的「强烈的兴奋感」。
尤其是结合他几乎每一个重要的人生选择,都在选更难、更不确定、更没人走过那条路。
高中成绩够上海四校,他义无反顾选了一个差点但有竞赛班的革致中学,理由是「这个竞赛班按现在的话说就是 underdog」。
清华自主招生本来只面向北京学生,他作为上海考生疯狂给招生办老师发短信,硬把自己塞进了考场。
「胆子要大。你不争取是永远得不到,争取了也有可能得不到,但不争取就绝对得不到。」
本科他做凝聚态理论,做出了一个范式级别的工作(描述非厄米系统的一套理论),按理说沿着这条路走下去会是一个非常体面的物理学家。但他主动放弃,跨进了完全不相关的高能物理。
「我总爱挑战一些自己不会的事。」
博士读完拿到伯克利博后 offer,他只待了两个星期就辞职跳到 Anthropic。在 Anthropic 待了一年,又跳到 Google DeepMind,因为他想学不一样的东西。
每次他做选择,目标都是:「这里我不会」。
听到这些,我突然理解了为什么这期播客含金量很高的原因 ——一个真正享受困难的人,做的判断、说的话,跟一个想包装自己的人,是不一样的。
13. 普通人面对模型,可以更大胆地说「你们 tmd 真难用」
姚顺宇说,Gemini 真正在市场上被看见,是两件事接连发生:Nanobanana 把市占率干上去了(爆款让大家下载了 Gemini App),Gemini 3 把人留下来了(模型能力够强)。
但更早一些,他说大众在Gemini 2.5那一代就已经判断出 Google 要追上来。
这与我们看待模型能力的进度是一致的。
也就是说,「内部知道这个模型行了」和「公众感受到这个模型行了」,时间是基本对得上的。
这个观察对普通用户的意义在于,当你用一个模型觉得难用的时候,问题不在你菜,问题在模型本身。
国内有种风气,模型不好用大家会反思自己的 prompt 写得不对、自己没学好「提示词工程」。但姚顺宇这个观察反过来证明:公众的体感和模型的真实水平,是高度一致的。
你觉得豆包语音真好用,那是因为豆包语音真的全球最强。你觉得 Claude 写代码可以,是因为 Claude 的 agentic coding 真的全球最强。
你觉得某个国产模型「答非所问、车轱辘话、毫无判断」,它真的就这样,跟你会不会用没关系。
模型难用就是难用,没必要替它找理由。
写完这 14 点的时候,火车已经快到北京了。
AI 仍然是一座高科技信息高地。一线发生的事、研究员的真实想法、模型背后的真实运作,对绝大多数公众几乎都是一个黑盒。
我们日常能看到的,大多是经过包装过的发布会、二次解读过的概念、各种听起来很宏大但其实没什么内容的「行业判断」。
在这种背景下,是否选择说真话、如何选择说真话,是一件非常困难的事情。
说真话意味着会得罪人,比如点破蒸馏的真相会得罪两家公司、甚至整个行业,比如直接说反华是离开 Anthropic 的原因之一会引来争议,比如说苹果不重视 AI 显得很蠢会让一批苹果迷不舒服。
所以很多人选择不说,或者只说一半。
所以这一期,是真的值得听的播客。
文章来自于"AI Humanist by杉森楠",作者 "杉森楠"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Meitu's Xinhong Wu on AI apps: deepen vertical use cases and control model and monetization costs (opens in a new tab)
AI Product Aying distills a podcast's lessons on product choices, small-team validation, subscriptions plus service fees and global markets, alongside reflections on the author's own startup.
Jeff Dean 与李飞飞讨论自动实验和递归自我改进的边界 (opens in a new tab)
对谈区分模型优化和改进研发流程,讨论计算与实验时间的约束。Jeff Dean 称 Discovery Loop 已运行约 20 个自动改进循环,提效倍数属于目标。
MiniMax 闫俊杰谈推理成本、开放权重与多模态模型 (opens in a new tab)
闫俊杰在 Scottish Mortgage 播客解释低推理成本如何支持后训练,并讨论 H3 开放权重和 M3 Pro 的开发进度。访谈亦区分年化收入运行率与财报收入。
对话张拳石:怎样用等效交互审计模型的判断依据 (opens in a new tab)
上海交大张拳石讨论思维链作为监控信号的局限,并介绍用输入遮挡、稀疏交互和等效拟合分析预测的研究。对谈也谈到跨模型共有特征和交流式学习的设想。
奥特曼:谁来决定AI该比人类聪明多少? (opens in a new tab)
报道整理奥特曼访谈中关于超级智能控制权、研发速度及权力集中的讨论,并回顾模型监测与人类复核机制。软件任务时长、IQ测验和科学验证是不同尺度,不能直接换算智力差距,也不能据此确认完全自主RSI已经实现。