告别云端依赖!字节开源新作DreamLite让手机秒变 AI 画板
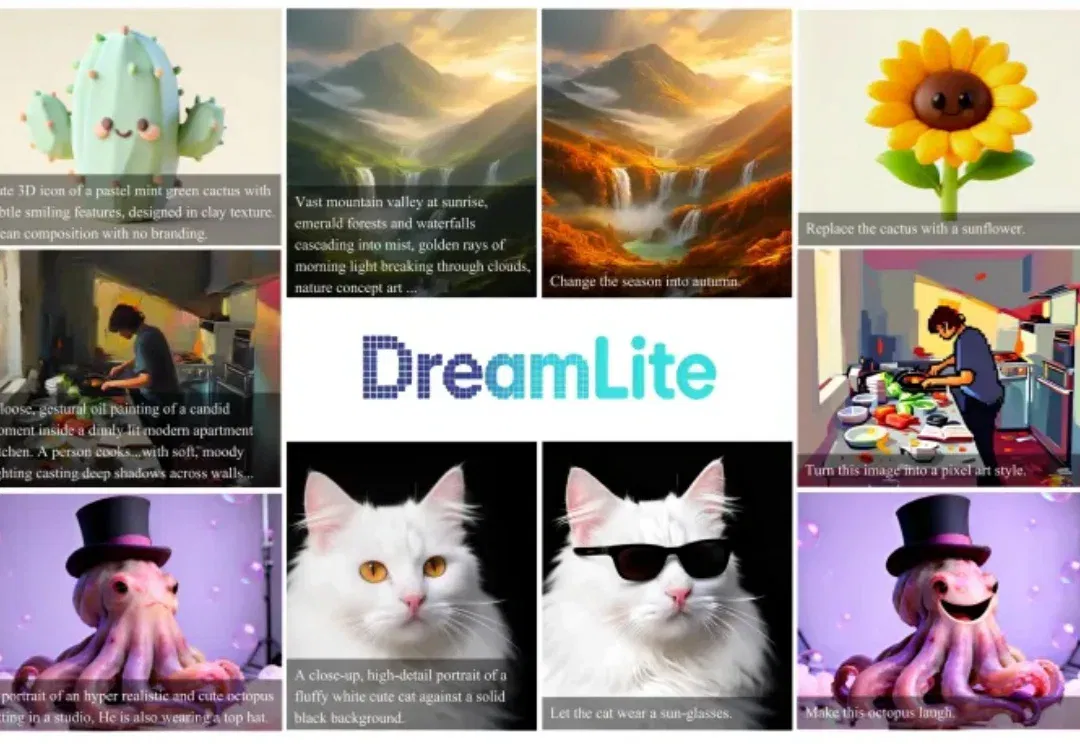
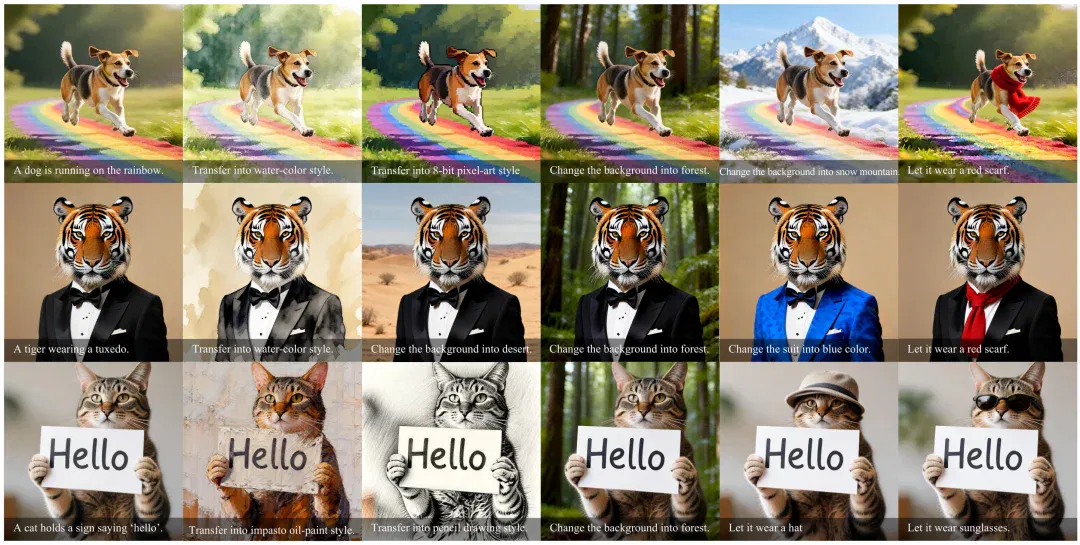
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
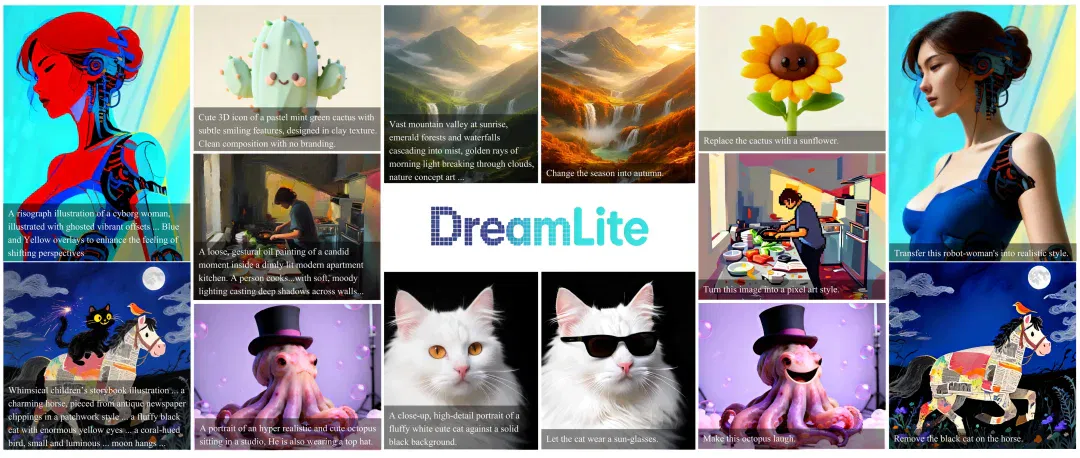
DreamLite 在 iPhone 17 Pro 上实现了约 3 秒生成或编辑一张 1024×1024 图像,完全在设备端运行,无需云端。在 GenEval、DPG、ImgEdit 等主流基准上,DreamLite 全面超越现有端侧模型,并与参数量大 10-30 倍的服务端模型表现相当。
目前,DreamLite 论文与推理代码已开源。
- 论文链接:https://arxiv.org/abs/2603.28713
- 项目主页:https://carlofkl.github.io/dreamlite/
- GitHub 链接:https://github.com/ByteVisionLab/DreamLite
- 在线 Demo:https://huggingface.co/spaces/carlofkl/DreamLite
当扩散模型想 "搬进手机":两大痛点亟待解决
在使用 FLUX、HunyuanImage、Qwen-Image 这类大模型创作或修图时,用户正在习惯 "提词即生图、一句话改图" 的体验。但当这些能力想真正走进手机、走向离线场景时,却遇到两个现实的拦路虎:
痛点一:生成与编辑,要装两个模型
现有方案中,文生图和图像编辑往往依赖两个独立的 pipeline: 一个负责 "从零生成",一个负责 "看图改图"。对本就内存紧张、存储有限的移动设备而言,同时装下两套数十亿参数的模型,几乎不可承受。
痛点二:质量和速度,难以兼得
把大模型压缩到端侧可用的体量后,生成质量往往断崖式下跌;而如果追求画质和指令跟随能力,推理延迟又会退回到 "按下按钮等待十几秒",彻底丧失实时交互的意义。
更关键的是,真实产品场景里,用户需要的是同一套应用里无缝切换 "生成一张图片" 和 "修改这张图片"。两个模型意味着两份显存占用、两份下载流量、两份维护成本,这在端侧尤其奢侈。
DreamLite:一个模型,两种能力
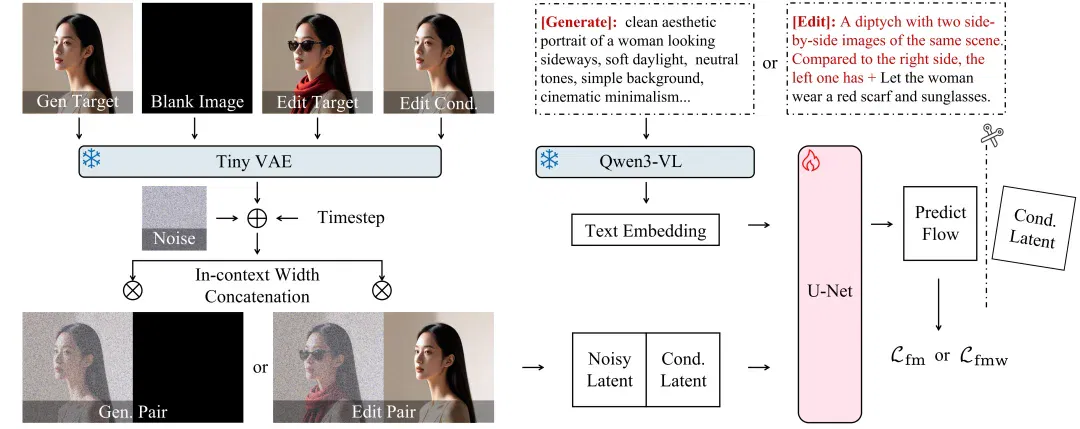
DreamLite 的核心思想非常直接:将把 "生成" 和 "编辑" 统一压进一个轻量级网络里,而不是分别训练两个模型。围绕这个思路,团队做了三项关键设计。
1. In-Context 空间拼接:用 "占位符" 统一两类任务
DreamLite 在剪枝后的 SDXL U-Net 主干上,引入了一种空间维度的 in-context 条件注入机制。具体而言,模型的输入始终是一对左右拼接的潜变量。对于文生图,输入的右侧参考图为全黑占位图,相当于 "没有视觉条件";对于编辑,输入的参考图为待编辑的原图。
在此之上,团队还在文本 prompt 前插入显式任务 token([Generate] 或 [Edit]),作为一种零参数的任务路由信号。这样一来,同一个 U-Net 就能根据输入自动分辨当下是 "文生图" 还是 "编辑",无需新增任何分支、适配器或额外模块,天然适配紧凑主干。
2. Task-Progressive Joint Pretraining(渐进式联合预训练)
直接联合训练生成和编辑任务会导致小模型的训练不稳定。团队提出了分阶段的渐进式策略:
- 阶段一|T2I 预训练:用大规模图文数据,以及经典的文生图范式,训练模型的生成能力;
- 阶段二|编辑预训练:激活 in-context 条件,让模型在保留原图结构的前提下,学会 "指令编辑";
- 阶段三|统一联合预训练:在同一 in-context 范式下继续联合优化生成与编辑。
这种分阶段的策略,让一个 0.39B 的小模型也能稳定习得 "生成 + 编辑" 双重能力。
3. RLHF 对齐 + DMD2 步数蒸馏
预训练之后,DreamLite 还经历两轮 "打磨":
- 高质量 SFT + RLHF 对齐:在精选高质量数据上监督微调,再通过强化学习做偏好对齐。生成任务以 HPSv3 作为 reward model,编辑任务以 EditReward 作为 reward model,并采用 ReFL 完成扩散模型的偏好优化。这一步显著提升了美学质量和指令跟随能力。
- DMD2 步数蒸馏:通过 Distribution Matching Distillation 2,将采样步数从数十步压缩到仅 4 步。
两者叠加,DreamLite 真正具备了 "端侧实时" 的现实可行性。最后通过量化和部署,实现在手机端生成 / 编辑(如下图)。
实验结果:跻身轻量化模型第一梯队
1. 指标:同级压制,越级对标
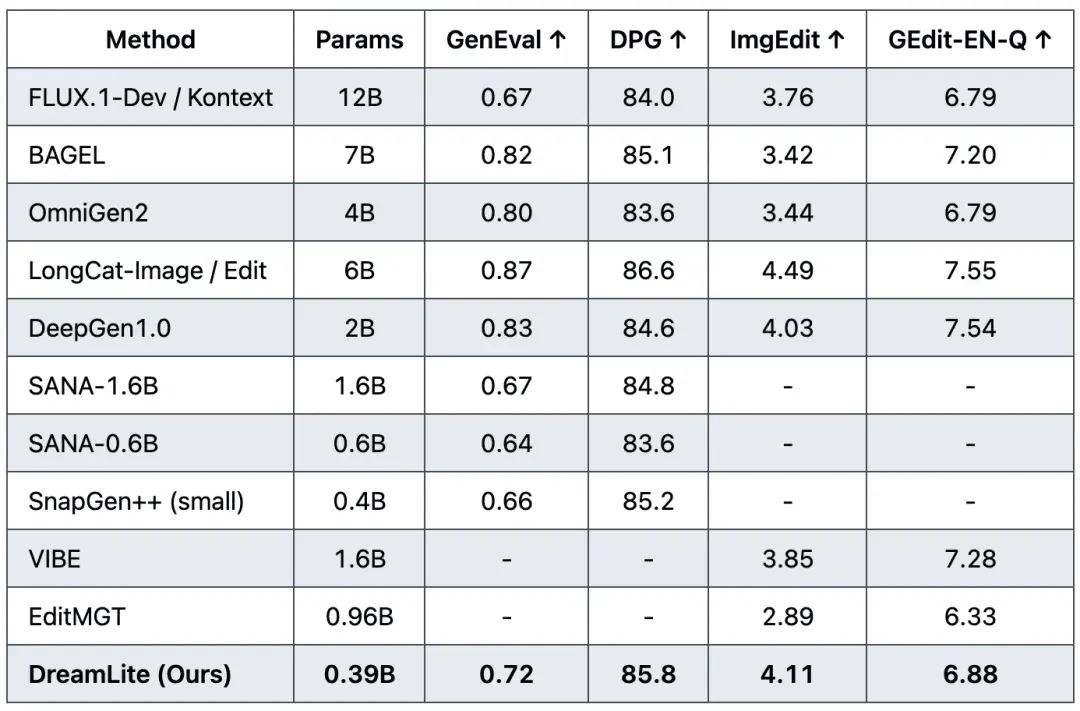
在文生图侧,DreamLite 在 GenEval 拿到 0.72、DPG 拿到 85.8;在图像编辑侧,在 ImgEdit 拿到 4.11、GEdit 拿到 6.88。在一众基线的对比中,DreamLite 作为端侧模型,不仅领先于 SnapGen、SANA 等轻量级的单任务模型,与参数量高出其 10–30 倍的服务端统一模型(如 FLUX、OmniGen2)相比,也展现出了极具竞争力的表现。
2. 手机实机演示:全程离线、无需联网
在 iPhone 17 Pro 的实机演示中,DreamLite 可稳定支持以下典型工作流:
- 人像生成 + 风格迁移:先生成人像写真,再一键转换为油画风格;
- 风景生成 + 背景替换:先生成自然风景,再完成冬夏的季节切换;
- 商品场景 + 增删替换:生成日常桌面场景,灵活替换物体。
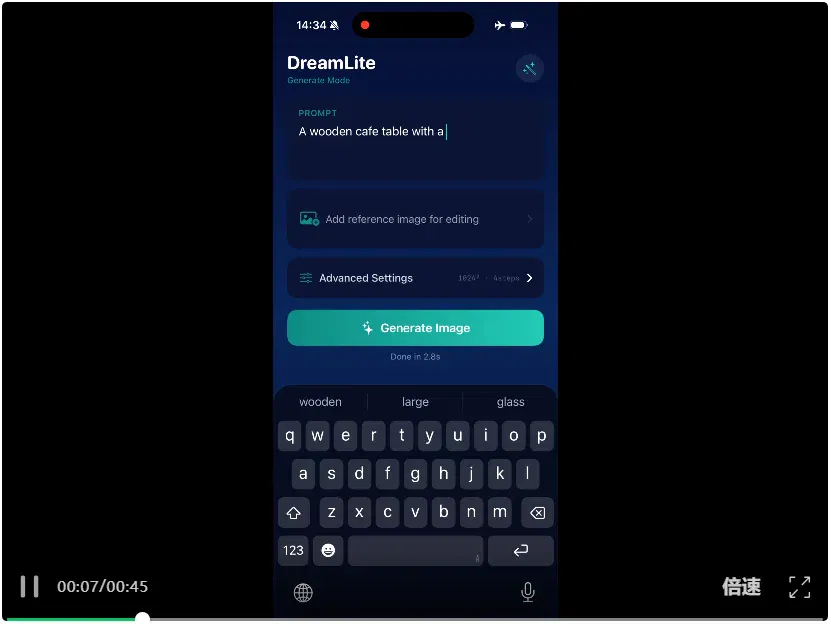
完整流程全程端侧运行、无需联网、用户数据不出设备,对隐私敏感场景尤其友好。
意义与展望
DreamLite 给端侧生成式 AI 的落地,提供了一条相当工程化、也相当有说服力的路径:
- 一个模型替代两个:统一生成与编辑,直接砍掉端侧 "双模型部署" 的内存、存储与调度开销;
- 4 步出图、秒级可用:DMD2 步数蒸馏让实时交互成为可能,真正贴合 App 级别的产品体验;
- 完全端侧、零数据外传:所有计算在设备本地完成,既降低云端推理成本,又从根本上规避了用户数据上传带来的隐私风险;
- 硬件门槛大幅降低:0.39B 主干意味着在更广泛的中低端设备上,也有机会享受到扩散模型级别的创作能力。
DreamLite 的意义,不只是 "在手机上又能跑一个扩散模型"。它更像是在回答一个更根本的问题:当扩散模型进入生产级的移动端时代,"生成" 和 "编辑" 能否作为同一个能力、由同一个小模型来承担?
随着端侧算力的持续提升、模型组件的持续轻量化,像 DreamLite 这样的轻量统一模型,很可能成为 AI 创作工具走向大规模、人人可用的关键一步 —— 把生成式 AI 从 "云端算力密集型服务",变成 "口袋里随时可用的画板"。
作者介绍
Kailai Feng 为字节跳动实习生,Yuxiang Wei, Bo Chen, Yang Pan, Hu Ye, Songwei Liu, Chenqian Yan, Yuan Gao 均为字节跳动研究员
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Aalborg study examines how diffusion-language-model sampling affects training-data extraction (opens in a new tab)
The paper compares masked completion with autoregressive models, finding that finer sampling steps can increase reproduction probability in matched tasks. The results do not establish that diffusion models are safer in every setting.
ChatGPT Images 2.6 实测:制作 GIF、参考图换装和局部编辑 (opens in a new tab)
机器之心展示了用参考图生成循环 GIF 和编辑局部的案例,并比较 Flare 与 Sunburst 的定位。文中同时记录了动图接缝跳变,以及单次 API 测试的耗时和成本。
DiffuSpace 发布开源扩散语言模型 Clover-35B-A3B-Preview (opens in a new tab)
Clover-35B-A3B-Preview 以块内并行去噪和历史状态复用提高生成效率。团队报告编程、工具使用及端侧量化结果,并介绍双向交互与联合决策探索。单用户生成速度与整机吞吐不同,性能比较受硬件、精度、框架和任务设置影响。
图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量 (opens in a new tab)
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
代码造世界,扩散绘现实:AgentGarten让智能体在实时试炼场中边玩边进化 (opens in a new tab)
推开一块挡板,通道就此封闭;搬来一段坡道,高墙便有了越过的可能。