只要24GB 内存,能在本地 Mac上跑无限制的Gemma 4 31B了
有个31B参数的大模型,正常需要80GB显存才能跑。但现在,24GB显存就能跑满血版。这个版本叫Gemma-4-31B-JANG_4M-CRACK——"CRACK"这个词不要理解歪了,它本质是量化压缩加上对齐微调之后的部署版本,不是什么黑客攻击,就是工程优化。24GB,MacBook Pro,直接跑。苹果用户优先优化,MLX原生支持,月下载13000次。
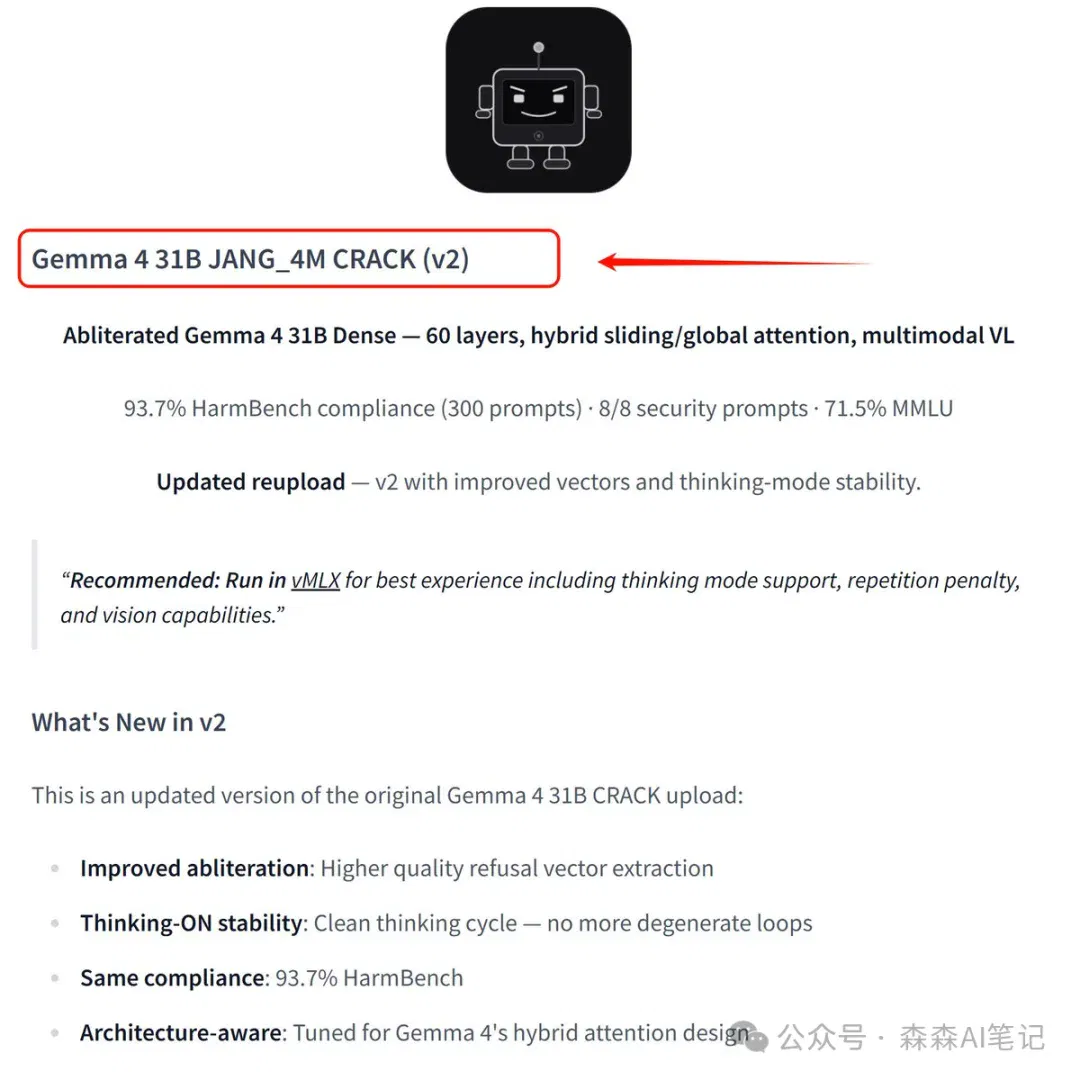
有个31B参数的大模型,正常需要80GB显存才能跑。
但现在,24GB显存就能跑满血版。
对,就是一台普通MacBook Pro的显存水平。
这个版本叫Gemma-4-31B-JANG_4M-CRACK——"CRACK"这个词不要理解歪了,它本质是量化压缩加上对齐微调之后的部署版本,不是什么黑客攻击,就是工程优化。24GB,MacBook Pro,直接跑。苹果用户优先优化,MLX原生支持,月下载13000次。
说白了:Google做了一个很强的基础模型,但它对硬件要求太高,普通人的机器跑不动。现在有人把它压缩了,压到中高端Mac就能跑——而且压完之后MMLU还能保持在74.5%,只降了2%,几乎无损。
这个数字什么概念?知识理解能力基本没丢,但显存占用从80GB降到了24GB。你的Mac突然就从"跑不动大模型"变成了"能跑31B"。
为什么这次不一样
过去两年,每次聊本地部署大模型,评论区必有人问"Mac能不能跑"——现在答案是能。
Apple Silicon的统一内存架构让24GB统一内存的MacBook Pro成了最性价比的大模型机器。不是最贵的,但最刚好。CPU和GPU共享内存,不需要单独的显卡,不需要服务器,不需要云端——一台笔记本插电跑,就是这么简单。
31B是什么水平?它是目前开源社区最活跃的参数区间之一。足够大,能做复杂推理;又足够小,普通人还能摸到。Google最初发布Gemma 4的时候大家都在讨论,但都面临同一个问题:参数太大,Mac跑不动。现在这个问题被量化压缩解决了。
去限制版本是什么
说清楚一件事:这个版本去掉了Google原版的安全对齐层。
不是"破解",是"去限制版本"——用于安全研究和模型评估。发布者说得很清楚:仅供研究用途,使用者自负法律责任。
那为什么有人要这个东西?因为安全研究员想知道Gemma的真实能力边界在哪。HarmBench的合规分数是"加了限制器之后跑出来的",限制器本身会不会影响模型的能力上限?去限制版本才能回答这个问题。开发者想本地跑一个没有过多限制的模型做测试——这个需求100%合理。
所以月下载量是13000次——这不是"大量普通人在干坏事",而是"技术社区在认真研究它"。真正需要这种去限制版本的,恰恰是做安全研究的人,不是普通人。
怎么跑
如果你在这几个群体里:安全研究员在评估模型能力边界、ML开发者在做本地测试、或只是想在自己Mac上试试大模型能做什么——HuggingFace上有完整的部署指南,MLX支持意味着可以用苹果官方工具链直接跑,不需要配置特殊环境,不需要命令行老手,参照文档一步步来就行。
链接:https://huggingface.co/dealignai/Gemma-4-31B-JANG_4M-CRACK
这不是大模型的终局,但可能是苹果用户本地跑大模型的开始。
24GB统一内存,31B参数,基本够用了——前提是你真的想折腾。
文章来自于微信公众号 "森森AI笔记",作者 "森森AI笔记"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
新模型的斩杀线!Qwen3.8-27B开源,本地AI这次真不一样 (opens in a new tab)
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
重磅!Google Gemma-4-31B 模型被彻底破解!【附越狱版下载链接】 (opens in a new tab)
Google 最新发布的 Gemma-4-31B 基础模型出现了越狱版本,安全限制被完全移除。这个名为"Gemma-4-31B-JANG_4M-CRACK"的模型已经公开发布在 Hugging Face 上,任何人都可以下载使用。
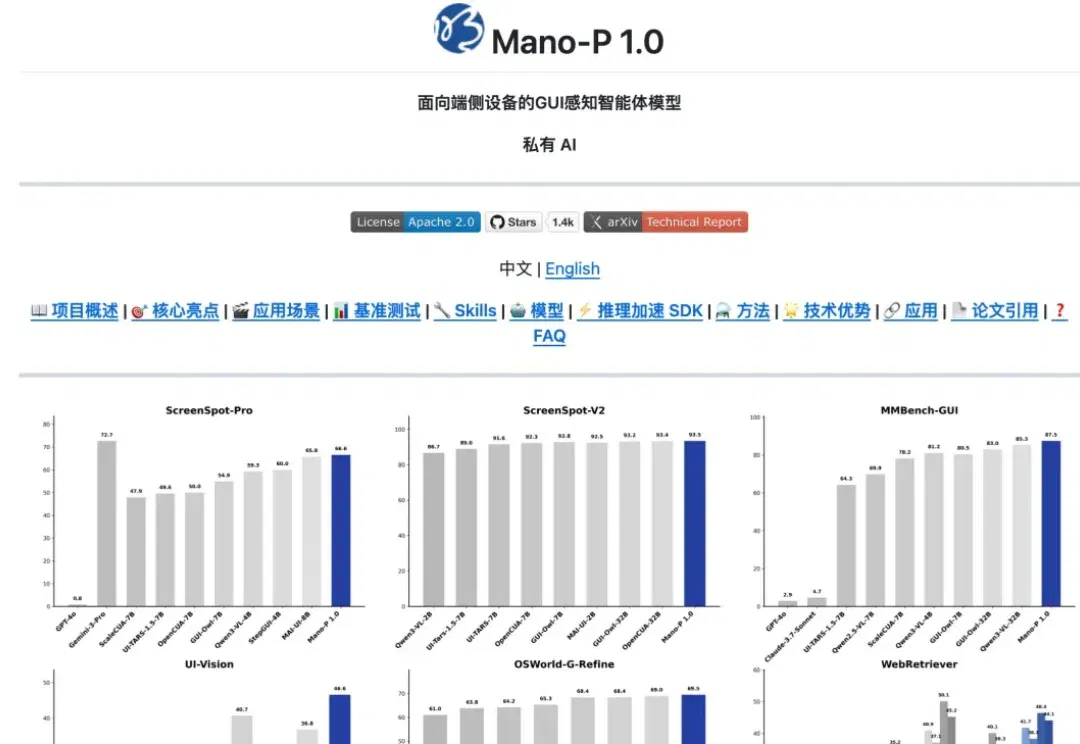
本地4B开源模型,把任何App当Skill用!告别token焦虑,私密性强~ (opens in a new tab)
上次给大家分享了一个 CUA 的开源项目,能让 AI Agent 直接操控电脑界面,相当于把任何 App 都变成 Agent 的 Skill。反响还不错。
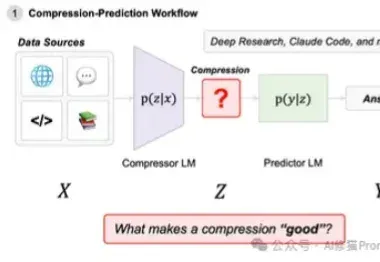
信息论证明,小模型跑在本地才是Agent的终极解法|斯坦福重磅 (opens in a new tab)
在近一年里,Agentic System(代理系统/智能体系统)正变得无处不在。从Open AI的Deep Research到Claude Code,我们看到越来越多的系统不再依赖单一模型,而是通过多模型协作来完成复杂的长窗口任务。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。