特斯拉OpenAI数据路线遇挫!8千平具身「兵工厂」+ego众包狂飙
质量和成本只能二选一?通过大脑+小脑分层、场内+场外双轮驱动,数据堂给出了具身智能数据难题的解。
质量和成本只能二选一?通过大脑+小脑分层、场内+场外双轮驱动,数据堂给出了具身智能数据难题的解。
为什么机器人还干不好家务?
不是因为它不够「聪明」,而是因为——它没有「长大」。
人类用几年时间,通过数百万次真实交互学会动作与决策,而机器人,却要从数据里「补课」。
2026年,Physical AI真正的瓶颈,不在算法,也不在算力,而在一个更现实的问题:谁能以最低成本,生产最多、最真实的训练数据?
2024年,特斯拉和OpenAI在机器人数据采集上,走了两条完全不同的路。
特斯拉选择重资产路线,利用动作捕捉服和虚拟现实头显,用昂贵的遥操作设备采集高精度数据;OpenAI则押注低成本机械臂,试图通过众包方式获取海量数据。
两种选择背后,折射出一个根本矛盾——在数据采集这件事上,「质量」和「成本」,似乎只能二选一。
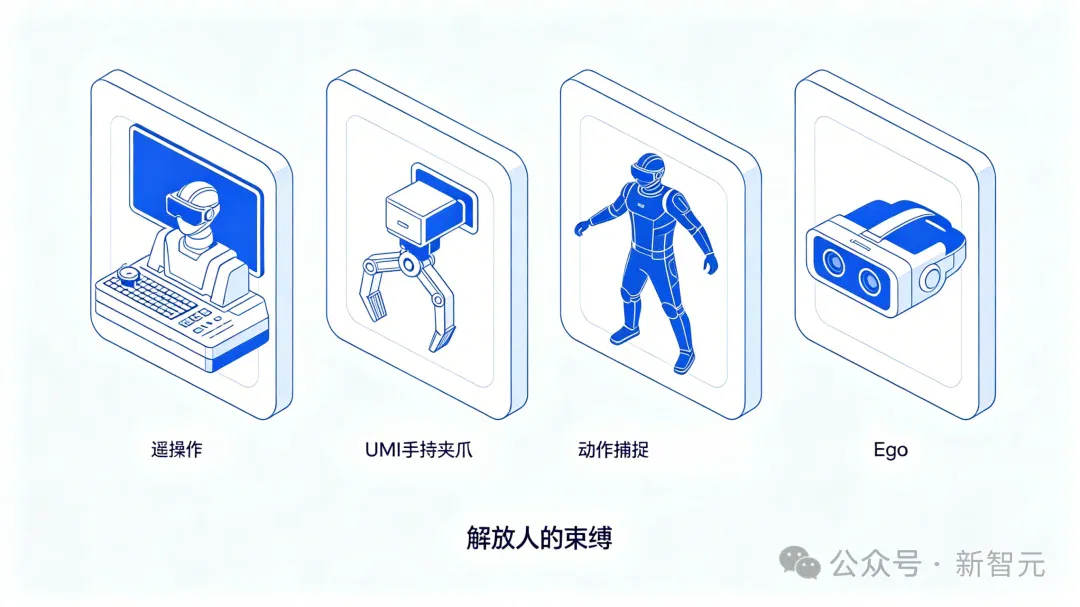
事实上,过去两年数据采集方式已历经三次迭代:从「真机遥操」到「手持夹爪UMI」,再到今年爆发的「第一人称人类视频Ego Centric」。
每一次都在「解放对采集人的束缚」,虽然扩大了产能,降低采集成本,但也损失了精细控制数据的获取。
本质上,这三次演进是在不断回答同一个问题:如何在不牺牲过多「真实度」的前提下,释放数据生产力?
这个矛盾该如何破解?
一、困局:质量 vs 成本
一个不可兼得的选择题
在算力、算法、数据构成的AI三角中,算力和算法正在变得同质化,如何获取高质量、多样化、类人化、低成本的训练数据,已成为提升Physical AI模型性能的「诀窍」。
Scaling law(规模定律)告诉我们,只要能在数据上每增加10倍,就能提高一倍的性能。
在合成数据、第三视角视频学习仍无法替代真实物理交互的当下,如何在真实采集中实现低成本、高质量,成为行业需要破解的难题。
目前Physical AI数据采集,主要有以下流派:
1. 真机遥操:为专属机器人「量身定制」的高精度方案
真机遥操的核心逻辑是人通过VR眼镜、手柄、遥操手套等,操控某一款机器人完成各类动作,同步记录关节角度、电机力矩、末端位姿、力反馈与各视觉传感器信息。
这种方式的优势极为突出,数据高度贴合目标机器人,包含完整的力触觉信息,训练出来的模型可以直接运用到同型号机器人上,无需额外适配。可以直接使用π0算法来训练,不用迁移。
但缺陷同样严重,数据与机器人强绑定,几乎无法跨机型迁移;真机采集场景受限,多样性差;遥操作会限制操作员动作,采集的数据不自然;真机成本高,采集效率低,通常需要两人配合,有效数据时长短。
因此,这种真机遥操的方式很难低成本积累大量的预训练数据。
2. UMI通用夹爪:从通用性、真实性出发,降低采集成本
UMI通用夹爪是斯坦福大学2024年提出的折中方案:人手持标准化的通用夹爪(3D打印+GoPro等运动相机),在真实野外场景中操作,同步记录末端视角、夹爪状态、相对轨迹与运动信息。
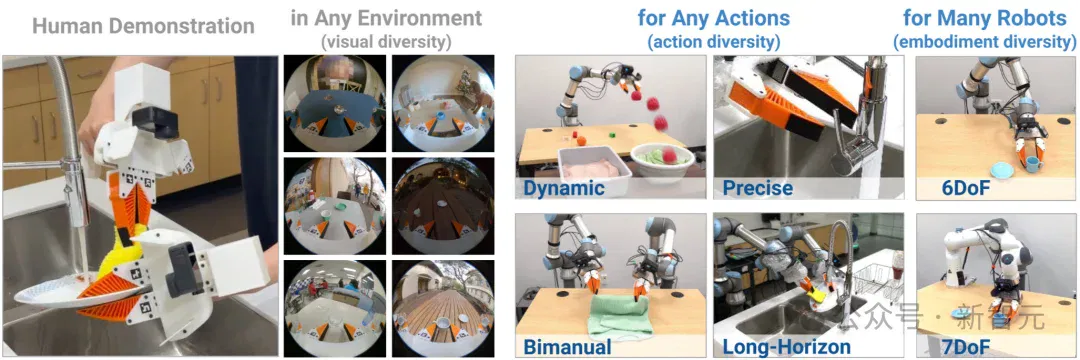
这种方式兼顾了成本与复用性,设备成本低、高便携、数据可跨机器人复用,贴近主流夹爪执行逻辑。
但是仍旧存在缺陷,夹爪仍然是一个不自然,对操作员有较多限制的末端执行器,难以完成拧螺丝、分拣细物等精细操作。数据缺少环境、行走决策等信息,难以用在人形机器人训练,多用于机械臂。
3. 动作捕捉:直接无侵入捕获真实人类的动作
动作捕捉则跳出了对机器人本体和UMI夹爪的依赖,通过穿戴式设备捕捉人体和手部关键点轨迹,再映射到机器人系统中。
优势在于采集成本低、可批量开展,无需部署真实机器人,人类的动作更自然。
动捕的方案和设备在虚拟数字人方面已经非常成熟,但具身智能数据采集上,依然会遇到一个问题——设备部署需要单独的环境和空间,无法便携的带到千家万户的真实场景中去,并且对遮挡等敏感。
4. Ego 第一人称视频:可穿戴式的无侵入数据采集方案
Ego(Ego Centric)数据是2025年底从硅谷火到国内的具身智能采集方式,Ego采集是从第一视角采集而不是爬取第三方视角数据来获取更高质量的数据,而且采集成本比从互联网爬取、清洗更低!
记录的数据包括了第一人称视角中双手的操作,环境数据,身体关键点数据。
采集员只需佩戴头环、头戴式相机,使用双手操作即可。由于是可穿戴设备,很容易进入家庭、商业等场景中进行数据采集。
这种方式的优势极为突出:采集成本极低、规模可无限放大。
英伟达的EgoScale和DreamDojo已展示数万小时级的采集能力。
同时,第一视角蕴含了环境信息、人类的决策逻辑、视觉注意力切换,也包括了丰富的手-物交互细节。
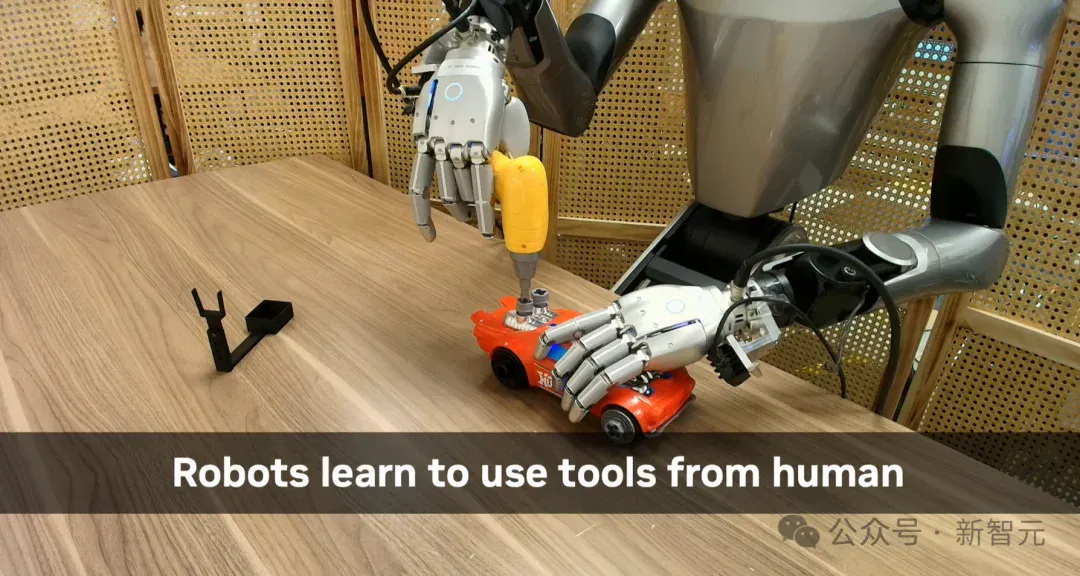
当然,它也有自己的劣势:多设备需要时间对齐、空间标定,设备需要长时间稳定运行;原始视频中包含大量无效片段,需清洗才能提取有效数据;不包含任何力触觉信息或精确的关节轨迹;其人体关节仅捕获手和脚,其他关键点需要预测,手部关键点和位置需要使用双目相机预测。
几条路线各有取舍,却都无法破解「质量与成本」的矛盾。
这也让行业逐渐意识到具身智能难以实现一种方案打遍天下,而是需要匹配机器人不同智能层级的「分层采集架构」——就像人类的大脑与小脑,各自分工、协同工作,才能实现高效的智能输出。
二、破局:大脑+小脑分层
场内+场外双范式
人类的智能天然分为两套协同系统:小脑负责精细控制、毫秒级执行,大脑负责高层规划、常识推理、错误恢复。
具身智能同样需要复刻这套逻辑,构建「云端大脑+端侧小脑」的分层架构,对应的采集方式也分为场内与场外两种,各自承担不同的使命。
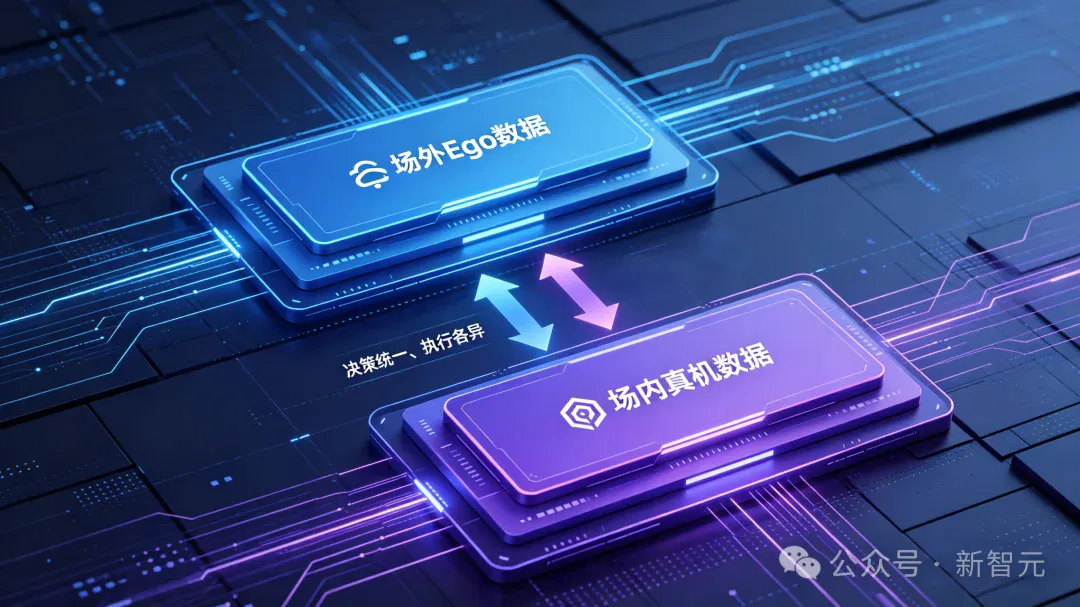
1. 训练机器人的「小脑」,打造肌肉记忆
场内采集聚焦短程技能、实时执行与毫米级精度(如抓取、精密装配等)。
这类动作对延迟极度敏感,因此必须部署在端侧,通过VLA模型实现实时响应。
对应的核心数据需求,是电机信号、力矩、力反馈、高频控制指令等能反映「执行细节」的信息。
而最佳采集方式正是真机遥操,只有通过真实机器人的交互才能获取最精准的力触觉反馈,为特定机器人打造稳定、确定、可复现的「肌肉记忆」。
场内采集的核心价值不在于数据通用性,而在于「精准适配」,为特定型号机器人定制专属的执行能力,确保它能稳、准、快地完成精细动作。
2. 训练机器人的「大脑」,构建通用的决策能力
与场内采集相反,场外采集聚焦长程任务与动态决策(如整理房间、设备巡检等)。
这类动作不需要毫秒级延迟,更需要多样化的场景覆盖,因此适合部署在云端,支撑VLM大模型持续迭代。
对应的核心数据需求,是周边环境、决策逻辑、实际人类操作,最佳方式是使用众包方式的Ego采集,无需真机即可快速覆盖海量真实场景,让大脑理解 「做什么、为什么」。
这里多样化的场景非常重要,大脑的数据需要适应性,不仅包括各种静态场景(甚至失败的情况),还要包括各种动态干扰。
因此,针对未来机器人真实的工作场景,Ego采集是最佳选择。
场外采集的核心价值,不在于精度,而在于通用适配。
不为特定机器人提供专属数据,而是为所有机器人打造通用的决策能力,实现「一句指令,多种执行」。
二者的协同,构成了具身智能数据采集的核心逻辑:思考方式统一,执行各异。
具身智能的数据问题本质不是「选哪种采集方式」,而是:用什么数据,训练机器人的哪一部分智能。
这也是为什么,行业开始从「单一采集方案」转向「分层数据架构」,而像数据堂这样的专业数据基础设施服务商,正成为这一转型中的关键角色。
三、落地:场内靠工厂提效
场外Ego众包扩量
分层架构的清晰只是具身智能落地的第一步。
真正的行业竞争在于工程化能力——如何低成本、大规模、稳定地产出高质量数据。
解决方案就是「场内工厂化+场外众包化」的双轮驱动。
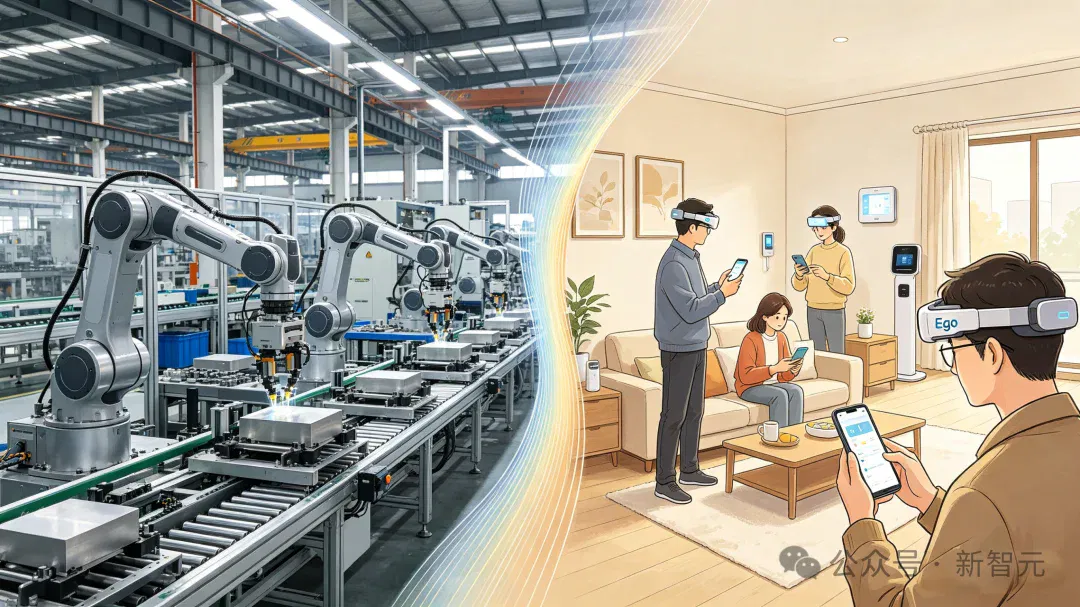
1. 场内采集:重资产工厂运营,拼的是成本与效率
小脑训练需要真机数据,场内采集是典型的重资产运营模式,机器人、场地、电力、人力的持续投入决定了效率就是生命线。
必须构建一套完善的成本优化与流程标准化体系,采用梯队化管理,实现任务标准化、动作规范化、异常处理流程化。
一个熟练采集员日均产出200–500条有效数据,而通用抓取模型训练就需要10万条以上。
只有工厂化、规模化运营,才能摊薄成本。
2. 场外采集:轻资产Ego众包模式,拼的是极简与规模
大脑训练追求的是场景多样性。2026年,场外采集已从「手持夹爪众包」升级为Ego极简采集,采集员仅需头戴式运动相机+便携计算模块+手机控制搭配语音独白,以第一人称视角记录日常操作。
这种方式成本可控、易部署、无约束,更贴近人类自然操作,再通过自动化质检和人工抽检机制保障数据质量,可快速积累高质量多场景数据。
甚至这种无侵入的采集,最好的方式是跟各种专业人员操作结合起来,直接请专业的酒店整理、厨师、物流人员佩戴,在实际工作中记录,既真实又降本。
3. 场内与场外:不是二选一,而是协同互补
场内工厂与场外众包,并非相互替代的关系,而是两种不同的数据采集模式,各自承担着不同的产业使命,最终形成协同互补的数据供给闭环。
场内采集走的是B2B重服务模式,高可控、稳交付,主要服务于头部机器人厂商,支撑机器人 「小脑」 训练。场外为平台轻模式,高扩张、广覆盖,以Ego数据为核心补充场景多样性,支撑「大脑」的通用化训练。
二者协同,实现高精度与高通用的兼顾,为具身智能规模化落地提供完整的数据支撑。
四、实践:数据堂
让「具身智能数据」不再成为算法训练的难题
对机器人企业而言,自建数据体系往往面临三个现实问题:
- 成本高(设备 + 人员)
- 周期长(从0到1搭建)
- 难规模化(无法快速扩张)
数据堂的价值,本质上是:把「数据生产」这件事,从研发问题,变成基础设施服务。
相比机器人公司自建采集团队,专业数据服务商具备两方面独特优势:一是规模化工程能力——已在全国布局采集基地与标注中心,拥有成熟的数据采集SOP与人员梯队;二是全链路闭环经验——从任务设计、真机采集、众包分发到多模态标注、质检交付,已形成标准化流水线。
数据堂作为专业的人工智能数据服务提供商,凭借十余年的行业积累,成为国内具身智能数据服务领域的核心标杆,将「大脑-小脑、场内-场外」的理论框架,转化为可交付、可规模化、可商业化的落地服务。
已服务多家头部具身智能企业,完成万小时级Ego数据采集与百万级标注交付。
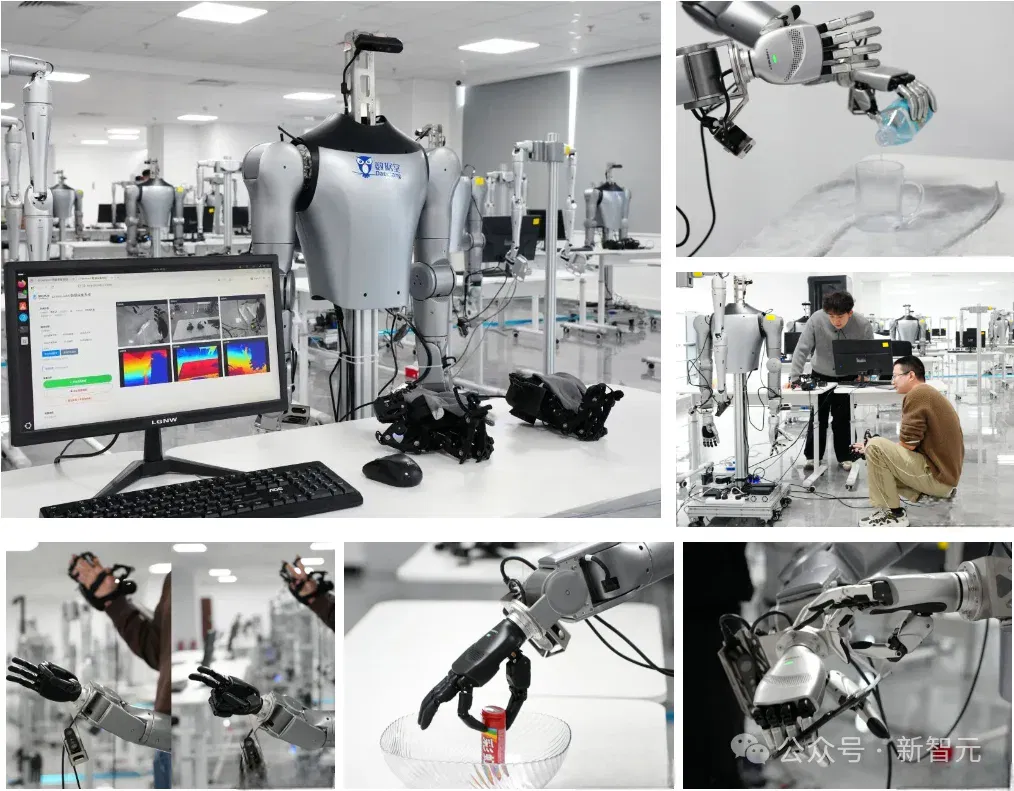
自建具身智能数据工厂(场内采集)
面对数据采集的困难,数据堂斥巨资打造国内顶尖具身智能数据工厂。
工厂占地超过8000平方米,搭建高度真实、可灵活配置的物理环境,模拟药店、超市、工厂、家居、厨房等真实复杂场景,涵盖零售、医疗、工业自动化等多个商业化领域。
工厂装配了300组通用双臂灵巧手采集设备,600名经验丰富的采集员。计划今年产出10万小时数据。
拥有全球众包资源提供Ego采集服务(场外真实环境采集)
在采集端,紧跟2026行业范式,数据堂同步搭建Ego第一视角采集、UMI手持采集的众包体系。
实现了设备管理和维修、项目管理、培训、质检、众包资源拓展、场景资源拓展的人员体系,以及面向具身智能算法企业的服务体系,可短期低成本采集大量的真实场景数据。
已经为数个国内头部具身智能玩家提供Ego、UMI数据采集服务。
通过高效的标注平台支持各类具身智能的数据标注
同时数据堂拥有百万级标注团队与自研智能标注平台,提供覆盖感知到决策的多模态标注服务。
如位姿标注服务于「小脑」训练,通过解算点云精确识别目标物体的六自由度位姿,是精细操作的前提;VLA/VLM标注则服务于「大脑」训练,对操作视频进行任务拆解与结构化对齐,为模型提供决策依据。
结语
2026年,不是人形机器人的量产元年,而是具身智能数据元年。
硬件决定机器人的下限,而数据决定机器人的上限。
这场Physical AI竞赛的核心,是数据闭环工程能力。
以数据堂为代表的服务商,正用双轮体系为具身智能输送燃料,搭建实验室与产业落地的桥梁。
未来,机器人的差距,本质上是数据的差距。
而那些能掌握分层采集、数据闭环与标准体系的企业,终将主导下一代Physical AI的发展——因为,数据正在重新定义机器人的未来。
文章来自于"新智元",作者 "犀牛"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
OpenAI把AI推向物理世界,这家公司已造好引擎,下一站1000万小时人类经验 (opens in a new tab)
9 月 3 日,OpenAI 正式发布 GPT-6 Astra。在 ARC-AGI-3(一个考验 AI 能否在陌生环境中自主探索、理解规则并规划行动的 Benchmark),Astra 拿下 99.9%,并在 96% 的关卡中达到或超过人类的行动效率基准。
蚂蚁VLDB最佳论文:用一张“逻辑表”驯服3050亿条训练数据 (opens in a new tab)
训练一个大模型之前,语料需要经过解析、清洗、去重、质量评分、Token化和样本组装。
Ropedia releases Xperience 2 to align real scenes with first-person behavior (opens in a new tab)
Scene geometry, video and body trajectories share one coordinate system. Demos cover simulation conversion, retargeting, virtual teleoperation and trajectory generation; benefits for real-robot training need further tests.
报道称字节 Seed 技术负责人周畅离职,创业方向为 Physical AI (opens in a new tab)
Z Finance 报道,字节 Seed 技术负责人周畅已离职,正围绕 Physical AI 创业并获得美元基金支持,融资金额、投资方与产品路线尚未披露。文章回顾其多模态、世界模型与机器人研发经历,也提到此前曾有接近字节人士否认离职消息。
矩侨工业获亿元 A 轮融资,继续拓展织物触觉传感与数据采集 (opens in a new tab)
据 Z Potentials 报道,矩侨工业完成蚂蚁集团领投的亿元 A 轮融资,资金将用于织物电子皮肤量产、触觉技术研发和场景拓展。公司从柔性纤维出发,将压力感知延伸至手套、机器人皮肤和家居康养产品;交付与性能数据采用原报道及企业口径。