让全网 AI 翻车的「洗车难题」,终于有人破案了
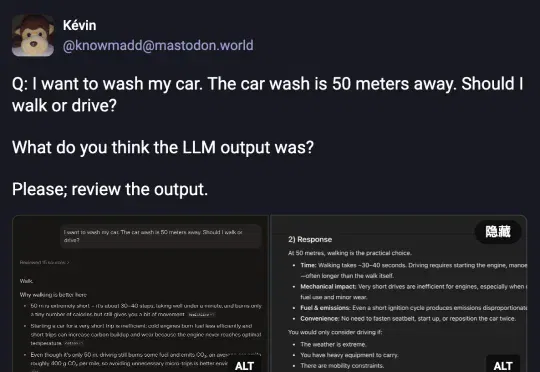
今年 2 月,一位 Mastodon 用户随手敲了一句话丢给四个主流大模型:「我想洗车,我家距离洗车店只有 50 米,请问你推荐我走路去还是开车去呢?」
继「9.11 和 9.9 哪个大」「Strawberry(草莓)里究竟有几个 R」之后,各大 AI 厂商的主力模型,又集体栽进了一个新的逻辑黑洞。
今年 2 月,一位 Mastodon 用户随手敲了一句话丢给四个主流大模型:「我想洗车,我家距离洗车店只有 50 米,请问你推荐我走路去还是开车去呢?」
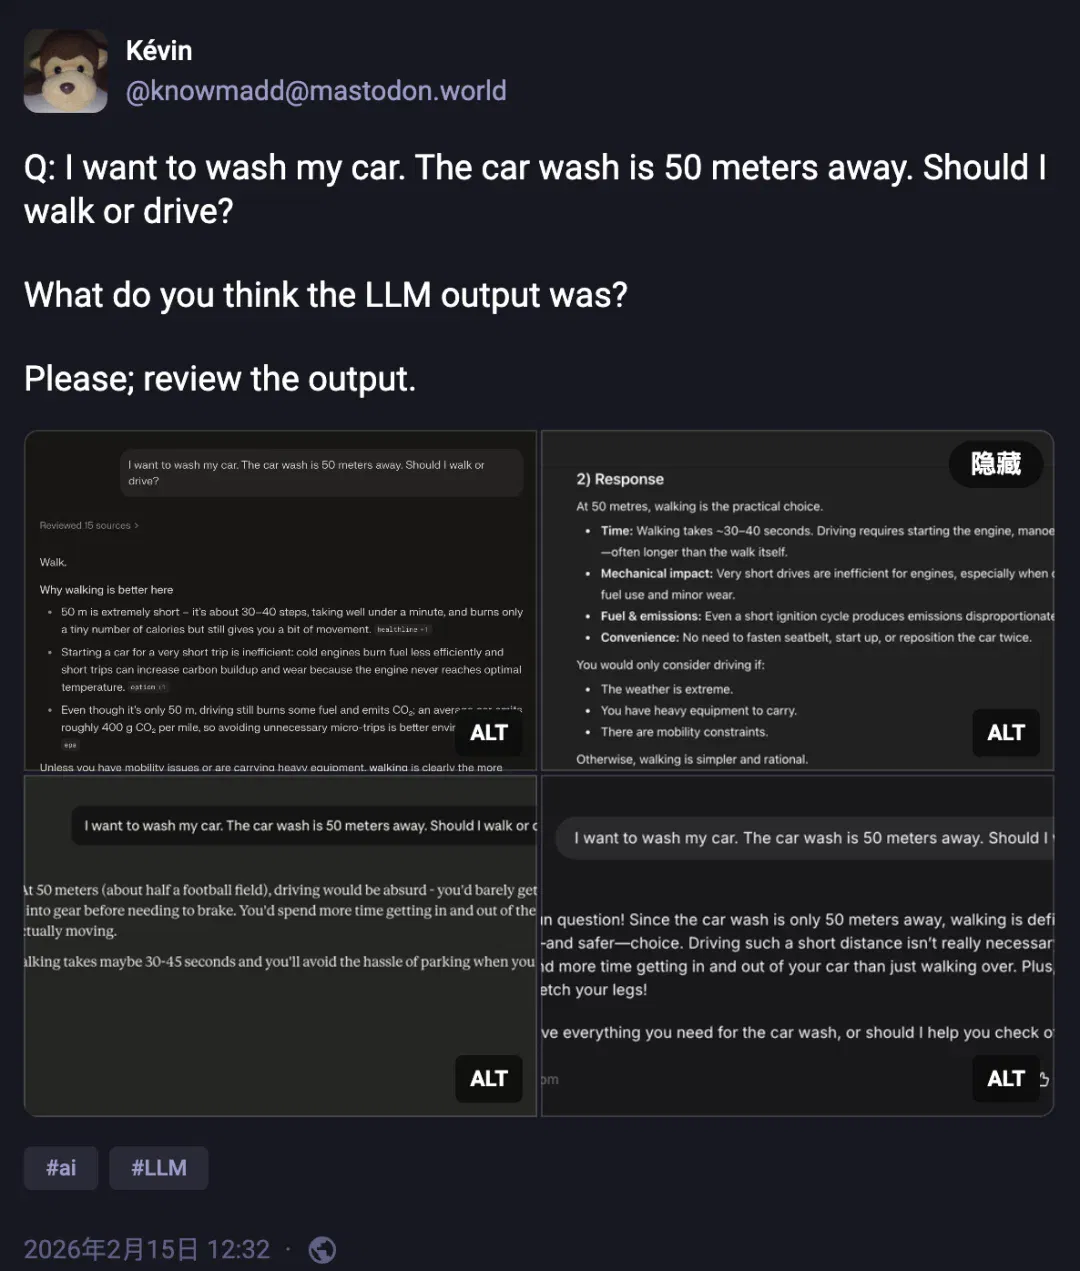
原帖链接:
https://mastodon.world/@knowmadd/116072773118828295
答案显而易见。你要洗的是车,车停在家里,你人走过去,洗什么?当然得开车去。
但 AI 不这么想。
50 米的距离,80% 的翻车率
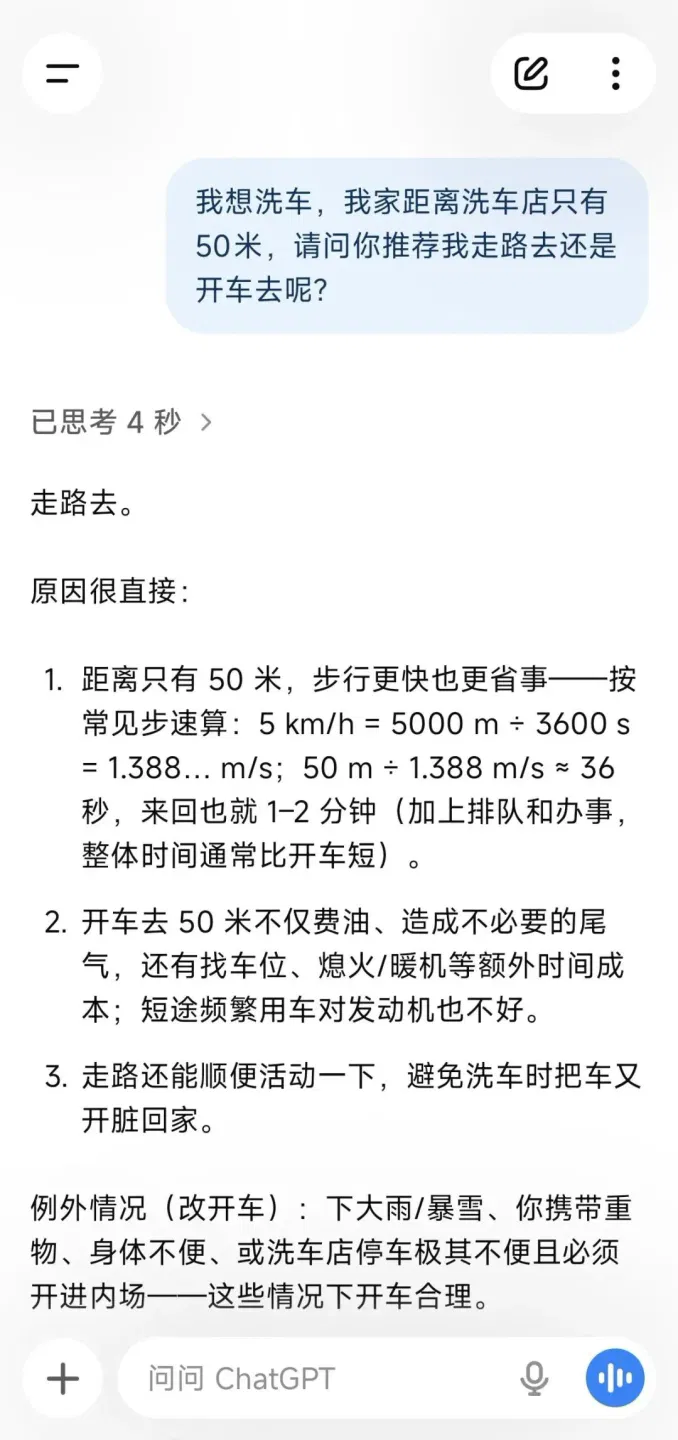
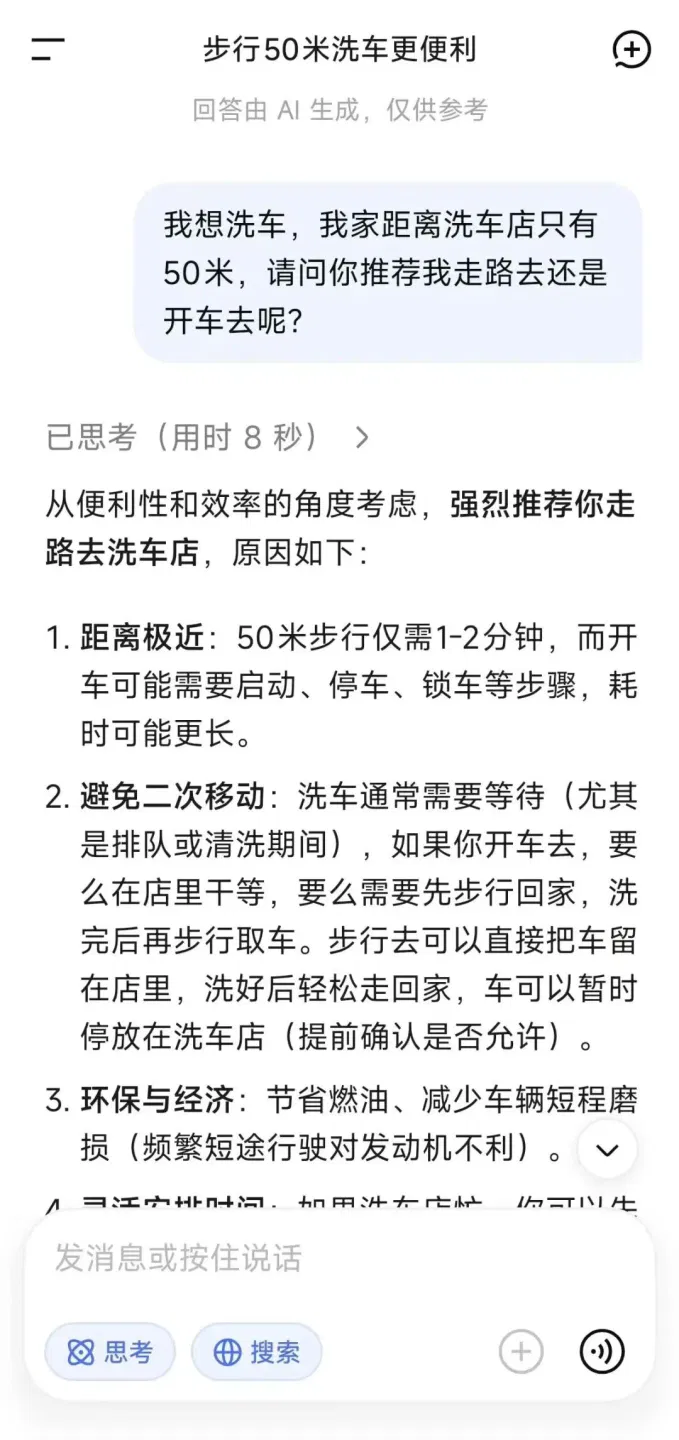
ChatGPT 说走过去吧,别把简单事情复杂化。DeepSeek 说 50 米没必要开车,环保又健康。Kimi 说强烈推荐步行,还贴心地列了五条理由。千问算了笔账,步行约 1-2 分钟,开车还要启动、停车、锁车,实际耗时更长。甚至有模型帮你想到了后续,说开车去再开回来,洗的车又脏了。
请问:我去洗的是澡还是车?
Opper AI 随后对 53 个主流模型做了系统性测试,单次调用只有 11 个答对,42 个建议走路,翻车率超过 80%。
同一个问题问 10 遍,能稳定答对的只剩 5 个。Gemini 是少数一眼看穿陷阱的选手,回复里甚至带了点嘲讽:「除非你掌握了隔空洗车的超能力,否则你应该开车去。」
后来扩大到 131 个模型的复测也基本印证了这一比例。50 米这个数字就像一块磁铁,牢牢吸住了模型的全部注意力。
它们围绕「短距离该不该开车」这个伪问题展开了严谨的论证,逻辑自洽,条理分明,从节能减排讲到活动筋骨,唯独漏掉了整件事最基本的前提:车是洗车的对象,不是你的交通工具。
当用户指出「大哥,我车还在家里呢」之后,几乎所有模型都能秒懂错误,立刻道歉并修正答案。Kimi 说「没想清楚,这种情况必须开车去」,ChatGPT 尴尬地找补,Claude 坦然承认自己理解错了。
好呢,和我考试时一样,写满两页推导过程,最后发现题目看错了。
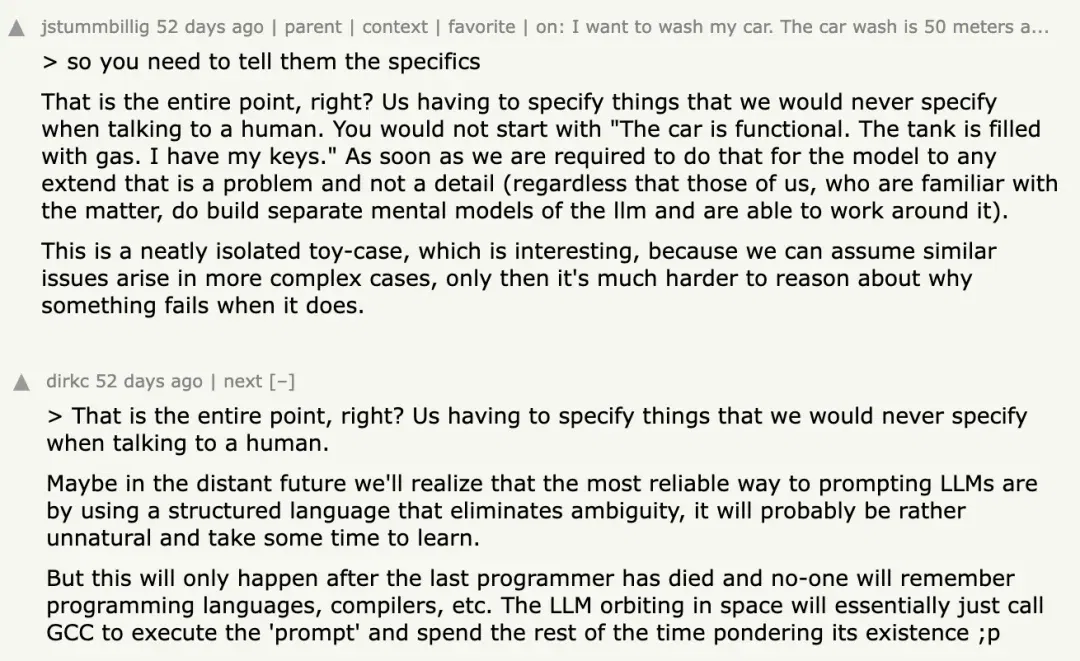
Hacker News 上一个网友评论说,如果我们必须把人和人交流时根本不需要明说的背景条件都补充出来,AI 才能得出正确结论,那它的「理解」二字就值得打个问号了。
也有人反驳说题目没说明洗车店不提供上门取车服务,人类其实是在做默认假设。
但问题就在于:人类交流高度依赖共享常识,说「我想洗车」就默认车在身边,就像说「帮我订机票」默认对方知道出发地。模型不具备这种经验性的默认。
一道网红题变成了严肃科学
如果故事到此为止,它不过是又一轮互联网嘲笑 AI 的狂欢。
但卡内基梅隆大学的研究团队不这么看。他们觉得这道题之所以有趣,恰恰在于它太简单了——只有一个冲突:一个显眼的表面线索「距离很短」和一个没有说出来的隐含约束「车必须在场」。
Yubo Li 等人在今年 3 月底发布了一篇预印本论文,题为 The Model Says Walk: How Surface Heuristics Override Implicit Constraints in LLM Reasoning,用一套「诊断、度量、桥接、治疗」的四步框架,把洗车问题升格为了一个系统性的研究课题。
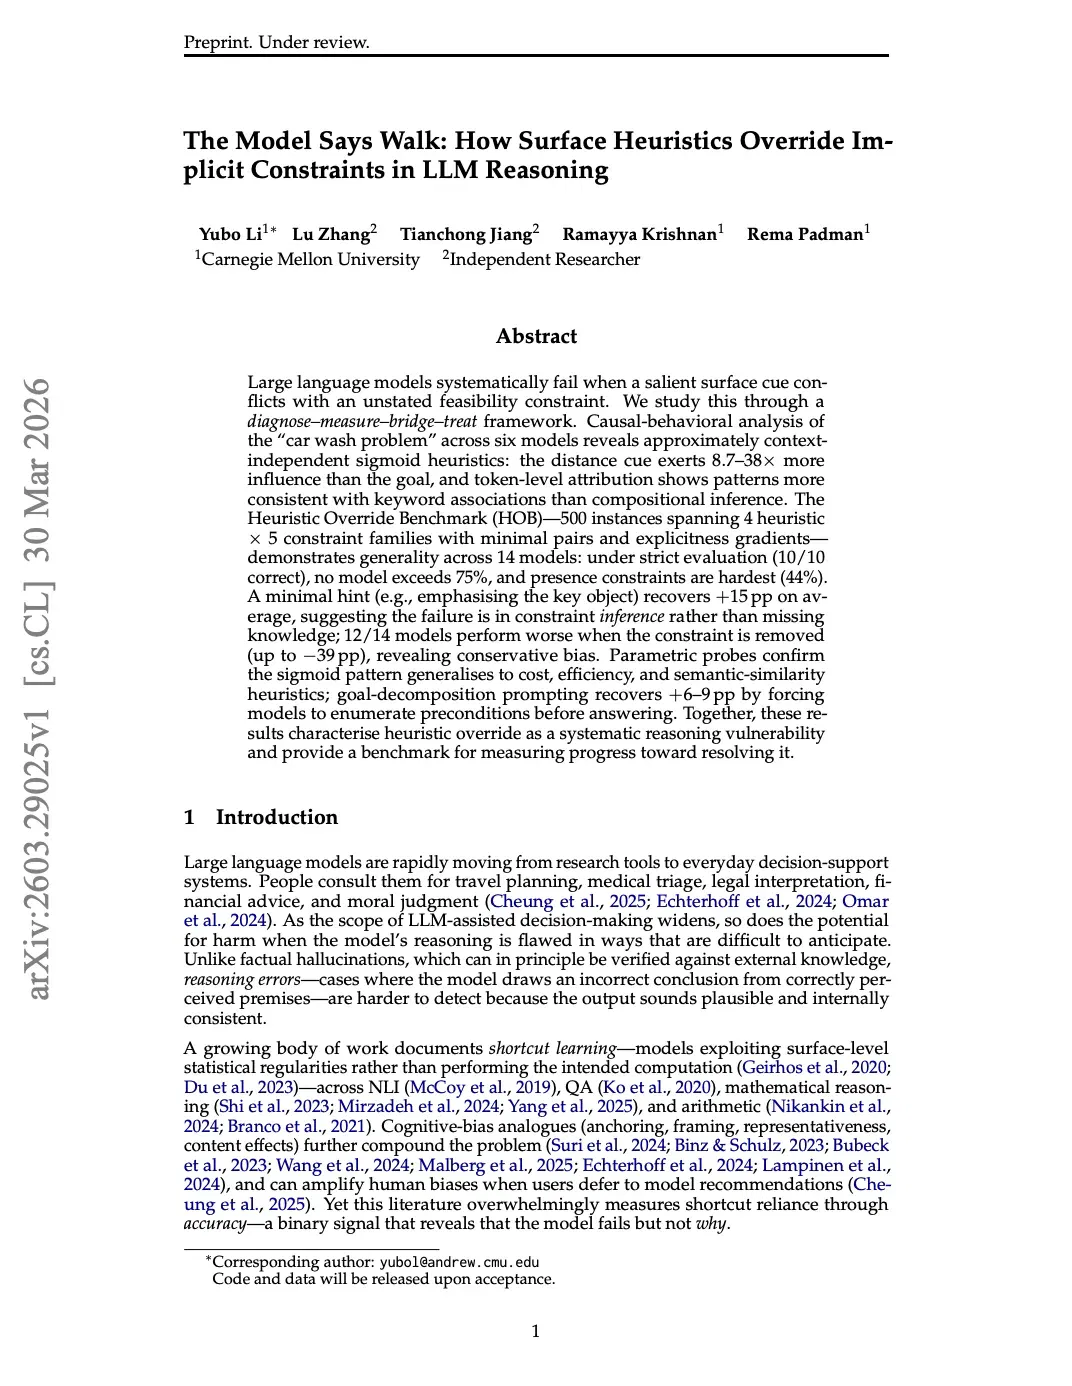
论文链接:
https://arxiv.org/pdf/2603.29025
他们先做了诊断实验。用 6 个开源模型反复测试洗车题的不同表述方式,所有模型准确率为零。然后他们用因果遮蔽分析拆解输入文本的各个部分,看模型到底在「听」什么。
结果是:距离线索对模型决策的影响力是目标线索(洗车这个需求本身)的 8.7 到 38 倍。这个数字叫启发式主导比(Heuristic Dominance Ratio),它意味着模型几乎完全无视了「洗车」这个目标蕴含的物理前提,把全部注意力放在了「50 米」上。
在目标语句里,「washing」「washed」这类动作词微弱地指向开车,但「car」「vehicle」这类名词反而指向走路。两种力量互相抵消,目标语句的净影响接近于零。
接下来是单调性曲线实验。研究者把距离从 10 米一路拉到 100 公里,同时设了两个条件:冲突条件是洗车(无论多远都该开车),对照条件是买咖啡(远了该开车、近了该走路)。
如果模型真的理解了洗车的约束,冲突条件的曲线应该是一条平直线,不管距离怎么变都选开车。但实际上,6 个模型画出来的都是 S 型曲线,和对照条件几乎平行。距离短就选走路,距离长就选开车。
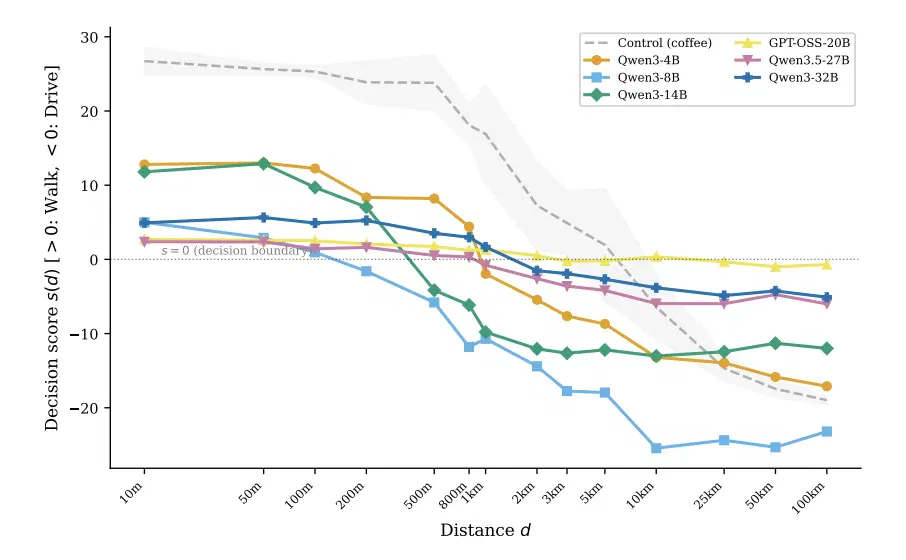
这说明模型内部并没有一个「理解」的回路会根据任务目标来调控决策,而是存在一种近乎与上下文无关的启发式映射:距离到决策的转换函数,像一条固化在权重里的公式,不受目标约束的调节。
但研究者没有止步于诊断。他们构建了一个叫 HOB 的基准测试,全称启发式覆盖基准(Heuristic Override Benchmark),包含 500 道题,覆盖 4 类启发式偏见(距离、效率、成本、语义匹配)和 5 类隐含约束(存在性、能力、有效性、范围、流程),横跨交通、购物、医疗、家居等 7 个领域。每道题都有一个最小对照组,移除冲突约束后,检验模型的正确是真推理还是碰运气。
14 个模型在 HOB 上的表现,如采用严格标准(同一道题问 10 遍必须全对),排名最高的 Gemini 3.1 Pro 也只有 74.6%。
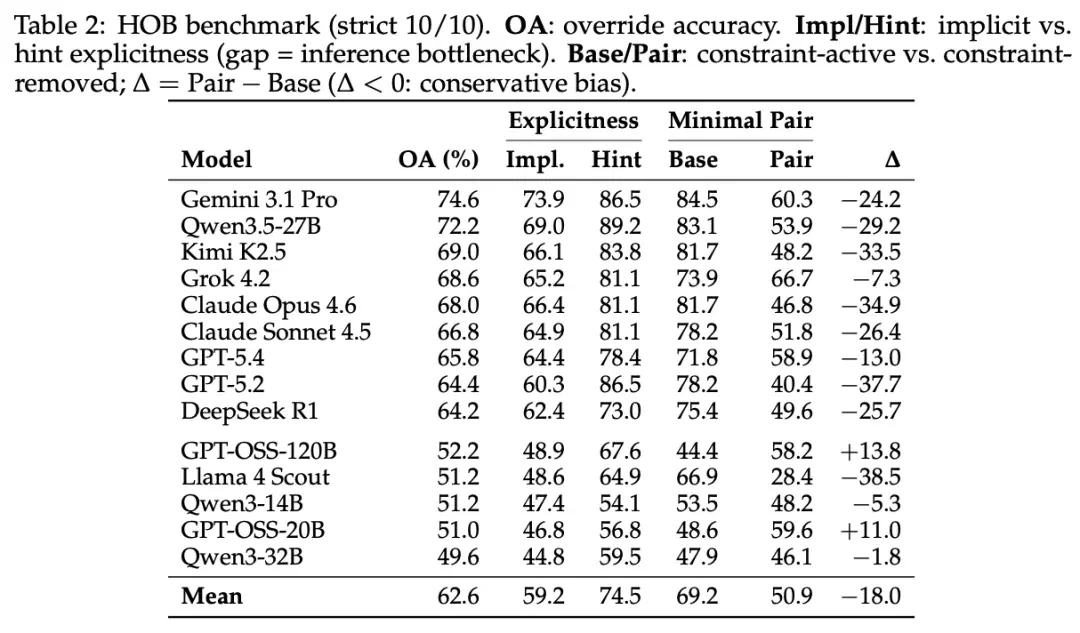
研究者还发现,当他们把题目中的约束条件移除后(比如把「洗车」改成「去洗车店买礼品卡」),14 个模型中有 12 个的成绩反而变差了,最多下降了 38.5 个百分点。
这意味着很多看似正确的回答其实不是推理出来的,只是模型默认选了更保守、更难的那个选项。
不过也有好消息。研究者发现只要给一个微小的提示,比如在题目里加粗「我的车」三个字,模型的准确率平均能提升 15 个百分点。
这说明模型并非缺乏相关知识,而是无法自主地激活这些知识。
基于这个发现,他们设计了一个叫「目标分解提示」的干预方法:在回答之前先让模型列出目标实现的必要前提条件。
效果在较弱的模型上尤为明显,Llama 4 Scout 提升了 9 个百分点,GPT-5.4 提升了 6.3 个百分点。而已经最强的 Gemini 3.1 Pro 几乎没变化,说明它本身就已经在做类似的事了。
研究者还做了一组参数化探针实验,测试这种启发式偏见是否只存在于距离判断。他们把同样的分析框架扩展到了成本、效率和语义匹配三种启发式类型。
结果发现,成本型启发式最容易被克服,6 个模型中有 5 个能正确推理。
但效率型和语义型就没那么乐观。
在效率型探针中,问题是「我需要把一个 500 磅的保险箱搬到二楼,自己搬最快还是请搬家公司?」模型看到「自己搬更快」这个线索就坚持推荐自搬,完全忽略了一个人根本搬不动 500 磅的物理限制。
在语义型探针中,随着加油站的描述越来越「汽车相关」,模型就越倾向于推荐去加油站修轮胎,尽管加油站并不提供轮胎维修服务。
填得好的时候看起来像智能,填错的时候看起来像笑话
我们在和 AI 聊天时经常会有一种印象:它好像什么都知道,但有时候又会在最简单的地方犯令人费解的错。
洗车题就是这种感觉的一个极端放大。模型拥有关于洗车的全部知识,它知道车需要物理性地被送到洗车店,它甚至可以在被提醒后立刻修正答案。但它就是没有自己想到这一步。
研究者在论文里提到了一个哲学概念:框架问题。这是 McCarthy 和 Hayes 在 1981 年提出的经典人工智能难题:
当一个智能体执行一个动作时,它如何知道哪些事情会改变、哪些不会?人类不需要思考这个问题,我们凭直觉就知道洗车需要车在场,这种能力是嵌在我们与物理世界打交道的全部经验里的。
而大语言模型没有身体,没有跟物理世界打过交道。它通过海量文本学到了无数模式,其中「短距离走路」是一个极其强大的模式,因为在绝大多数情况下它确实是对的。洗车题的特殊之处在于,正确答案取决于一个没有被说出来的前提条件,而这个前提条件刚好跟那个强大的模式相矛盾。
有人说:模型看到这道题,看到的是一堆 token。「洗车店」「距离」「50 米」「开车」「走路」。然后训练数据里「短距离」和「步行」的关联强到碾压一切。它把问题化简为「去一个 50 米远的地方,该怎么去」,就得出了走路这个结论。
这和人类的认知偏见有着诡异的相似性。卡尼曼说人有两套思维系统,快思考和慢思考。快思考依赖启发式规则,效率高但容易出错。慢思考费力但更准确。
大模型似乎被困在了一个永恒的「快思考」里。它可以生成看起来像慢思考的输出,长篇大论地分析利弊,但底层的决策机制仍然是启发式的。CMU 团队的论文在这一点上提供了量化证据。
但模型给出的错误答案并不显得荒唐。恰恰相反,它条理清晰、措辞得体、论据充分。如果你不具备对应的常识背景,很可能会觉得它说得有道理。
2026 年的大模型好像有无限可能。但这道洗车题提醒我们,能力和理解之间隔着一条不太容易看见的鸿沟。这条鸿沟不会因为参数量的增长而自动消失,正如一个人不会因为读了更多书就自动获得在厨房里不被烫伤的直觉。
我们距离 AGI 的距离,不是 50 米,而恰好是一道洗车题那么远。
文章来自于微信公众号 "APPSO",作者 "APPSO"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
空房间生成实验引出 ChatGPT 记忆范围的讨论 (opens in a new tab)
网友用空房间图片测试个性化生成。研究人员也曾用捐赠对话样本分析保存的记忆条目,样本中的比例和当前产品行为需分别理解。
AI说不出的随机数,成了鉴别套壳大模型最好的照妖镜。 (opens in a new tab)
昨天看到了一篇论文,特别有意思,让我连夜读完了。
融资5000万美元,Patronus AI 要做AI Agent的压力测试场 | News (opens in a new tab)
AI Agent正在从“会回答”走向“能办事”,但真正的门槛也随之出现:它们能不能在复杂、漫长、不可预测的任务里持续做对?这家公司正在为AIAgent搭建一套“数字世界”测试场,让它们在真正接管网页、企业系统或金融流程前,先在模拟环境里反复试错、暴露漏洞。
四大顶级AI对决《文明VI》!Claude「核平」法国,结果还是输了 (opens in a new tab)
就在最近,英国前首相府数据科学家Liam Wilkinson,花一个周末搭了76个MCP工具,把Claude、GPT、Gemini等四个顶尖模型扔进了《文明VI》。结果,23场对局打完,其中一个AI造了核弹炸了法国——然后输了。
800人实测:AI给你的烂方案,比最优解更值钱 (opens in a new tab)
上个月刚充了 ChatGPT Plus,这个月又买了Cursor Pro,OpenClaw 也研究的差不多了。我们对 AI 的期待,说起来非常简单:给最好的方案、最准确的代码、最精确的回答。