拍照即交互、专为Z世代打造,Chance AI做了世界首款视觉Agent产品
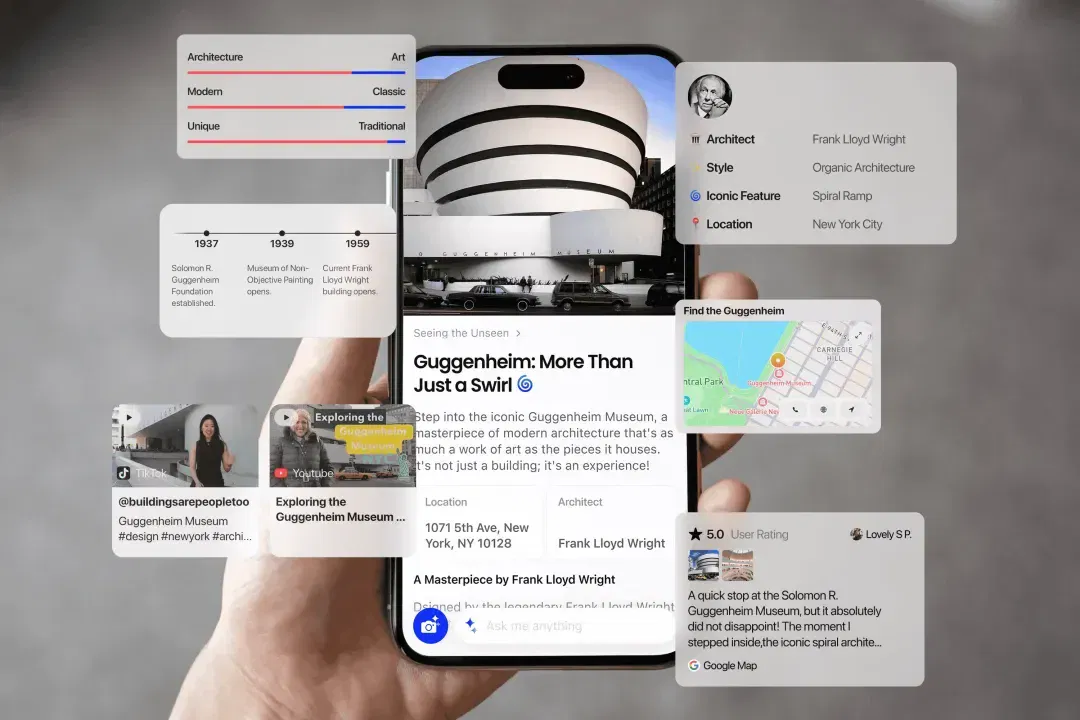
一款 AI 产品出现在了国际顶级的艺术展览中,而且是充当解说员的身份。Chance AI 作为这届博览会官方引入的首个 AI 产品,负责帮观众解读艺术品。观众举起手机,对准一幅画,拍照即交互,听 AI 解释:这件作品为什么成立,它背后意味着什么。
一款 AI 产品出现在了国际顶级的艺术展览中,而且是充当解说员的身份。
上周,亚洲当代艺术博览会 Art Central 落幕。Chance AI 作为这届博览会官方引入的首个 AI 产品,负责帮观众解读艺术品。观众举起手机,对准一幅画,拍照即交互,听 AI 解释:这件作品为什么成立,它背后意味着什么。
创始人曾熙给这套系统起了个名字「Visual Agent」。核心逻辑是,让 AI 先看懂,再开口。
认知科学 PhD 背景的曾熙,曾在一加、OPPO 和字节跳动做过十多年的产品与设计。他相信,尤其是 Z 世代的年轻人,天然地习惯通过图像和直觉去理解世界。
「AI 与人类不应该是一个输入框的关系。更直觉的方式是:我一看,AI 就已经理解我需要什么。」
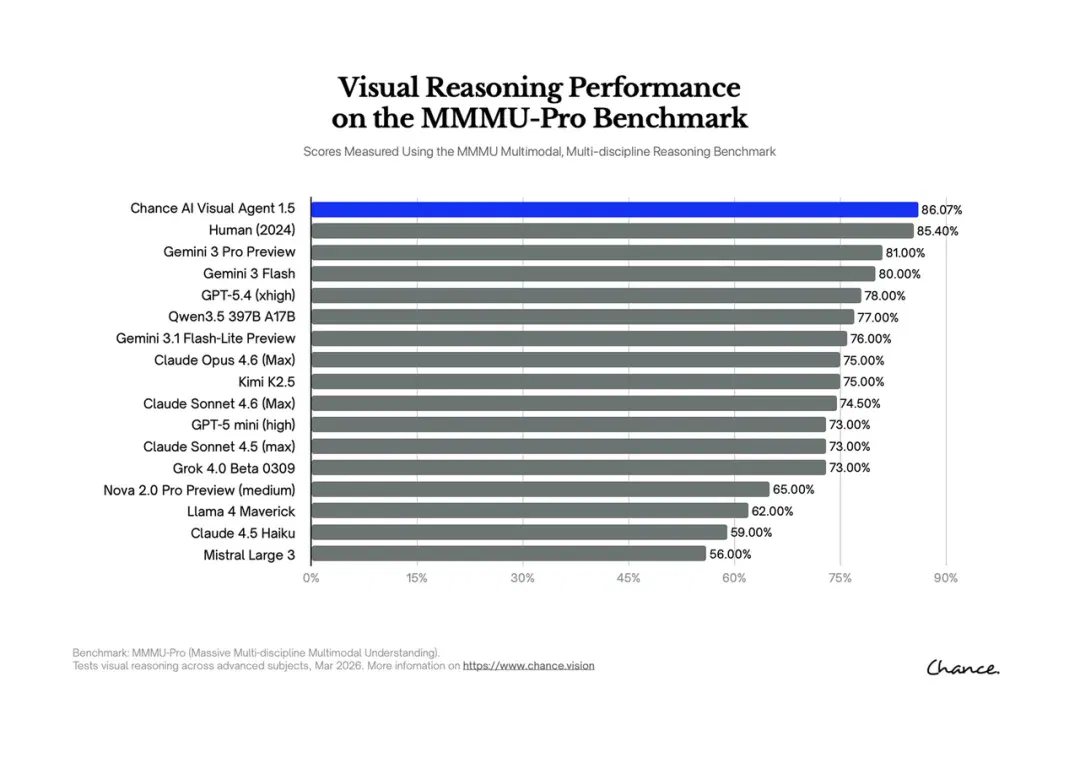
Chance AI 第一次把这套人类认识世界的方法,带进了 Agent 的 Harness Engineering 里。在视觉理解的核心 Benchmark MMMU 上,Chance AI 目前排名世界第一,准确率 86.07%,超过了人类评分(85.4%)和所有主流大模型。
以 Visual Agent 为切入点,Chance AI 发布后在推特上引起了 AI 行业不少硅谷大 V 的讨论,AK、Robert Scoble、Rohan Paul、Madza、Parul Gautam 等大佬都点赞转发。产品目前已有 20 万用户,高校 Z 世代人群居多。
再往下一步,Chance AI 想让 Visual Agent 成为下一代的 AI 终端入口。「视觉,才是人类最直觉的操作系统。」
以下是 Founder Park 与 Chance AI 创始人曾熙的对话,经编辑整理。
产品官网:https://www.chance.vision/
产品最初的 MVP 验证,
是一款导览小程序
Founder Park:简单介绍一下团队和你个人的过往经历。
曾熙:我过去在一加、OPPO 和字节跳动工作,做了十几年的产品和设计,主要都是在做消费电子方向。从手机硬件到手机操作系统,再到 AI 应用,加起来做过差不多近 6 亿级别用户规模的产品了。也是在字节的那一段时间,我开始更深入地参与 AI 产品的构建,尤其是多模态相关的探索。
我自己的学科背景其实有一点不一样,PhD 研究方向是认知科学。我一直在思考一个问题:人是如何最直觉地理解这个世界的?这也是我后来做 Chance AI 的起点,不是说 AI 能做什么,而是反过来推导:AI 如何帮助人们更好地在现实生活中去理解世界,然后进入下一步决策。
团队方面,大部分是我在这三段经历里认识的、合作特别好的同事。尤其是负责视觉推理和算法的、海外增长的同学,都是之前共事的同事。
Founder Park:什么契机决定离开大厂,全身心投入 Chance AI?当时看到了什么机会?
曾熙:主要是有三个时刻。第一个是我在字节做豆包的时候。2024 年的时候发现很多人喜欢在豆包里上传图片,然后和豆包聊。当时隐约觉得一种新的交互习惯要出现了。
第二个时刻是 VLM 的出现。GPT-4o 第一次有了很强的多模态能力。我们当时就在思考,基于 VLM 能不能做出应用层的东西?很多人基于 LLM 做东西,但还没有人基于 VLM 做东西。
第三个是真正让我们下定决心的时刻。2024 年底,我们几个朋友在深圳做了一次 Andy Warhol 的展览。我们做了一个 AI 导览小程序,所有人进来后扫描会场里的画,然后与作者进行对话。展览结束三个月后,我们发现竟然还有 1500 个用户持续地用这个小程序去看生活中的东西。我们去回访这些用户,发现他们用来给小朋友看花草、看名胜古迹、看收藏的球星卡和潮玩,或者看想买的东西。
当时我们认为这是真实存在的需求。从那之后,到了 2025 年初,我从字节离开,决定全职做这件事。
Founder Park:怎么介绍目前你们的这款产品?
曾熙:Chance AI 是一款视觉 Agent 产品。打开 App 之后,没有输入框,只有一个相机。拍照即交互——对准花草、名胜古迹、球星卡,或者任何你感兴趣的东西,AI 就开始工作。
我们不叫自己「AI 相机」或者「视觉搜索」,而是 Visual Agent。因为在我们理解里,它是一个更主动的、和你一起参与的系统——它不是等你输入再响应,而是参与你整个看世界的过程。核心逻辑是:让 AI 先看懂,再开口。
Visual Agent 的核心,
是帮用户构建一套理解世界的系统
Founder Park:Chance AI 提出了「Visual Agent」这个概念,它和传统的视觉识别工具,比如 Google Lens 的区别是什么?
曾熙:简单来说,Google Lens 或者别的工具,比如关于识别花草的、鸟的、红酒的,统称为「识别工具」。它们的目标是把东西识别清楚以后,把你带到搜索或带到交易。Google Lens 一开始就是为了电商而生的产品,找同款,所以它的结果就是链接和价格。
我们观察到的问题是:用户很多时候并不是想知道这个东西是什么,而是想知道为什么它长这个样子?它为什么有意思?它跟什么样的文化、历史故事有关?所以我们把重点放在解释层上面,不是描述层面。
假设你的偶像是乔布斯,我跟你说「这是乔布斯最喜欢的某个厨房料理机,因为他小时候家里就是用的这个款式,后来影响了他做 iPod 的经历」,这个时候你的感受会区别于讲表面信息的时候。这个我们已经验证过了,尤其是潮玩,都是塑料,为什么某些潮玩卖得特别好而某些就一般?因为某个潮玩代表了某种情绪,但那个情绪是需要被诱导出来的。
这是下一个时代新用户的行为模式,所以我们是为这群新用户做的新产品形态。它不仅仅是识别,它需要把感知、上下文、社会共识全部连接起来。
Google Lens 是一个工具,我们是在帮用户构建一个理解系统。因为我们相信一切行动都是建立在理解之上的。一个你不理解的东西,你不可能想要买它、拥有它或者想去那个地方。这是很大的区别。
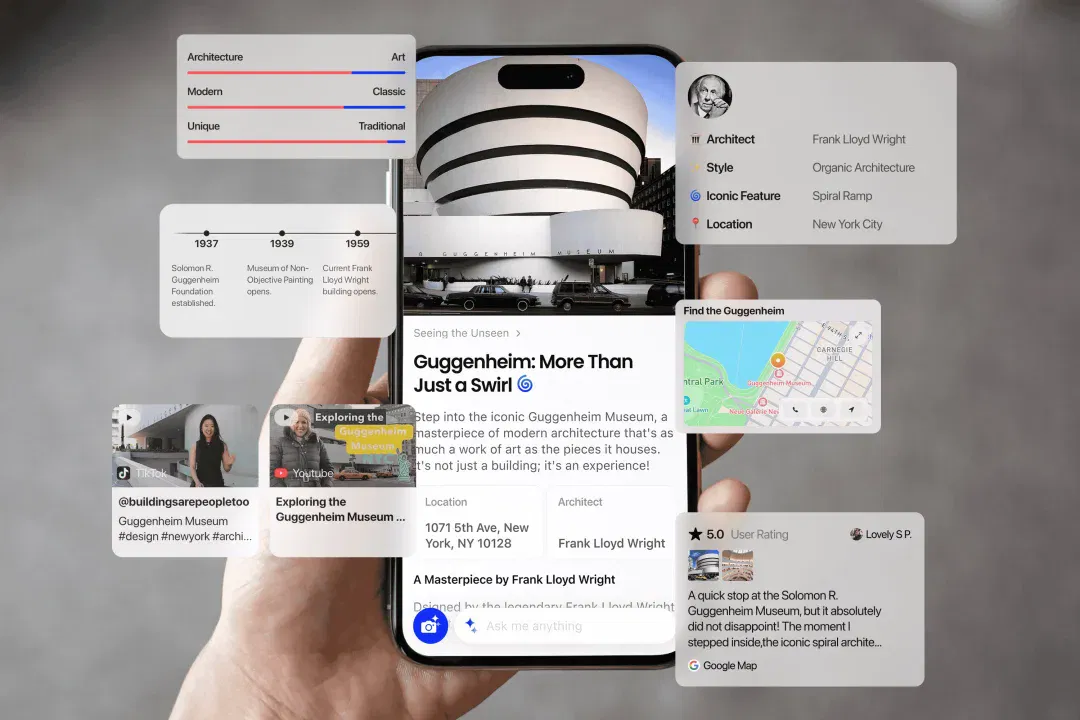
Founder Park:那 Chance AI 和普通 ChatBot 的区别是什么?
曾熙:这些通用模型的视觉能力,本质上对它们来讲是一个附加能力。它们没有针对多模态能力做任何优化,核心仍然是对话,输入框,用户先提问,再调用部分视觉作为输入的一部分。我们认为这是不合理的,因为真实世界不是这样的。真实世界是你看到一个东西,你甚至都不知道该怎么问,你只是觉得「我想关注这个东西了」,有一瞬间的好奇心。
我们的做法是贴近真实世界,从你看到的世界开始,而不是从问题开始、从输入框开始。这带来一个很本质的区别:对 Chatbot 来讲,一进去必然是一个输入框;对我们来讲,一进去就是相机,要么你就拍,要么你就上传图片。本质上它不是能力的差别,而是产品方向的选择。
Founder Park:相当于 ChatBot 里的视觉识别只是文字交互中的附加功能。但对你们来说,视觉本身就是用户理解世界的最主要方式。
曾熙:对。如果做类比的话,有点像 ElevenLabs。今天 Gemini、GPT、豆包全部都可以生成音乐了,为什么 ElevenLabs、Suno 还是能获得非常好的表现?因为它们起步早,有非常垂直的定位,然后随着月活越来越多形成正向飞轮。对我们来说也是一样,今天比如用户要看穿搭、看审美、看艺术品或看潮玩,已经没有任何通用模型能比我们更强。
Founder Park:也就是说你们已经基于用户迭代出来了很多场景,比如 OOTD 穿搭、看肤色这些,涌现出了很多用户自己建的场景。
曾熙:没错,而且这些用户的需求是大厂不会干的事。所以我们一定得绕开大厂的辐射范围,离用户很近、对用户的反应更快,这也是我们的「护城河」之一。
Z世代天然更习惯用视觉去表达和理解世界
Founder Park:Chance AI 面向的核心目标人群是 Gen Z,你们当时是怎么确定他们是第一批用户的?
曾熙:还是一个被选择的过程。我们有很多假设,最后是因为这批人的表现最好,所以圈定他们作为早期种子用户。我们发现他们有一个共同点,给他们一个标签叫「艺术的生活家」。他们不是那种艺术家,但一定是那种对生活很有追求、很有品质的人,很在意自己的 Image。
我们发现这群人都有这个特性,我们叫做视觉驱动型用户。大部分是艺术学院或文理学院的学生。他们很喜欢用表情包、meme 图片、视频沟通,而不是通过邮件或长文本。很多时候他们不是在表达一个问题,更多是在表达那个 vibe,特别抽象,但又特别能引起共鸣。
这是我们最后沉淀下来发现表现最好的用户群。比较有优势的是,这群用户恰好又是在社交媒体上比较活跃发声的用户,自然就给我们的增长带来了助力。所以我们并不是把 Gen Z 广泛地定义为目标用户,而是因为这群人更习惯用视觉去理解世界。
我们在产品上也往这群人靠拢,很注重审美、文化风格这一类的东西,而不是告诉你一个客观参数。当他们使用我们产品的时候就觉得很自然,不需要去想,因为一想就变理性了,一旦触动思考、要想怎么组织一句话,就变得很理性,跟他们追求感性、追求 Vibe 的特质是违背的。所以这群人使用我们产品的学习成本几乎为零,这也是为什么他们很自然地成为了我们的种子用户。
Founder Park:你们现在的用户规模大概是多少?增长主要靠什么?
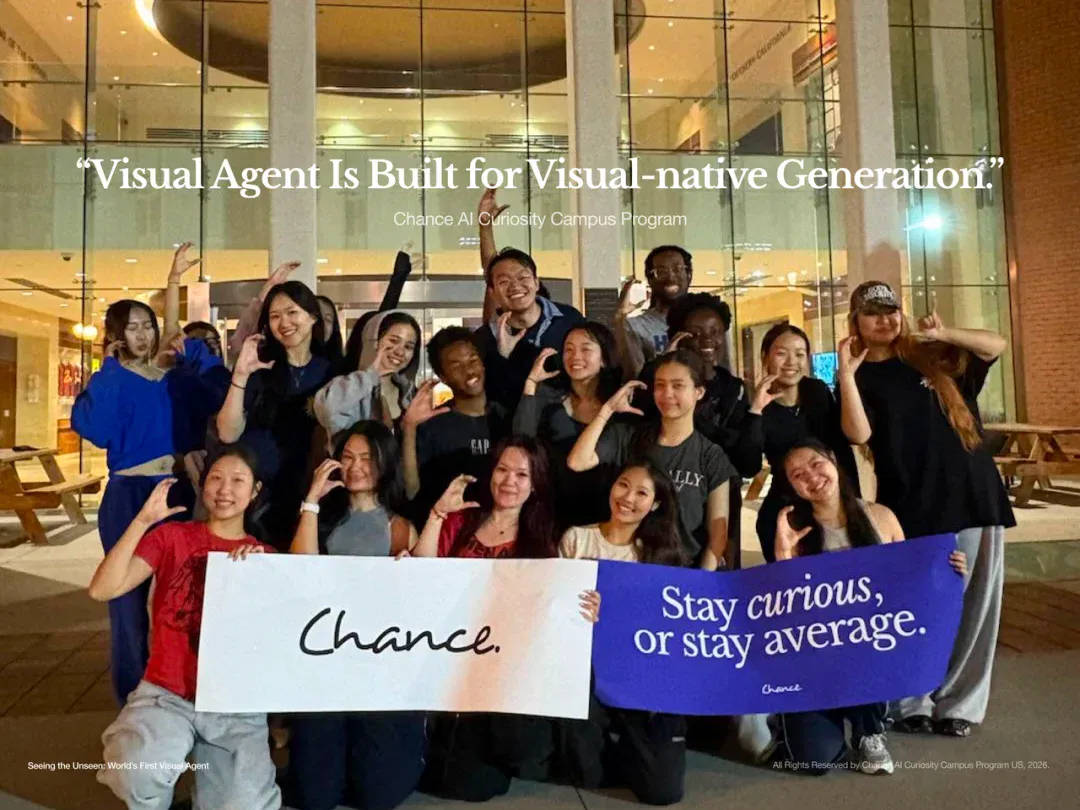
曾熙:我们现在大约 20 万用户,其中差不多 15 万是 25 岁以下的年轻用户。
最主要的增长来源是校园计划,靠学生的口碑传播。我们会鼓励不同校园里的活动。比如 sponsor 一些资金支持,二三十个学生一起去逛某个地方,逛的过程中使用我们的产品,最终坐在一起在咖啡店里分享发现了什么有趣的东西。
Founder Park:你们的预期是一直服务大学生群体,还是陪伴他们进入社会后继续服务?
曾熙:我们服务的是 Visual Native 的人群,没有那么明显的年龄界限,只是现阶段他们正好处在 18 到 25 岁这个年龄段。我相信即使他们步入社会以后,也还是保留这个用户习惯的。接下来可能 15、16 岁的人也会更加 Digital Native。
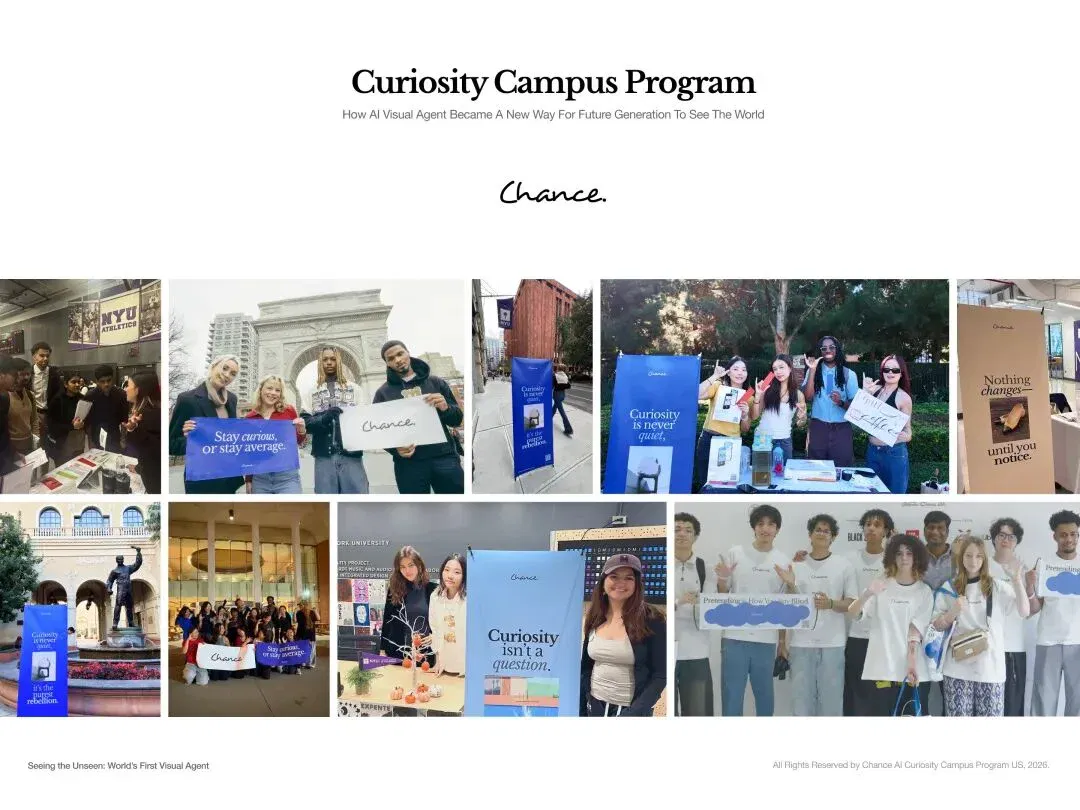
Chance AI 的各类线下校园活动
Founder Park:不同地区的人群在使用场景上会有区别吗?
曾熙:会有,但差异体现在看什么,而不是怎么看。美国用户大部分看穿搭购物、化妆品、潮玩。欧洲用户很喜欢看艺术品、建筑、展览、书籍封面,一个法国学生可能会拍意大利语的书籍封面,然后去读内容。拉美用户更偏神秘学,看手相、看面相,每天出门前拍一拍来决定今天要注意什么。而且他们会把穿搭和神秘学联系在一起,根据今天的运势决定要戴什么颜色的首饰。
Founder Park:如果想从现在的 20 万到 100 万、500 万,大概是怎样的增长路径?核心靠什么实现用户增长?
曾熙:短期以产品驱动为主。口碑传播在达到 100 万用户以前可能都不会改变。因为这个产品的核心不是获取流量,而是需要帮助用户形成一种新的使用习惯。如果习惯没有建立,去做投流、买量是没办法放大的。
增长路径现在比较清晰,把核心场景打透。除了日常的视觉理解以外,比如穿搭场景、神秘学场景、旅行场景、购物场景,我们要围绕这些场景把它做深。现在只能说有一个苗头,看到了努力的方向,但还没有拼尽全力去做深。
然后再通过内容和社交去做扩散。比如我们现在穿搭场景里有直接一键帮你生成 Instagram Story 的模式,除了给你打分、给你颜色搭配建议、饰品建议以外,更重要的是有一键变成 Ins Story 图片的功能。
不是效率工具,
是 lifestyle 的视觉伴侣
Founder Park:一开始预想产品要做成什么样?早期优先解决什么问题?
曾熙:很坦白地说,当时是没有的,我们只是知道「看世界」是一个比较具体的需求,但具体看什么我们完全不知道。我们认为要做好的事情就是把架构做好,用户会告诉我们他们选择看什么东西,看得多了以后再针对性地优化。
比如穿搭这件事,我们一开始并没有帮用户看穿搭的 Visual Agent,而是穿搭照片的占比多了以后,我们才专门针对穿搭去做优化,是这种反哺回来的形式。这来源于我在一加时候的社区共创基因。我觉得这教会了我非常多,如果你还没想清楚,没关系,最重要的是赶紧先把你的能力丢出去,用户会告诉你他们需要什么。
Founder Park:你们最初上线的版本,先解决的是让用户能拍照跟世界进行交互,这个交互形式是从一开始就确定了吗?
曾熙:对,这个架构从一开始就确定了。我们有一段时间在首页加了输入框,结果那段时间产品的表现特别差。
Founder Park:加输入框反倒效果差了?
曾熙:对。我们加输入框加得很次要,作为搜索框的形式存在,结果让用户失焦了。很多人直接把它当成 Chatbot 来用。所以我们把输入框去掉之后,这群用户离开了,但反而长期留存变得更好了。
Founder Park:你之前提到「提示词是为懒惰的 AI 准备的」,那在图片生成后的追问环节,这种「基于单图的对话」与传统 Chatbot 的区别是什么?
曾熙:所有后续追问都是基于同一个主题的。就像我所有追问都是基于「我今天穿什么衣服」这个主题,所以它会针对这个有很强的上下文,它知道我前面试了多少套、每一套之间细微的区别是什么,从而判断你是不是正在犹豫去的场合不知道穿什么。我们认为这是很天然的、直觉的。别的 Chatbot 里开一个对话框是一个主题,对我们来讲每张图片就是一个主题。
Founder Park:那不同的图片,比如看手相、OOTD 这些,是直接上传一张看手相的图就可以,还是需要选一个场景才会进入对应的功能?
曾熙:两种都有。有些强风格化的东西会给你推荐,比如你把某个产品丢进去,有可能是想买它、想吐槽它、想给它写一首诗,这时候我们会做推荐。但有些很特定的场景,比如拍一朵花或拍手纹,我们就很确定地知道该导入到哪个功能。你问的这个问题其实很本质,本质上我们不应该再有推荐,但限于 VLM 的能力,目前不得不有一个过渡状态。
Founder Park:如果用户输入的信息只有一张图,你们怎么去理解用户的意图?
曾熙:这又回到我 PhD 研究的课题上了。视觉一定先于语言,当你看到一个东西的时候,你可能都没想好怎么组织语言,但你已经有一个念头了。所以我们认为,你跟看到的东西的交互发生在后面,输入框是发生在追问里,而不是你产生意图的那个瞬间。
当你看到一个东西的时候,至少百分之八九十的意图已经能命中,你看到一套衣服,大概率想买它或想知道适不适合自己,可能有百分之一二十的概率是你想把它买给你的女朋友。这就需要长时间的交互,我才知道你是男生还是女生,为什么一个男生要拍女装?随着第二次、第三次交互,我就能知道原来你是在帮别人挑礼物。
所以意图在你看到图片的瞬间,以及长期交互的过程里,会变得越来越准、越来越懂你,是一个收缩的状态。
Founder Park:所以,拍的时候用户自己可能也没有很明确的意图,更多是直觉。拍完之后的下一步交互,是用户在明确自己的意图,Chance AI 也在更明确地理解用户。后面的交互是大家逐渐把意图收敛的过程。
曾熙:没错。分享一个核心用户群数据:我们有一个指标叫单次核心任务流的交互时长,是 6.4 分钟。也就是说,当用户上传一张图片触发一个任务流后,他跟这张图片的交互时长是 6.4 分钟,基本上每个人会进行 3 到 5 轮对话。
Founder Park:所以,Chance AI 瞄准的用户不是那种「我很明确地要做什么」的用户?
曾熙:对,所以它并不是一个效率工具,更偏 lifestyle,是一个视觉伴侣。我们的用户都是北美的年轻人。他们可能上课的时候用 GPT 写课件、写论文,但出去玩、跟小姐妹喝下午茶、跟兄弟逛球鞋店,基本上都是 Chance AI 的场景。
Chance AI 是一个 lifestyle 的 companion,会陪你一起看世界,「看」是它最重要的能力。
Founder Park:你们会怎么定义这个产品最终给用户的价值?
曾熙:它是一个非效率场景的、帮你赋能生活方式的 AI 产品。分享一个例子,产品在去年年底迎来了一波增长,原因是快到圣诞节的时候,非常多人要挑礼物,就用 Chance AI 给自己的男女朋友或家人挑礼物。
把人类看世界的方法
带到 Harness Engineering 里
Founder Park:在技术架构方面,你们是怎么做的?
曾熙:我们 post-training 了一些开源的 VLM,用在不同的场景里。但对我们来说更宝贵的还是我们做了一套 visual 的 harness engineering。
我们这套技术架构,本质上是从人类如何真实地看世界出发,然后把这个过程映射到我们的 Visual Agent 里。在人类的认知过程中,其实有一条非常清晰的处理链路:
首先是视觉信号的采集——通过眼球和视网膜接收外界的光信号;随后,这些信号通过视神经被转化为神经信号并传递到大脑;接着进入视觉皮层(visual cortex),从初级视觉区(V1)到更高层区域逐级处理,完成对形状、结构、语义、空间关系等信息的整合与理解;最后才进入决策,这个东西我要不要拿起来?我是一只手拿还是两只手拿?它烫不烫?
你会看到分了四层:信号采集、信号传递、视觉皮层处理、大脑决策。现在其他 AI 产品的问题是,他们想让眼睛做思考,把这些步骤混在一起,想用一个模型实现从看见到思考的全链路。
我们的 visual agent 在技术上没有什么秘密,就是把这四个链路拆开做。难的是我们第一次把人类认识世界的方法带到了 agent 的 Harness Engineering 里面。
Founder Park:每一步都会有一个大模型来处理?
曾熙:对,它会根据看到的物体在每一步决定是调用云端模型还是我们自己的 post-train 的模型,调用哪个 skill。比如发现用户看的是衣服,衣服对趋势比较敏感,就会去调用一个能找到 Instagram trending hashtag 的 skill。每一层都发生自己的判断。它是一个工程能力,不是把所有东西做到一个模型上面。
这才是我们理解的 AI,因为人就是这么看世界的,我们只是把人看世界的方法复制到了技术实现上。我们一开始花了很多时间,来摸清楚这件事。
Founder Park:中间走了什么弯路?
曾熙:走了特别大的弯路。我们一开始也想用一个模型做所有事情,然后发现怎么设计都有问题,理解能力强了,就调用不了 skill;skill 强了,视觉理解的本质又没了。特别难,中间发生了非常多这种事情。
最后主要还是我 PhD 在认知科学方面的知识启发了我,为什么我们要期待把眼睛和大脑做成一个东西?这可能一开始就是错的。
Founder Park:感觉比起你们现在的模型架构,底层的 VLM 反倒不是核心优势?
曾熙:没错。这就是为什么我们在 MMMU Benchmark 上能做到全世界第一。对我们来说,VLM 用谁家的都不重要,哪个便宜就用哪家,无论用哪家都能达到那么好的效果。我觉得这才是我们在技术层面有价值的地方。
Founder Park:你们大概什么时候摸索清楚这个架构确实能跑通了?
曾熙:从 2025 年初到 2025 年中,我们一直都在研究这个问题,都没做产品。而且 2025 年初 VLM 能力更差,凭什么我们视觉理解能力能比别人好?真的就是后面做的这套 Harness。
Founder Park:感觉这个 Harness Engineering 有点类似于把人类本能的看东西、理解东西的逻辑复用到了 AI agent 的流程里面。复用的是人类本能的流程,而不是我们自己的实践 SOP。
曾熙:是的。为什么烫杯子不能碰?你什么时候决定要不要联想回以前的记忆?这个判断逻辑很重要。如果判断要联想,可能要花很多时间和 Token,怎么判断联想还是不联想?要不要在过往的 Visual Memory 里做匹配?这又得回到用户,靠用户反馈,我们才能有一个阈值去调整什么情况下要联想、什么情况下不联想。
我们做的事情在 LLM 领域不是什么新鲜的事情,但的确是第一个把这些方法带到视觉领域的公司。
Founder Park:所以在这套 Visual Agent 里,有 VLM 也有 LLM,互相搭配最终产出结果?
曾熙:是的,每个节点里最终看到的结果,最多的时候能调用 6 到 8 个模型。
甚至结果会因为每个用户的品味不同而异。我们有一个功能,是根据你看到的图片来给你推荐音乐。这是很多人用的一个场景:我要发一个 Instagram Story,要配一个背景音乐,怎么知道我看到的东西跟音乐之间是正相关的?比如我看到一个洛杉矶的落日,它就给我配了一首落日飞车那种很舒缓的 City Pop 音乐。看上去很直觉,但我们在里面做了大量的工程,怎么把一个图像找到很适合这个图像 Vibe 的音乐,然后推荐出 Spotify 链接。虽然它只是结果页里的一个小框框,但真的很不容易。
最后产出的结果也很偶然,相当于我们做好了一套 Skill Set,让模型自己决定要调用什么。
Founder Park:最近流行的 OpenClaw 是用 MD 文件来储存 context。你们是怎么存储、管理用户的 memory 和 context 的?
曾熙:我们没办法用单一的文件来做用户的记忆存储。在视觉记忆方面,我们并不是把每一张图都变成你的记忆。我们会把图片分成三个级别的不同像素。比如一张图片,在后台会被压缩成 100x100 的小方框,人眼看上去是没有意义的东西,但模型之间能理解。我们要确保 agent 内部之间用最小单元进行沟通,传输的只是 100x100 的像素就能完成信息传递。
某些场景下我们会用中等尺寸的图片,比如 500x500,进行思考部分,到展示给用户时才回到原尺寸。
Founder Park:所以你们是用视觉图片的形式在不同 agent 之间做信息传达,不是在一开始就转译成语义文本来传播?
曾熙:我们去年做 memory 的时候,就是把图片拿掉变成纯文本,结果发现效果特别差。纯文本是累积型数据,越用越多,可能就有几百个 MD 文件了。效果差,沟通效率也低。
后来我们发现,把文字大量压缩成低像素图片之后,模型间的沟通效率反而提高了,效果又变好了。
我们发现一个很哲学的问题是,视觉才是最高效的沟通媒介。DeepSeek 发过一个 OCR 的模型,相同的 100 比特信息,变成文字传输快还是变成一张图传输快?他们的结论是变成图传输快,跟我们的结论完全一样。但他们主要聚焦 OCR,把文献语言图片化,我们面对的可能更复杂一点,除了 OCR 类图片,更多的是那种说不清道不明的 Vibe。
你必须离用户很近,
才知道产品下一步是什么
Founder Park:Visual Agent,跟 Manus 或 Claude Code 这类生产力、工具型 Agent 有什么区别?
曾熙:我们把它定义成 Visual Agent,最重要的点在于它是一个能和你一起看世界的 Agent。我们不叫自己 AI 相机或视觉搜索,而是叫 Visual Agent,因为在我们理解里它是一个更主动的、和你一起参与的系统,它不是一个响应式的输入,而是参与你整个看世界的过程。
具体来说有两个很大的变化。第一是连续性:不是一次性的识别,而是一个持续的理解过程。它知道你上周的穿搭、三天前的穿搭、你买过什么东西。它会建议「你可以试一下刚买的那双蓝色鞋子,更配你这套蓝色西装」。
第二是它具有行动能力。比如我看到一个活动海报,它可以帮我加到日历里;看到一个菜单,它可以帮我点菜;看到一个商品,它可以全网比价找到最合适的购买链接。具有行动能力对我们来说非常重要。真正的闭环是要完成一个行动。
Founder Park:对 Agent 来说,看懂可能只是第一步。那看懂之后,接下来要提供什么价值,你们有判断或者预期吗?
曾熙:举个具体的例子。有用户开始用我们看球星卡来了解卡的稀有度和历史。但他看懂之后想炫耀给自己的圈子,所以我们给球星卡做了一张海报式的电子证书。然后他说「我要发到 Instagram story 和 WhatsApp 群组里」,我们又加了一键分享功能。最后他甚至想看看别的网站上它值多少钱,可能有一天想卖掉。
它是一个你必须离用户很近,才知道下一步是什么的过程。
Founder Park:怎么定义离用户很近?
曾熙:我们现在和美国 6 所大学里的不同协会,都有很紧密的合作关系,所以能很及时的通过调研了解他们的场景,从醒来到睡觉前什么时候打开摄像头、每次打开摄像头干什么、预期完成什么任务、哪些是我们能做的、哪些现在做不了但以后有可能做。这种敏感度也是我认为我们现在最大的护城河。
和 AI 一起看,
天然就是下一个时代的 AI 终端入口
Founder Park:Chance AI 目前有十几个功能模块,从艺术分析、穿搭、菜谱,再到看面相。哪些场景做,哪些场景不做,你们是怎么取舍的?
曾熙:首要考虑的因素还是用户。用户会告诉我们,我们最主要做的是把能力架构做好,确保你扫的时候不会崩,10 秒钟就能出结果而不是等一分钟。里面涉及不同的数据、不同的搜索能力、不同的 RAG、不同的 MOE,都已经在那了,但怎么用靠用户的想象力。
用户需求和我们能实现的能力之间有「重合点」,这个重合的地方就是我们会去做的功能。
Founder Park:那你们观察到用户在 Chance AI 主要在做什么?
曾熙:现在的用户行为前三,第一是和你的图片互动,大概占到差不多一半的时间,拍一张图以后不断追问上下文、跟它说话,从而形成判断、形成行动;第二是看首页内容,会跟内容互动、留评论、回复,更多的是学习,看别人怎么用。原来这个东西也能拍飞机,能拍护肤品,能看艺术品,它起到了一个低成本教育用户的展示区作用;第三是看自己拍过的内容。
现在的用户行为跟我们现在产品形态的设计是完全符合的:第一拍照交互,第二看首页探索别人拍的和不同玩法,第三看自己过去看过的东西。
Founder Park:用户看自己过去拍的东西是高频行为?
曾熙:是的,有点出乎我们意料。我们发现有的同学已经把它当成一个专属剪贴本来用了。比如有一个日本用户,很神奇,他喜欢收藏昆虫标本,有一天拍了 180 次,第二天拍了 160 次,把自己收藏的所有标本都输进去了。
有点像 AI native 的 Pinterest,Pinterest 是根据像素决定分类,我们是根据图义来分类的。它能自动把每个类别的上下文拉过来,比如「这是什么亚热带的什么虫,它跟你收藏里的某个虫是同一个产地的」。Memory 部分的使用时长越来越多,使用时长多的用户留存极高。
Founder Park:现在有一批人群在高频使用这个产品,你们会把它定义成 AI 时代的一款社交产品吗?
曾熙:社交可能是它的某一个过渡态,因为它确实能帮助相同兴趣的人连接到一起。这是我们很开心看到的,现在很多人在社交平台上大部分内容是被动接收的,算法决定了你看到什么。但我们更鼓励的是,先主动去发现真实世界里的东西,然后我帮你找到也喜欢这个东西的人,你们之间产生交流。
在这个阶段,社交不是我们最重要的东西,可能用户达到 100 万之后,社交会形成一个很重要的形态。
Founder Park:你们会怎么看待这批用户对 Chance AI 的定位?
曾熙:渐渐地它会变成一个习惯。我们想培养的是用户习惯,当他未来想到要看什么的时候,先想到和 Chance AI 一起看。我们希望在这个阶段尽量多地让他们给我们反馈,无论是产品上的、数据上的还是模型能力上的,有了这种反馈我们的飞轮才能转起来。
对我们来讲最宝贵的是「和 AI 一起看世界」这个行为,在手机上它是不太自然的,但到了下一个时代的 AI 终端,它就会变得非常自然。想象一下你戴着 Ray-Ban Meta Glasses,很自然地问你「你怎么看那个?」AI 因为很懂你,「我觉得你穿那个不好看,你家里已经有个类似的了,再买很多余。但刚刚那个我觉得挺好看的,你怎么不考虑一下?」就开始跟你聊。这个场景就很自然了。
Visual Agent 最终会成为一个新的操作系统
Founder Park:在下一阶段,AI 硬件天然就有视觉入口,甚至 Visual Agent 本身也能成为一个新的 AI 入口。你觉得这件事真正发生,还需要哪些条件?
曾熙:这个问题我们也经常在思考。首先能确定的是,未来 AI 硬件的终端形态一定是和用户一起看世界,根据你看到的东西来进行交互,这是确定的,不确定的是时机。
我们认为目前的卡点在三个地方。第一是基础技术,VLM 今天已经有了,但还没办法做到超级实时,或者在很低成本的情况下瞬间完成电影里那种感觉,这部分我们一直在关注,也一直在等待;第二是硬件供应链的成熟,目前我们判断还没到爆发的周期。即使 Meta Glasses 已经卖了 200 万台,但离真正成为每个人日常使用的、像手机一样级别的产品,还有一定距离;第三是用户习惯,用户有没有养成和 AI 一起看世界的新习惯。年轻用户其实已经有了,但要扩展成大众市场,主要还是看那群习惯了文本交互的用户,他们切入视觉交互会不会有阻碍。
这三个考虑点是我们正在观察的。我们很开心地看到这件事其实已经正在发生了,只是近还是远,现在还在观察中。
Founder Park:你觉得 Visual Agent 最终会是一个什么形态?硬件、操作系统、还是 APP?
曾熙:我们理解它一定是一个操作系统,就是电影《Her》里的那个 Samantha。
Founder Park:如果最终形态是操作系统,会不会更依赖于 LLM 的智力提升?
曾熙:LLM到今天已经很成熟了,基本没有什么卡点。反而要回到生活场景上,是有困难的,Claude Code 很难帮你一起去买一个雪糕,或者跟你一起看落日。生活场景,才是大众市场的最主要场景。
我们的判断是:今天文本场景很成熟,很多大厂在里面解决基础问题。反而是文本之上的视觉层面,目前还没什么人看到,也没什么人在上面努力。
Founder Park:Visual Agent 和 ElevenLabs 这样的 voice agent,是什么关系?
曾熙:互补。我相信最终是没有模态之间的区分的。对用户来说,不会分什么是文字、什么是语音、什么是图片,最终都会混合成为一个正常的输入输出系统。有点像看电影,你不会在意是声音让你笑还是台词让你笑。
Founder Park: 那未来你们会做硬件吗?
曾熙:迟早会做。做硬件对我们团队来说反而是舒适区,供硬件产品定义、软硬结合用户体验、全球市场产品 GTM、生命周期管理等,团队有丰富经验。难的是现在这个阶段,先把这一套视觉思考的大脑搭建好。比如 Meta Glasses 你现在戴着看黑色水壶问「这是什么?」,它跟你说「这是一个黑色的圆柱形物体」,这是无用信息。它们离真正的价值差得太远了。
FOMO 的是效率不够快,
而不是终点方向
Founder Park:现阶段,Chance AI 的竞品是什么?
曾熙:如果一定要选的话可能有三类:第一类是上一个时代的各种垂类识别软件,植物、花鸟那种,技术上的竞品;第二类是入口型产品,像 Google Lens 这种;第三类可能是 AI 硬件,像 Looki 这种 Always-on 的设备。
我们最关注的还是入口型产品。我们希望用户拿起摄像头的时候,最先想到的是用我们。如果他拿起摄像头用了别的 App,那个 App 就会被我们视为潜在竞品。
Founder Park:你们自己核心的壁垒是什么?或者说别人做不到、你们跑得更快的是什么?
曾熙:前边也提到了。我们离用户很近,这种「敏感度」是我们现在最大的护城河。我们有能接住用户的工程能力,有把在美国真实生活的年轻人每天的需求转化为功能的流程,有跟他们直接沟通的渠道和分发能力。有了这些以后,我们就有自己的飞轮,Harness Engineering 的飞轮。
Founder Park:作为创业者,你今年会 FOMO 吗?
曾熙:只要在这个行业里就会 FOMO,因为变化太快了。三个月前你讲 OpenClaw,可能没人知道是什么,现在全民 OpenClaw,这也是让人兴奋的地方。
我们可能会 FOMO 一些技术实现的效率、对工具的选择,这个很常见,我们很害怕自己正在使用的工具不是世界上最先进的。
但在产品方向上我们是很有自信的。我们认定视觉这件事很直觉,人类跟世界就是这么交互的,这不是这几年的事情,是好几百万年的事情,这是不变的。变的是怎么让速度加快、怎么让它发生。我们担心的是,如果实现效率不够快,可能站在船头的人就不是我们了。
Founder Park:所以还是会有各种技术、效率上的焦虑?
曾熙:在 How 上面是有焦虑的,但在 Why 上面是没有的。我们现在很确定一定会在牌桌上,只是不确定是牌桌的上位还是下位。
文章来自于微信公众号 "Founder Park",作者 "Founder Park"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
深度|10人团队登顶视觉推理榜,Chance AI 超过GPT、Gemini和人类专家 (opens in a new tab)
过去两年,多模态模型的竞争看起来像一场“造眼睛”的竞赛:更高的图像分辨率、更多的视觉 token、更大的模型,以及更昂贵的训练。行业似乎默认,只要第一次看得足够清楚,AI 就能从“看见”抵达“洞见”。
一款没有输入框的AI应用正在北美年轻人中走红 (opens in a new tab)
一款没有输入框的AI应用,正在北美高校悄悄走红。
独家 | 16年智能硬件老将入局AI影像,获高瓴、阿尔法公社投资,曾打造爆款产品喵喵机和图公主 (opens in a new tab)
AI智件独家获悉,智能硬件公司「炎途智能」于近期获得新一轮融资,投资方为阿尔法公社。与此同时,公司的业务也由此前的NAS设备延伸至近两年大热的AI影像,并推出了AI拍立得产品。
“六小龙”高管做AI空间相机,竹马创新宣布完成天使+轮融资,30天估值翻倍 (opens in a new tab)
竹马创新宣布完成天使+轮融资,其由商汤国香资本领投,鼎晖VGC、峰瑞资本跟投。竹马创新是一家以Camera + AI为核心方向的空间智能公司,刚在4月完成数千万元天使轮融资,仅仅约30天,其估值增长已翻倍。
独家|美图入局 Visual Agent,Chance AI 完成数百万美元天使轮融资 (opens in a new tab)
美图正在布局下一代视觉 AI 入口。 Visual Agent 创业公司 Chance AI 宣布完成数百万美元天使轮融资,本轮由美图领投、NYX Ventures、阿里系投资机构等跟投。融资将主要用于模型能力迭代、北美学生群体渗透、以及社区与商业化探索。 Chance AI 成立于 2025 年 8 月,创始人兼 CEO 曾熙博士拥有认知科学、消费电子和 AI 产品的交叉背景,曾在 OnePlus、OPPO、字节跳动参与智能硬件产品、系统体验和 AI 产品从 0 到 1 的建设。 Chance AI 切入的是一个正在发生的 AI 交互跃迁:从输入框到摄像头,从文字提问到视觉理解。与过往的 c