这是一个划时代的生图模型,一手实测Wan2.7-Image
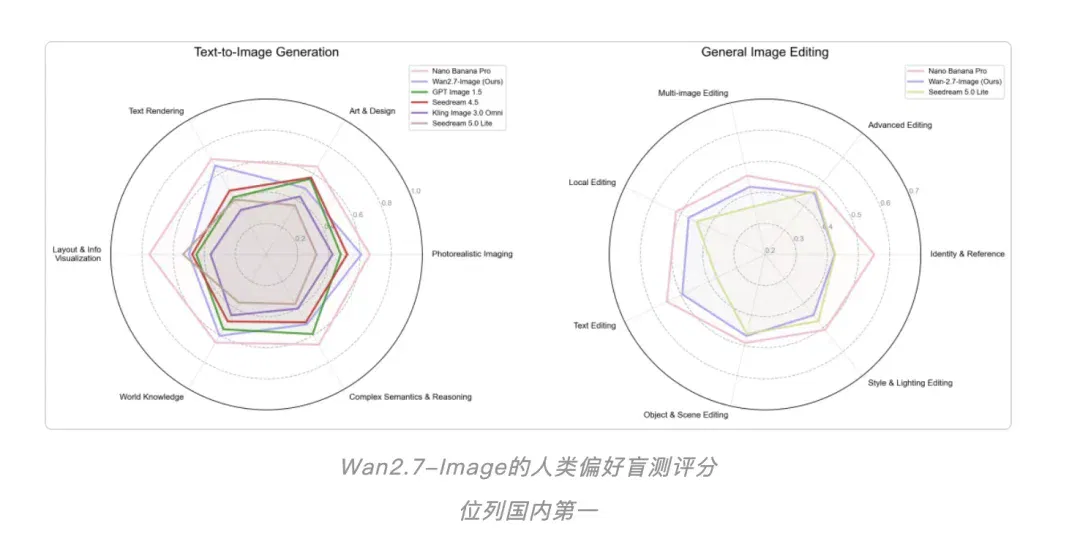
3月30日,阿里巴巴内部发布了 Wan2.7-Image 图像生成与编辑统一模型。根据官方公布的数据,在人类偏好盲测评分中,Wan2.7-Image 目前位列国内第一。从放出的评测雷达图来看,无论是文本生图(Text-to-Image)还是综合图像编辑(Image Editing),它的各项指标基本都盖过了市面上主流的几家头部模型。
3月30日,阿里巴巴内部发布了 Wan2.7-Image 图像生成与编辑统一模型。
根据官方公布的数据,在人类偏好盲测评分中,Wan2.7-Image 目前位列国内第一。
从放出的评测雷达图来看,无论是文本生图(Text-to-Image)还是综合图像编辑(Image Editing),它的各项指标基本都盖过了市面上主流的几家头部模型。
官方对它的定位也很明确:
就是为了解决当前 AI 生图中的审美疲劳、色彩失控等痛点,带来更具活人感的人物生成、精准的色彩控制以及超长文本渲染能力。
我平时其实不太喜欢用划时代这种词汇。
这两年大家见过了太多的模型发布,几乎每个月都有新的大满贯或者跑分王出现。
作为在一线和业务打交道的人,我对这些跑分数据已经逐渐脱敏了。
就算盲测拿了第一,我们在实际工作里面临的困境,往往不是AI能不能画出一张好看的图,而是AI能不能完全听懂我的控制,画出一张能直接用于商业生产的图。
在 Wan2.7 之前,大家其实对 AI 生图是有很多积怨的。
比如,过去模型生成的脸永远长得千篇一律,那种完美的高颅顶、大眼睛、过度平滑的肌肤,看一眼就知道是 AI 跑出来的硅胶脸,毫无生机。
再比如,过去想要实现特定人物的连贯出镜,简直是一场灾难。
你得先靠运气跑出一张图,然后把它作为参考图去垫图,即便如此,只要换个机位或者换件衣服,人物的脸大概率还是会崩,极难保持一致性。
此外,色彩控制基本靠抽盲盒,甲方要的特定品牌色 AI 根本听不懂;
更别提在画面里加中文字了,出来的全是扭曲的乱码;
修图时想改个局部,结果牵一发而动全身,连背景都跟着变形。
但直到我测试了新出的 Wan2.7-Image ,我发现它把这些过去的痛点,一个一个地变成了确定的可控项。
下面我结合具体的实测,和大家聊聊它到底改变了什么。
PART.01废话不多说,直接开测
你可以登录万相的网站https://tongyi.aliyun.com/wan/、或wan.video网站自己跑跑看。
进去之后,点击左上角的generate,对话框里选Image,模型切到2.7Pro。
它是完全支持中文提示词的。
为了方便大家测试,我写了几个比较典型的 Prompt,你可以直接复制进去试试效果。
改变一:告别千篇一律的AI脸,用文本捏出活人感
Wan2.7 强化了对面部细节的深度自定义功能。
你可以非常细致地用自然语言规定这个人的骨相、脸型(方脸、长方脸等)、眼部特征。
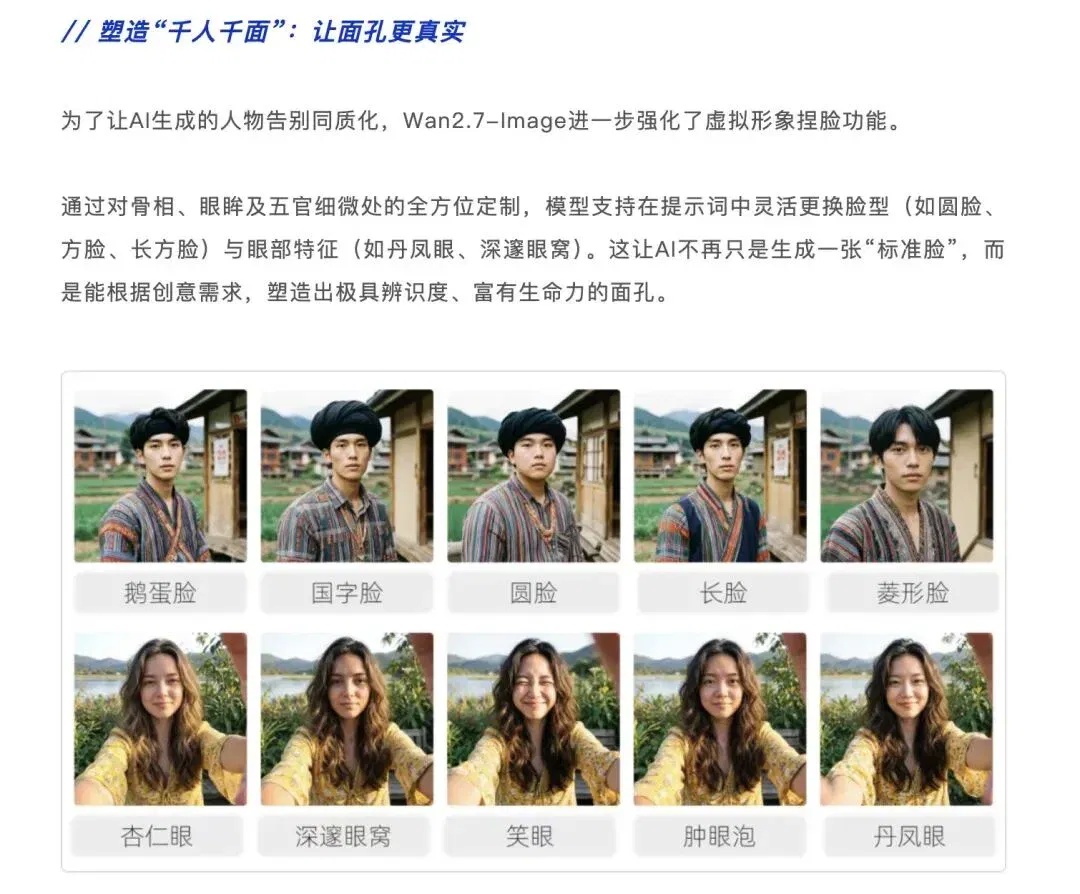
甚至是皮肤的瑕疵和岁月的痕迹,不再只能被动接受模型默认的那张犹如剥壳鸡蛋一般的完美脸。
为了挑战它到底能不能摆脱硅胶感,呈现出带点粗糙感的真实人类质感。
我没有用那些讨巧的漂亮词汇,而是输入了这样一段甚至有点刁难的提示词:
正面半身肖像特写,人物平静地看向镜头。一位35岁左右的亚洲女性,长方脸型,骨骼感明显,颧骨微高,单眼皮,眼神带有沉静的阅历感。留着自然垂落的黑色中长直发。重点要求:绝对不要AI磨皮,必须保留真实的皮肤瑕疵,脸颊要有明显的色斑、雀斑和毛孔,眼底有轻微的细纹和暗沉。侧面窗边柔和的自然漫射光,背景是虚化的窗框和绿植,极强的纪实摄影质感和活人感。
看到成图的那一刻,我确实被这种扑面而来的真实感镇住了。
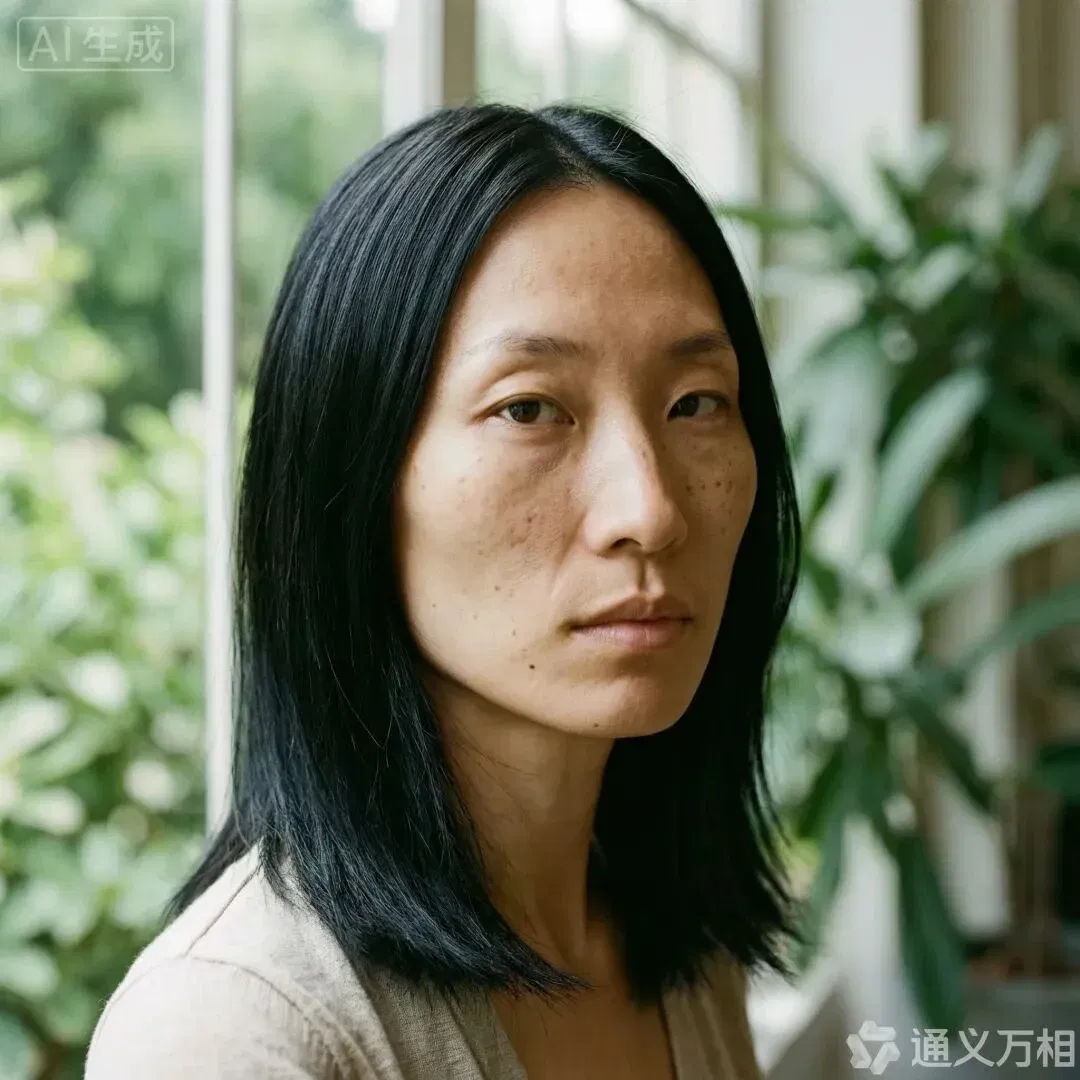
画面里不再是那个美颜拉满的假人,而是一个有血有肉、带着生活痕迹的真实女性。
你如果放大看,她皮肤上不均匀的色斑、细腻的毛孔、下颌角的自然阴影,甚至连额前微微凌乱的几根碎发,都极度逼真。
这对需要高辨识度人物设定的短剧筹备、商业摄影提案,或者是追求高级质感的虚拟IP博主来说,是决定性的跨越——AI 终于懂得了不完美的瑕疵,才是真正的高级感。
改变二:不再依赖痛苦的垫图,一次性直出连贯的分镜组图
以前为了让一个角色在多张图里长得一样,我们需要反复垫图和抽卡,这对于做漫画、短剧脚本或者 PPT 配图的人来说简直是一场灾难。
只要换个机位或者动作,人物的衣服和脸大概率就会崩。
但现在情况变了。
Wan2.7 具备了非常强悍的组图生成能力,最高支持一次性生成多达 12 张逻辑连贯的图像序列。
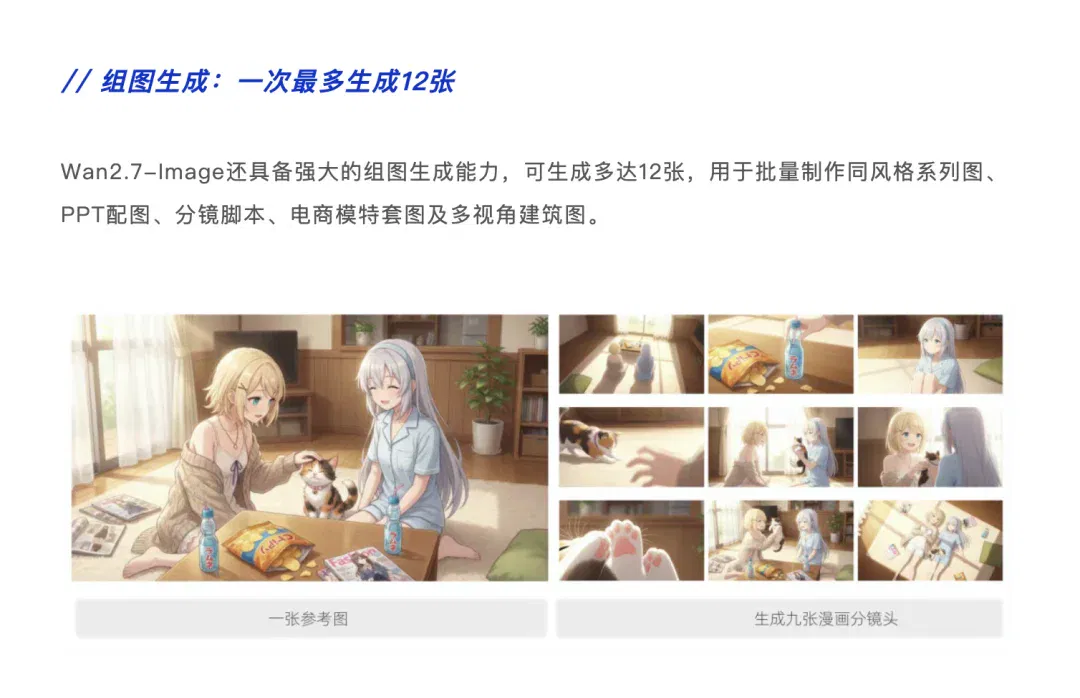
只要你给它一张设定图,它就能稳稳地把同一个人在不同视角、不同场景下的连续动作直接画成一套分镜。
为了验证它的极限,我直接把在【改变一】里刚生成的那张极具真实感的雀斑女性原图作为参考图传了进去,并选择生成9张组图。
我想看看,如果强行给她加上特定道具(眼镜、风衣),并要求复杂的镜头调度,这张脸还会不会稳得住。
提示词:基于参考图,生成九张逻辑连贯的电影感悬疑漫画分镜头。请保持女侦探的面部特征、黑框眼镜和卡其色风衣完全一致。内容表现她在一个昏暗的图书馆里寻找线索,动作依次包含:推开木门进入、在书架间穿梭寻找、特写她的眼神、最后翻开一本发光的古书。包含全景、中景和局部特写。
点击生成后,模型直接返给了我一组排版好的9宫格分镜图。
说实话,这效果真的让人起鸡皮疙瘩:从推开木门的全景,到穿梭在书架间的中景,再到第五张那极具视觉冲击力的面部大特写。
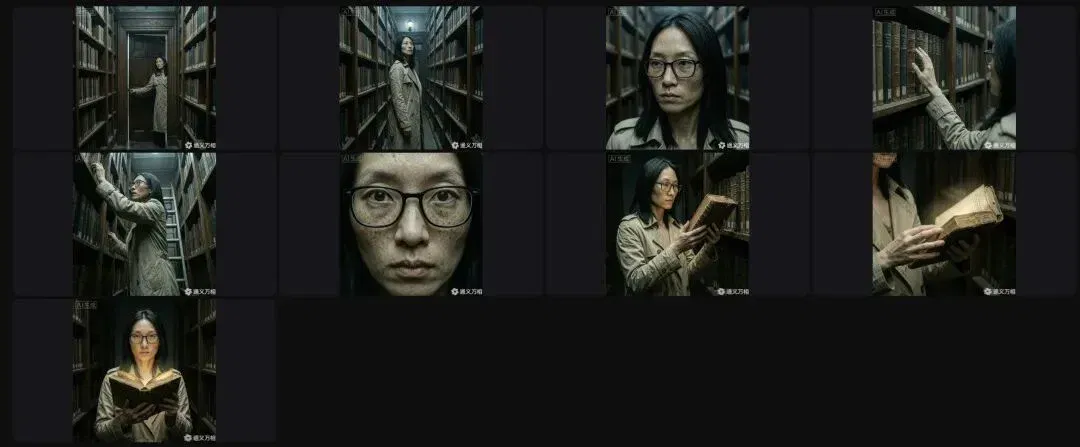
你会发现,即便戴上了黑框眼镜,女侦探的脸型、骨相,甚至脸颊上的每一颗色斑细节,都和原图保持了惊人的100%一致!
它不仅完美统一了卡其色风衣的款式,还极其精准地执行了翻开发光古书的叙事动作。
最后两张图中,古书发出的神秘暖光打在她脸上,光影过渡极其自然、符合物理逻辑。
这把做电影分镜脚本、连载漫画以及电商模特多场景套图的门槛,真正降到了可以直接落地的程度。
改变三:色彩不再是抽盲盒,一键提取的精控调色盘
以前设计师想让 AI 出一张符合特定品牌色调的海报,基本只能靠运气拼概率。
Wan2.7 引入了一个极其硬核的调色盘功能,它能直接读懂并执行特定的色彩配比。
最新的官网界面已经上线了可视化的Palette(调色盘)面板,我们不再需要像过去那样苦哈哈地敲代码了。
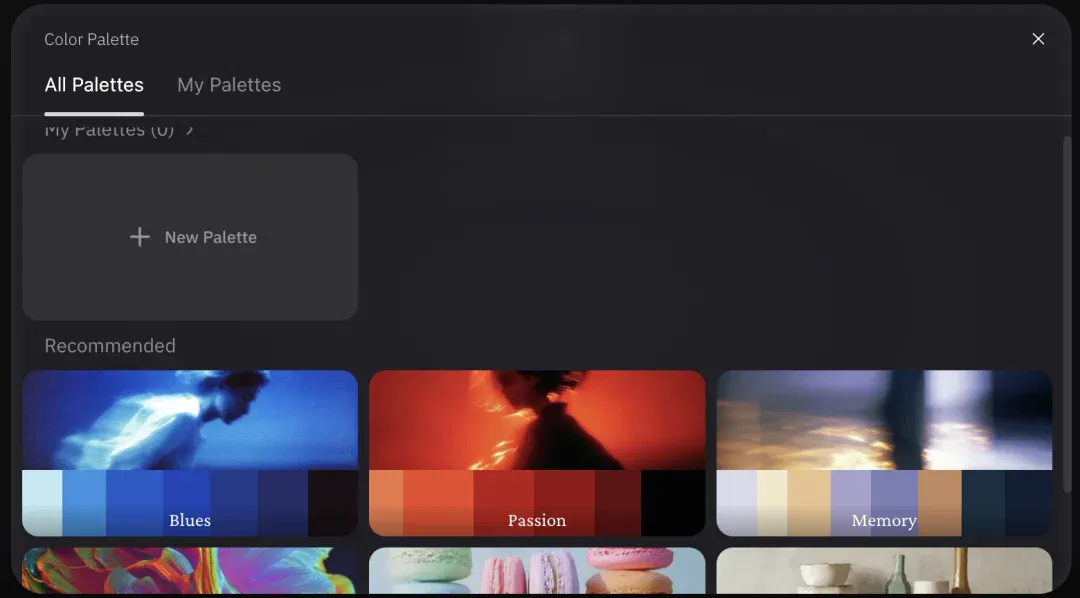
点击输入框右侧的Palette按钮,你可以直接选用系统推荐的经典电影级色板(比如 Blues 忧郁蓝、Passion 热情红等),也可以点击New Palette直接一键提色。
为了测试它对颜色的绝对服从性,我故意出了一个反常规的难题——我要一棵违背自然规律、绝对没有绿色的树。
提示词:一颗巨大的葱郁树荫下,树荫占据了整个画面,枝繁叶茂。画面带有强烈的西方文艺氛围,情绪叙事感,电影胶片质感和颗粒感。有风吹动树枝的动感,大风刮来树叶朝一个方向飘动。抽象,细腻,饱满细节。(操作:在调色盘功能中,直接选中了官方推荐的Blues忧郁蓝色板)
看到成图的那一刻,我才意识到这个模型的控色逻辑有多强。
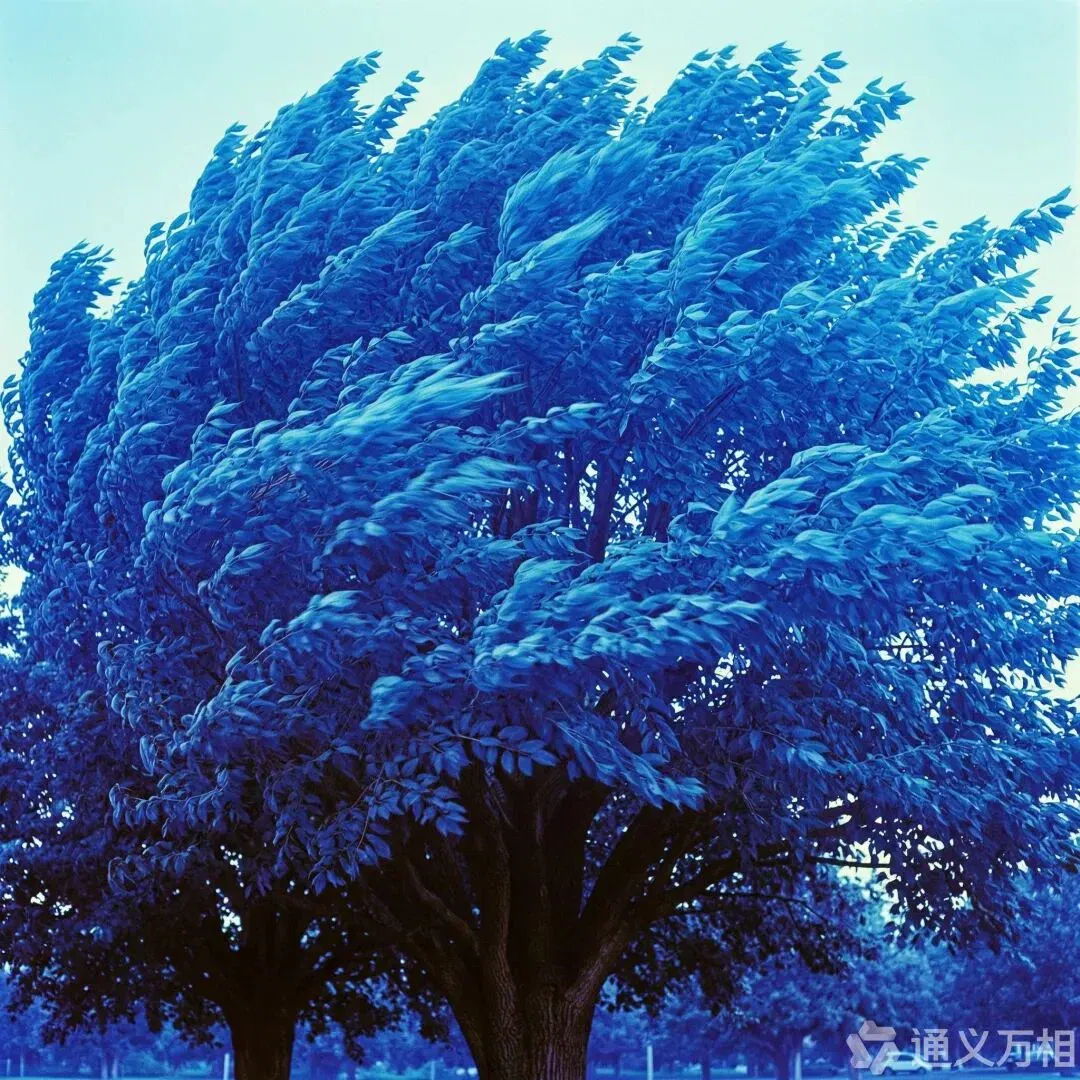
通常情况下,如果你让 AI 画一棵树,它潜意识里一定会疯狂给你塞绿色和棕色,哪怕你给的提示词里加了蓝色滤镜。
但你看这张图,整棵大树在强风下的动态极其真实,树叶翻飞的模糊感(Motion Blur)和胶片颗粒感十足。
然而,它的色彩被死死地限制在了调色盘规定的深蓝与青蓝色系里。
模型没有胡乱添加任何绿色的杂色,而是极其精准地把树的物理形态和默认的自然色彩剥离开来,完美执行了这套带有超现实感和忧郁气息的配色。
这意味着,以后甲方要什么样的品牌主色调,你就能像这样一键死死锁住颜色,再也不怕 AI 擅作主张了。
改变四:攻克文字渲染,长篇中文直接上图
遇到复杂的文字排版,过去的 AI 几乎都会翻车,能在图里把几个英文单词拼对就已经谢天谢地了。
但 Wan2.7 这次把文本渲染做到了最高 3K token 的超长输入,且清晰度达到了印刷级。
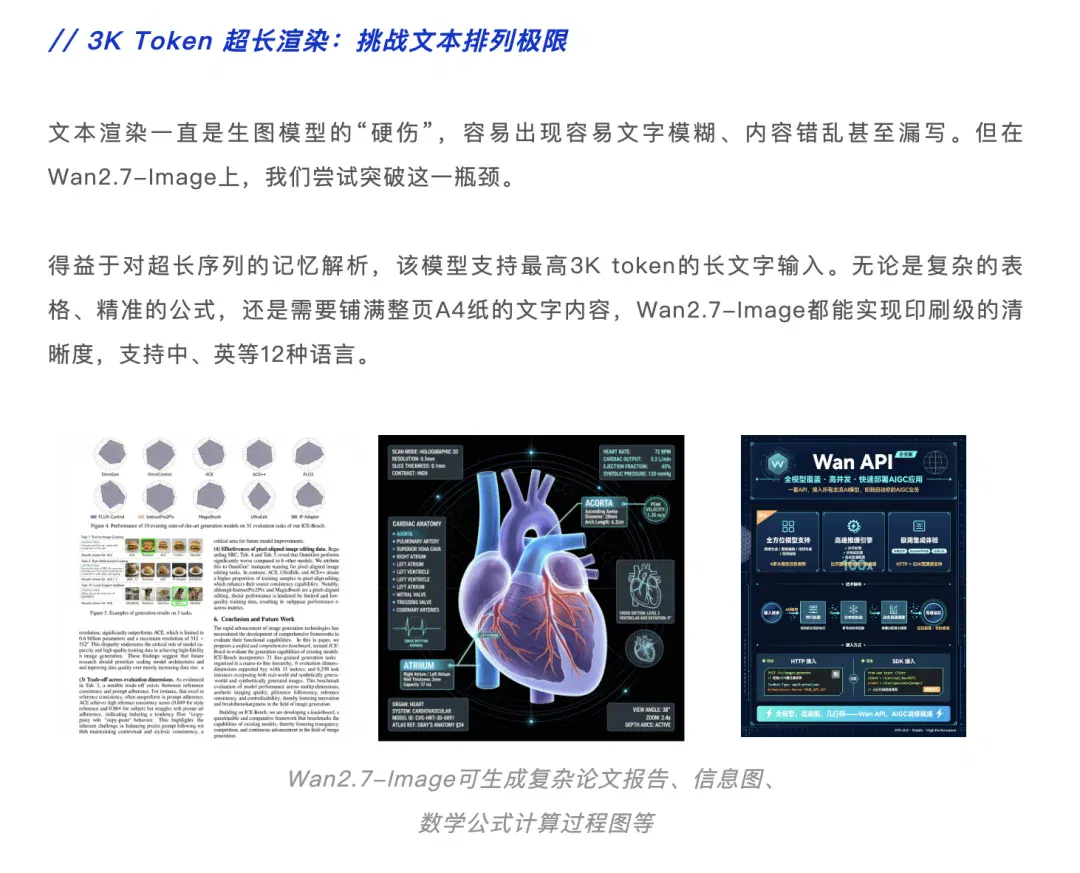
为了探探它的底,我做了一个在以前完全不敢想的极端压力测试。
直接把近千字的完整版《滕王阁序》全部塞进提示词,让它排版出一张长卷轴。 我的提示词长达近 1000 字,具体如下:
一张极简且大气的东方美学超长卷轴海报,竖版构图,8K分辨率。背景选用带有岁月痕迹的宣纸纹理,画面顶部用水墨晕染的技法画出层峦叠嶂的秋日群山与落霞,一只孤鹜在天际飞过,呼应‘落霞与孤鹜齐飞’的意境。画面中下部大面积留白,作为文字排版区域。
请在留白处,使用优雅且清晰的中文繁体行楷字体,排版以下整篇《滕王阁序》。要求:文字排版必须从右向左、从上到下竖向排列,字迹清晰锐利,具有书法骨力,绝不可出现任何字符扭曲、乱码或漏字。正文内容如下:
『豫章故郡,洪都新府。星分翼轸,地接衡庐。襟三江而带五湖,控蛮荆而引瓯越。物华天宝,龙光射牛斗之墟;人杰地灵,徐孺下陈蕃之榻。雄州雾列,俊采星驰。台隍枕夷夏之交,宾主尽东南之美。都督阎公之雅望,棨戟遥临;宇文新州之懿范,襜帷暂驻。十旬休假,胜友如云;千里逢迎,高朋满座。腾蛟起凤,孟学士之词宗;紫电青霜,王将军之武库。家君作宰,路出名区;童子何知,躬逢胜饯。
披绣闼,俯雕甍,山原旷其盈视,川泽纡其骇瞩。闾阎扑地,钟鸣鼎食之家;舸舰弥津,青雀黄龙之轴。云销雨霁,彩彻区明。落霞与孤鹜齐飞,秋水共长天一色。渔舟唱晚,响穷彭蠡之滨;雁阵惊寒,声断衡阳之浦。
遥襟甫畅,逸兴遄飞。爽籁发而清风生,纤歌凝而白云遏。睢园绿竹,气凌彭泽之樽;邺水朱华,光照临川之笔。四美具,二难并。穷睇眄于中天,极娱游于暇日。天高地迥,觉宇宙之无穷;兴尽悲来,识盈虚之有数。望长安于日下,目吴会于云间。地势极而南溟深,天柱高而北辰远。关山难越,谁悲失路之人?萍水相逢,尽是他乡之客。怀帝阍而不见,奉宣室以何年?
嗟乎!时运不齐,命途多舛。冯唐易老,李广难封。屈贾谊于长沙,非无圣主;窜梁鸿于海曲,岂乏明时?所赖君子见机,达人知命。老当益壮,宁移白首之心?穷且益坚,不坠青云之志。酌贪泉而觉爽,处涸辙以犹欢。北海虽赊,扶摇可接;东隅已逝,桑榆非晚。孟尝高洁,空余报国之情;阮籍猖狂,岂效穷途之哭!
勃,三尺微命,一介书生。无路请缨,等终军之弱冠;有怀投笔,慕宗悫之长风。舍簪笏于百龄,奉晨昏于万里。非谢家之宝树,接孟氏之芳邻。他日趋庭,叨陪鲤对;今兹捧袂,喜托龙门。杨意不逢,抚凌云而自惜;钟期既遇,奏流水以何惭?
鸣呼!胜地不常,盛筵难再;兰亭已矣,梓泽丘墟。临别赠言,幸承恩于伟饯;登高作赋,是所望于群公。敢竭鄙怀,恭疏短引;一言均赋,四韵俱成。请洒潘江,各倾陆海云尔:
滕王高阁临江渚,佩玉鸣鸾罢歌舞。
画栋朝飞南浦云,珠帘暮卷西山雨。
闲云潭影日悠悠,物换星移几度秋。
阁中帝子今何在?槛外长江空自流。』
看到生成的这张长图时,我确实有点吃惊到了。
因为预期里觉得,这么多汉字,大概要密密麻麻的糊成一坨。
但没想到画面上方是非常有意境的水墨群山和飞鸟,而下方大面积的留白处,这近 1000 个汉字密密麻麻、整整齐齐地印了上去。
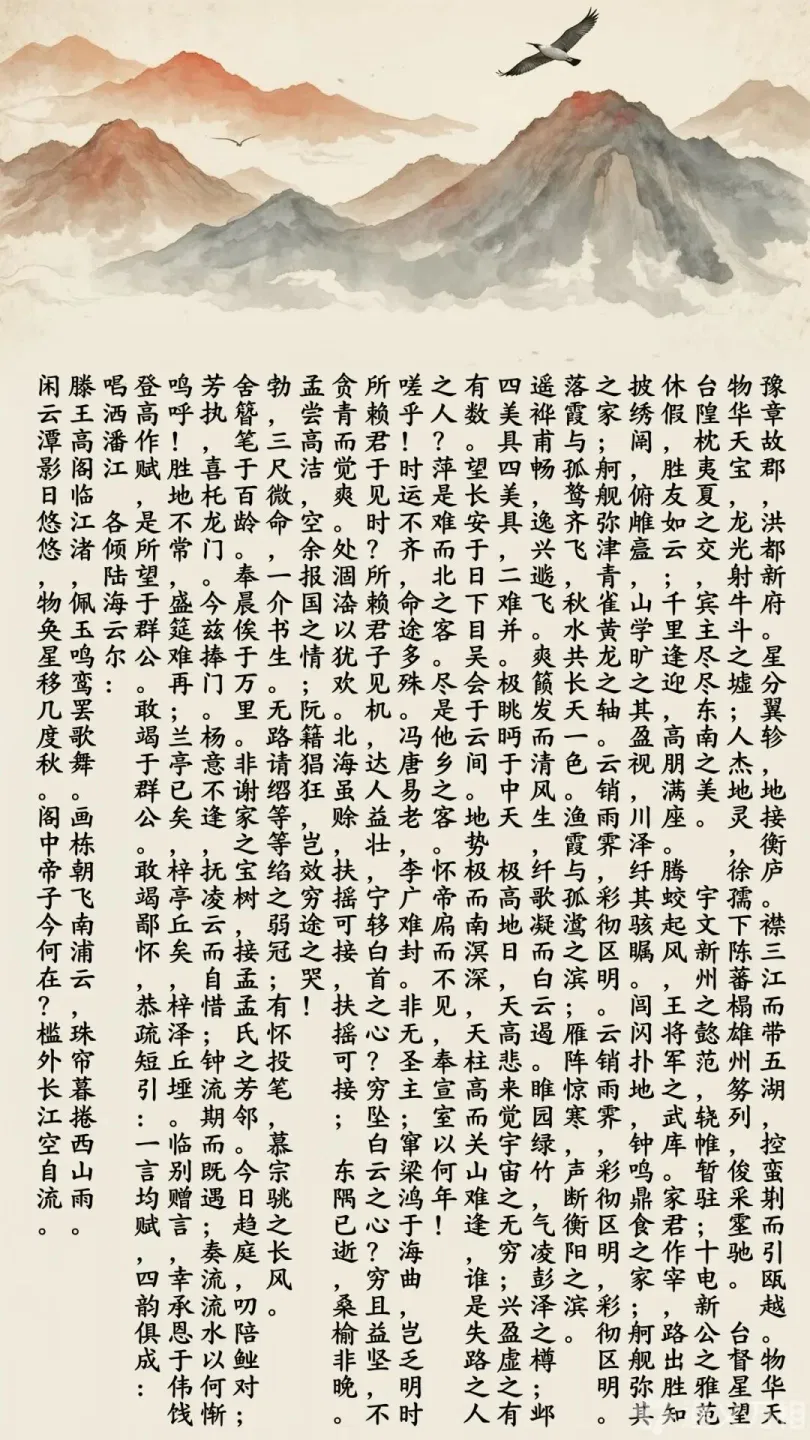
如果你把图片放大仔细看,它完全遵循了从右向左的竖版排版逻辑。
没有出现过去 AI 常见的鬼画符。
这意味着,以后做一些带大段长文的电商详情页、数据繁多的信息图表,或者是需要大量文案排版的商业海报。
我们终于可以一气呵成,不用再切回 PS 里痛苦地敲字排版了。
改变五:哪里不爽改哪里,懂设计师意图的交互编辑
局部修改一直是痛点,以前想在图里的特定位置加个道具,往往是牵一发而动全身,很多时候跑一次图连背景都跟着变形。
Wan2.7 引入了极其精准的交互式编辑。
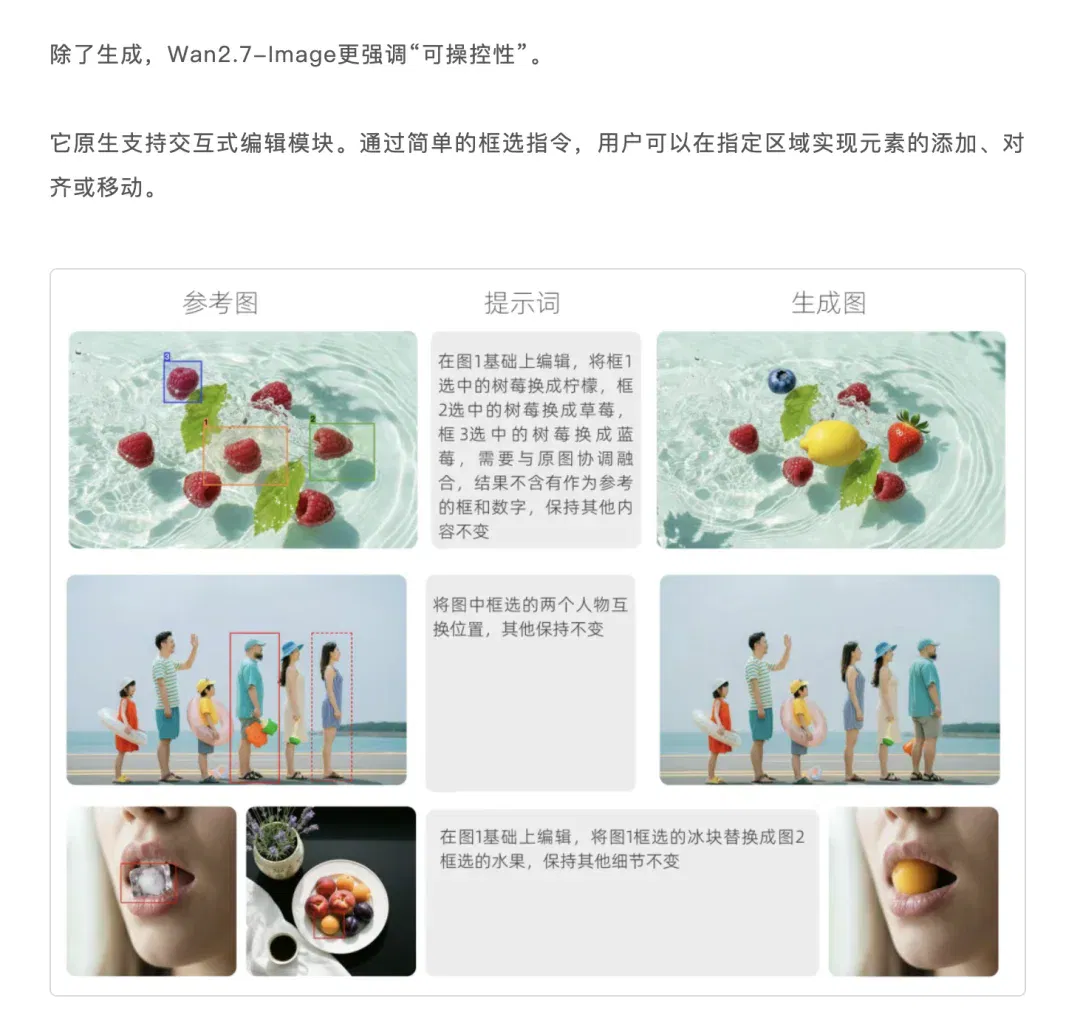
你可以在图上直接画框,甚至用不同颜色区分,明确告诉模型每个框里具体要放什么,它能做到真正的指哪打哪。
为了测试它的精准度,我找了一张大家都很眼熟的戴草帽站立猫咪表情包。
我直接用鼠标在猫咪的左边画了一个黄框,右边画了一个红框。
提示词:在黄框位置加一瓶百事可乐,在红框位置加一瓶美年达
看到成图后,我发现它不仅完美理解了空间位置,还顺带秀了一把前面刚刚提到的文字渲染能力。
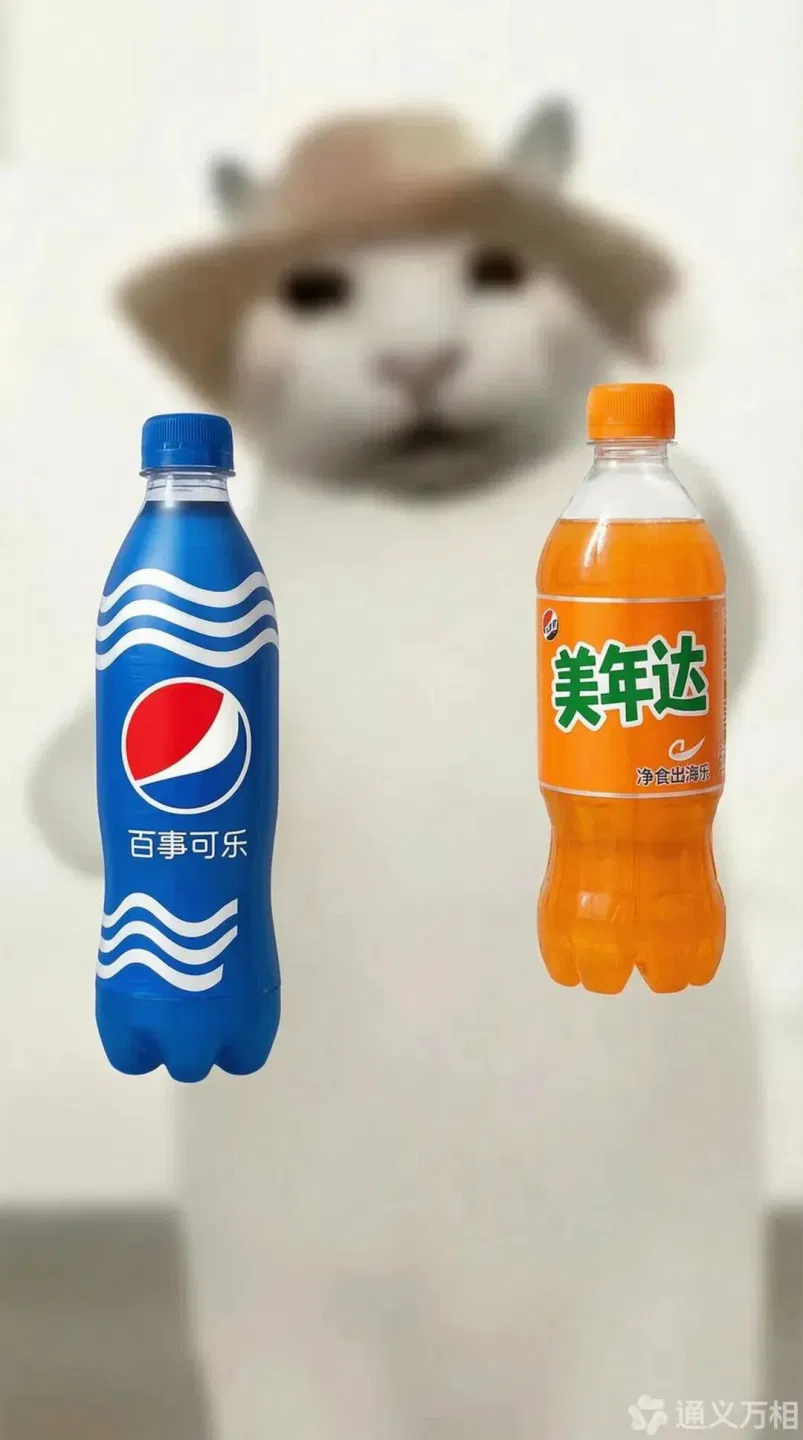
在你画好的黄框和红框的位置上,精准地出现了一蓝一橙两瓶饮料。
让人无比惊喜的是,瓶身上不仅还原了经典的包装配色和 Logo,还极其清晰、准确地印上了百事可乐和美年达的中文字样,没有任何错别字或乱码!
更重要的是,景深的物理逻辑依然在线。
作为背景的那只模糊的搞笑猫咪被完好无损地保留了下来,完全没有因为前景强行塞入了两个清晰、复杂的实体商品而产生任何画面崩坏或变形。
这个功能意味着,以后运营同学想做热点海报、给特定模特手里塞个自家产品,或者是内容创作者想二创表情包,只需要简单画个框就能搞定,再也不用去素材库里苦哈哈地抠图、调光影、做合成了。
PART.02不只是生图,更懂图
可能有人会问,为什么这次的模型能把控制力做得这么精细?
值得注意的是,Wan2.7-Image 不只会生图,它还更懂图。
在底层的模型架构上,它采用了领先的生成与理解统一架构。
这意味着模型不需要再费力去瞎猜你的提示词到底对应什么样的画面。
同时,团队在数据工程上下了死功夫,不仅涵盖了全域品类的超大规模异构数据,还构建了非常精细的多维标注体系。
把每一张图的布局、文字、光影、拍摄角度和用途都嚼碎了喂给模型。
顺带一提,基于更大规模数据及尺寸训练而成的Wan2.7-Image-Pro版本目前也已上线,它生成的图像构图会更加稳定,语义理解也更强、更精准。
正是因为这种极高的可控性,Wan2.7-Image 现在的能力可以迅速应用到多个行业里:
- 短剧与影视团队:可以极低成本完成前期的角色设定、动作模仿与特效分镜预览。
- 自媒体与内容创作者:能轻松稳定地生成多风格的爆款封面和 OOTD 穿搭图。
- 电商领域:只需要给出一张基础图,就能无限裂变出局部特写和不同场景的卖点图,大幅降低外景拍摄成本。
- 教育和科研从业者:也能直接调用模型,生成没有错乱文本的论文配图、信息图表以及儿童绘本。
甚至,官方在玩法上也留了一些有趣的彩蛋。
比如针对时下大火的龙虾热,Wan2.7-Image 现已支持 skill 调用,你可以直接解锁让龙虾画画等脑洞大开的场景。
PART.03最后
测完这些功能,我最大的感慨是:
技术终于不再只是为了跑分而炫技,而是真正俯下身来,去解决普通打工人每天都会面临的泥泞和琐碎。
阿里和 Wan 团队这次做得很好,他们显然是真的听进去了设计师、画师和内容创作者的抱怨,把发力点极其精准地对齐了用户的真实需求。
当一个生图模型不再执着于我能画得多炫酷,而是开始死磕我怎么让你用得更顺手、更确定时,它就已经跨越了玩具的门槛,真正成为了一件划时代的生产力工具。
剩下的,就看大家怎么把这些确定的控制力,真正融合进自己的日常工作流里了。
总之,作为一个工具,Wan2.7-Image 现在的底子已经非常扎实了。
它解决的是真实世界里设计师和内容创作者的痛点,不再是一味地追求视觉上的虚假繁荣。
剩下的,就看大家怎么发散思维,把这些确定的控制力,玩出不一样的花样了。
文章来自于"01Founder",作者 "Max"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚刚,龙虾学会画画了!阿里甩出Wan2.7生图王牌,捏脸精确到骨相 (opens in a new tab)
龙虾终于会画图了!阿里Wan2.7-Image刚刚上线,捏脸到骨相级、首创「调色盘」、3K超长文本写满A4不崩,还能接入OpenClaw一句话出图。
深度|近3000家付费客户之后,这家创业公司如何把服装审美写进大模型? (opens in a new tab)
过去两年,AI生图的参数量与清晰度完成了指数级跨越,但真正面向服装行业却依然面临一个极其尴尬的悖论——当GPT、Gemini等顶尖大模型在通用图像生成上大放异彩时,落地到服装产业的深水区,依然满屏是令人出戏的AI味。通用的SOTA模型做得到了“逼真”,却依然做不好“商业”。
马斯克的新生图模型,让我笑了一整晚 (opens in a new tab)
毫无疑问,四月份发布的生图模型 GPT-Image-2,现在依然是当之无愧的 AI 生图之王。
突发,谷歌地球紧急撤回Nano Banana 2生图功能! (opens in a new tab)
昨天,谷歌把最新图像生成模型Nano Banana 2正式塞进了谷歌地球网页版。谁能想到,一觉醒来,新功能被玩坏,谷歌紧急撤回了这一功能!结果效果太逼真,被专家强烈反对后,谷歌紧急撤回了新功能,「加强防护措施」后再次发布。
1/8 参数,跑赢 80B 大模型:Boogu-Image 是黑马还是鸡肋? (opens in a new tab)
2026 年 6 月,HuggingFace 上一个名为 Boogu-Image-0.1 的开源模型,在上传以后迅速引爆了 AI 圈。这款模型最引人注目的地方,在于它以区区 10B 的参数规模,就在多项关键能力上超过了很多参数量更大的模型。