林俊旸离开的 48 小时:一条朋友圈、一个小模型、和一个万亿美金的假设
离职的消息最沸沸扬扬的时候,Qwen 团队的核心负责人林俊旸在朋友圈发了两句话:
「按照原来安排继续干」
离职的消息最沸沸扬扬的时候,Qwen 团队的核心负责人林俊旸在朋友圈发了两句话:
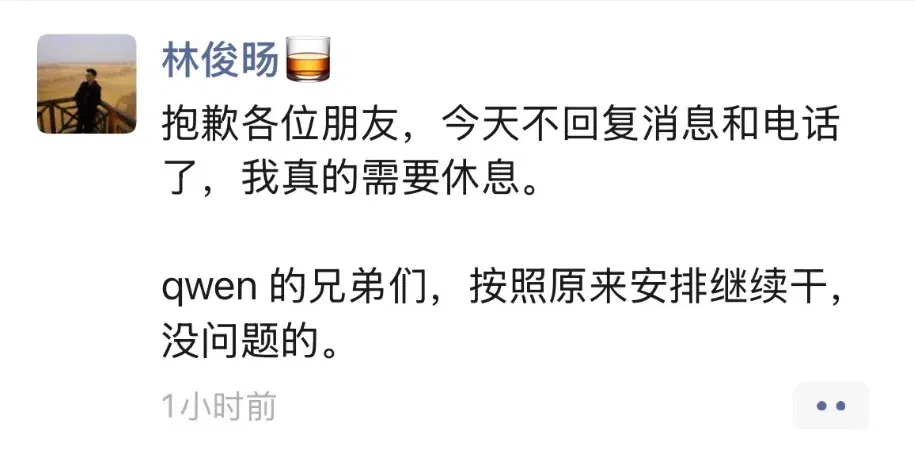
「Qwen 的兄弟们,按照原来安排继续干,没问题的。」
「安排好的」?这是什么?
林俊旸离开前夕,Qwen 团队刚刚发布了一件被全球开发者社区刷屏的东西。Qwen 3.5 Small 系列,参数量从 0.8B 到 9B,专为端侧设备设计,可以在普通笔记本电脑上运行。
不是一个更大的模型——而是一组更小的模型。要知道,过去三年里,AI 行业最强大的共识是「越大越好」。OpenAI 的 Sam Altman 四处筹措万亿美金建设算力基础设施,各家实验室军备竞赛般地烧钱烧卡,底层假设只有一个:模型越大,就越聪明。
这套逻辑被称为 Scaling Law,它不仅仅是一条技术规律,更像一种信仰——整个行业的融资叙事、人才分配、硬件投资都建立在这个前提之上。
但 Qwen 3.5 Small 的发布,和林俊旸的离开,同时发生。一个技术信号和一个人事信号,交织出一个更复杂的故事:小模型到底在发生什么?它为什么重要?
当 9B 打赢 120B
即便不是开发者,也可以跑分上一窥 Qwen 3.5 的战绩:
Qwen 3.5 Small 系列中,9B 参数的模型在多项基准测试中全面超越了 OpenAI 的 gpt-oss-120B——一个参数量是它 13 倍的模型。
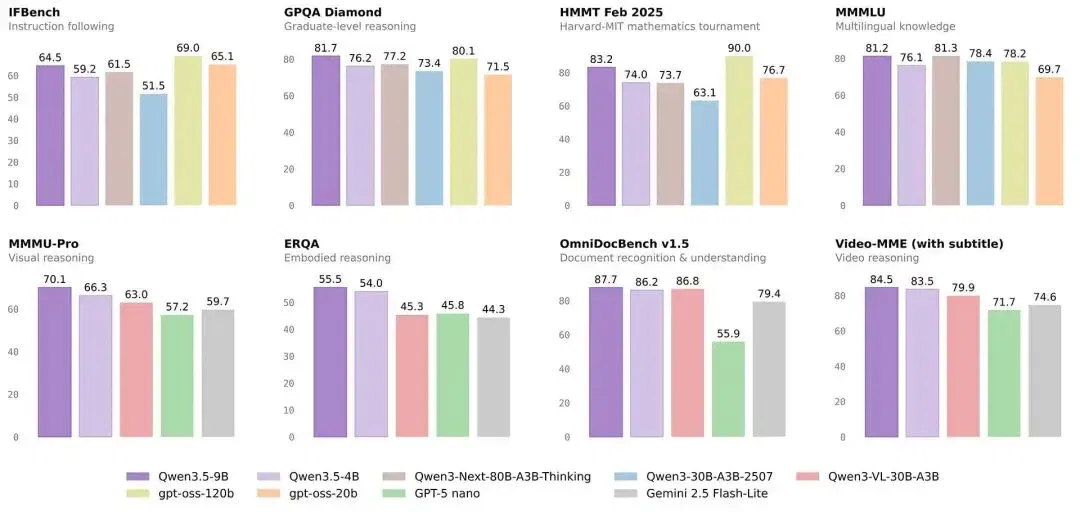
这些不是边缘指标上的微弱优势,而是在核心推理任务上的系统性领先。一个可以装进笔记本的模型,在数学、科学、视觉推理上全面击败了一个需要数据中心级硬件才能运行的对手。
当然了,摸着良心说,gpt-oss-120B 不是 OpenAI 的旗舰产品,而是其开放权重的中端线。而且它采用 MoE 架构,标称 120B 参数,但每个 token 实际只激活约 5.1B 参数——所以参数量的对比,在工程层面并不像字面数字那么悬殊。
但这不影响趋势本身的成立。因为 Qwen 3.5 Small 并不是孤例。
同一时期,Nature 报道了一个微型递归模型(TRM),在 ARC-AGI 逻辑测试中击败了多个顶级大语言模型。Google Research 在 2026 年初发表论文,证明小模型在意图提取任务上的表现优于显著更大的模型。PNAS 上的一项研究更直接——模型规模与说服力之间呈急剧递减收益,大到一定程度之后,更大几乎不带来更好。
《华尔街日报》早在 2025 年 10 月就已经敢说,
「大模型拿走了所有的关注,但小模型才真正干活的那个。」
这些信号共同指向一个判断:以小博大不是偶发事件,而是大势所趋。
那么问题来了——小模型凭什么?
才不是大模型的替身文学
直觉上,人们容易把小模型理解为「大模型的平替」,同样的方法,只是规模小一些,性能差一点,胜在便宜。
但事实恰恰相反:今天的小模型之所以能以小博大,是因为它们在技术方法论上,走了一条和大模型完全不同的路。
第一,数据质量压倒数据规模。 大模型的路线是「尽可能多地吞入互联网数据」,而小模型路线的代表——比如微软的 Phi-4 系列——走的是精筛路线:用高质量的合成数据加上严格筛选的公开数据集,让模型在更少的数据上学到更精确的能力。这背后的逻辑转变是根本性的:不是「喂得越多越聪明」,而是「吃得精才学得好」。
第二,原生多模态设计取代了适配器拼接。 传统做法是先训练一个纯文本大模型,再通过适配器模块接入图像、视频、音频等能力。Qwen 3.5 采用了完全不同的架构:将视觉 token 和文本 token 在同一个潜空间中联合训练,从底层就是多模态的。这意味着它是一个天生就同时理解文字和图像的模型。这种架构在小参数量下反而更有优势,因为不需要额外的适配器开销。
第三,量化技术带来的不只是压缩。 4-bit 量化常常被理解为「把模型压小 4 倍以节省存储」,但它真正的意义在于减少 4 倍的内存吞吐量。在端侧设备上,瓶颈往往不是存储空间,而是内存带宽,也就是数据从内存搬运到处理器的速度。量化技术让小模型在带宽受限的手机和笔记本上,获得了决定性的速度优势。
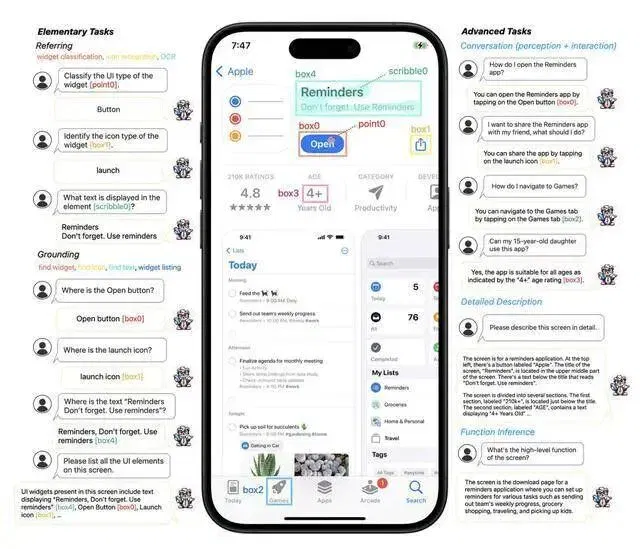
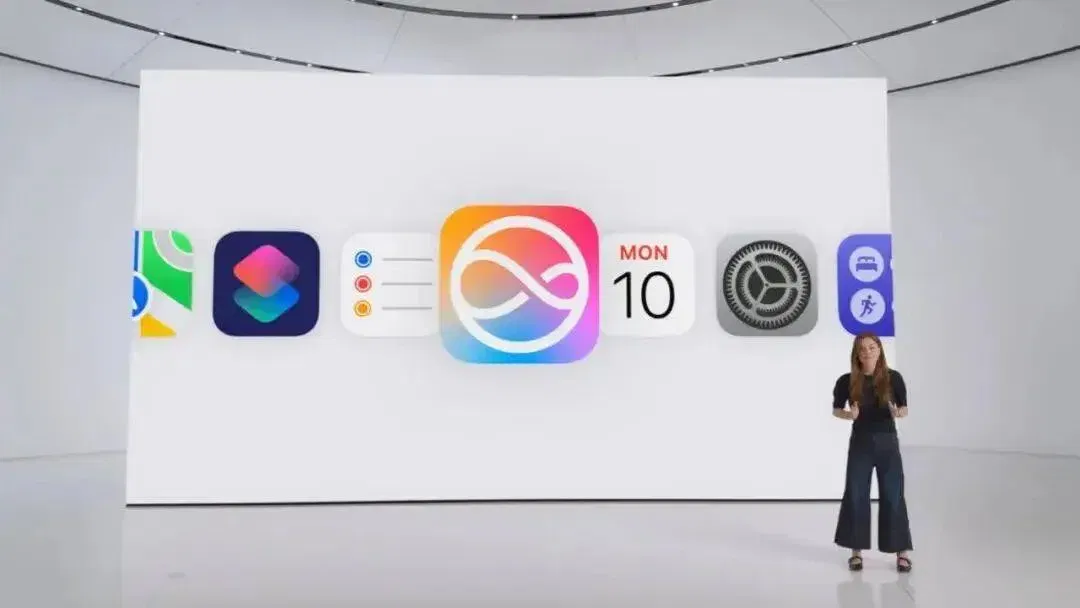
这些方法论上的突破已经开始转化为产品。3 月第一周,苹果发布了 M5 全线芯片,每颗 GPU 核心内置 Neural Accelerator,AI 性能较 M1 提升最高 8 倍。与此同时,苹果研究院公开了 Ferret-UI Lite——一个仅 3B 参数的端侧 GUI 代理,可以本地操控手机和桌面应用。加上 Apple Intelligence 约 3B 参数的端侧基础模型,苹果正在将「on-device AI」从概念推进到芯片、模型、交互三位一体的产品形态。
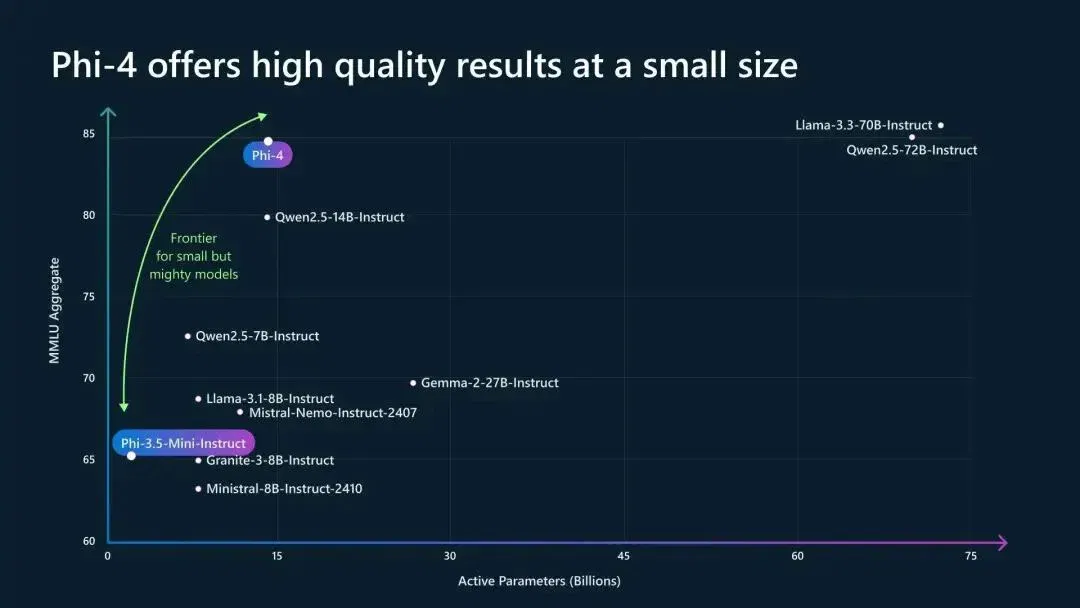
微软的 Phi-4 multimodal 也开始尝试商用上线 Azure,3.8B 参数,接受文本、音频和图像输入。开源社区的反馈更加直接——Reddit 上的开发者实测后认为 Qwen 3.5 的 4B 版本是「甜点级」模型:跨任务稳定、无崩溃、远快于 9B 版本。
技术路线已经被验证,产品化拐点已经到来,天边泛起鱼肚白,曙光乍现。
而就在此时,林俊旸选择离开。
最会做小模型的公司,最没有动力让它成功
Qwen 3.5 Small 在发布后获得了开发者社区的广泛认可,开源社区的评测结果甚至超出了官方发布时的宣传。
但是,他所在的公司是阿里巴巴,阿里巴巴的商业引擎是阿里云。
大模型和云计算之间存在天然的正向循环:模型越大,推理所需的算力越多,客户就越需要购买云计算服务。对阿里云来说,大模型是完美的商业叙事——它同时推高了客户的算力需求和对云平台的依赖。
而小模型的逻辑恰恰相反。小模型的核心价值在于可以在端侧设备上运行——手机、笔记本、边缘服务器。这意味着客户可以绕开云,在本地完成推理。对用户来说,这意味着更低的成本、更好的隐私和更低的延迟。但对阿里云来说,这意味着收入被侵蚀。
Qwen 3.5 Small 做得越好,对阿里云的商业叙事就越尴尬。
这不是阿里一家的问题。放眼中国的科技巨头,几乎所有 AI 领先的公司都面临同样的结构性矛盾。百度和腾讯的处境与阿里类似——商业模式建立在云服务和平台抽成之上,小模型的端侧化趋势直接削弱了它们的价值主张。
字节跳动的豆包手机是一个有趣的例外,但字节做硬件才刚起步,远没有建立起「芯片+操作系统+模型」的垂直整合能力。
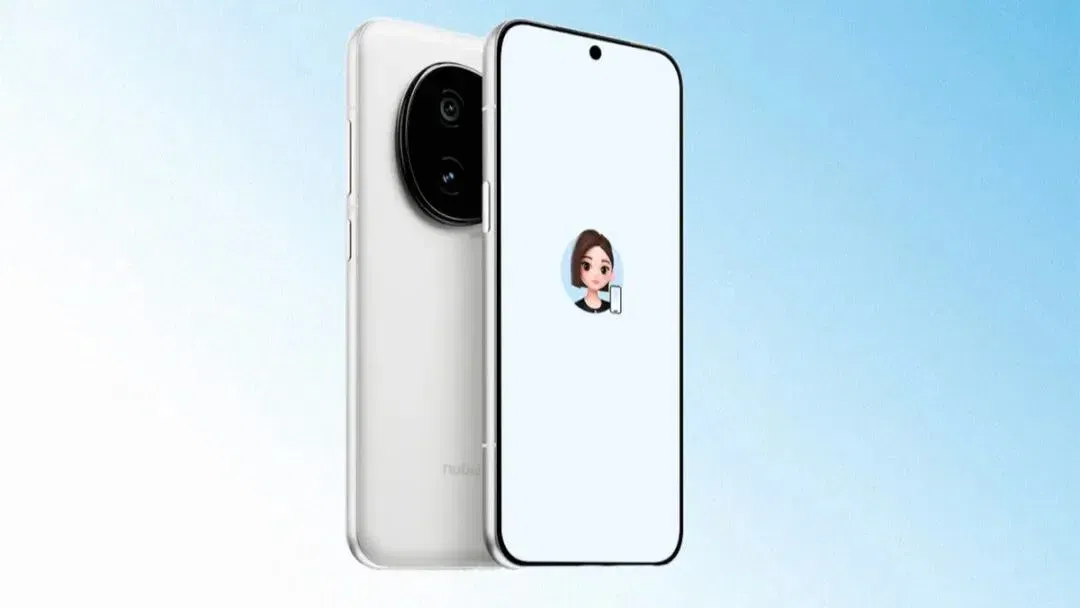
华为理论上最有条件,既有芯片,又有终端设备。但在制裁的影响下,它的算力上限本身就逼着它走小模型路线,这更多是被动的求生策略,而非主动的战略选择。至于小米、OPPO、vivo,它们有设备,却不是 AI-first 的公司,缺乏自研模型的基因和持续投入的动力。
全球范围内,真正打通端侧 AI 全栈的公司,可能只有一家:苹果。芯片、设备、操作系统、自研模型,全部自有。苹果的动力来自复合型的商业模式,这驱动它把一切计算尽可能留在设备上,因为每一次端侧 AI 体验的提升,都会转化为硬件的溢价和生态的黏性。
不过,这里需要诚实地处理一个可能的反驳:云厂商难道不能走「端云协同」的路线吗?用小模型做端侧入口,复杂的推理任务回调云端处理,两边都不耽误。
理论上可以。但这恰恰说明了问题——在端云协同的框架下,小模型对云厂商来说是「引流工具」,而不是「独立产品」。云厂商没有动力把小模型做到好到不需要云。
还有一个绕不开的反例:微软也是云厂商,但它在认真做 Phi-4 系列小模型,而且已经商用上线。这是否说明「左右互搏」的论点站不住脚?
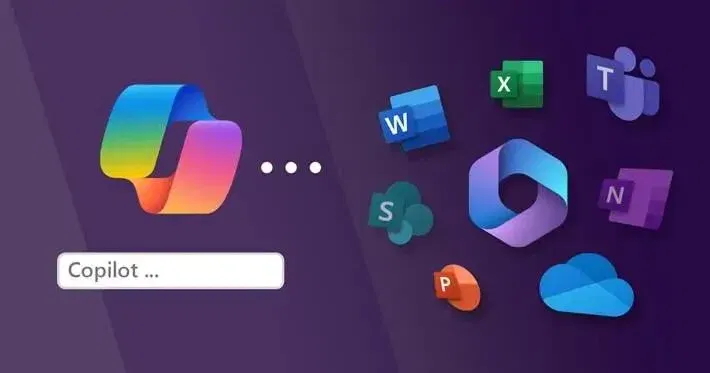
非也。微软之所以能两条腿走路,是因为它同时拥有 Windows 和 Surface 的硬件生态、Azure 的云平台以及 Copilot 的端侧产品线。做 Phi-4 对微软来说是防御性布局:如果端侧 AI 的趋势不可逆转,为了大局,宁可壮士断腕,自折一臂,也不能把端侧市场拱手让给开源社区和苹果。
但阿里没有这个选项——没有消费级操作系统、没有主流终端硬件、没有面向个人用户的 AI 产品矩阵。Qwen 做得再好,也没有自家的「最后一公里」可以落地。
动力不同,产品的天花板就不同。
这就形成了一个令人不安的画面: 小模型从实验室走向产品的真正瓶颈,不是技术能力,而是供需错位;最擅长做小模型的公司(云厂商),最没有动力让它真正成功;最需要小模型的公司(设备厂商),又缺乏独立研发的能力。
「没问题的」
回到林俊旸的那条朋友圈,「按照原来安排继续干,没问题的」。
也许他说的就是字面意思。技术路线在他走之前就已经铺好了,一切都在朝着正确的方向走。但在一家以云为重的公司里,就算做出世界级的小模型,团队的处境注定不会舒适。
这不是对阿里的批评——任何一家以云收入为生命线的公司,面对一项可能侵蚀自身收入的技术路线,都会陷入同样的两难。这是一个结构性矛盾,不是个人或管理层的选择问题。
比人事更值得关注的,是 Scaling Law 本身正在发生的变化。
过去三年,「越大越好」不仅仅是一条技术规律,它是整个 AI 行业的信条。融资叙事围绕它建立——投资人相信更大的模型意味着更强的能力,所以万亿美金涌向算力基础设施。人才分配围绕它运转——最顶尖的研究者被吸引到训练最大模型的团队。硬件投资围绕它定价——英伟达的市值在 2025 年一度突破 3 万亿美金,而这个估值建立在一个前提之上:对算力的需求会永远增长。
现在,这个前提正在松动。MIT 的研究估计,效率提升将使中等硬件上的模型在 5 到 10 年内逐步追平最大最贵的模型。芝加哥大学的研究表示,数据质量正在取代数据规模成为核心竞争维度。
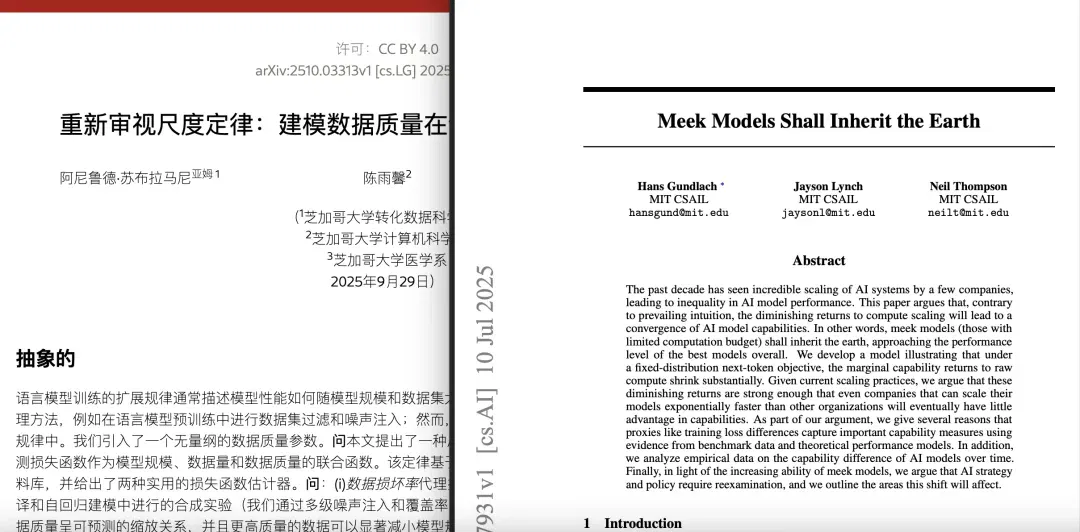
产品化的方向不再只有云端,而是同时向端侧扩散。Scaling Law 正在从一条单调递增的曲线,变成一张需要在多个维度上寻找最优解的地图。
不再是「越大越好」,而是「在对的地方,用对的大小」。
林俊旸大概比大多数人更早地感受到了这个变化。他用 Qwen 3.5 Small 证明了一件事:在对的方法论下,9B 参数可以击败 120B。但他同时也撞上了另一堵墙——
技术上的正确,不等于商业上的可行,更不等于组织上的舒适。
他说,没问题的。确实,技术路线已经铺好了,而剩下的问题不在实验室里,而在实验室外面。
文章来自于“APPSO”,作者 “APPSO”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
都误会了,是林俊旸不想再等阿里 (opens in a new tab)
千问(Qwen)技术负责人林俊旸在X上宣布离职24小时后,阿里高层火速批准了他的离职邮件。如果单从时间节点看,林俊旸的离开,很容易被解读为一次“模型迭代失利后的调整”。 过去一年,Qwen模型迭代频繁
阿里千问大模型掌舵人林俊旸卸任 (opens in a new tab)
me stepping down. bye my beloved qwen.(我将卸任。再见了,我深爱的 qwen。) 3 月 4 日凌晨,阿里通义千问(Qwen)技术负责人林俊旸在 X 突然发文,向自己一手带大的开源模型项目告别。
Qwen Code 1.0 Preview 发布,融合 Qoder 的 Harness 能力 (opens in a new tab)
Qwen Code 1.0 预览版开放融合后的运行框架,以事件组织会话、工具与反馈。团队保留稳定分支,并计划继续完善分布式扩展和任务接续。
苹果公布国行 Apple 智能首批功能计划,千问作为可选扩展接入 (opens in a new tab)
10月31日苹果中国官网发布新闻稿《Apple 智能即将登陆中国》,宣布国行 Apple 智能首批核心功能11月4日起随 iOS 开发者 Beta 版开放测试,12月随 iOS 27.3 正式版推送,并在 Siri、写作工具和视觉智能接入阿里千问,Siri AI 等下一代功能暂不包含在内。
刚刚,阿里开源 Qwen3.8-Max 2.4万亿参数大模型!性能比肩Fable 5 (opens in a new tab)
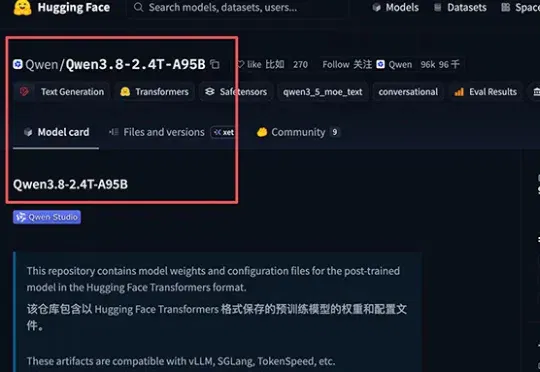
刚刚,阿里千问大模型团队开放Qwen3.8-2.4T-A95B模型权重! Qwen3.8-Max是基于Qwen3.8-2.4T-A95B的官方版本,于8月3日发布,拥有更多功能,例如视觉输入功能、无需思考即可使用、默认支持1百万上下文长度处理、内置官方工具等。