我的 AI 2026 万字预判:AI「肾虚症」、AGI 被喊爆、开源被玩坏、国产复刻在狂飙、岗位在消失
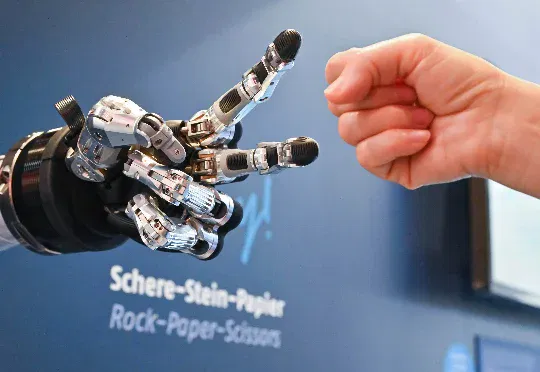
昨天晚上的春晚,想必大多数人都看了。虽然大概率没看完,说实话确实有点无聊,但前三个节目的人形机器人小品,估计很多人都多少瞄过一眼。 有人在朋友圈吐槽:「之前春晚没有年味,今年的春晚没有人味。」 我倒是
昨天晚上的春晚,想必大多数人都看了。虽然大概率没看完,说实话确实有点无聊,但前三个节目的人形机器人小品,估计很多人都多少瞄过一眼。
有人在朋友圈吐槽:「之前春晚没有年味,今年的春晚没有人味。」
我倒是和朋友们看的时候,不知不觉聊了个挺有意思的问题:人形机器人和 AI 的发展,真的会让你产生一种很复杂的情绪。
说不上是什么,但就是既担忧,又兴奋🤔。
担忧的是 AI 和机器人的发展速度越来越快,不知道会冲击什么;兴奋的是国家科技实力在这块确实在加速,未来生活估计会变得方便很多。
所以这篇文章,就是我连夜把这一年对 AI 的观察梳理出来,也是在对自己这一年的认知做一个矫正。
说的都是很真实的想法,坦白讲,大概率有点「不那么乐观」。
AI 模型的发展速度还在加快
2025 年上半年的时候,圈子里有一个特别统一的声音:「AI 增长放缓了」。
这个转折最明显的体现就是,很多人开始讨论一个事儿:「AI 增长在某种意义上放缓了,传统的大规模预训练的时代已经不再是唯一的高效成长路径。」
过去 5 年,特别是 2020 到 2025 这段时间,AI 的增长就靠一套方法论:大量未标注数据加上线性扩参,再堆海量算力。这被称作「扩展时代」。
但到了 2025,可用的数据资源慢慢开始见顶,靠规模堆积的效果也开始减弱,一些核心研究者就开始说话了:单靠预训练已经推不动下一个大跳跃。
有个曾经证明过「规模可以显著推动能力提升」的关键人物 Ilya,他公开讲了句话:「我们正在从扩展时代回到研究时代。预训练时代已经接近极限。」这句话在圈子里传得特别开,引发了很大讨论。
为什么会形成这个共识?
主要是三个表象同时出现了。
一是 Benchmark 的分数提升变小了。很多新模型发布时,分数只比上一代高一点点,不再是那种跨代跃迁式的提升。
二是训练成本已经高到离谱,动辄数亿美金,外界自然要问一句:投入这么多,就涨这么点?
三是公开论文和技术分享明显在减少,大厂开始集体「闭源加少说话」,信息密度直线下降,很容易被理解成:没什么新东西了。
所以一个很自然、也很容易传播的判断就出现了:Scaling 撞墙了,大模型进入平台期。
顺着这个判断,大家又推导出下一步:不过话说回来,国产模型快速追赶的时间窗口打开了。有人甚至认真算过账:按 Benchmark 收敛速度推算,国产模型 2 到 3 个月就能和国外前沿模型打平。
但 2025 年下半年发生了什么?
新一代前沿模型一出来,尤其是 Gemini 2.5 Pro 那一波能力展示,整个判断体系被重新打穿了一次。包括 OpenAI、Claude、Grok,以及多家国内基础模型厂商,都统一了一个新认知:预训练远没结束,规模路线仍然有效,只是进入了更精细、更结构化的新阶段。
后训练、推理增强、数据构造、合成数据循环、多阶段训练范式,这些东西把原来「看起来变平」的曲线再次拉陡。Sam Altman 后来的公开表态也等于给这条路线重新背书:钱还要继续砸,规模还要继续推。
这也直接改变了叙事层面的东西。
当前沿 AI 的能力曲线再次被拉开以后,原先「国产模型迅速追齐」的叙事开始摇晃。一个很直观的信号就是,2025 年下半年到现在,国产厂商在发布新模型时,话术明显变了。
从「对齐 GPT、超越 Claude、接近 Gemini」变成了:「与国际前沿 SOTA 模型仍存在差距,但在部分场景具备优势。」
语气收敛了,判断也更现实了。
说白了,没有上半年那种「全面追平、全面反超」的冲锋口气了。
开源
先说开源。这个话题这两年被讲得太好听了,好听到慢慢脱离了实际使用场景。
自从 DeepSeek 爆火以后,「开源」就成为了国产 AI 基础模型厂商的一个重要传播姿态。
一开始大家讨论开源的时候,说的是真东西:技术扩散、社区共建、研究透明,还有让更多人能接触到模型本体。但后来这个事儿逐渐有点变了味道。
很多 AI 基础模型厂商在发新模型的时候,问的第一个问题其实是:「开源会不会更好传播?」答案通常是:会。
因为开源天然自带两个传播优势。第一是立场正确,第二是标签清晰。只要模型一开源,就很容易获得开发者好感、媒体好感和社区转发。这在传播层面的加成非常明显。
问题出在哪儿
但问题在于,当越来越多公司把开源当作传播工具时,它就变成了一种声量放大器。
现在回头看,很现实的一点是:开源越来越像是在帮新模型「进榜单」。
很多 Benchmark、很多模型榜单,本身不分开源组和闭源组。只要你开源,在传播时就能自然被归类进「开源模型阵营」做对比。而开源阵营的整体能力密度,客观上通常低于最前沿的闭源阵营。
这就导致一个很微妙的结果:你更容易在「开源模型榜单」里拿第一。
听起来没问题,但语境被悄悄换掉了。这不能算造假,但确实有点取巧。赢是能赢,但不说明全部问题。
所以你会看到一个现象:不少模型的「开源声量」,远大于它的「纯粹技术贡献」。
现在我们看到一个越来越清晰的分层趋势。
能带生态的模型在开源,能带声量的模型在开源。但真正卡在能力前沿线上的旗舰模型,开始越来越谨慎。
比如,OpenAI 在 2025 年下半年之前,不时会放出风来说:我们在开源上落后了。重复这个论调好几次。但现在呢?硅谷似乎没人讨论开源了。
这也是为什么关于 Meta 下一代旗舰模型 Avocado,业界几乎有一个默认的预期:很可能不会开源。哪怕过去几年 Meta 一直是开源的旗手,但到了能力的临界点,策略一定会重新计算。
说到底,开源这件事没有变坏,但位置变了。
现在的开源,在如此恶劣残酷的竞争下,越来越像一种策略。
国产模型
2026 年 1 月初,两件事几乎同时发生。智谱 AI 在 1 月 8 日上市,估值 511 亿港元,募资 43 亿港元,被称为「全球大模型第一股」。才过一天,1 月 9 号,MiniMax 也上市了,市值 763 亿港元,募资 55.4 亿港元,开盘前的融资认购就超过了预期 30 倍。
首先要为他们鼓掌。
国产 AI 模型需要有一个能赚钱的叙事出来,没钱,再宏大的目标都是胡说八道。两家公司的 IPO,本身就是个很清晰的信号。国产大模型产业进入了商业化的定性阶段。融资故事讲不动了,现在得用赚钱的数据说话。
但这背后隐藏的问题更值得关注。IPO 不是终点,反而是个反问。它反问的是:这些模型真的创新了吗?还是在玩另一种游戏?
比如,MiniMax 的融资信息里有个细节值得琢磨。人家的研发成本仅为 OpenAI 的 1%。这是优势吗?是成本优化吗?还是说,国产模型根本走的就是另一条完全不同的路?
这个问题很关键。因为如果答案是后者,那国产大模型面临的竞争远比想象的要恶劣得多。
换一个视角看,2026 年春节可以说是史上最卷的国产 AI 基础模型竞赛。但这场竞赛的竞争点,现在看来已经不是技术了。
「入口」成为了各家厂商的目光所在。更像互联网时代再度来临,只不过这次争的不是下载量,而是默认入口权。
你能很清楚地看到这个变化。之前讨论的是模型参数、推理能力、训练方法。现在呢?大家讨论的是「放在哪个入口」、「接到哪个 App」、「绑定哪个场景」。红包、补贴、奶茶,一套一套往上堆。
这种打法你我都特别熟,这就是移动互联网打仗时的老剧本。
当竞争进入入口层,其实就说明了一件事:底层能力的代差已经没大到能直接碾压对手了。这确实让人有点担忧。
国产 AI 是否还走在正确的技术路线上?还有没有那种实现 AGI 的野心?因为如果技术差距真的足够大,其实不太需要送鸡蛋 🥚。
从这个角度看,那两次 IPO 不只是融资事件,更像一个信号:国产大模型正式进入了「商业绞杀期」。
热闹肯定会更热闹,但生存的难度也会更高。
网页 AI 和本地 Agent,谁活谁死?
接下来一个会被反复误判的分叉点,是网页 AI 和本地 Agent。
自从 Claude Code、Skills、Codex、CLI、Cowork 这类「工具思维」正式进入大家视野后,我们已经看到了太多国际、国产 AI 基础模型厂商纷纷上马这些项目,也看到了对效率的明显提升。
但很多人现在还在用老问题看新阶段:在网页 AI 里,通过一个路由,根据复杂程度、思考程度分辨模型,ChatGPT 甚至一时间出现了 5 种以上模型。国产 AI 模型发布,也同样一次性发布 3 个尺寸模型。
但未来真正的路由方式,很可能不再按模型分,而是按是否需要本地化执行来分。
从网页 AI 进入 本地 Agent 是一定的,这点无需质疑。
只要任务开始变成连续的、私密的、跨应用的、要长期记忆的,网页形态就会迅速变笨重。本地 Agent 的价值就会突然放大。
光是长期记忆这一点,网页形态的 AI 问答,就足够笨重,而本地 Agent 有太多方式可以应对,想象空间很足。
尤其是一旦进入真实的工作流程层,几个问题就绕不开:要不要长期记忆?要不要读取本地文件?要不要调系统权限?要不要跨 App 操作?要不要常驻后台?要不要低延迟响应?
这些能力,天生更偏向本地执行。
Agent 概念这两年被说滥了,但一个被低估的事实是,它的工程成熟度,已经比很多人预期的要高得多。工具调用、环境操作、长链规划、多步纠错、任务拆解,这些能力在真实系统里已经能跑起来了,不再只是 demo。
一旦 Agent 稳定度跨过可用阈值,产品形态就会发生反转:模型退到后面,Agent 站到前台。
随着模型的进展,未来的用户可能只需要在本地面对一个聊天框,路由只用来分辨是否使用「本地复杂任务特化的模型」还是「只需简单对答的模型」。
入口权会向 Agent 偏移。
工程能力、复刻能力、创新能力
现在来拆「工程能力强」这个概念。这是中国 AI 产业最爱自夸的东西。
我观察了一年,结论其实越来越清楚:这个词用错了。更准确的说法应该叫:复刻能力强。这不是贬义,但需要正名。
因为这两个能力,在产业含义上完全不是一回事。
真正的工程能力,是从 0 到 1 的系统设计能力,是把一个没人验证过的技术方向,变成一个可用产品栈的能力。它包括架构取舍、产品范式定义、系统级优化、交互范式创新,以及在不确定性里把东西做出来。
复刻能力,则是另一种很强但不同的能力:快速理解已经被验证的产品逻辑,把它本地化、成本化、流程化,然后持续迭代,把体验磨到可用甚至好用。
一个偏“首创路径”,一个偏“最优路径”。都难,但难点不一样。
过去很多年,我们习惯把后者也叫工程能力,因为在移动互联网时代,这套能力是绝对优势:海外出一个模式,国内三个月内做出体验更好、成本更低、运营更猛的版本,直接规模化碾压。这套方法论是成功过的。
但在前沿 AI 这里,这两个能力开始被强行拉开。
拿 AI 编程工具举例就特别清楚。
就拿我们又爱又恨的 Claude 举例,因为这个例子太典型了。
Claude Code 成为主流 AI 编程工具,是因为产品范式选对了。它重新定义了“人机共写代码”的交互流程:协作式上下文、持续推理链、任务级拆解、长过程对话记忆。
包括 Cowork、In Excel 这些方向,很多人早就猜到“模型 + 办公软件”一定会出现,但猜到和做出来是两回事。真正把它们系统化、产品化、稳定化地交付出来,这就是 0→1 的工程能力。
Claude 当初最开始宣布他们在做这些产品的时候,我是全程关注的。当时给我们带来的感触是很震撼,但似乎没有感受到实用性。但很多人没想到的是,自从发布这些灵感,到最终发布产品,居然没有一家其他公司做出来这类产品。
Claude 最终实现了诺言,从事后来看,这些产品的体验相当不错。
这些功能单点看,模型含量未必高,但系统整合难度很高。权限、上下文、延迟、错误恢复、交互节奏,全都是硬工程问题。
结果很有意思:不少国内团队很快就补上了对应产品形态,体验也不差,甚至在本地场景更顺手。
再往上看一层,创新能力就更稀缺了。
OpenAI 这些年真正让大家颇为感慨的地方,其实是它不断在重写问题定义:从对话模型,到工具调用,到函数接口,到多模态统一,到推理模型分层,再到 Agent 化执行路线。很多路线在当时都是争议巨大的,但它敢押注,能做出来。
谷歌现在来看还没完全大象转身,但它的底层研究能力一直在那里。一旦产品和组织结构完成对齐,反扑速度很可能会非常快,Gemini 2.5 Pro 和 Nano Banana 就是绝佳的例证。
总结下,复刻可以让你很快到 80 分,但从 80 到 95,通常不在复刻路径上。
所以与其反复强调“工程能力强”,不如更诚实一点承认:我们的复刻能力和产品化能力很强,这已经很厉害;但在范式创新和 0→1 系统工程上,差距仍然存在。
把能力叫对名字,才知道下一步该补什么。
2026 裁员将会更加汹涌,企业方可能不会再「拘束」了
这是一个大多数人都在躲避的话题:失业。
2025 年的数据摆在那儿。美国一整年的裁员人数是 117 万,这是 2020 年疫情以来最高的。其中,AI 导致的裁员有 5.5 万人。这个数字看起来不大,但增长趋势很可怕。
再看具体的企业,亚马逊 10 月裁 1.4 万个企业岗位,微软全年裁 1.5 万人 ( 7 月单月就 9000 人 ),埃森哲 9 月单月超万人裁员,针对的就是「缺乏 AI 技能」的员工。华尔街的预测更激进:未来三年失业超 20 万人。
大学生「毕业即失业」的风险在增加。
但这不是我最在乎的点。
我最在乎的是:为什么 2025 年没有大规模裁员,而 2026 年真的可能来?
原因很简单:企业还没有找到「打通完整 AI 工作流」的方法。
表面上 AI 能替代文书工作。设立一个 Agent 操作员,能顶七个文员。听起来没问题。但那七个文员的隐性工作呢?比如财务部的文书可以用 AI 替代,但财务规划、风险判断、和高管的沟通这种「隐性决策」怎么转移?
企业的报表系统、数据流程全要重建,这不是三两个月能做完的。
一旦有一家公司成功打通这个流程,其他公司就会跟进。这个「临界点」大概在哪儿?
我的观察是:7000 元以下的所有文书工作,从理论上已经可以完全淘汰了。一旦真的有企业做成了,裁员就不会再「拘束」,而是毫不留情的。
我预测这个突破点会在 2026 年下半年出现。
AGI 这词太虎逼了
现在所有人都在说 AGI。说得太多了,多到已经开始失去信息含量。
只要一个模型能力稍微强一点,就有人往 AGI 上靠;只要一个产品能自动跑几步流程,就有人说是“通用智能雏形”;只要一篇论文指标好看一点,标题就敢往 AGI 关键路径上贴。
词被用滥之后,就只剩情绪,不剩定义了。
从当前模型的发展轨迹看,几十年内真正意义上的 AGI 大概率到不了,至少到不了那个“可自我设定目标、自主跨域学习、自主重构知识结构”的版本。
但这个判断本身其实没那么重要。重要的是:AGI 这个词,已经被彻底营销化了。
它变成了一种叙事放大器。
只要贴上 AGI 方向、AGI 路线、AGI 架构,就自动获得三种好处:估值更高、融资更快、媒体更愿意写。技术路线的真实成熟度,反而退居其次。
于是就出现一种很奇怪的现象:AGI 还没来,AGI 溢价先来了。
问题在于,这种叙事会反过来污染判断。
技术讨论被愿景讨论替代,工程问题被口号替代。
AGI 这个词最早是研究用语,是为了区分“窄智能”和“通用智能”。它是个分类概念,不是进度条概念。但现在被用成了进度条,好像谁往前走一步,就能多占一点 AGI 百分比。
这在逻辑上本来就不成立。
更现实一点的说法应该是:我们正在接近的是高能力通用模型 + 强执行 Agent + 工具化智能系统。
而且,这条路径就算走通,也未必会按 AGI 这个词来命名。
AGI 这个词不会消失,但至少不该再被当作营销主轴了。再这么用下去,它会变成当年的“元宇宙”,人人都蹭过,最后没人说得清到底是什么。
历史会记住那些大喊「AGI」的人,裸泳者终会在岸上。
AI 严重「肾虚」患者越来越多
现在一个很有意思的现象是,大家把 AI 领域里的金句,当六味地黄丸在吃。
每天刷十条观点:AI 要颠覆行业、AGI 临近、人类岗位重构、认知革命到来。转发、点赞、焦虑、再转发。情绪补得很满,手上却没工具,流程也没改。
金句泛滥最大的副作用,就是制造了能力幻觉。
好像只要天天看 AI 观点,就等于在参与 AI 中;
但真实情况是普通人对 AI 的实际使用能力,大概只有入门者的百分之一;而入门者,对真正把 AI 嵌进工作流的人来说,也可能只有百分之一。
中间差的是动手密度。
你问一个很简单的问题就知道了,有多少人真正连续一个月用过 Claude Code、Cursor 这种编程助手?有多少人用过 OpenClaw、甚至有多少人用过 DeepResearch?
这就造成一个认知断层:舆论层的 AI 进展速度,远远快于使用层的 AI 渗透速度。前者天天在飞,后者还在走路。
而且还有一个更现实的问题:AI 工具一旦进入真实工作流,是有学习成本和重构成本的。你得改习惯、改接口、改流程、改权限边界。这不是看两篇文章能解决的事,是要花周级、月级时间去磨的。
多数人其实不是被 AI 替代的,多数人是被更会用 AI 的人替代的。
但这句话没有“AGI 来了”好传播,所以不流行。
于是就出现一种很典型的“AI 肾虚症状”:观点摄入过量,实践摄入不足;判断极度宏大,操作极度初级;嘴上全是范式革命,手里还在复制粘贴。
泛 AI情感陪伴赛道将会有大事发生
接下来一个很多人还没认真对待,但我认为一定会出大事的方向,是泛 AI 情感陪伴。
先别急着笑,这条线已经过了「玩具阶段」。
人类对 AI 生物的情感投射,会在接下来一两年里明显加速,而且是结构性加速,不是个别案例。
现在越来越多 AI 交互开始具备三个新特征:持续记忆、人格稳定、情绪反馈。
只要这三件事同时存在,大脑就会自动把它归类为“关系对象”。
很多人低估了一个事实:人类对“拟人反馈”的阈值非常低。只要对方持续回应你、记得你、语气稳定,你就很难把它纯粹当工具看待。
而这一点,模型现在已经完全做得到。
我上一篇《全民大压抑、大擦边时代,AI 是什么角色里》仔细分析过这件事。
情感陪伴赛道过去被看轻,是因为早期产品太像噱头:聊天玩具、虚拟恋人、二次元壳子。但现在底层模型能力变强之后,交互质量已经发生质变,对话连贯度、情绪理解、语境记忆、长期角色一致性,都在快速提升。
一旦“对话像人”跨过阈值,“情感关系”就会跟着发生。
更关键的是,这条赛道的用户行为指标,和传统工具类 AI 完全不同。工具类 AI 玩的是任务完成率、效率提升、调用次数;情感类 AI 拼的是停留时长、对话轮数、复访频率和依赖度。
后者一旦跑通,商业模型会非常凶猛。
Character.ai的日活已经到了 2-3000 万级别,国产 AI 出海产品 PolyBuzz 也夺得 AI 情感陪伴产品日活 Top1,这些都是好的例证。
情感产品天然具备三种属性:高频、长时、强粘性。这在互联网历史上,一直都是最值钱的产品形态之一。社交、游戏、内容平台,全都吃这三点。
而且这条线和 Agent 发展是会合流的。一旦情感 AI 开始进入你自己的生活,帮你安排日程、提醒健康、管理社交、参与决策,它就会彻底迎来转折点。
当然,这里一定会出争议,而且是大争议。
依赖性、替代性、情感错配、未成年人使用、心理健康影响,这些问题一定会被放到台面上反复讨论。监管不会缺席,舆论也不会温和。
所以这条赛道不会悄悄长大,它会带着冲突长大。
下一场真正的用户规模战,可能在情感接口层爆发。
终端超级智能化与小模型爆发
很多人现在还在盯着大模型榜单,但真正会在用户侧产生体感变化的,很可能不是更大的模型,而是更小的模型。
小模型会爆炸性发展,这几乎是一个可以提前下注的判断。我个人对 Apple 这一波尤其期待,因为终端厂商一旦认真下场,小模型的产品形态会被彻底重写。
前段时间,我使用了几款国产手机,比如 Oppo,它已经能够做到帮助你非常便利地发布微信朋友圈文案,也集成了视觉识别能力。再往后,就是豆包 AI 手机,以及国内许多 AI 厂商都在推的 GUI 操作系统,确实惊艳,也让我知道了 小模型加持下的 GUI 是可以保证很好的操作精度的。
原因其实很简单:只有小模型,才能进终端;只有进终端,才有常驻权。
云端大模型再强,也绕不开三个现实问题:延迟、隐私、成本。只要交互是高频的、实时的、带个人数据的,本地推理就会天然更优。
你不可能让耳机每一句实时同传都去云端绕一圈,也不可能让车载系统把全部传感器数据都持续外送推理。
所以终端侧一定需要“够聪明但不巨大”的模型常驻。
手机、汽车、耳机、眼镜、可穿戴设备,这些终端的共同特点只有一个:资源受限,但交互极密。
小模型不是大模型的降级版,它可以为场景特化、为延迟优化、为功耗重写、为权限耦合设计。
国外已经有非常多成熟的 AI 公司开始以「大模型缩小化」作为主打技术,获得大量融资的案例,比如西班牙的 Multiverse Computing。
等到小模型技术彻底成熟,到那一步,AI 就会成为一层操作系统行为。
这也是为什么终端厂商的优势会突然放大。谁控制硬件入口,谁就能决定模型调用时机、传感器权限、上下文深度和默认开关。模型公司如果不进终端层,就会天然晚一拍。
2026 年我们可能将会看到每一家 AI 基础模型厂商都有一家自己的手机公司,或者至少与一家终端厂商合作的场景。
AI 版权将会被放在明面上讨论
过去两年,其实每一代能力跨越式提升的生成模型出来,都会伴随一轮版权争议浪潮。视频这条线尤其明显:从去年的 Sora,到 Sora2,到 Grok 的图像能力,到 Gemini 的 Veo,再到今年 2 月初 Seedance 2.0,只要生成质量跨过一个肉眼可乱真的阈值,负面声音一定同步放大。
AI 音乐生成模型也是一样,或许,这个时候我们该考虑考虑 AI 时代下的「版权」到底是一种什么样的新形态了。
过去版权体系默认一个前提:作品背后一定有一个可识别的人类创作者。但在生成模型时代,这个前提被技术直接打穿了。
模型生成内容既不像纯粹的人类创作,也不像传统意义上的复制粘贴,这玩意谁都没办法定义。
而且最麻烦的事,当版权方开始把视线往前溯源,放在 AI 音视频模型训练数据来源的时候,这事就更难搞了。
大家懂的都懂,没有数据,AI 模型基本就是一坨。要是都靠授权数据,或者是每拿来一批数据,就要去找人授权,那这 AI 也不用做了。
所以,在数据来源上做版权保护,我个人估计不光是企业方,政府方也并不一定喜闻乐见。没人愿意自己国家的 AI 发展落后一步,对于中美来说更是这样。迪士尼、好莱坞该骂还是骂,AI 基础厂商该赔还是赔。
所以,版权体系一定会被迫升级,不是选择题,是时间题。
可以预见的趋势是:版权会被重新拆分成几层,训练使用权、风格使用权、生成发布权、商业变现权。不同层级不同定价,不同许可,不同追责路径。
现在看起来很复杂,但音乐采样、影视改编、字体授权当年也都是这样走过来的。
行业会先吵很多年,然后形成一套大家都不满意但都能活下去的新平衡。
真正值得注意的是一旦有人把训练授权、风格授权、生成分成做成标准化协议,版权方和模型方的关系就会从对抗变成交易。
技术问题变成市场问题之后,争议反而会降温。环球音乐与 Suno 旷日持久的对抗,基本就是以这样的形式落下帷幕的。
AI 一定能改善生活,这不再是个问题
说了这么多模型、路线、资本、开源、Agent、终端、小模型,其实有一件事反而越来越确定:AI 一定会改善生活,这已经不再是个需要争论的问题。
真正的问题只剩下两件事:改善到什么程度,谁先学会用。
很多讨论一上来就卡在一个点:AI 能不能直接带来收入?能不能立刻变现?能不能替代岗位?但这其实把问题问窄了。
技术对生活的改善,从来不只体现在直接赚钱上。
看病的时候,能不能帮你把报告先读明白;做内容的时候,能不能帮你把结构先搭出来;写论文的时候,能不能帮你把文献先看完。
有飞蚊症这种小毛病的时候,能不能先给你可靠的信息判断;过年回老家,红包习俗、彩礼区间、礼数差异能不能先帮你查清楚;教育孩子时,能不能给你一套更清晰的解释方式和学习路径。
这些都是改善,只是它们不一定直接体现在工资条上。
生产力不只等于收入。
很多人低估了一点:把一个人每天要做的“微小决策成本”降下来,本身就是巨大的生活升级。以前要查半小时的东西,现在三分钟搞清;以前要来回试错的流程,现在一步到位。
当然,也有很多人期待另一种改变:让 AI 直接替你干活,直接替你赚钱,直接替你完成工作的一大块。
这不是不可能,但这里有个很现实的问题绕不开:如果 AI 能完整替代你现在做的那部分工作,你的生态位在哪里?那为什么别人不这么干?
技术替代从来不是新闻,被替代的,往往是最容易被流程化的人。
AI 最先吃掉的,是标准流程、重复决策、模板输出、规则清晰的那部分工作。越像流程节点,越容易被自动化。
所以如果要给这篇文章收一个尾,我更想把话说得简单一点。
AI 不会按我们情绪的节奏发展。
不会因为有人焦虑就慢一点,也不会因为有人兴奋就快一点。
这一年看下来,我最大的感受是不管你懒不懒,能克服还是要克服一下,多用一用 AI ,多玩一玩新功能。
能连续用三个月的人,会和只连续看三个月观点的人,走到两条可能完全不同的路上。
至于人形机器人会不会越来越像人,Agent 会不会变成入口,岗位会不会被重构,AGI 会不会被重新命名,这些问题都值得讨论,但它们都比不过一个更直接的问题:你有没有开始把 AI 变成你的日常能力。
如果这篇长文能起一点点作用,我希望不是制造焦虑。
技术的浪会一波一波来,
我们水里见。
最后 ㊗️ 2026 年,所有「杉森楠」的关注者,发大财 !!!财神在上,我帮大家先拜了 🙏。
看到这里,辛苦啦。
感谢你的阅读和「在场」!
文章来自于微信公众号 "AI Humanist by杉森楠",作者 "AI Humanist by杉森楠"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。

黄仁勋离任后:硅谷101访谈英伟达的技术、供应链与组织挑战 (opens in a new tab)
硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。