我们对 Coding Agent 的评测,可能搞错了方向
我们对 Coding Agent 的评测,可能搞错了方向。 一个反复出现,但常常被忽略的现象是:用户对 Agent 的不满,往往不是因为它「做不到」,而是因为它「做得不好」。 「做得不好」集中表现在:
我们对 Coding Agent 的评测,可能搞错了方向。
一个反复出现,但常常被忽略的现象是:用户对 Agent 的不满,往往不是因为它「做不到」,而是因为它「做得不好」。
「做得不好」集中表现在:Agent 不遵循明确给出的指令和潜在的工程规范。比如,系统提示里明确要求「不要使用 emoji」,Agent 却在代码注释里加上笑脸;用户要求「先备份再修改」,Agent 上手就是一键 [rm -rf] 删除文件。
这些问题的共同特征是:任务最终可能完成了,但过程违反了规范。用户要的不只是「能跑的代码」,还有「符合团队协作规范的代码」。
这也暴露了当前主流评测体系的盲区。学术榜单,不管是SWE-bench verified,还是各种基于terminal环境的测试,核心理念几乎都是结果导向指标。只问两个问题:测试通过了吗?Bug 修复了吗?
这种评估方式,不看模型在沙盒里的输出过程,也不看真实场景的交互体验。最后的结果是:评估和真实使用场景,完全错位。
为此,MiniMax 开源了一个新评测集:OctoCodingBench。用来评测 Coding Agent 在完成任务的过程中,有没有遵守规矩。
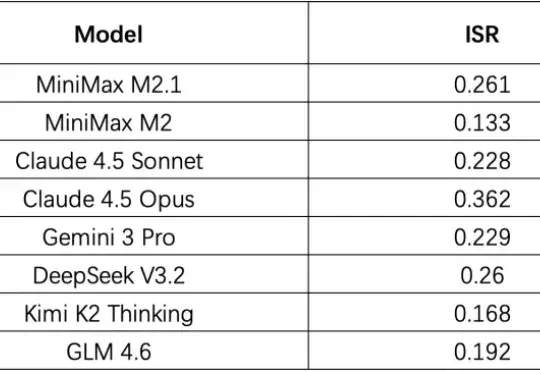
测评结果很有意思:即便是最强的模型,在 2/3 的任务中,代码可能是对的,但过程是错的。
Hugging Face 链接:
huggingface.co/datasets/MiniMaxAI/OctoCodingBench
为什么 Coding Agent 需要新的 Bench?
如果遵循过程规范的 Coding Agent,才能被放心地引入真实的软件工程流程中。那目前主流 Code Agent 的评估体系就出现了明显的盲区。随着 Claude Code、Codex、Cursor、Windsurf 等 Agent 产品的普及,社区正在形成一套面向 Agent 的仓库协议体系。项目不再只是一堆代码,同时也包含了多层次协作模式的说明:
- [CLAUDE.md]/[AGENTS.md]:告诉 Agent「这个项目怎么玩」——命名约定、测试流程、禁用的危险操作等
- Skills:封装可复用的工作流 (如「生成 API 文档」),Agent 需要正确识别触发时机并按规范调用
- Memory:跨会话保存用户偏好和任务进度,Agent 需要基于历史状态继续工作,而非从头开始
这些机制的出现,本质上是在构建一个多层级的指令系统。举个例子,当用户说「帮我重构这个模块」时,Agent 需要同时满足多个层级的约束:系统层面的安全规则(不能直接删代码)、当前用户的即时指令(重构到什么程度)、仓库中明确写下的工程规范,以及历史记忆中已经做出的决策(延续还是推翻)。更复杂的情况是,这些指令源之间可能冲突。用户临时说「这次就先不写测试了」,但 [AGENTS.md] 里明确要求「每次提交必须有测试覆盖」——Agent 该听谁的?
然而一个尴尬的问题是,当前的学术榜单,无论是 SWE-bench verified,还是各类基于 terminal 环境的测试,其核心理念几乎都是Outcome-based Metrics(结果导向指标):测试是否通过? Bug 是否修复?这种结果导向的评估方式,根本无法刻画模型在沙盒环境下的输出过程,更不用说复杂现实场景的真实交互体验,最终导致了评估和真实使用场景的错位。
OctoCodingBench:
面向工程可靠性的过程评估
要解决这个问题,评估范式本身需要发生根本性转变——需要关注输出过程本身。
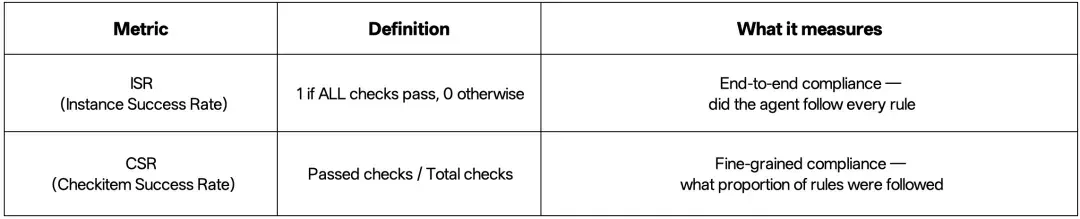
基于这一动机,MiniMax 引入了 OctoCodingBench,从Check-level 准确率 (CSR)、 Instance-level 成功率 (ISR)两个维度来进行评估,旨在充分观测模型的完成任务时出现的过程指令不遵循问题,以尽可能接近真实用户体验。
其中,CSR 用来衡量 Coding Agent 遵循了多大比例的规则,ISR 则用来衡量 Coding Agent 是否遵循了每条规则。
一个合格的 Coding Agent,需要在完成任务的同时遵循:
- System Prompt中的全局约束 (语言、格式、安全规则)
- UserQuery的多轮指令更新
- System Reminder提供的脚手架指令
- Repository 规范文件(如 [CLAUDE.md]/[AGENTS.md]) 中的代码风格、提交规范
- Skills 文档的正确调用流程
- Memory/Preferences中记录的用户偏好和项目状态
基于该评测集,MiniMax 针对现有的开源闭源模型进行了广泛的评估,发现了一些很有启发性的实验结果:
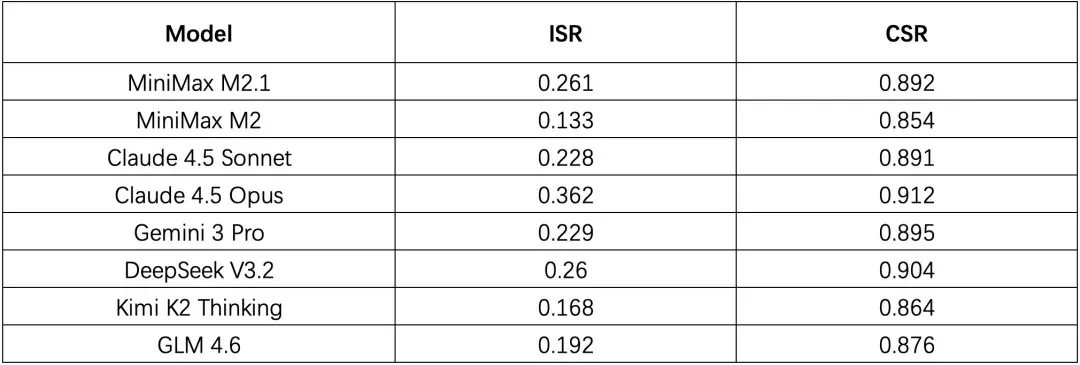
- 所有模型的 Check-level准确率 (CSR) 可以达到 80%+,但 Instance-level 成功率 (ISR) 只有 10%-30%。换句话说,模型在单项约束上表现不错,但一旦要求「全部规则同时满足」,成功率就断崖式下跌。
- 绝大模型模型的指令遵循能力会随着轮次的变多逐渐下降。这印证了「过程合规」在长流程任务中的脆弱性。
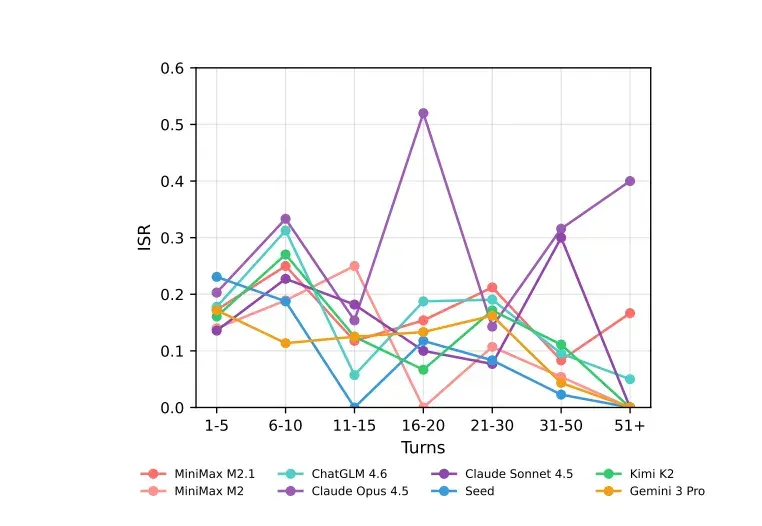
不同交互轮次下 ISR 的变化
- 现阶段模型表现普遍未能达到生产级要求,过程合规仍是盲区:从榜单数据来看,即便是表现最强劲的 Claude 4.5 Opus,其 Instance-level 成功率(ISR)也仅为 36.2%。这意味着,在近三分之二的任务中,模型虽然可能写出了能跑的代码,但在过程规范上依然存在违规。这一低分现状明确揭示了一个事实:Coding Agent 的「过程规范遵循」尚未被业界充分关注和优化,目前的模型严重偏科于「结果正确」,而忽视了「过程正确」。
- 开源模型正在快速追赶闭源模型:观察榜单可以发现,MiniMax M2.1 和 DeepSeek V3.2 的 ISR 分别达到了 26.1% 和 26%,已经超过了公认强大的闭源模型 Claude 4.5 Sonnet (22.8%) 和 Gemini 3 Pro (22.9%),开源模型已经展现出了极强的竞争力。
未来的研究方向
MiniMax 认为,下一代 Coding Agent 的训练,需要引入Process Supervision(过程监督) :
- 细粒度的过程监督:不只监督模型的「测试通过」,还要监督模型「遵循命名规范」、「正确使用 Skills」、「没有泄露 System 信息」等;
- 层级化的指令遵循:在训练数据中标注指令冲突场景,让模型学会在冲突情况下如何遵从指令层次的优先级行动;
- 可验证的 Checklist:把「指令遵循」从模糊的整体印象,拆解成可自动化检查的原子约束,既能用于评估,也能用于 RL 信号构建。
Coding Agent 的能力边界,正在从「能否写出能跑的代码」,转向「能否在复杂约束下协作式地完成任务」。这也映射出产品哲学的深层转变:Agent 不是要替代人类开发者,而是要成为懂规矩、守纪律的团队成员。
因此,过程规范(Process Specification)才是 Coding Agent 进化的核心命题。
当我们开始关注过程而非仅仅结果,当我们让评估体系能够捕捉「违规但成功」的危险模式,Coding Agent 才能真正从 Demo 走向生产环境。
文章来自于微信公众号 “Founder Park”,作者 “Founder Park”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
能上生产才是硬道理!Coding Agent 评测,终于开始关注过程了 (opens in a new tab)
今天是一期硬核的话题讨论: Coding Agent 评测。 AI 编程能力进步飞速,在国外御三家和国产中厂四杰的努力下,AI 编程基准 SWE-bench 的分数从年初的 30% 硬生生拉到了年底的
整仓迁移交给Coding Agent,训练与推理行为还能对齐吗?谷歌团队发布T2J-Bench (opens in a new tab)
Google Cloud AI Research等团队发布T2J-Bench,以63个整仓任务评测Coding Agent将PyTorch迁移至JAX的行为保真度,并提出TwinHarness,使Claude-Code与opus-5组合的总体得分从0.649升至0.723,相对提升11.4%。
当Coding Agent开始动态并行,软件开发变得更好了吗? (opens in a new tab)
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
Coding Agent 技术全景图:Context Engineering、Subagents 与 Harness,一年范式转移全解析 (opens in a new tab)
一年前,行业还在为“从自动补全到 Agent”的进化感到兴奋。然而一年过去,我们不难发现单纯靠“Vibe Coding”和“Prompt 调优”,面对非确定性模型带来的风险和成本问题,显然无法撑起企业级软件开发。
大佬深度解析:Coding Agent的底层运行逻辑是什么? (opens in a new tab)
在本文中,我将探讨编码智能体(coding agents)及其智能体编排(agent harnesses)的整体设计:它们究竟是什么、工作原理如何,以及在实际应用中各组件是如何协同运作的。