看完 Manus、Cursor 分享后的最大收获:避免 Context 的过度工程化才是关键
最近,Cursor 也发表了一篇文章《Dynamic context discovery》,分享了他们是怎么做上下文管理的。结合 Manus、Cursor 这两家 Agent 领域头部团队的思路,我们整理了如何做好上下文工程的一些关键要点。
毫无疑问,上下文工程的优化,仍然是 Agent 创业公司在新一年都在「卷」的重点。
在实际落地开发中,上下文信息的质量,很大程度上决定了 Agent 的表现。
Manus 的首席科学家季逸超在之前访谈中提到过一个观点:
初创公司真的应该尽可能长时间地依赖通用模型和上下文工程,而不是过早地构建专用模型,也包括微调。上下文工程是应用层和模型层之间最清晰、最实用的边界。
做好上下文工程,开发者能够在不触及模型底层权重的前提下,灵活驾驭模型,同时还能适应快速变化的产品需求。
最近,Cursor 也发表了一篇文章《Dynamic context discovery》,分享了他们是怎么做上下文管理的。
结合 Manus、Cursor 这两家 Agent 领域头部团队的思路,我们整理了如何做好上下文工程的一些关键要点。
Cursor 原文:https://cursor.com/cn/blog/dynamic-context-discovery
「上下文缩减」是最直接有效的策略
在 Agent 的构建过程中,会发现一个现象:上下文会持续增长,并且是以一种非常特殊的方式增长。
Agent 每调用一次工具,就会返回一个工具的观测结果,这个结果会被追加到聊天记录中。随着时间的推移,消息列表会越来越长,导致 Agent 在运行时消息数量出现无限制的爆炸性增长。
Manus 之前提到,典型的任务大约需要调用 50 次工具。Anthropic 也提到过类似的情况,生产环境中的 Agent 可能会进行长达数百轮的对话。
上下文长度的持续增长,会导致推理性能断崖式的下跌。业内叫做「上下文腐烂」(Context Rot),具体表现是:推理变慢、质量下降、甚至开始无意义地重复。
如何解决?业内目前共识的一个方法是「上下文卸载(Context Offloading)」,核心思路是别把所有东西都硬塞进 Agent 的短期记忆里,把它卸载出去。放到上下文窗口之外,但在需要时,又能被精确地检索回来。
将信息转移到文件系统中,是目前生产级 Agent 中主流、最 Work 的一种做法。
Cursor:万物皆可文件化
Cursor 把「卸载」这个思路,发挥到了极致。用文件作为基础单元,将冗长的工具结果、终端会话、聊天记录全部转化成文件。
Cursor 提到,
我们不确定未来 LLM 工具的最佳接口是什么。但文件是一个简单、强大的基础单元,比发明一套新抽象要安全得多。
基于这个思路,Cursor 提出了「动态上下文发现」(Dynamic Context Discovery)模式。核心是,别急着把信息塞给模型,而是让模型在需要的时候自己去找。
Cursor 把这套模式用到了他们的多个实际场景中:
- 将冗长的工具结果转化为文件
工具调用,特别是 Shell 命令或第三方 MCP(模型上下文协议),经常返回巨大的 JSON 响应,瞬间就能撑爆上下文。目前的编程 Agent 通常采取的简单粗暴做法是:直接截断过长的 Shell 命令或 MCP 结果,但很可能会丢失最关键的信息。
Cursor 的做法是,将这些输出直接写入到一个文件,然后在上下文中只告诉 Agent:「结果在 output.log 里,你自己去看。」Agent 可以先用 tail 命令查看文件末尾,如果需要更多细节,再读取整个文件。
- 在「总结」阶段引用聊天记录
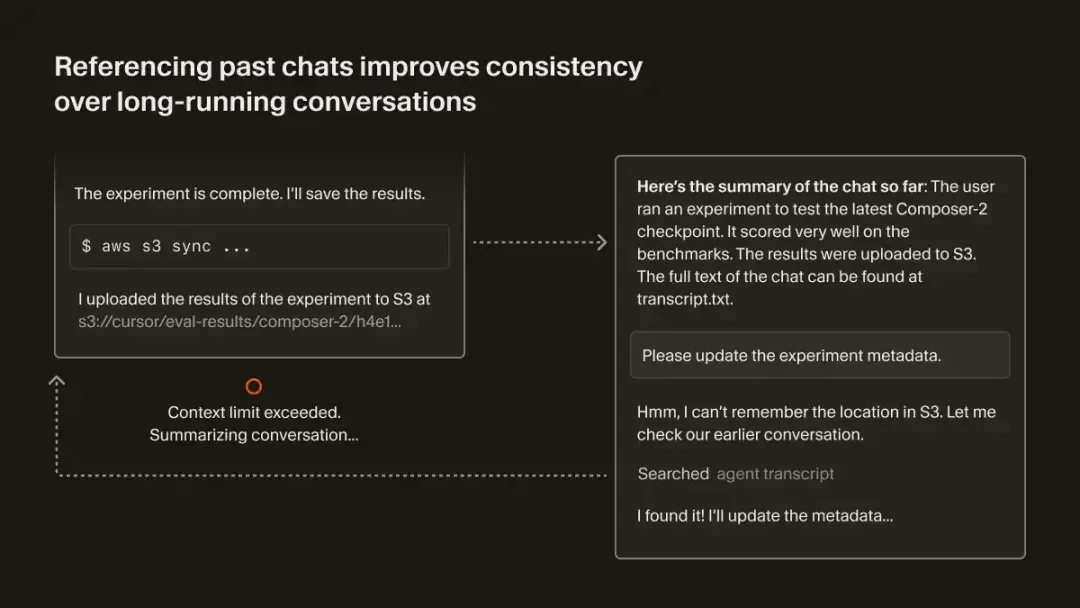
当模型的上下文窗口被填满,Cursor 会触发一个「总结」步骤,给 Agent 腾出一个新的上下文窗口,其中包含之前工作的摘要。
但 Agent 的知识会在这个过程中「退化」,因为「总结」本质上是对上下文的一种有损压缩。 Cursor 把完整的聊天历史记录也看做是一个文件。当触发总结时,Agent 会拿到一份摘要,以及一个指向「历史记录文件」的引用。如果 Agent 意识到摘要中缺少某些它需要的细节,它就可以通过搜索这份历史记录文件来找回这些信息。
- 将所有集成终端的会话视为文件
在 Cursor 中,不再需要手动复制粘贴满屏的终端报错信息,会自动将集成终端的所有会话输出同步到本地文件系统。 提问「为什么我的命令失败了?」时,Agent 能直接定位问题,甚至可以使用 grep 这样的命令,在长篇的服务器日志中只搜索相关的错误行。这种做法模仿了 CLI Agent 的体验,拥有之前的 Shell 输出作为上下文,但不同的是,它是动态发现,不是被静态注入。
Manus :一套结构化的可逆、缩减系统
对比 Cursor「简单粗暴」的解决思路,Manus 的做法是,把「上下文缩减」设计成了一套有明确触发机制、分阶段执行的结构化流程。
首先,Manus 的系统会持续监控上下文长度,设定一个远低于模型硬件极限的「腐烂前阈值」(Pre-rot Threshold)。
季逸超:你的模型有一个硬性的上下文限制,比如说 100 万个 Token,这在今天是相当普遍的。但实际上,大多数模型在远低于这个值时性能就开始下降,通常可能在 20 万个 Token 左右,你会开始看到我们所说的「上下文腐烂」,比如重复、推理变慢、质量下降等。
所以,通过大量的评估,识别出那个「腐烂前」的阈值非常重要,通常是 12.8 万到 20 万个 Token,并将其作为触发上下文缩减的条件。
当信号被触发后,系统会启动第一阶段的操作:
第一步:紧凑化(Compaction)
这是一种无损、可逆的缩减。核心是,剥离掉任何能从外部状态(比如文件系统)重建的信息。
举个例子,Agent 调用了一个向文件写入内容的工具,这个操作在历史记录中可能包含 path 和 content 两个字段。一旦执行成功,那个可能极其冗长的 content 字段就可以被安全地从上下文中剥离,只保留 path。
信息并没有丢失,它只是被「外部化」了。如果 Agent 在 10 步之后需要再次读取该文件,它凭借保留的 path 就能轻易将其检索回来。
Manus 提到,这种可逆性是非常关键的,因为你永远不知道哪个过去的动作会成为未来的关键。
通常情况下,紧凑化只会用作最早的 50% 的历史记录,来保留最新的、完整的工具调用作为模型学习的范例(Few-shot Examples)。
但紧凑化收益有限。多轮操作后,上下文削减的收益变得微乎其微时,系统会启动第二阶段:
第二步:摘要化(Summarization)
这是一种有损、但带保险的压缩。把它当做最后手段,在执行时需要极其谨慎。
它的「保险」在于:在生成摘要之前,系统会更激进地将整个摘要前的完整上下文,转储(Dump)到一个文本或日志文件中。 相当于给历史创建了一个完整的快照存档。如果模型足够聪明,它甚至能用 grep 或 glob 自己去这个日志里捞数据。
季逸超:紧凑化是可逆的,而摘要化不是。两者都减少了上下文长度,但它们的行为方式非常不同。
在进行摘要化时,总是会使用完整版本的数据,不是紧凑版本。
摘要化依然会保留最后几次完整的工具调用记录。 这能让模型清楚地知道自己从哪中断,能平滑地继续工作,保持风格和语气的连贯性。
两个步骤下来,通过「紧凑化」(Compaction)剥离可重建信息,以及在「摘要化」(Summarization)之前,将完整的上下文转储(Dump)到日志文件中。实现上下文缩减。
给工具搭建一套灵活的行动空间
当 Agent 能力逐步增强,配备的工具集也越来越丰富。
如果将所有工具的冗长描述,都放到上下文窗口中,会带来两个问题:
- 一是出现上下文混淆(Context Confusion)的情况,工具太多,模型直接懵掉。可能会调用错误的工具,甚至是幻觉出根本不存在的工具。
- 二是最直接的 Token 浪费,大多数工具,在绝大多数时候根本不会被用到。如果,还使用了多个 MCP 服务器,情况会变得更糟。
工具过载的问题怎么解决?一个核心思路是:动态发现,让 Agent 自己去找要调用哪些工具。
Cursor:把工具说明书,全部文件化
Cursor 的策略,更简单、粗暴。把所有 MCP 工具、Agent Skills 的详细定义,全部都同步到文件夹里,让 Agent 在需要时自己去查阅。
在 Cursor 的框架中,分成了索引层和发现层。
索引层,Agent 的系统提示词(System Prompt)里只包含一小部分静态信息,比如 MCP 工具或 Agent Skills 的名称列表。
这些工具和技能的详细描述、参数定义、使用方法,则被全部同步到一个本地文件夹中。当模型需要时,Agent 会像一个聪明的程序员一样,进入发现层,用 grep 或语义搜索,主动去文件夹里查找它需要的工具的详细信息,然后拉取到上下文中来处理。
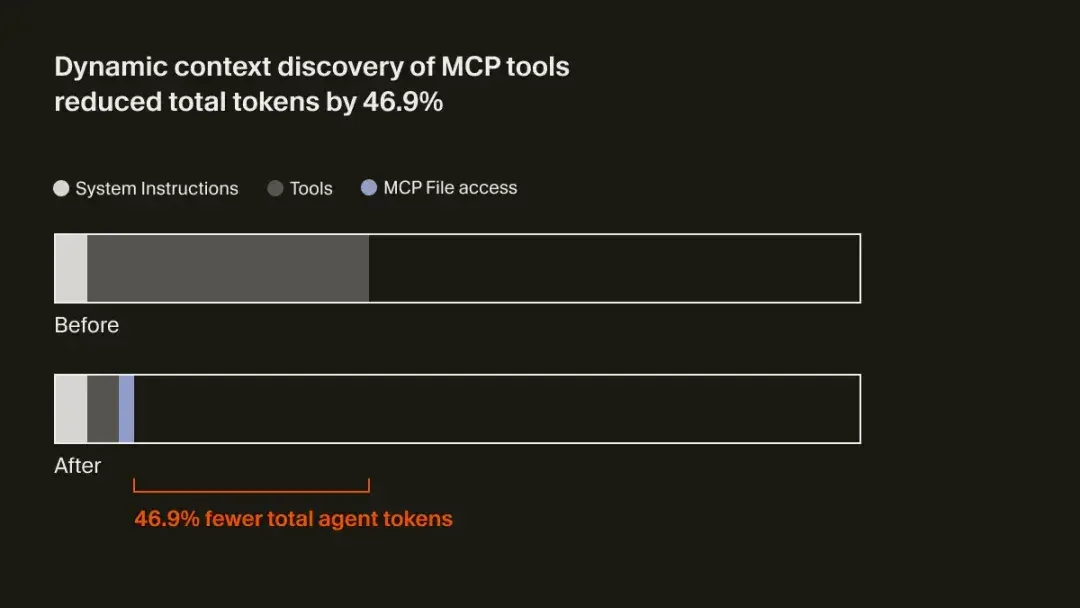
Cursor 做了一次 A/B 测试,结果发现,对于调用了 MCP 工具的运行任务,这种策略把Token 的总消耗降低了 46.9%。
同时,Cursor 提到,这种全部文件化的方式,还解锁了一个意想不到的能力:向 Agent 传达工具的状态。
例如,以前如果一个 MCP 服务器需要重新认证,Agent 可能会直接「忘记」这些工具的存在。但现在,Agent 可以主动发病、告知用户去重新认证。
Manus:设计了一套分层的行动空间
Manus 认为,常见的方法对工具描述进行动态的 RAG,不可行。 因为动态加载工具定义,会「干掉」KV 缓存,且历史记录里的旧调用会成为陷阱。
为了解决这个问题,Manus 设计了一套分层行动空间。把 Agent 的能力划分为三个层次:函数调用、沙盒工具、软件包和 API。
- 第一层:原子函数调用(Function Calling)
核心层,只包含极少数固定的、正交的原子函数,比如:读写文件、执行 shell 命令、在文件和互联网中搜索。因为这层是固定的,所以对 KV 缓存友好,且功能边界清晰,不会导致混淆。
- 第二层:沙盒工具(Sandbox Tools)
卸载层。Manus 将绝大多数工具,格式转换器、语音识别工具,甚至 MCP 调用本身(通过一个 MCP CLI 命令行工具),都作为预装软件放在一个定制的 Linux 虚拟机沙箱里。 Agent 不在上下文中「看到」这些工具的详细定义,更像是一个真正的开发者,通过第一层的 shell 命令来动态地与它们交互。比如,它可以用 ls /bin 来查看有哪些可用的工具,或者用 mcp_cli --help 来学习如何使用 MCP 命令行工具。
- 第三层:软件包与API(Packages & APIs)
代码层。对于需要大量内存计算或者需要与复杂第三方服务交互的任务,允许 Agent 编写并执行 Python 脚本。比如,分析一整年的股票数据,Agent 不会把原始数据加载到上下文中,而是会写一个脚本去完成计算,只把摘要结果返回。
季逸超:在这一层,Manus 可以编写 Python 脚本来调用预先授权的 API 或自定义软件包。例如,Manus 可能会使用一个 3D 设计库进行建模,或者调用一个金融 API 来获取市场数据。实际上,我们已经代表用户购买了所有这些 API 并支付了费用,这都包含在订阅里。
所以,我们基本上在 Manus 中预装了大量的 API 密钥,Manus 可以用这些密钥访问 API。我认为这对于需要大量内存计算,但又不需要将所有数据都推送到模型上下文的任务来说是完美的。
这套思路,和 CodeAct *论文类似。
代码是可组合的,可以在一步内做很多事。但它同样不是模式安全的,在代码上做约束解码非常非常困难。所以我们认为你应该为这些功能找到合适的场景。对我们来说,所有能在一个编译器或解释器运行时内处理的事情,我们都用代码来做;否则,我们就用沙箱工具或函数调用。
CodeAct *:《Executable Code Actions Elicit Better LLM Agents》:
https://arxiv.org/pdf/2402.01030
Manus 这套分层设计非常优雅,而且高效。从模型的角度看,无论想使用第二层还是第三层的复杂工具,最终都会通过 L1 的那几个原子函数执行。这种接口设计,对模型极度简洁,且缓存稳定。
多 Agent 协作,
需要反复使用模式、结构化输出
多个 Agent 之间如何协作,也是个难题。
Cognition 之前在博客中提到:不要滥用多 Agent 设置,因为当你有很多 Agent 时,它们之间的信息同步会成为一场噩梦。
怎么利用多 Agent,实现「上下文隔离」,让每个子 Agent 都有自己独立的上下文窗口,从而实现关注点分离。是一个核心问题。
Manus 的解决思路是,借鉴 Go 语言:不要通过共享内存来通信,而是通过通信来共享内存。
把这句话里的「内存」替换为「上下文」,就是两种截然不同的 Agent 协作模式。
两种 Agent 协作模式
- 任务委托模式:「通过通信」实现隔离
这是经典的主-子 Agent(Master-Sub-agent)设置。主 Agent 将一个任务封装成一条简短、清晰的指令,然后发送给子 Agent。子 Agent 的上下文是完全独立的,从零开始,只包含这条指令。
简单来说,主 Agent 发任务,子 Agent 交结果,中间过程免打扰。
这个模式,适用于「过程不重要,只关心结果」的任务。举个例子,主 Agent 需要在一个大型代码库中搜索特定的代码片段。它只需要委托子 Agent:「在 A 项目中找到所有调用了 some_function 的地方」,然后等待返回结果列表即可。主 Agent 不关心子 Agent 是如何使用 grep 或其他工具完成搜索的。
在内部,Manus 将这种模式叫做「Agent 即工具」。从主 Agent 视角,它只是调用了 advanced_search 函数,但背后实际上是另一个拥有独立工作流的子 Agent 在执行。
- 信息同步模式:「通过共享上下文」实现协作
但对于更复杂、需要完整历史记录的场景,简单的任务委托是远远不够的。
Manus 的思路是,通过共享上下文来实现协作。子 Agent 被创建时,能够看到主 Agent完整的先前上下文,包括所有的历史工具调用和观察。但这个子 Agent 拥有自己独立的系统提示词和新的行动空间。
这种模式,更适用于高度依赖历史信息、需要综合分析的任务。比如,在进行一项深度研究任务时,最终的研究报告需要综合大量的中间搜索结果和笔记。
如果使用第一种通信模式,主 Agent 需要将所有中间产物写入文件,再让子 Agent 去一一读取,这会造成巨大的延迟和额外的 Token 消耗。在这种情况下,直接让子 Agent 继承完整的上下文反而会更高效。
但 Manus 也提到,共享上下文的模式成本是相当昂贵的。因为每个子 Agent 启动时都需要 Prefill 一个非常大的输入,并且因为系统提示词不同,无法复用主 Agent 的 KV 缓存,所以必须支付全价。
所以,需要根据任务的性质,灵活地在这两种模式中间进行选择。
多 Agent 通信,发信息不难,难的是收结果
多 Agent 通信的一个难点是「接收」,如何从多个并行工作的子 Agent 那里,获得结构一致、内容准确的输出?
Manus 设计了一套内部代号叫做「Agent 化的 MapReduce」的系统。简单来说,
- 共享沙箱
每个 Manus 会话都在一个完整的虚拟机沙箱中运行。当主 Agent 创建子 Agent 时,共享同一个沙箱。这意味着,共享同一个文件系统,信息的传递可以简单到只传递不同的文件路径,解决了输入信息同步的问题。
- 输出模式(Schema)
这是关键。主 Agent 在创建子 Agent 之前,必须先定义一个输出的 Schema。这个模式就是一份强制执行的 API 合同,规定了子 Agent 最终必须返回什么样的数据结构。
- 约束解码
子 Agent 有一个专用工具 submit_result。Manus 使用约束解码(Constrained Decoding)技术,强制子 Agent 提交的结果,必须严格符合主 Agent 定义的 Schema。
这套设计的核心思路是,无论是做摘要还是 Agent 间通信,都反复使用模式和结构化输出作为一种「契约」,来保证信息以结构化、完整的方式传递。
最后,聊聊两家的设计哲学
最后,回到原点,聊聊这两家的上下文工程设计哲学。
Cursor 的「Dynamic Context Discovery」,强调:少即是多。Cursor 认为,在最开始提供给模型的细节越少,效果反而越好,因为能让 Agent 更轻松地自行抓取相关的上下文。
Manus 的思路是:「少构建,多理解」,避免上下文的过度工程化。上下文工程的目标是让模型的工作变得更简单,而不是更难。
季逸超:回顾 Manus 发布以来的六七个月,我们见过的最大的飞跃,不是来自增加了更多花哨的上下文管理层或巧妙的检索技巧,它们都来自于简化,来自于移除不必要的技巧,以及对模型多一点的信任。
每一次我们简化架构,系统都会变得更快、更稳定、更智能。上下文工程的目标是让模型的工作变得更简单,而不是更难。
两家的实践大方向都是,从「如何把更多信息塞进上下文」,变成「怎么给 Agent 创建一个信息丰富、易于探索的外部环境」。
引用宝玉老师的一句话:未来,随着基模能力的提升,把主动权交给模型会是一个趋势。
文章来自于微信公众号 “Founder Park”,作者 “Founder Park”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
从 Cowork 到 Cursor:Jenny Wen 的设计经历与 Agent 产品思路 (opens in a new tab)
量子位报道,曾参与 Claude 与 Cowork 设计的 Jenny Wen 已转向 Cursor,其社交简介也出现 Grok Bot。文章回顾她从 FigJam 到通用智能体的工作经历,以及对设计流程、快速试错和用户控制的看法;是否能改善新产品体验仍要看后续交付。
一觉醒来20个PR自己合进了主干!SpaceXAI工程师:我基本不看代码了 (opens in a new tab)
SpaceXAI工程师Lauren Tan用pstack并行运行20多个GrokBot智能体,单月交付1000多个PR,核心是用control glass等技能让智能体自验证,并以Dune架构禁用useEffect与注释、强制进程隔离等硬约束取代人工盯代码,使智能体可自主完成写码、测试与主干合并。
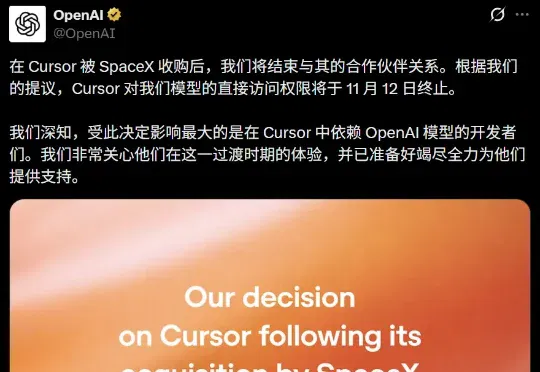
突发!OpenAI彻底断供Cursor (opens in a new tab)
就在刚刚,OpenAI宣布断供Cursor!根据方案,Cursor对我们模型的直接访问,将于11月12日彻底终止。至于下一代最强模型Astra,官方渠道永远不给。理由很简单。
马斯克罕见认怂,天价收购 Cursor 首次发声:Grok 落后了 (opens in a new tab)
据 The Information 报道,本月早些时候,这笔备受行业瞩目的天价收购案正式尘埃落定。随后,马斯克通过视频连线,首次直面了聚集在 Cursor 旧金山总部及各办公区的 1000 多名新员工。在这场内部会议上,马斯克非常坦诚地剖析了当下的竞争格局。
离谱!晒出Claude退订截图就送你200刀:Cursor抢人抢疯了 (opens in a new tab)
一张截图,200美元。 就在昨天,网友@notjazii 早上睁眼,发现Cursor账户里多了200刀。而他只是把自己退订Claude的截图,发给了Cursor的人。 他发帖说:我啥也没干,交了张退订截图,200刀到账。 这200美元能让他几乎可以随便刷Grok 4.6了。 退订Claude的截图,一夜之间成了硬通货。 一条「可能挨骂」的帖子 一切始于前一天。8月17日,Cursor工程师Lauren(@poteto)在X上公开喊话。帖子写得极其直白: 「我可能会因为这条帖子挨骂,但你要是正考虑切到Cursor加Grok Bot,把邮箱和取消其他订阅的截图私信发我,我送你一个月免费Ultra。