100万亿Token揭示真相:中国开源AI拿下30%全球份额,推理已成主流
之前我在这篇文章(超全面免费 AI API 分享!零成本开启你的AI之旅!)中介绍过 OpenRouter 这个大模型 API 聚合平台,最近他们通过分析了100 万亿 token用户真实数据,发布了一篇研究报告,反应了真实用户的大模型使用现状。100 万亿 token 是什么概念呢?是人类所有文字资料的好几倍,这个数据量非常有说服力。
前言
之前我在这篇文章(超全面免费 AI API 分享!零成本开启你的AI之旅!(在新窗口打开))中介绍过 OpenRouter 这个大模型 API 聚合平台,最近他们通过分析了100 万亿 token用户真实数据,发布了一篇研究报告,反应了真实用户的大模型使用现状。100 万亿 token 是什么概念呢?是人类所有文字资料的好几倍,这个数据量非常有说服力。
原文链接如下:https://openrouter.ai/state-of-ai ,感兴趣的朋友可以看看。我看完后大为震惊,原文很长而且是英文,如果你没时间看原文的话,可以看我这篇文章,可能会颠覆你对 AI 行业的很多认知。
2025 年中国开源模型势不可挡
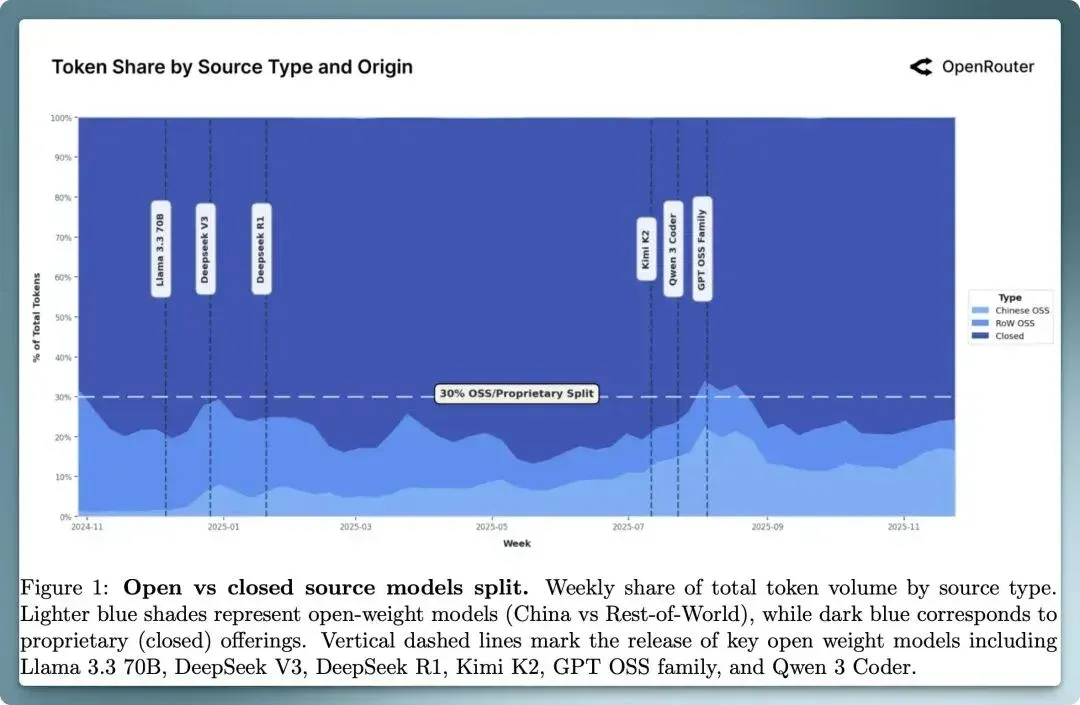
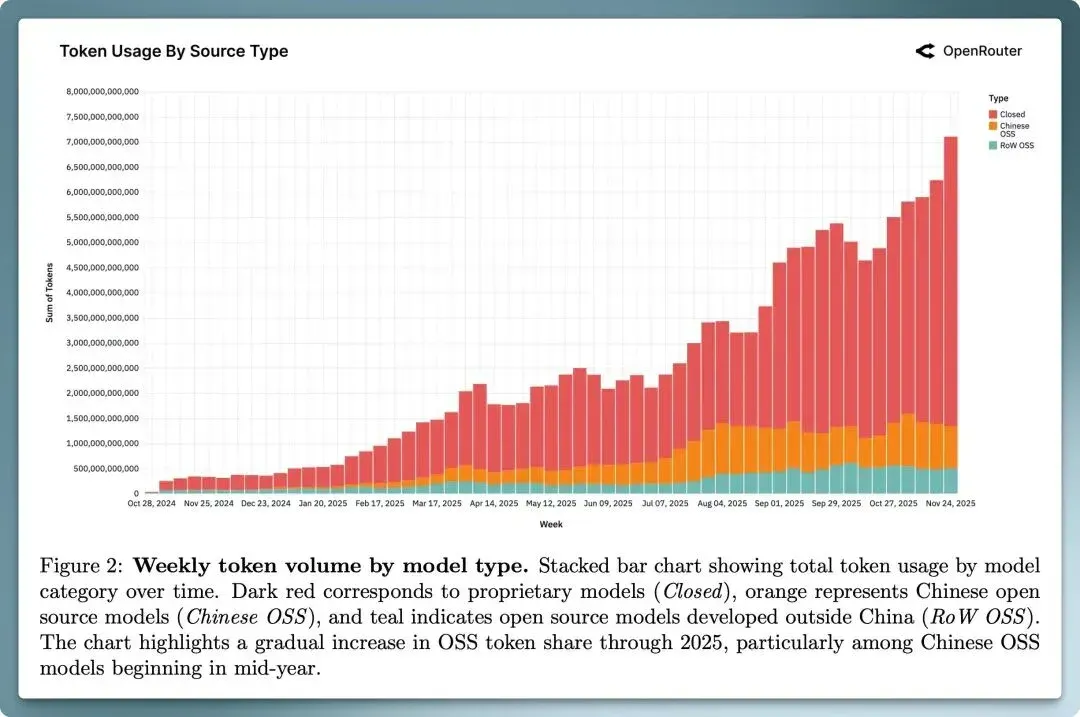
在过去一年,闭源模型占据 70% 左右的 token 消耗量,而开源模型始终保持在 30%左右,其中来自中国的开源模型的迅速发展,从 2024 年底忽略不计的调用量(周份额低至 1.2%),到 2025 年下半年快速发展到13.7%周调用量,在模型发布周的时候(例如 Kimi K2、 Qwen3 Coder 等模型),周调用量甚至达到30%之多!
在年度开源模型 token 消耗量前十名的厂商里,来自中国的厂商占据了半壁江山,分别是DeepSeek(深度求索) 、Qwen(千问)、Minimax、Z-AI(智谱)、MooshotAI(月之暗面),而 DeepSeek 更是以 14.37 万亿年度总消耗量领先所有开源模型。在今年上半年 DeepSeek 更是占据了绝大部分 token 消耗量。
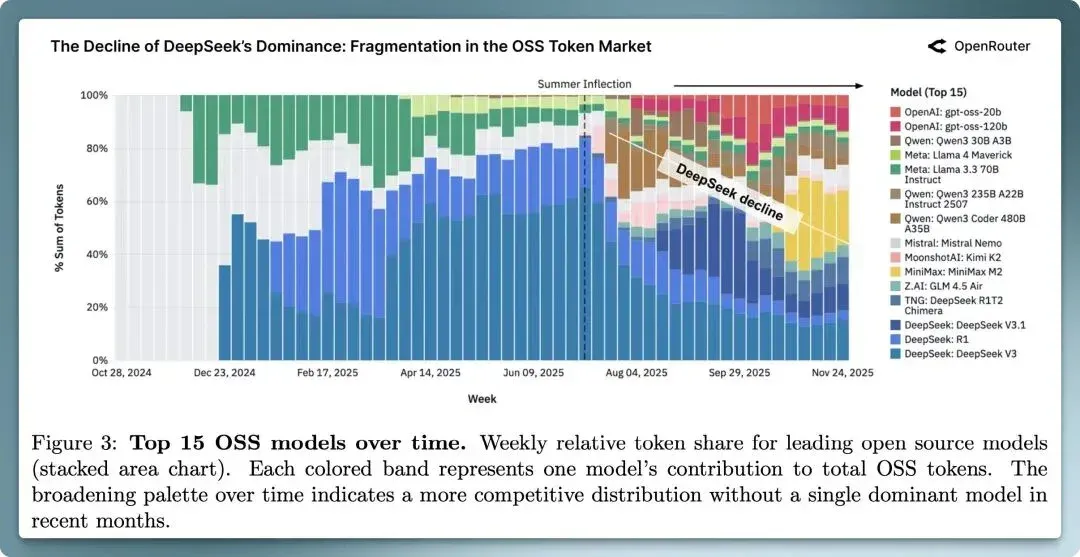
△ 图 3 开源模型规模与使用情况。小型、中型和大型模型在每周开源总token使用量中的占比。
但值得关注的是,随着 GLM 4.5、Kimi K2 、MiniMax M2 等模型加入竞争,到了 2025 年年末,没有哪个模型的 token 消耗量超过 25%,这预示着开源模型若停滞不前,往往会被快速迭代或针对特定领域微调的模型取代。
2025 是 Agent 元年
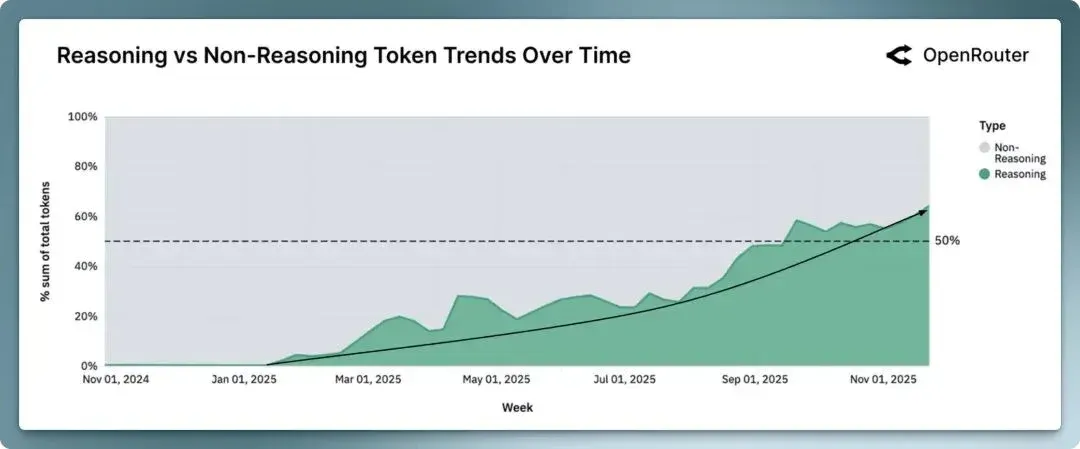
模型不再只是用来生成文本,而是被用于规划、工具调用或在更长的上下文中进行交互来采取行动。目前推理模型的 token 消耗占到了所有 token 消耗的一半以上,随着 GPT-5、Claude 4.5 和 Gemini 3 等更高能力模型的发布,扩展了用户对逐步推理所能达到的预期,用户也越来越偏好能够管理任务状态、遵循多步骤逻辑并支持代理式工作流的模型,而不仅仅是生成文本。
伴随着各种 Agent 的发展,模型工具调用的频率在持续增高,从年初的几乎不计,到年底快速增长至 15%。
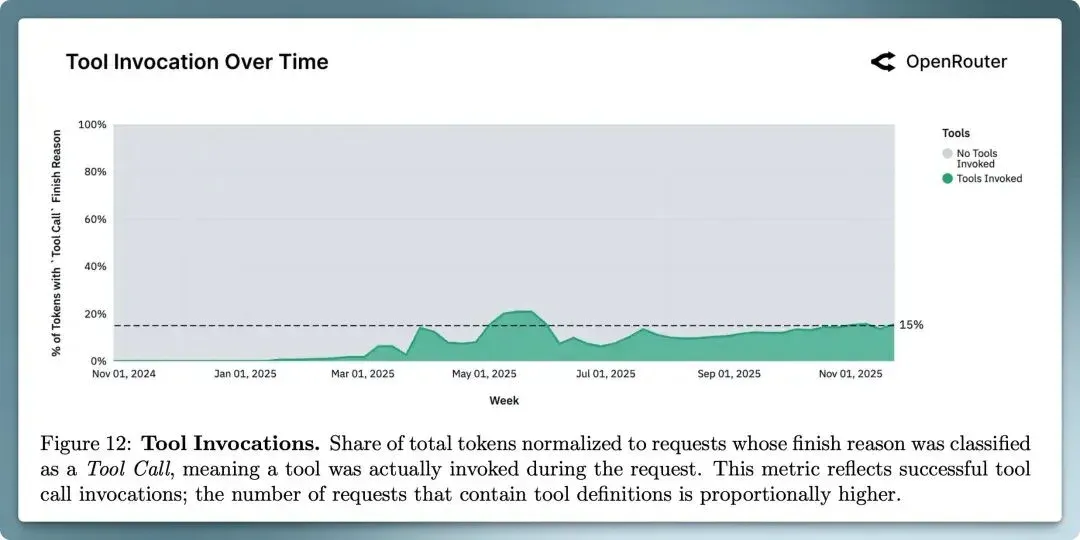
△ 图 12 工具调用
用户的提示词越来越长。相比 2024 年,提示词的 token 数量增长到了 4 倍以上。如今的用户请求不再是开放式的生成(如“给我写一篇文章”),而是对用户提供的庞大材料(代码库、文档、笔记、长对话等)进行推理,并产出精炼、高价值的洞见。模型越来越像分析引擎,而非创意生成器。尤其涉及代码理解、调试与生成的请求通常超过 20K 输入 token,而所有其他类别任务的请求始终保持相对平稳且体量较小的 token 输入。
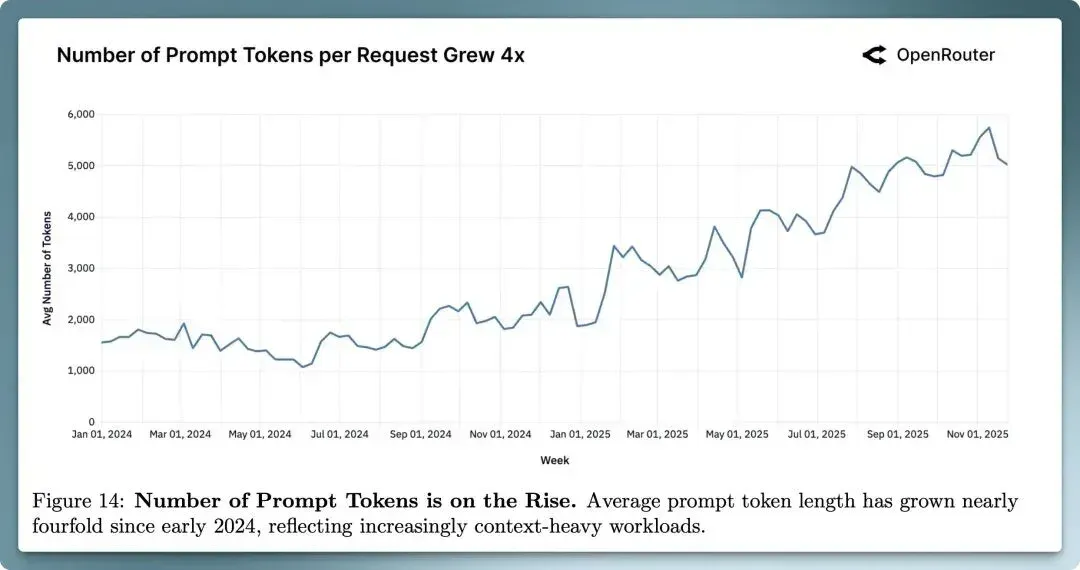
△ 图 14 提示词Token数量正在上升。平均提示词长度自2024年初以来增长了近四倍。
用户于模型对话长度更长,编程任务的对话长度显著长于其他任务。
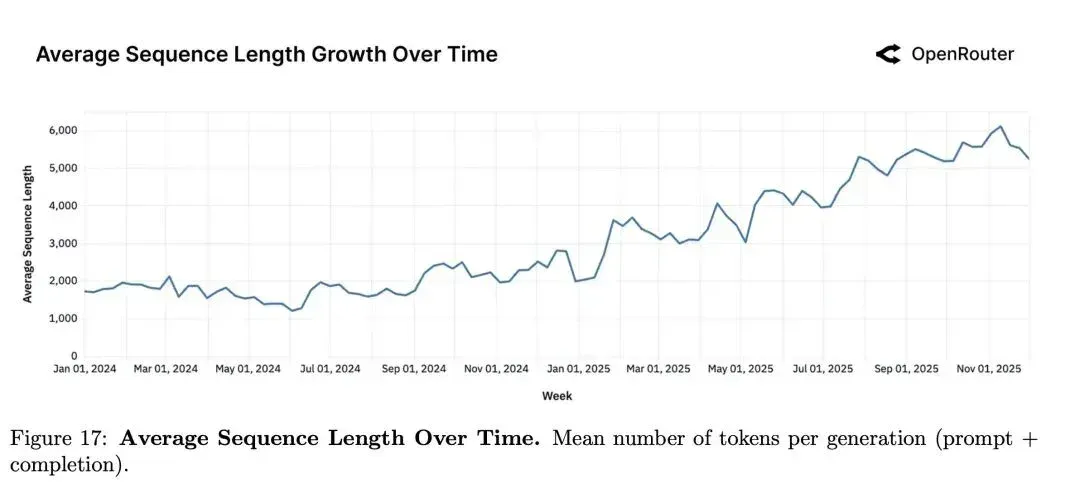
△ 图 17 每次生成平均 token 数(提示+补全)
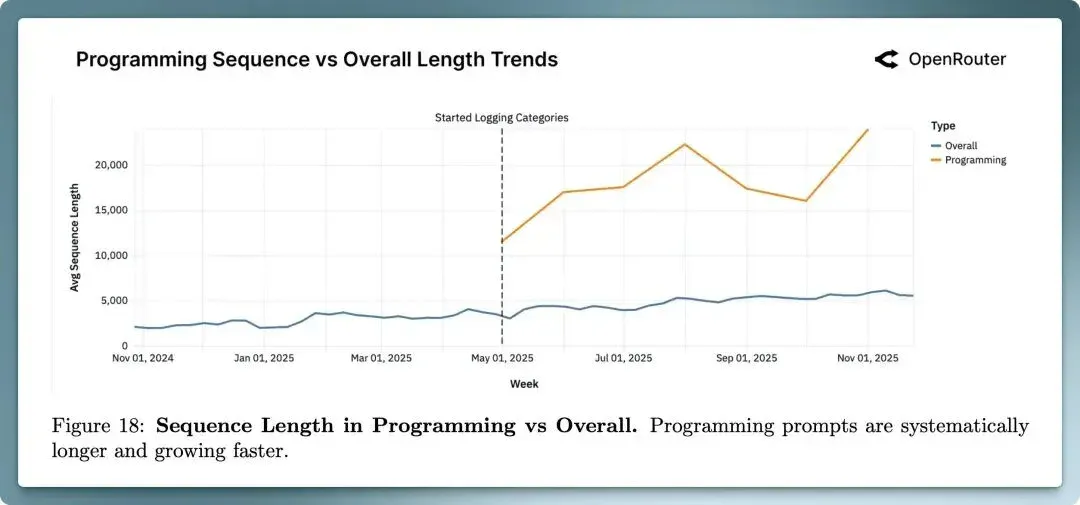
△ 图 18 编程中的对话长度与整体相比。编程提示词更长且增长更快。
综合上面的趋势(推理占比上升、工具使用范围扩大、提示词变得更长更复杂、对话长度提升等)表明,大语言模型的使用重心已发生转移。如今,典型的大模型请求不再是一个简单的问题或孤立的指令,而是结构化、多次模型交互的一部分:调用外部工具、对状态进行推理,并在更长的上下文中持续存在。
这意味着我们从人驱动 AI 慢慢过度到,「AI 自我推理自我执行任务」的阶段,AI 可以自己拆解任务、调用工具、迭代验证结果。
大家都用大模型来干什么?编程独占鳌头
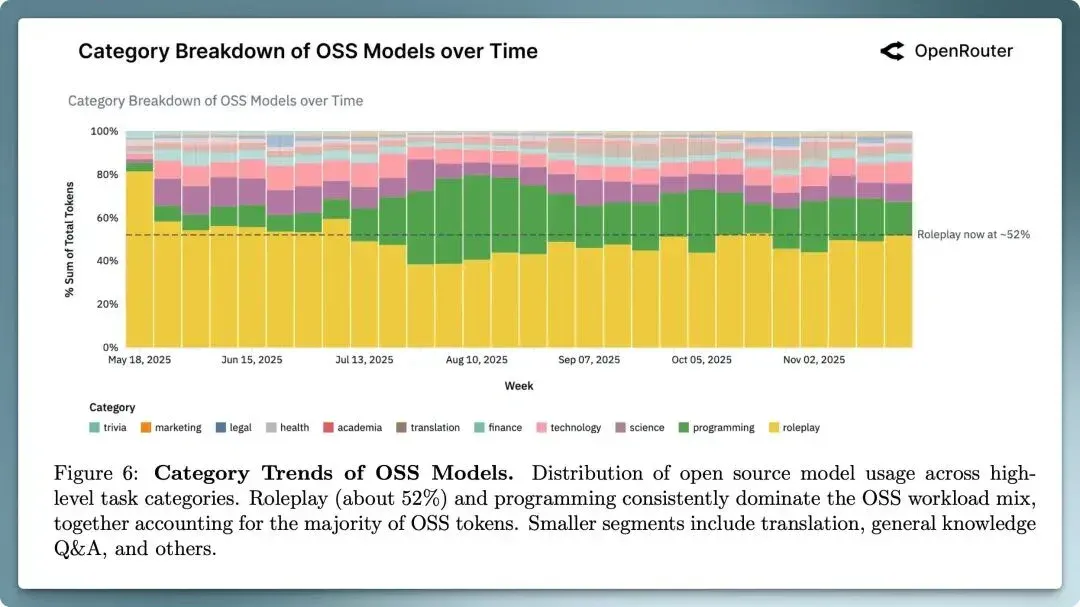
总体而言,编程任务消耗了大部分的 token,其中 Anthropic 家族模型占用 60% 左右编程任务 token 消耗量。这也跟我身边的观察非常一致,大部分程序员喜欢用 Claude 家族模型辅助编程。
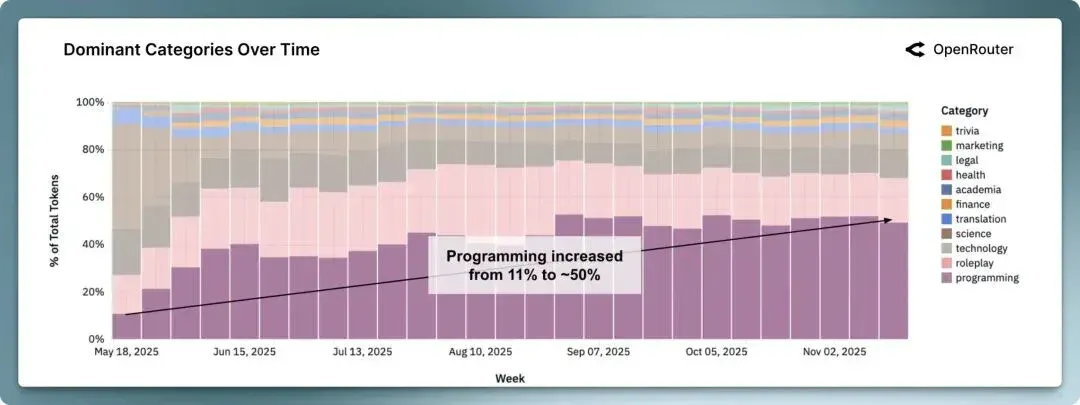
△ 图 19 编程任务的占比在不断提升。所有被归类为编程的 LLM 查询的占比持续上升,反映出 AI 辅助开发工作流的兴起。
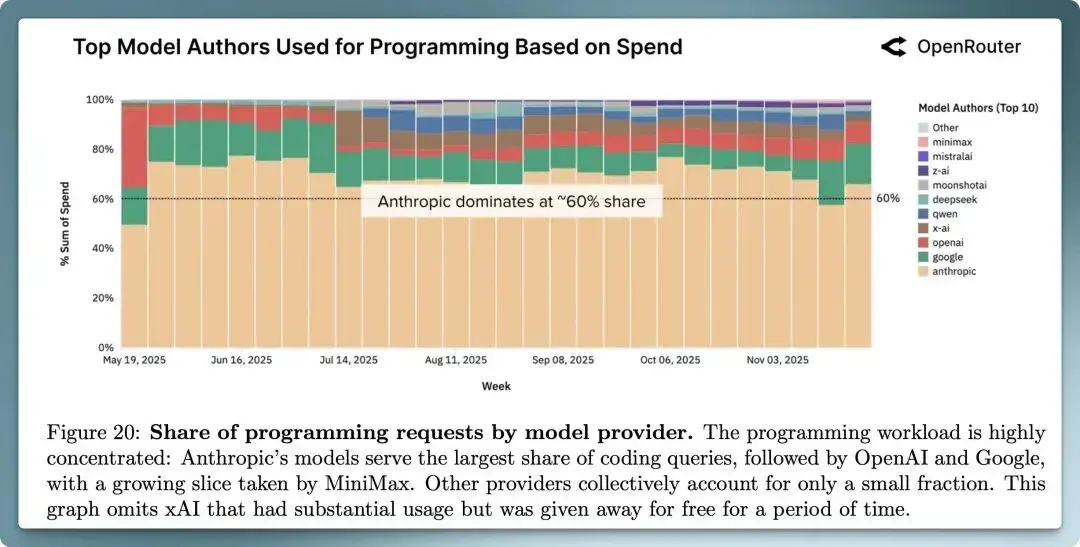
△ 图 20 各模型提供商的编程请求占比。Anthropic 的模型占据最大份额。
很有意思的是「角色扮演」任务也占据了不小的比例(见图 19),在所有任务中排在了第二位,用户尤其是喜欢使用开源模型进行创意类的互动对话(如讲故事、角色扮演和游戏场景等),原因是开源模型有更少的内容限制,这对一些互动类游戏应用、角色扮演类应用尤为重要。
用户留存率的「灰姑娘效应」
所谓的「灰姑娘效应」是指:当用户发现某个模型非常契合自己的工作流,他就会一直使用该模型,就像灰姑娘的高跟鞋,只有灰姑娘最合脚。报告中还发现以下几个现象:
- 先发优势:当一个 AI 模型率先解决某个重要问题时,就获得了巨大的先发优势,早期用户会把这个模型深度整合到自己的工作流程、技术系统和日常使用习惯中,一旦用习惯了,用户就不想换了,因为转换成本太高了。这样就形成了一个稳定的局面:即使后来出现更好的替代品,老用户还是愿意继续用原来的模型
- 留存率体现模型是否有突破性进步:当一个 AI 模型能在早期用户中保持长期使用,说明这个模型在某些任务上实现了重大突破。如果没有这种持续使用现象,说明各家模型水平差不多,没有本质区别
- 抓住用户的"黄金窗口"很短暂:AI 竞争很激烈,每个模型只有很短的时间来吸引核心用户,随着其他模型快速追赶,新模型吸引忠实用户的机会越来越小。
成本与使用量的关系
模型的成本是影响用户行为的关键因素,翻译这种简单的任务用户倾向是使用价格便宜的模型,而编程这种消耗量大对模型性能又有一定要求的任务,用户会选择价格适中的模型。
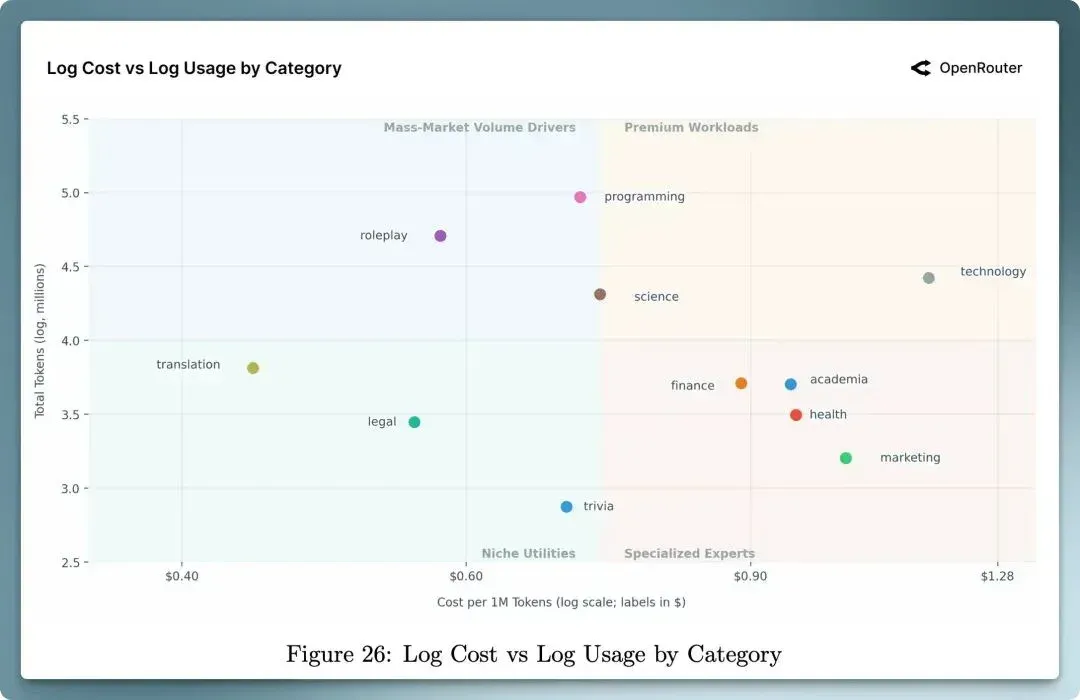
△ 图 26 成本和用量根据任务分类
同时报告发现,用户更在乎模型的效果而不是价格,并不会因为某款模型的调用价格更便宜
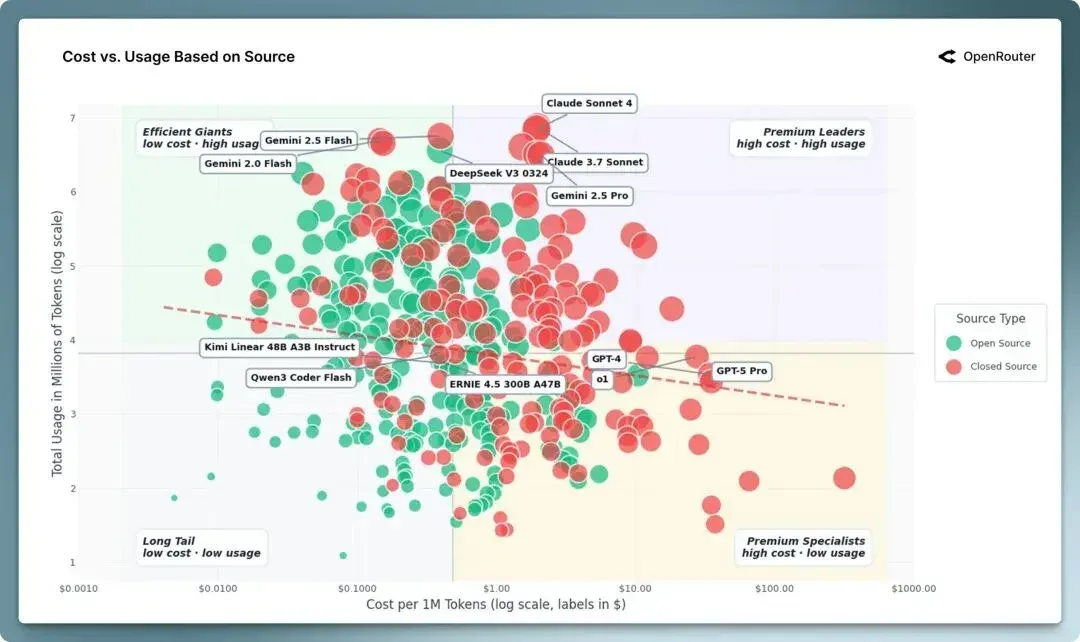
△ 图 26 闭源模型集中在高成本、高使用象限,而开源模型则主导低成本、高高使用区域。虚线趋势线几乎平坦,显示成本与总使用量之间相关性有限。
这揭示了AI 模型定价新逻辑:便宜不是王道,适配才是关键!
开源模型几乎免费调用,为什么开发者却不愿意深度集成?答案很简单:找不到合适的用例。
就像谷歌推出的 Gemini 系列,Flash 主打"快而省",Pro 专注"强而精"——这种分层策略正在重塑 AI 市场。厂商们不再纠结于"每个 token 多少钱",而是转向更聪明的思考:"每次成功任务要花多少钱"?
市场正在分层:
- 轻量级任务?选择便宜快速的模型
- 核心业务场景?投入更强大的模型
- 对延迟敏感?优先考虑速度优化
生产环境的真相:企业更愿意选择"快而准"的专用模型,而不是"便宜但不稳定"的通用模型。当任务结果的质量比省几毛钱更重要时,可靠性和适配度就成了决胜因素。
这告诉我们:AI 模型远未成为"大路货"。用户愿意为更好的体验、更强的能力、更稳定的服务买单。差异化价值依然存在,而且比以往任何时候都更重要。
总结
🔄 没有永远的王者,开源闭源平分天下AI 江湖群雄并起,没有一家独大。对开发者来说,别把鸡蛋放一个篮子——要灵活搭配多种模型,为不同任务选择最优解。对模型厂商而言,警惕来自角落的挑战,社区模型随时可能抢走你的地盘,除非你持续创新。
🎭 超一半用户用 AI"聊天",不是"干活"颠覆认知!超过一半的开源模型使用者,竟然是在角色扮演和讲故事。早期 ChatGPT 用户也是先玩后用,从娱乐逐渐转向生产力。这打破了"AI 主要是生产力工具"的假设——很多人要的是陪伴和探索,不是效率。
🤖 AI 进化:从"一问一答"到"多步推理"AI 不再是简单的问答机器,而是智能化的执行者。它会规划、推理、调用工具、访问数据,通过多轮迭代完成任务。评估标准也在转变:从"话说得好不好"到"事情办得怎么样"。下一个战场:谁能持续高效地推理,谁就赢得未来。
💰 市场未"白菜化",质量仍为王道AI 远未成为廉价商品。用户在成本与质量、可靠性之间做权衡。闭源模型主导高价值业务,开源模型称霸低成本场景——价格战打不赢,价值战才是关键。
👟 留存才是护城河,找到"水晶鞋"就赢了基础模型飞跃式进步,用户留存成为真正的护城河。每次技术突破都是短暂的机遇窗口,找到完美契合高价值场景的"水晶鞋",用户就会深度绑定。
对创业者和投资者来说,别只盯着增长曲线,要看留存曲线。那些即使模型更新也坚守的核心用户,才是真正的财富。在这个瞬息万变的市场,谁先抓住未满足的关键需求,谁就能在下一波技术浪潮中存活。
👨💻 个人观点
相比 2024 年,我最大的感受是开源大模型能力的井喷,从年初 DeepSeek 一炮而红,到今年下半年,KIMI K2、MiniMax M2、gpt-oss-120b 等模型陆续推出,开源模型凭借跟顶级闭源模型相近的能力、更低的调用成本、更开放的生态俘获了不少用户的芳心,中国厂商在开源大模型领域更是遥遥领先,放两年前这肯定是不敢想象的。
2025 年也是 AI Agent 元年,标志着人工智能从单纯的工具向自主智能体的重大转变。在 AI Agent 的落地实践中,编程任务作为一个关键应用场景,已取得显著的成效表现(从上面报告 token 消耗量也能看得出),我在这一年也用了非常多的 Coding Agent 产品:Cusror、Windsurf、Claude Code、Codex,也切身体会到了 Agent 的强大,改变了我日常编程的流程和范式。2026年AI Agent 也会在其他领域大放异彩。
文章来自于“DeBill独立开发”,作者 “DeBill”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚刚,Claude破纪录!日烧3万亿Token,神秘Fable 5.5压轴登场 (opens in a new tab)
OpenRouter数据显示,Anthropic的Claude 5.5家族日调用量创下2.95万亿Token纪录,Fable 5.5则被曝已向摩根大通、Meta等企业客户灰度部署。
深度|OpenRouter创始人收购后首次发声:专用AI打败“上帝模型”的时代要来了 (opens in a new tab)
Stripe收购OpenRouter后,创始人Alex Atallah首次亮相a16z播客,并与Replit创始人Amjad Masad主张,专用AI可凭专业化、神经多样性、成本与安全优势打败通用“上帝模型”,未来应是人类做通才、机器走向高度专业化。
AI 圈杀出新顶流,神秘「太空兔」能用涂鸦做网站 (opens in a new tab)
匿名AI模型Space Bunny Alpha(太空兔)近期凭借草图转网页、长上下文与Agent编程能力在OpenRouter和OpenCode平台刷屏并冲上日调用量第一,其分词特征与MiniMax M3.1系列高度吻合但尚无厂商官方认领。
神秘模型 Union Alpha 突袭!上线首日跑掉20亿Token,部分网友实测称性能直逼 Astra (opens in a new tab)
继“牛来”Ox Alpha 之后,OpenRouter 昨晚上又出现了一款身份不明的模型。
神秘新模型“Ox Alpha”突袭 OpenRouter,性能超过 Fable 5?全网盲猜智谱或小米 (opens in a new tab)
今天上午,OpenRouter 没有举行发布会,也没有公布技术报告,只用一个忍者表情放出了一款代号为“Ox Alpha”的神秘模型。“Ox”在英文中正有“牛”的意思,于是,一场属于 AI 行业的“牛来”也开始了。