里程碑时刻!首个100B扩散语言模型来了,技术报告揭秘背后细节
前段时间,我们在 HuggingFace 页面发现了两个新模型:LLaDA2.0-mini 和 LLaDA2.0-flash。它们来自蚂蚁集团与人大、浙大、西湖大学组成的联合团队,都采用了 MoE 架构。前者总参数量为 16B,后者总参数量则高达 100B—— 在「扩散语言模型」这个领域,这是从未见过的规模。
万万没想到,年初还是个小众方向的「扩散语言模型(dLLM)」,现在已经被扩展到千亿参数的规模了。
前段时间,我们在 HuggingFace 页面发现了两个新模型:LLaDA2.0-mini 和 LLaDA2.0-flash。它们来自蚂蚁集团与人大、浙大、西湖大学组成的联合团队,都采用了 MoE 架构。前者总参数量为 16B,后者总参数量则高达 100B——在「扩散语言模型」这个领域,这是从未见过的规模。
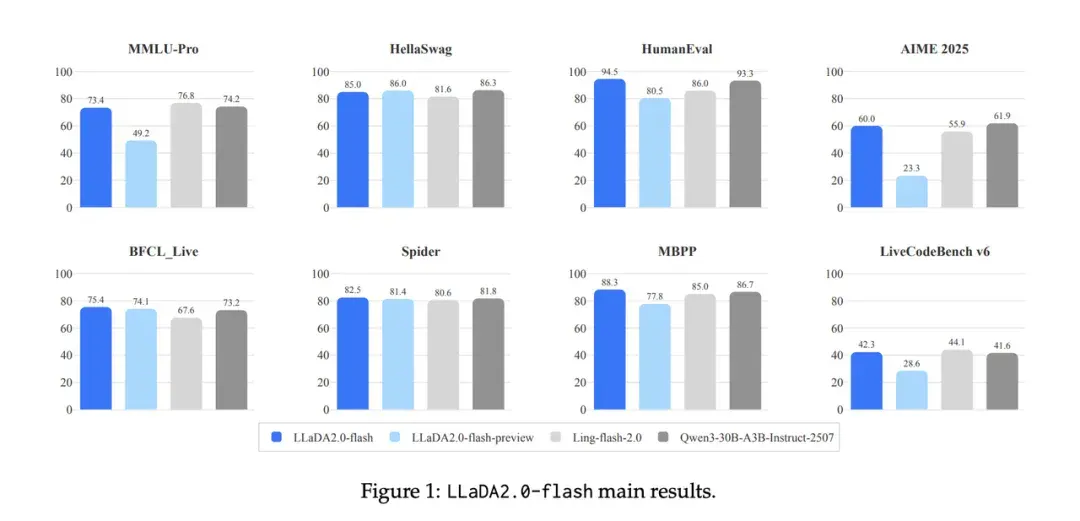
更令人欣慰的是,模型变大了,也确实变强了:在涵盖知识、推理、编码、数学、智能体与对齐几大维度的 47 个基准测试中,LLaDA2.0-flash 平均得分 73.18,与强 AR(自回归)模型 Qwen3-30B-A3B-Instruct-2507(73.60)持平,在编码(如 HumanEval、MBPP)、智能体(BFCL)等复杂任务上优势显著。
长期以来,自回归生成范式在大模型领域始终占据主导地位,这种从前到后依次生成下一个 token 的方法曾被寄予厚望。然而,其固有弊端也逐渐显现:长文本生成的计算成本较高、推理速度较慢,且难以捕捉 token 之间的双向依赖关系。一旦前期生成的内容出现错误,不仅无法直接修正,后续输出也会受到干扰,最终导致误差累积。
dLLM 的成功扩展让人们看到了另一条路的可行性。更值得注意的是,这类模型的快速演进并不是沿着单一路线不断推高规模,而是来自研究者们「多线并进」的探索。
就在今年 9 月,LLaDA 系列模型的研究者刚刚验证了 MoE 架构下从头训练 dLLM 的可行性,推出了 7B 的LLaDA-MoE(在新窗口打开),这为扩散范式提供了新的实现方式。而仅仅三个月后,团队又在另一条路线 ——从成熟的 AR 模型平滑迁移到扩散框架—— 上取得突破,直接将模型规模扩展到了 100B。
LLaDA2.0 生成效果演示。可以看到,模型会在多个位置并行生成,而且已生成内容可以修改。
这背后涉及哪些关键的技术选择?哪些方法在 dLLM 中能 work?在最近发布的技术报告中,LLaDA2.0 幕后团队披露了很多细节。
- 报告标题:LLaDA2.0: Scaling Up Diffusion Language Models to 100B
- 报告链接:https://github.com/inclusionAI/LLaDA2.0/blob/main/tech_report.pdf
- HuggingFace 链接:https://hf.co/collections/inclusionAI/llada-20
将 dLLM 扩展到 100B
—— 一个公认的难题
最近,有研究发现,在数据不够多的情况下,dLLM 会越训越强,最后反超传统自回归模型。训练得越久,优势越明显。如果数据更丰富或质量更高,这个「反超」会来得更晚;如果模型更大,反超会来得更早。
这些证据的出现让「训练 dLLM」这件事变得越来越有吸引力。但是,怎么把 dLLM「做大做强」却是一个公认的难题。在过去的一两年间,研究者们已经尝试了不少方法。
首先是从头开始训练。此前的 LLaDA、LLaDA-MoE 都是这一方向的成功尝试,证明了从头训练的 dLLM 性能可以接近同尺寸的 AR 模型,并且在加入 MoE 后,dLLM 还能更高效、更强。不过,受限于可用数据量、基础设施成熟度、计算成本、训练周期等因素,从头训练的 dLLM 通常规模较小(≤8B),在整体性能上仍落后于最先进的 AR 模型。
其次是从已经训练好的 AR 模型出发,让 dLLM 继承其知识与能力,从而减少训练成本并缩小性能差距。这一方向已经出现了多个代表性工作,包括 DiffusionLLaMA、Dream-7B、RND1、Block DLM 等。它们通过掩码退火、block diffusion 等方法,将 AR 模型预训练好的语言能力「挪」到扩散结构中。但这类尝试也没有突破 30B 的规模。再加上 block diffusion 本身的训练效率不高,很难把这种方法直接扩展到大规模模型的海量语料训练中。
最后是后训练阶段的努力。微调方面,已有工作证明 dLLM 经过 SFT 后可以在代码生成、复杂规划等任务上媲美顶级 AR 模型。强化学习方面,由于 dLLM 的对数似然难以计算,研究者不得不另辟蹊径设计新算法,甚至训出了首个具备长链思维推理能力的 dLLM。推理加速方面,通过动态剪枝或混合 AR - 扩散范式,dLLM 的推理速度已首次超越同规模 AR 模型。但总体而言,后训练研究仍处于起步阶段,这些技术如何协同、如何扩展到千亿参数规模,都还是开放问题。
LLaDA2.0 模型的出现,给这些问题提供了一个解决思路。
千亿级扩散模型的稳定训练
LLaDA2.0 给出了更优解
和之前的 LLaDA-MoE 等模型不同,LLaDA2.0 没有选择从头训练 dLLM,而是把已有的 AR 模型「平滑地」转化成扩散模型,并在这个基础上做大规模训练与对齐。
为了完成这种转化,LLaDA2.0 提出了一套系统性的解决方案。从训练范式的重构、预训练与后训练流程的强化协同,到训练与推理基础设施的适配与优化,给出了区别于以往方法的独特实现路径。
整体来讲,LLaDA2.0 通过构建一个分段式、可扩展的训练体系,高效完成了从 AR 模型转化为 dLLM 的目标。
如下图 2 所示,首先通过持续预训练(CPT)将一个 AR 基座模型重建为掩码扩散语言模型(MDLM),并使其能够学习双向去噪能力,从而在保持原 AR 模型表征几何结构的前提下平滑过渡到扩散范式。
接下来,在已训练的 MDLM 基础上引入了块扩散预训练(Block Diffusion Pre-training)。此时,模型不再针对单个 token,而是训练其对连续文本片段(即块)的去噪。从 token 到块的转变,显著增强了生成的长程一致性,并带来更高的计算效率。
最后,在兼具 token 与块两级 AR 生成能力之后,模型通过后训练(包括 SFT 与 DPO)具备了更强的人类意图与指令遵从特性,并更能满足下游任务的需求。经过这一阶段,扩散预训练过程中获得的强大生成能力可以高效地转化为实际任务中的性能表现。
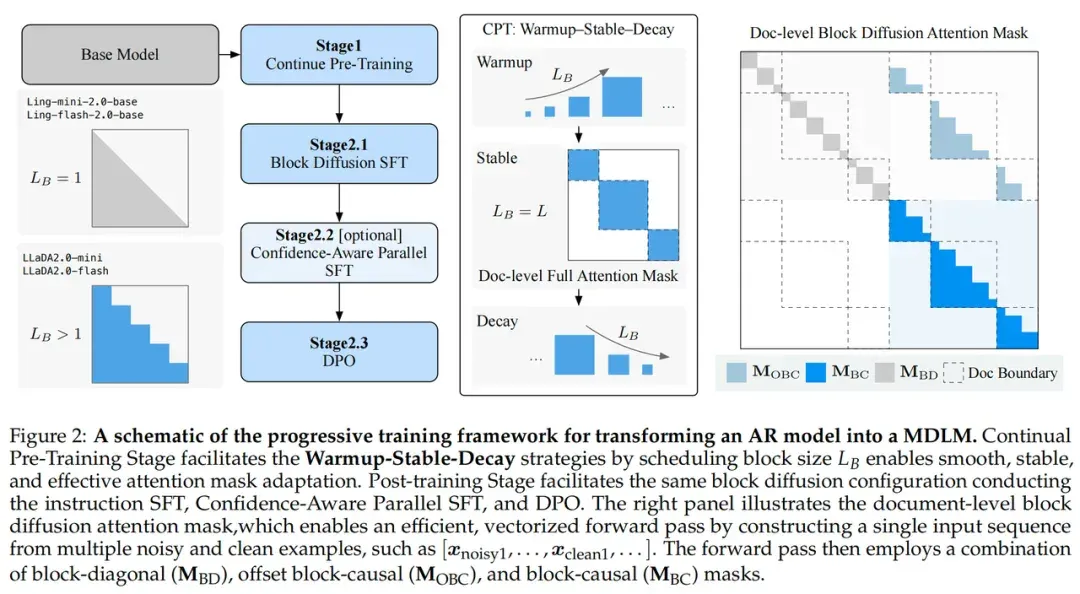
LLaDA2.0 训练流程图。
接下来,我们将逐一剖析这些关键环节。
持续预训练
由于 AR 模型的因果建模方式与 dLLM 的双向去噪机制存在天然差异,前者到后者的转化并不是简单替换训练目标就能完成。为此,LLaDA2.0 采取了Warmup–Stable–Decay(WSD)的持续预训练策略。
其中在Warmup(热身)阶段,团队将 Ling-mini-2.0(16B)等 AR 基座模型视为块大小 = 1 的块扩散语言模型(BDLM)起点,并按照「1→4→32 → 64 → 4096」逐步增加块大小。块大小的每次调整在中等规模数据上进行训练,以确保模型平稳过渡。在块大小达到最大 4096 时,BDLM 转化为标准的掩码扩散语言模型(MDLM),完成从因果生成向全局双向去噪的结构性迁移。
接下来是Stable(稳定)阶段。在块大小固定为 4096 且模型转化为全局双向去噪范式之后,在大规模语料上进行 MDLM 训练,以掌握扩散式生成与双向上下文建模能力。
完成 MDLM 训练之后,进入到Decay(衰减)阶段。团队逐步将块大小从 4096 减少到更适合推理的尺寸(如 32),从而转换回高效的 BDLM。这样一来,模型在 MDLM 阶段学到的全局上下文知识被蒸馏回更紧凑的块级结构中,让扩散式的双向语义能力与块级生成的推理效率二者兼得。
此外,由于训练过程中会将多个文档拼接成长序列,这会在语义无关的文本之间造成长程依赖。为此,团队引入了文档级注意力掩码(Document-level Attention Mask),可以避免这种跨文档干扰,防止语义污染,并确保双向建模稳定性。
为了进一步增强 BDLM 的泛化性和稳健性,团队又采用了Top-k 检查点融合策略。在预训练结束后,根据困惑度等验证指标选取表现最优的 k 个模型检查点,并对它们的权重、偏置等参数进行算数平均,得到了更稳健的 BDLM 初始化。
一整套流程走下来,LLaDA2.0 为行业内千亿规模的扩散模型训练提供了可借鉴的稳定解决方案。
后训练
在完成从 AR 到 dLLM 范式的持续预训练之后,LLaDA2.0 还进行了系统化的后训练,主要包括以下三个核心环节。
一是 SFT(监督微调):在预训练阶段完成之后,通过 SFT 来对齐用户指令。过程中引入多项关键改进:对序列长度进行块对齐,确保与块级注意力结构兼容;利用「Mask ratio bandwidth」避免近乎无噪声和过度噪声样本造成的训练无效与梯度不稳定;利用「Complementary Masking」,保证同一序列的所有 token 在一个训练 batch 中至少被学习一次,大幅提升样本利用率与收敛速度;通过覆盖推理、通用与工业三类数据,确保模型能力分布均衡而不偏科。
二是 CAP(置信度感知并行训练):通过在训练中添加额外置信度损失,CAP 为正确预测的 token 引入了熵最小化目标,提升模型预测置信度,并实现更快并行解码,生成质量与推理速度之间取得了良好权衡。
三是 DPO(直接偏好对齐):使模型更好地对齐人类偏好。团队构建了涵盖通用、数学、指令遵循等多个领域的偏好数据集,共包含 150 万对偏好样本。另外将重构损失的证据下界(Evidence Lower Bound,ELBO)作为对数似然替代,构建出适配扩散模型的 DPO 框架。
通过三项后训练技术的协同,LLaDA2.0 在能力塑造、推理效率提升与人类偏好对齐之间形成了完善的优化体系,使其从通用的扩散式生成模型进一步迈向高性能实用型大模型。
训练与推理基础设施
为了进一步解决训练稳定性、大规模可扩展性和推理效率问题,LLaDA2.0 分别在预训练、后训练与推理阶段进行了针对性的工程优化与机制设计。
在预训练阶段,团队将 Megatron-LM 用作训练后端,并结合数据并行(DP)、流水线并行(PP)、张量并行(TP)、上下文并行(CP)与专家并行(EP)的多并行策略,使得千亿级模型在长序列与复杂注意力结构下仍能保持高吞吐与强扩展性。
此外,团队通过引入基于 cuDNN 的注意力实现,为任意块扩散训练带来显著加速。在训练 LLaDA2.0-mini 时,相较于 TransformerEngine 中未融合的注意力实现,这一做法实现了 1.3 倍 + 的端到端加速,以及 90%+ 的注意力层显存节省。团队还通过在「masked token embedding」输出中添加独立高斯噪声,解决了扩散训练初期的数值不稳定问题。
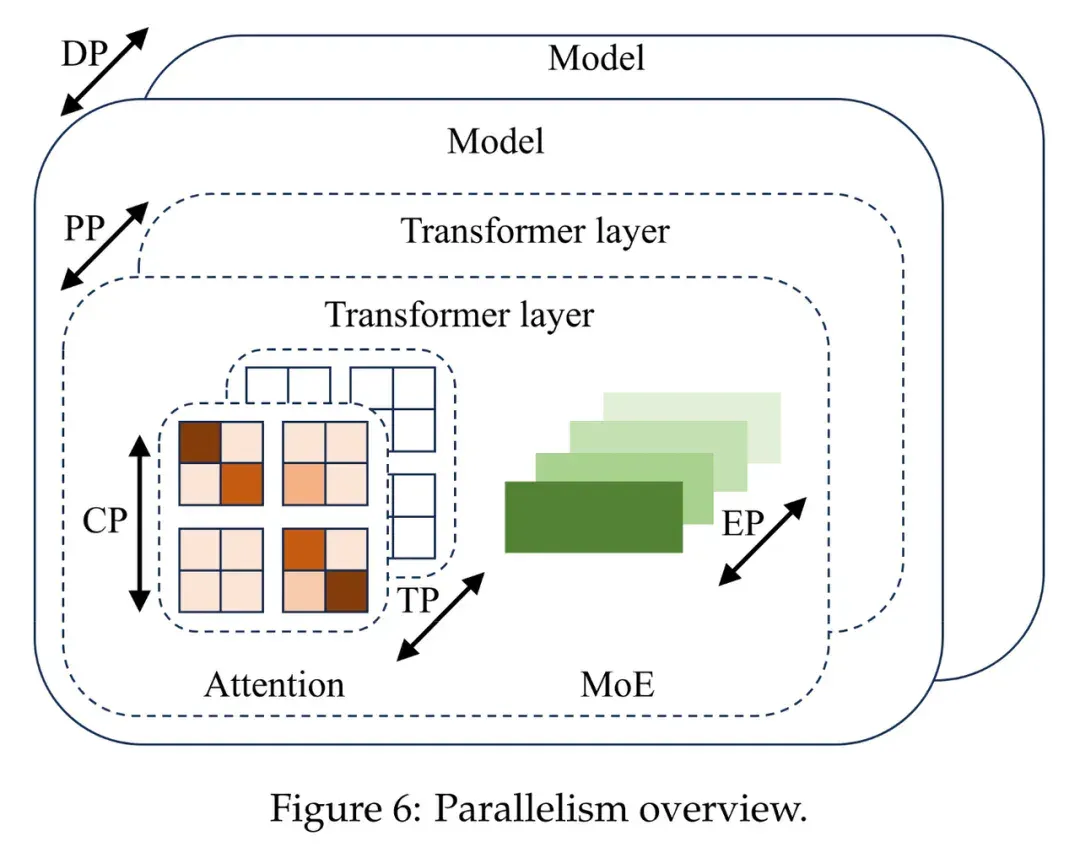
预训练阶段的多并行策略
在后训练阶段,团队通过专为 dLLM 提供高效训练范式的开源库 dFactory 实现了复杂的并行化策略。同时采用「数据打包」策略,将多个短序列拼接在一起,提升数据吞吐与硬件利用率。
在推理阶段,团队对原为 dLLM 推理框架的 dInfer 进行改造,使其能够支持块扩散推理,并在能力实现上更接近 AR 模型。关键优化包括有效复用 KV-cache,大幅降低 prefill 开销;另外,在 SGLang 中加入块扩散支持,使得 dLLM 也能享受 AR 模型的成熟推理优化生态。
下图 3 的结果显示,在 HumanEval、MBPP、GSM8K、CRUXEval 等基准测试中,LLaDA2.0-flash-CAP 达到了 535 TPS(Token/s),相较于基线 AR 模型(Ling-flash-2.0 与 Qwen3-30B-A3B-Inst-2507)实现最高 2.1 倍推理加速。
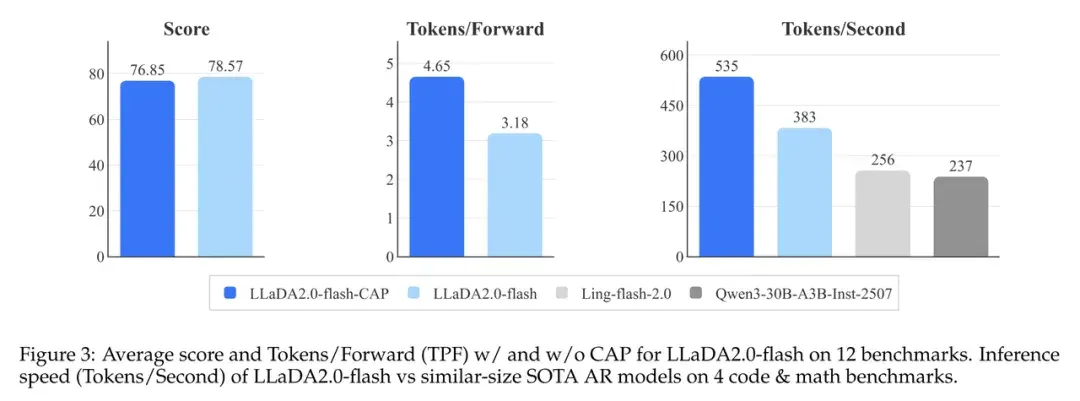
通过大规模训练、稳定性保障、分布式并行、高效推理框架的适配等多个工程环节的全面优化,LLaDA2.0 有望成为扩散模型实现真正工业级可用的关键转折点。
性能比肩 AR
dLLM 的路走通了?
说了这么多,LLaDA2.0 到底表现如何?
整体来看,该系列模型不仅具备竞争力,而且在一些关键领域展现出接近甚至超越 AR 模型的趋势。
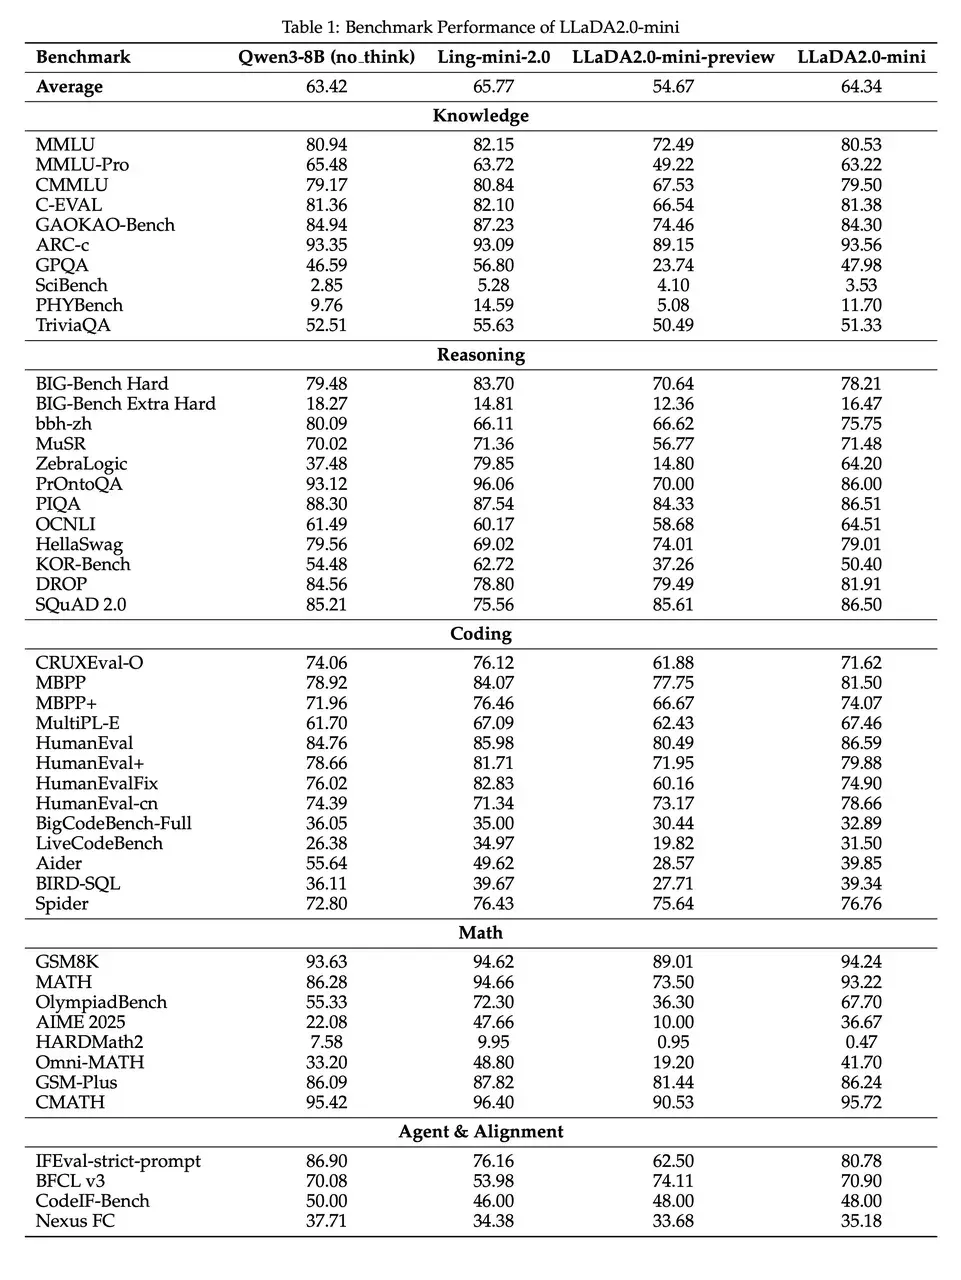
先看 LLaDA2.0-mini。它的综合得分为 64.34,接近同级别 AR 模型 Ling-mini-2.0 的 65.77,证明了扩散路线的基本可行性。值得一提的是,它在一些复杂任务上已经超过了直接对标的 Qwen3-8B,比如 SQuAD 2.0 阅读理解(86.50)、代码生成 HumanEval(86.59)。
再看更大的 LLaDA2.0-flash。它的综合得分为 73.18,与 Qwen3-30B-A3B-Instruct-2507(73.60)基本持平。而在编码任务上,它开始展现出更明显的优势:HumanEval 94.51、MBPP 88.29、MultiPL-E 74.87,均高于 AR 对手。这一趋势也延伸到了 Agent 能力(BFCL v3: 75.43)上。
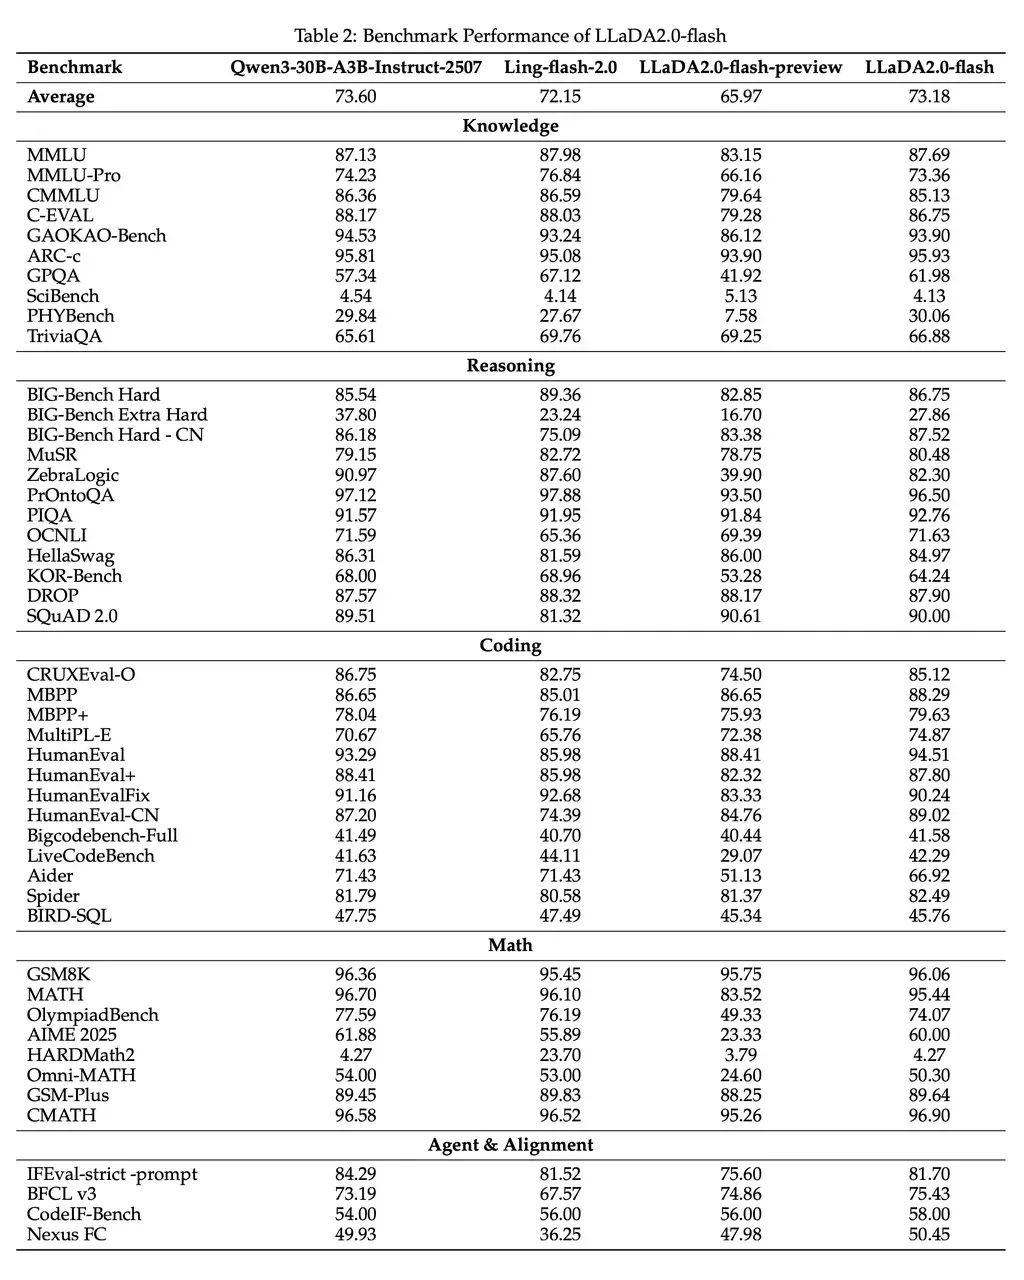
一个值得关注的现象是:随着模型规模增大,扩散架构在结构化生成和工具调用上的优势似乎愈发明显。
LLaDA 2.0 的性能表明,扩散语言模型是一条可扩展且有竞争力的技术路线。它在通用基准上快速缩小了与 AR 模型的差距,同时在代码生成、工具使用等复杂任务上展现出超越的潜力。
100B 之后
dLLM 未来可期
作为业内首个冲刺到 100B 参数规模的 dLLM,LLaDA2.0 系列模型的出现无疑给整个领域注入了一针强心剂。
除了规模本身,LLaDA2.0「将成熟 AR 大模型平滑过渡到扩散框架」的思路同样值得关注。它表明,不同生成范式并非非此即彼的对立关系,而是可以串联、融合、相互继承。这为扩散语言模型的规模化探索提供了一条切实可行的工程路径,打开了一片更广阔的设计空间。
与此同时,越来越多的玩家正在入场,其中不乏马斯克旗下 xAI 这样的科技巨头。
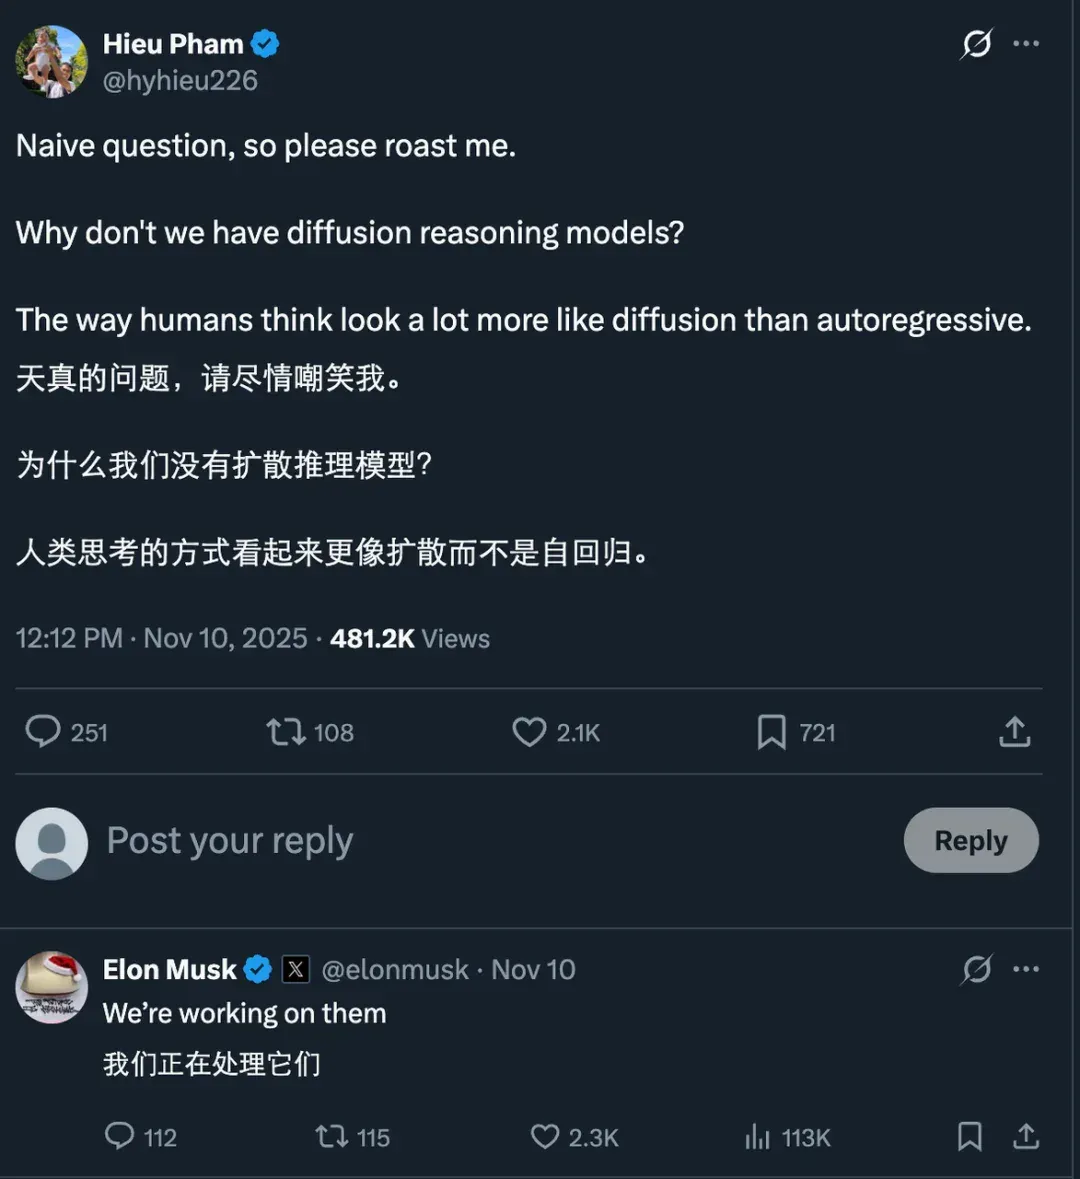
当然,dLLM 距离真正成熟还有很长的路要走。更大的参数规模、更高效的强化学习与推理范式、更快的解码速度…… 每一项都是待攻克的难题。但方向已经明确,剩下的只是时间。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Clover 上手与架构解析:扩散语言模型怎样执行 Agent 任务 (opens in a new tab)
量子位结合交互网页、代码生成和工具调用的上手记录,解释 Clover 的块扩散、历史记忆与连续任务执行方式。文章区分作者体验、团队评测和后续多模态及端侧计划,不将特定任务耗时推广为普遍速度。
Clover-35B-A3B-Preview 开源,扩散语言模型面向 Agent 与端侧部署 (opens in a new tab)
DiffuSpace 发布 Clover 首个预览版本,介绍混合专家架构、块扩散与门控记忆的设计,以及编程、工具调用和量化部署案例。文中评测来自发布团队,决策模型、客户端等后续计划与当前开源内容需分别看待。
比GPT-6 Luna快8倍!扩散LLM跑分也反超了 (opens in a new tab)
GPT-6 Luna 要被扩散 LLM 抢饭碗了?
数亿元!雷军、华为都投了,全球扩散语言模型最大融资诞生 (opens in a new tab)
扩散智能(DiffuSpace)连续完成两轮数亿元人民币融资,创全球扩散语言模型最大规模融资纪录,经纬创投、顺为资本、君联资本联合领投,华为哈勃等跟投。
大模型的逐字生成模式,正在拖慢你的Agent,有人跑出了5倍提速 (opens in a new tab)
扩散智能DiffuSpace与Acrab联合测试显示,扩散语言模型凭借全局并行生成机制可将端侧Agent运行速度提升约5倍,双方计划加速推进其在AI PC、智能汽车等场景落地。