刚刚,千问App把谷歌和OpenAI的「付费绝活」塞进了手机,还免费?
千问 App,大家都用上了吧? 这个被阿里委以重任的 AI 应用,今天迎来了一波史诗级更新:正式接入了阿里最强的两大视觉模型 —— Qwen-Image 和 Wan 2.5。 在 Hugging Face 等开源社区,Qwen-Image 系列模型长期霸榜,被全球开发者玩出了花;而 Wan 2.5 则是业内少有、具备「原生音画同步」能力的视频生成新贵。 但过去,想用上这些 SOTA 模型,你得会跑代码、部署 ComfyUI,或者苦等海外大厂的内测资格。 今天,门槛消失了。 千问 App 将这两大顶流模型深度整合,让普通用户在手机上也能拥有一座「掌上影像工作室」。 我们第一时间实测了这项更新,结
千问 App,大家都用上了吧?
这个被阿里委以重任的 AI 应用,今天迎来了一波史诗级更新:正式接入了阿里最强的两大视觉模型 ——Qwen-Image和Wan 2.5。
在 Hugging Face 等开源社区,Qwen-Image 系列模型长期霸榜,被全球开发者玩出了花;而 Wan 2.5 则是业内少有、具备「原生音画同步」能力的视频生成新贵。
但过去,想用上这些 SOTA 模型,你得会跑代码、部署 ComfyUI,或者苦等海外大厂的内测资格。
今天,门槛消失了。
千问 App 将这两大顶流模型深度整合,让普通用户在手机上也能拥有一座「掌上影像工作室」。
我们第一时间实测了这项更新,结果发现:它不仅「能打」,甚至在某些体验上,比那些收费的「天花板」选手还要香。
Qwen-Image
一句话无痕修图
如果说文生图已经卷到了「红海」,那么精准的图像编辑则是 2025 年各家大模型争夺的真正高地。
在这一领域,谷歌 DeepMind 最近发布的 Nano Banana Pro 凭借强大的逻辑推理能力到处刷屏:它能理解复杂的空间关系,甚至能像设计师一样思考构图。
如果你以为这种「带脑子画画」的能力只存在于谷歌的实验室里,那可就错了。在千问 App 实测 Qwen-Image 后,我们发现国产模型在「视觉逻辑」上的理解力同样毫不逊色。
强大的视觉逻辑理解
过去大部分 AI 绘图模型都是「右脑发达,左脑简单」:画风唯美,但一遇到「在左边的桌子上放立方体」这种逻辑指令,往往就会翻车。
而 Qwen-Image 的核心突破在于,它不仅是在生成像素,更是在理解几何与空间。它能像 Nano Banana Pro 一样,识别画面中的线条、透视和物体关系,并在原有基础上进行符合物理规律的修改。
比如说,图像编辑模型的老大难问题:家居摆放。
根据我们以前的经验,很多模型在房间这类三维空间的场景下表现都不尽如人意,不是搞错物体尺寸,就是搞错透视关系。
我们用 Qwen-Image 试一试:
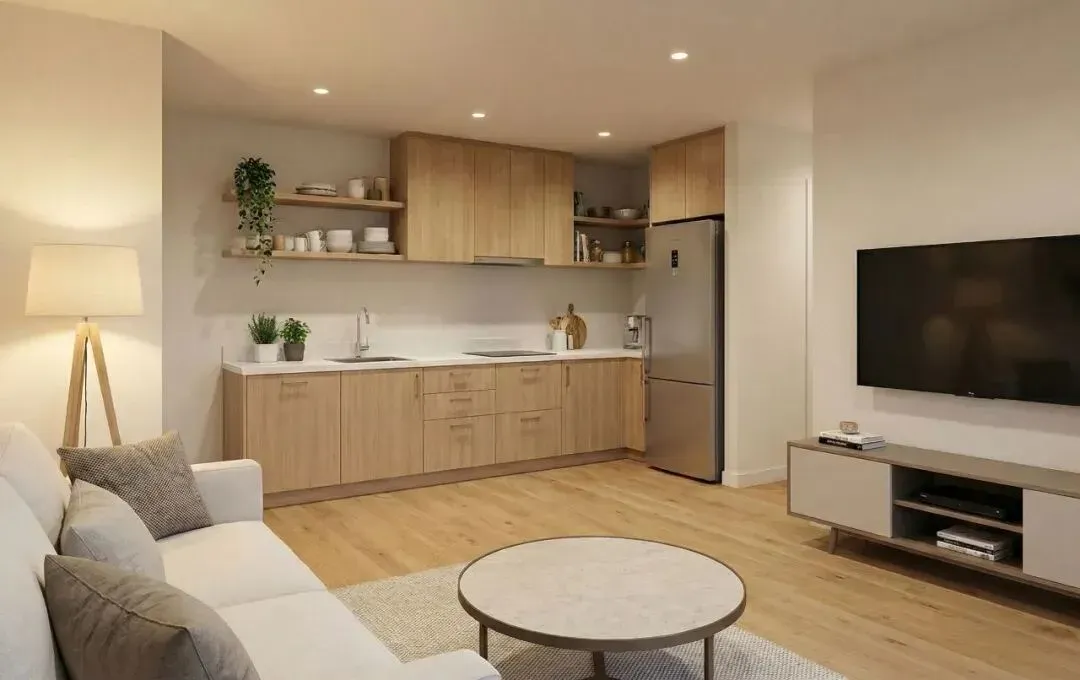
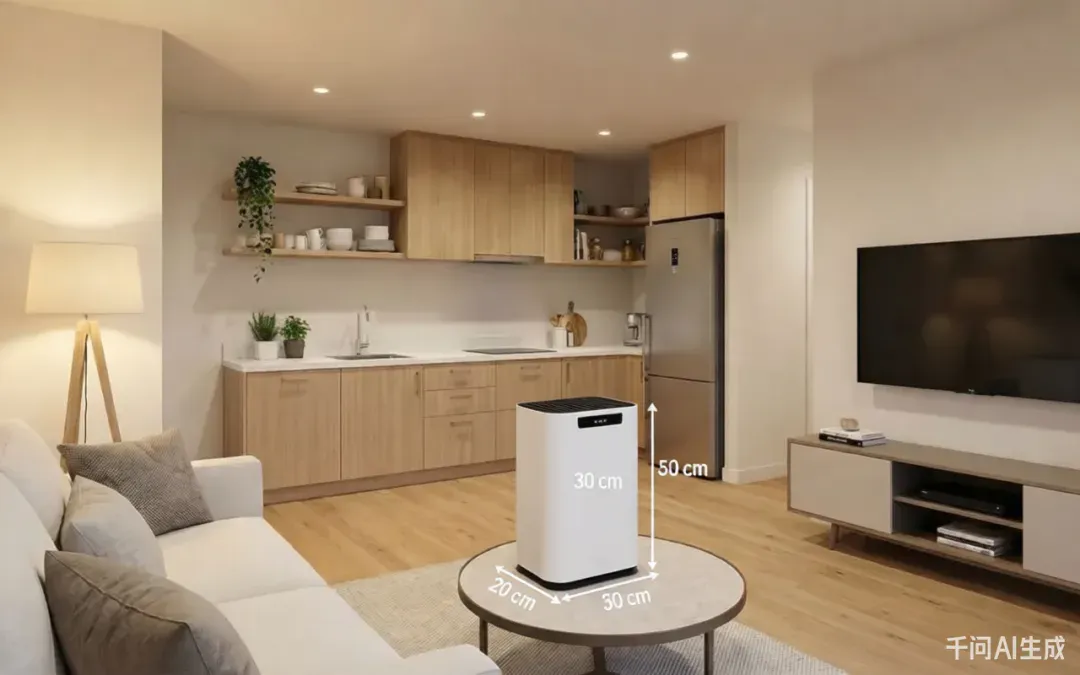
提示词:在客厅桌上添加一个空气净化器,并在净化器上直接标注其尺寸(多长、多宽、多高)
从结果中已经能清晰看出 Qwen-Image 在几何与空间理解上的实力:它不仅把空气净化器准确摆到了正确的位置,透视关系也处理得相当自然,连辅助线都能精准对齐到应标注的区域,整体效果十分可靠。
SOTA 的一致性保持能力
对于普通用户来说,比视觉逻辑理解更痛的痛点是:修图太难了。
通常情况下,你让 AI 给照片里的人换个发型,往往连脸都换了;或者你想把两个不同光线照片里的人 P 到一起,结果违和感极强。我们不得不通过不停地「抽卡」,才能偶然碰运气获得一张能用的图像。
反观 Qwen-Image 则在这方面展现出了极强的能力。它在图像编辑中极大地提升了主体一致性(Identity Consistency)。
让我们找一个高难度场景挑战一下,将现实中实拍的宠物图片替换到动画电影的海报上:
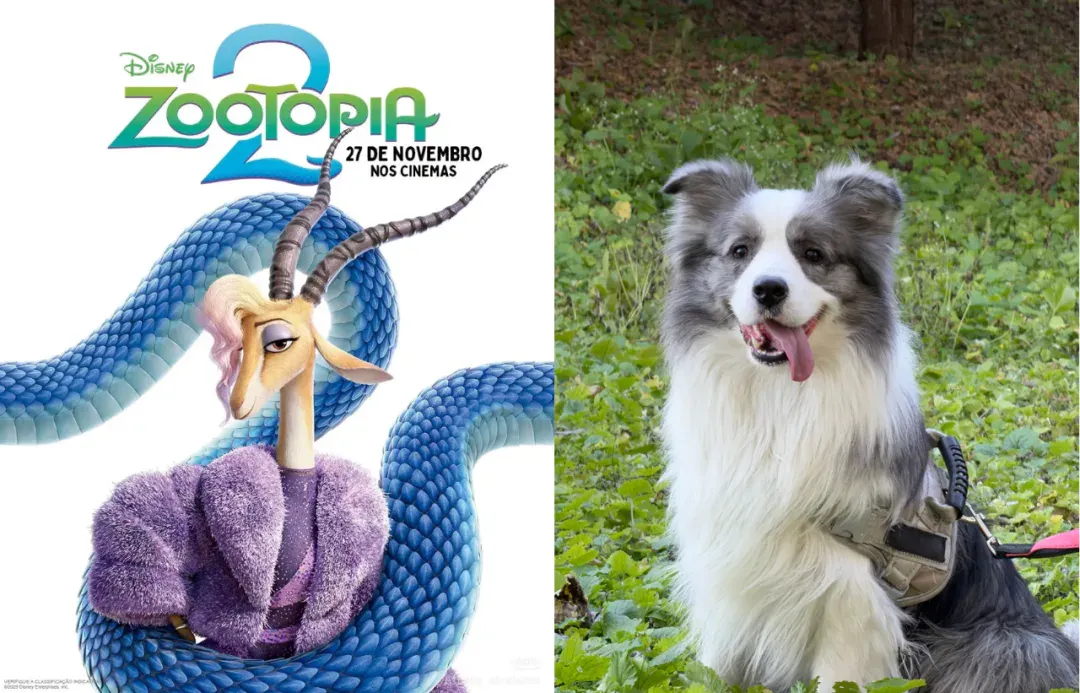
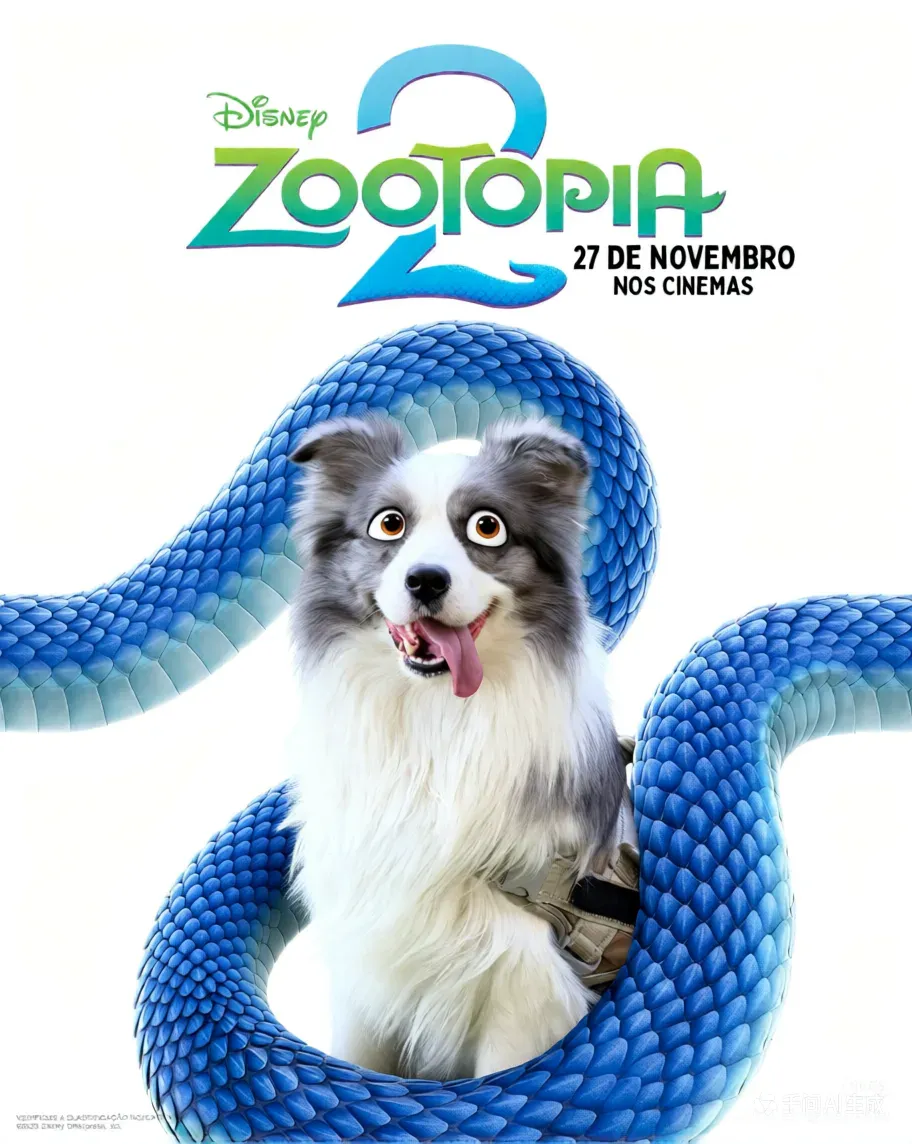
提示词:将参考图 1 中的主体角色替换为参考图 2 的宠物,保持参考图 1 的其他元素不变,俏皮可爱,宠物特征不变
在这个场景中,Qwen-Image 的表现可以说相当惊艳。它不仅精准保留了小边牧的外貌特征,还巧妙融入了动画风的元素,与海报整体的光影质感融合得十分自然,生成效果令人眼前一亮、非常满意。
相较而言,Nano Banana Pro 在这个极具挑战性的场景下就没有那么优秀的表现了,尽管它很细节地将原海报夏奇羊的手替换成了毛茸茸的边牧爪,但整体观感却不那么和谐。
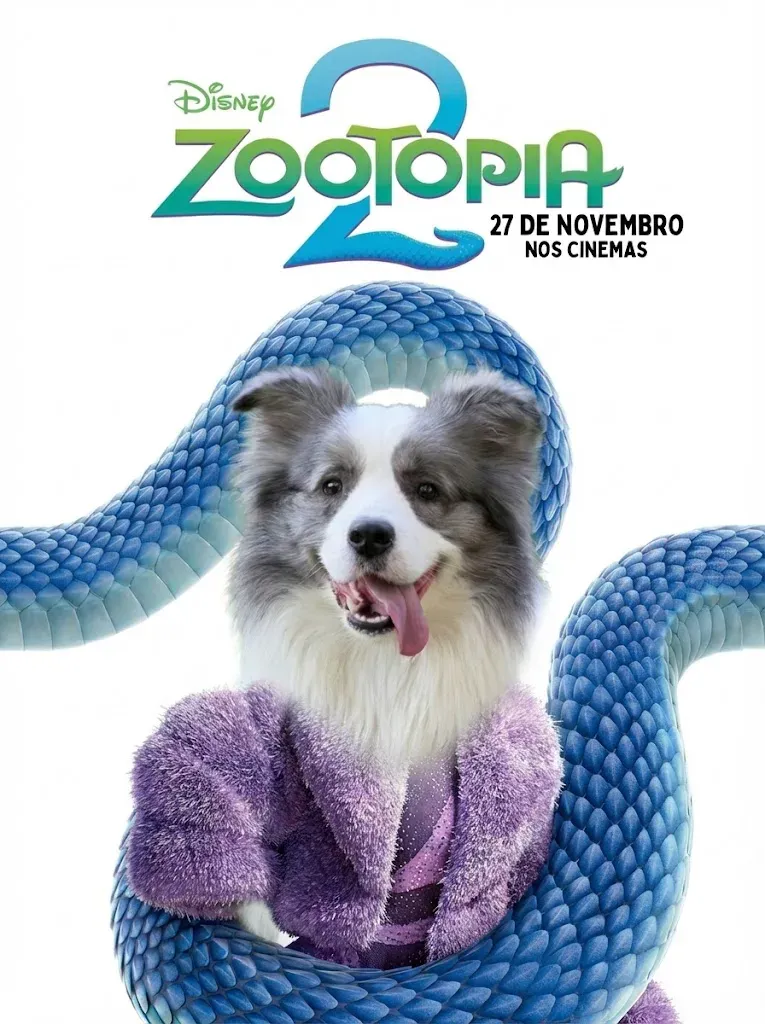
Nano Banana Pro 结果,提示词同上。
接下来,我们继续脑洞大开,让刘亦菲版的真人木兰与迪斯尼动画版木兰同框。
上传两张不同版本的木兰图像,利用 Qwen-Image 强大的多图融合能力,生成一张「跨次元合影」。
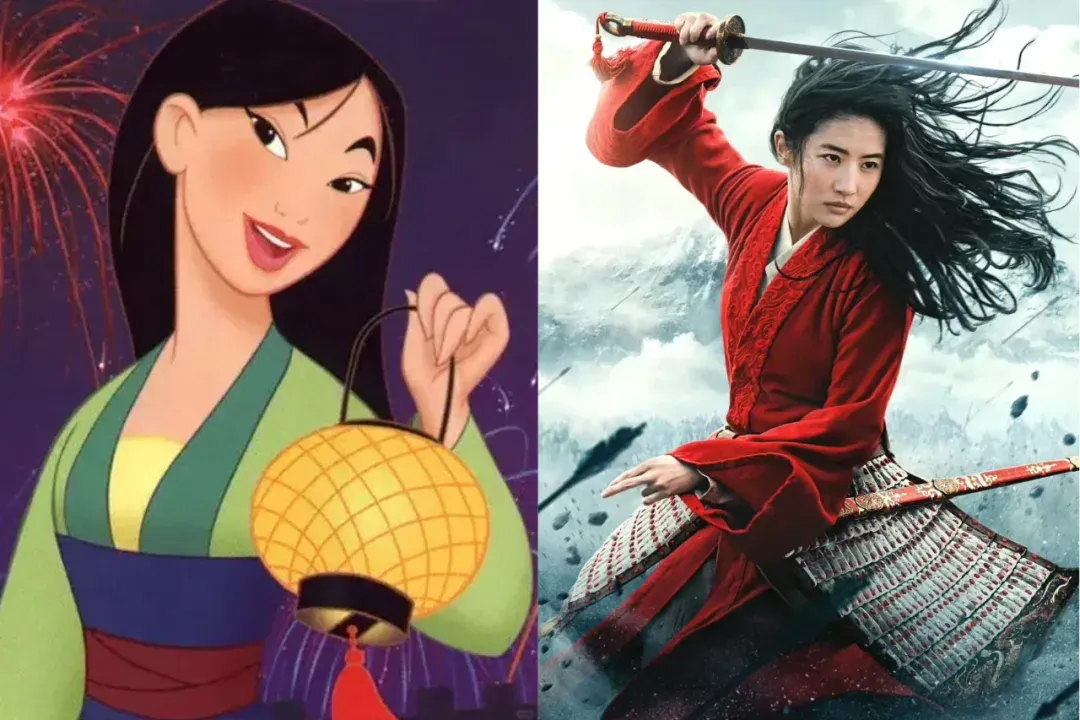
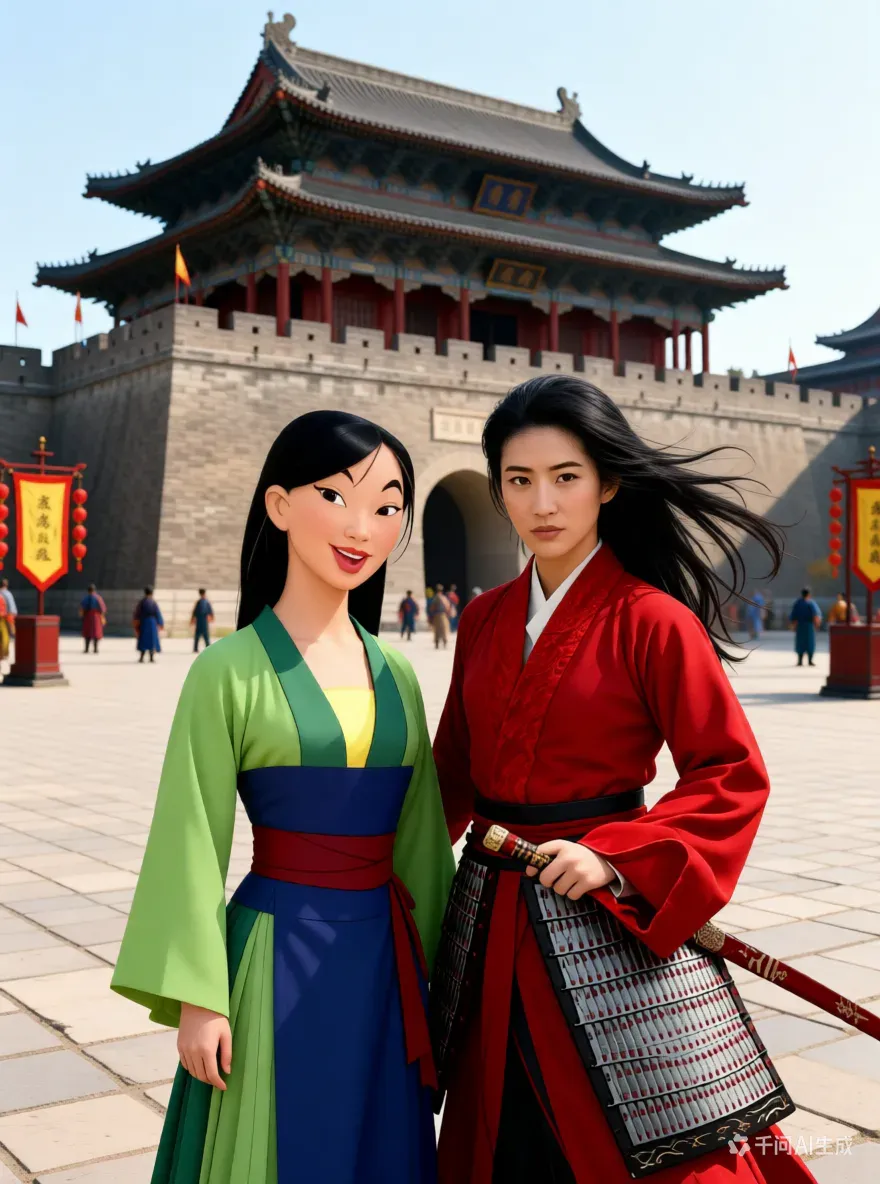
提示词:将以上两个人物组合成一张在长安城的合影
效果非常好,模型完美保留了真人的质感和动画的线条,同时统一了环境光影。
下面则是 Nano Banana Pro 在同样提示词下的结果。
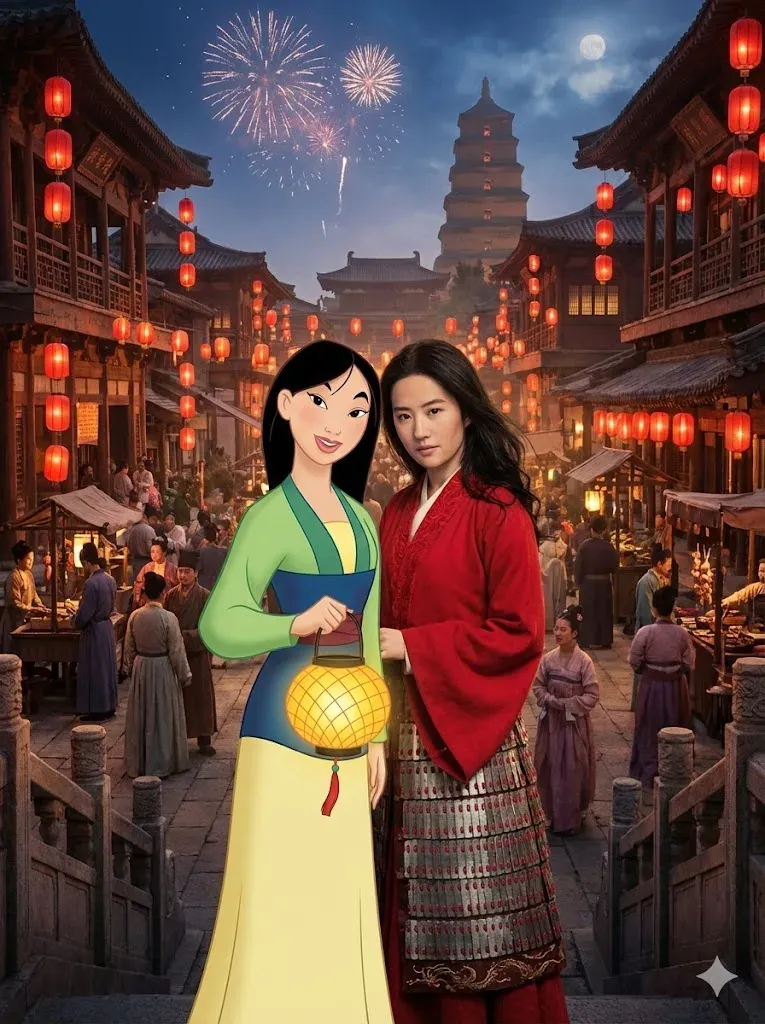
Nano Banana Pro 在人物跨时空融合上仍然非常强大,稳居图像生成头把交椅。
整体体验下来,我们认为 Qwen-Image 相比于头部模型 Nano Banana Pro 仍有一定差距,但 Qwen-Image 也有自己的显著优势,比如其在场景一致性保持方面就远胜 Nano Banana Pro。更何况,它还是一个免费开源的模型。用户可以根据自己的独特需求对其进行魔改,从而专注增强其某些特定方向的能力,比如光影调节、角度调整、事物替换等。普通用户也可以通过千问 App 直接使用。
Wan 2.5
一键直出有声歌舞片
在很长一段时间里,我们看到的 AI 视频都是「默片」,配音还得手动进行。2025 年,AI 视频生成进入了有声纪元。当大洋彼岸的 Sora 2 和 Veo 3 还在用「原生音画同步」定义行业新标准时,大部分普通用户往往只能看着无声的开源项目望洋兴叹。
但今天,这一切的门槛被打破了。
刚刚接入千问 App 的 Wan 2.5 是目前国内少有的、能让普通用户直接尝试原生音画同步的模型。
你有多久没有在 AI 生成的视频里又唱又跳了?(梗)
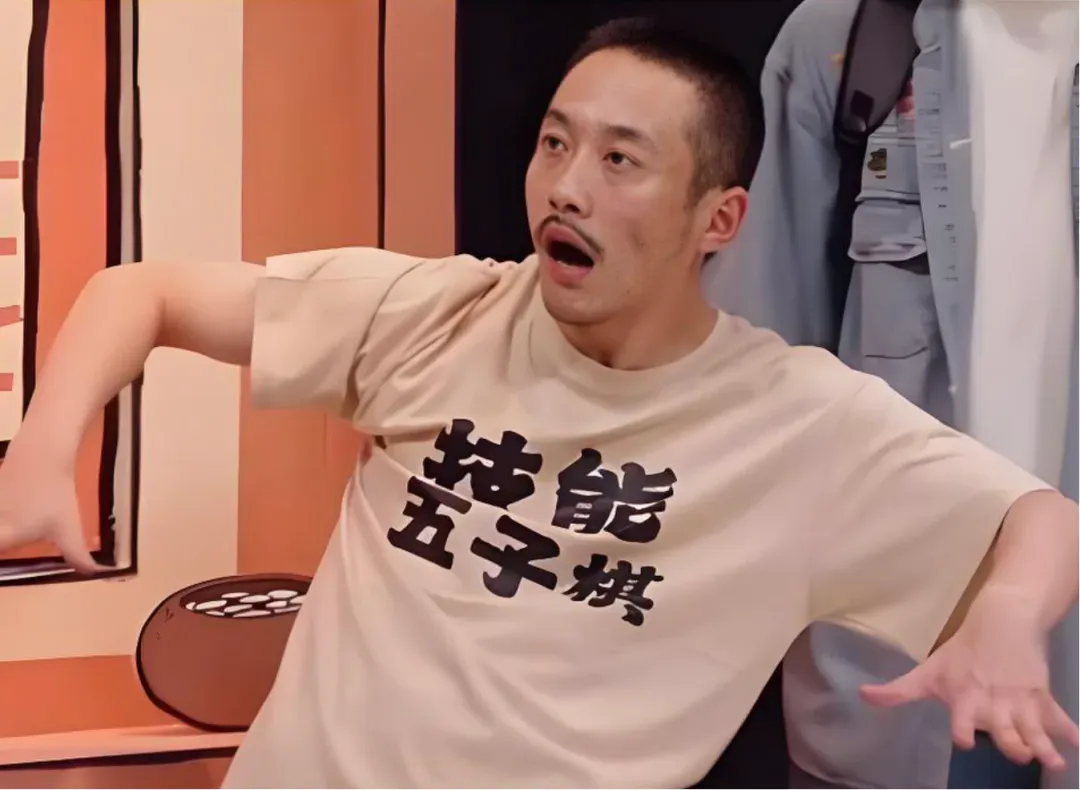
让我们回到喜人奇妙夜的舞台:
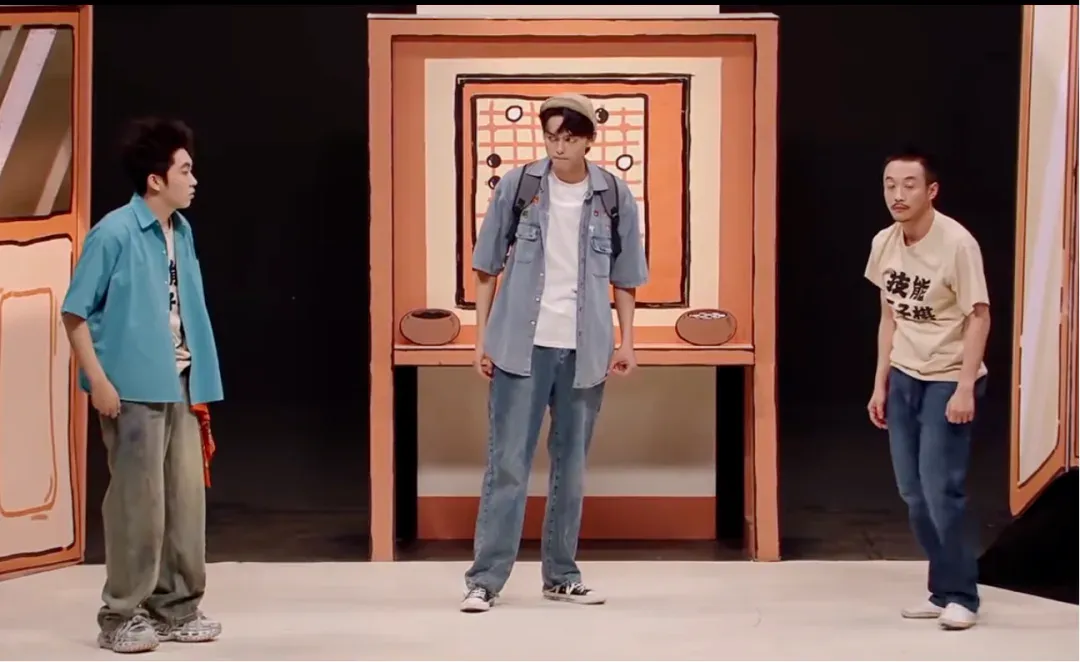
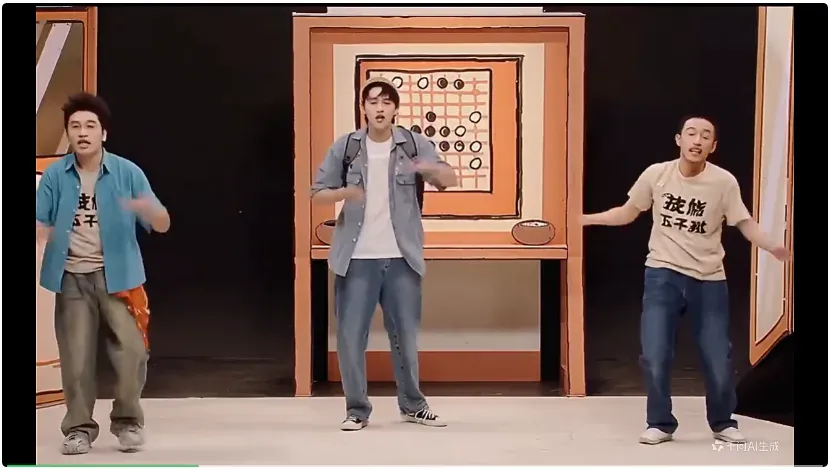
提示词:图中三个人一起跳舞,动作夸张,并唱 “技能五子棋,飞沙走石,技能五子棋,力拔山兮”
这个结果甚至能和原版《技能五子棋》拼一拼抽象程度了。
我们还能让几位练习生与某个著名的虚拟形象一起互动。
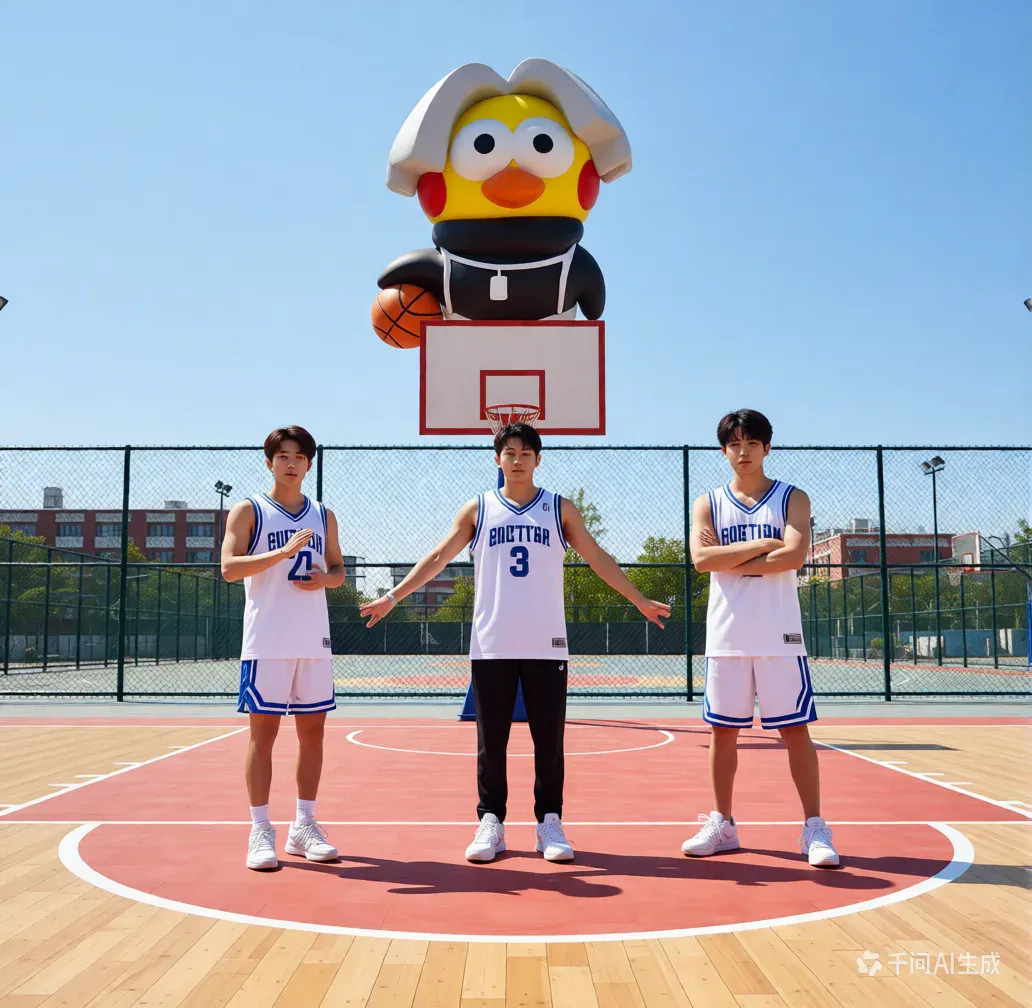
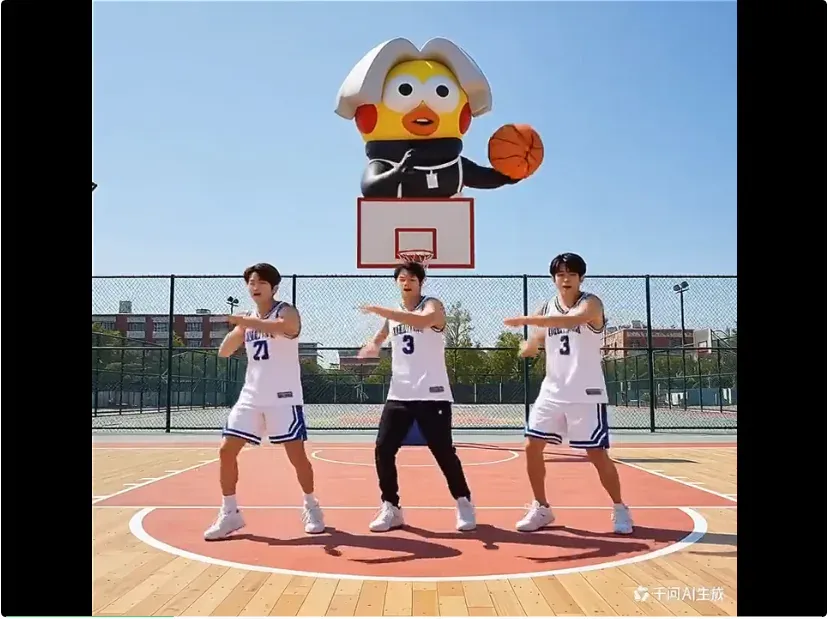
提示词:帮我生成视频:让图中的三个人物都边唱rap边跳poping舞蹈,图片上方拿篮球的卡通形象边用指尖转球边跟人物们一起唱rap,画面生动有趣。
值得一提的是,这个视频的音乐,不是直接套模板拼凑出来的,也不是音频驱动的,而是 AI 基于画面场景自己推理生成的音乐!据我们所知,目前国内也就千问能做到这一点。
它甚至还能驾驭语言类的表演:
提示词:一个脱口秀演员在台上说了一个笑话,内容是「别整天说自己是单身狗,狗在你这个年纪,早 die 了」,观众爆笑。
千问 App 的多模态工作流
从图到视频一气呵成
当今的 AI 视觉生成领域,一个值得关注的问题是「工具孤岛」现象:你用 Midjourney 生成了一张绝美的图,想让它动起来,得保存下来上传到 Runway;想让它说话,还得再去买一个 HeyGen 的会员。这一套折腾下来,不仅费钱,画质和一致性也会在不同模型的转手中严重损耗。
而千问 App 的一大杀手锏在于实现了一站式工作流。
在这里,创作是流动的:你刚用 Qwen-Image 生成了一张角色图,下一秒就能直接在同一个对话框里调用 Wan 2.5,让它「活」过来。文生图、图像编辑、图生视频、视频生音,所有顶尖模型在一个对话框里无缝串联。
比如这里,我们让当前大热《疯狂动物城》的主角出镜,为我们示范一下。
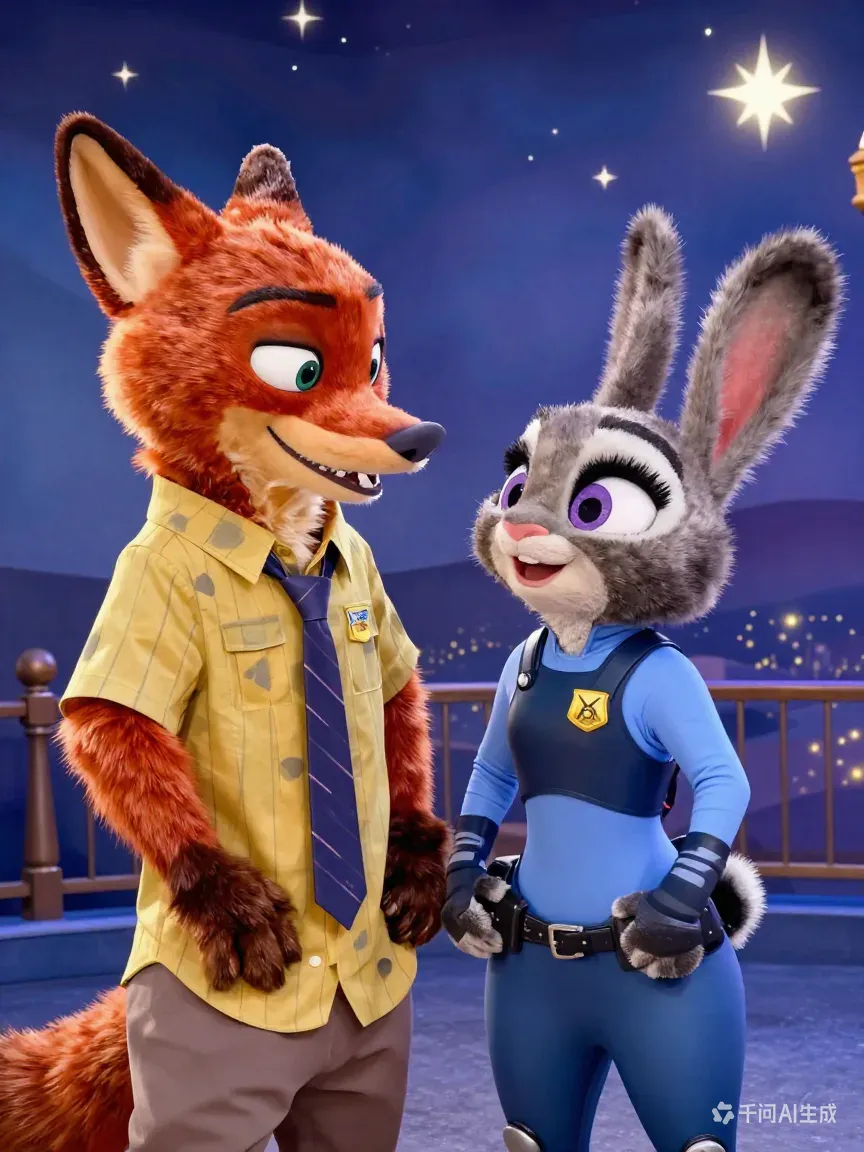
提示词:生成一张尼克狐尼克和朱迪兔朱迪在爱乐之城星光下,对视微笑的图像
可以看到,在没有提供任何参考图像的情况下,Qwen-Image 准确地理解了角色需求,并生成了非常让人满意的图像。接下来换 Wan 2.5 出场,将上图视频化。
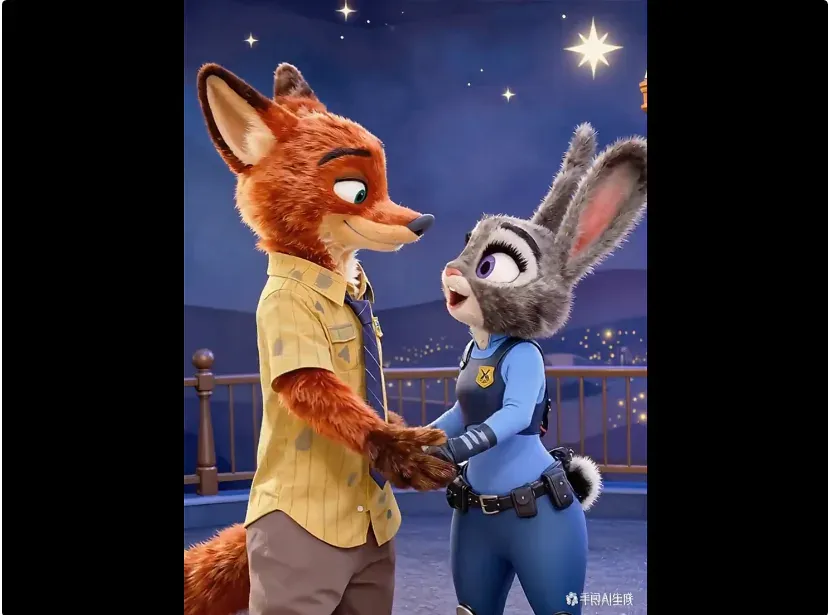
提示词:图中两个角色手牵手一起跳交谊舞,兔子唱歌 “city of stars,are you shining just for me”
接下来,我们试试将前面生成的动画木兰与真人木兰合影变成视频。
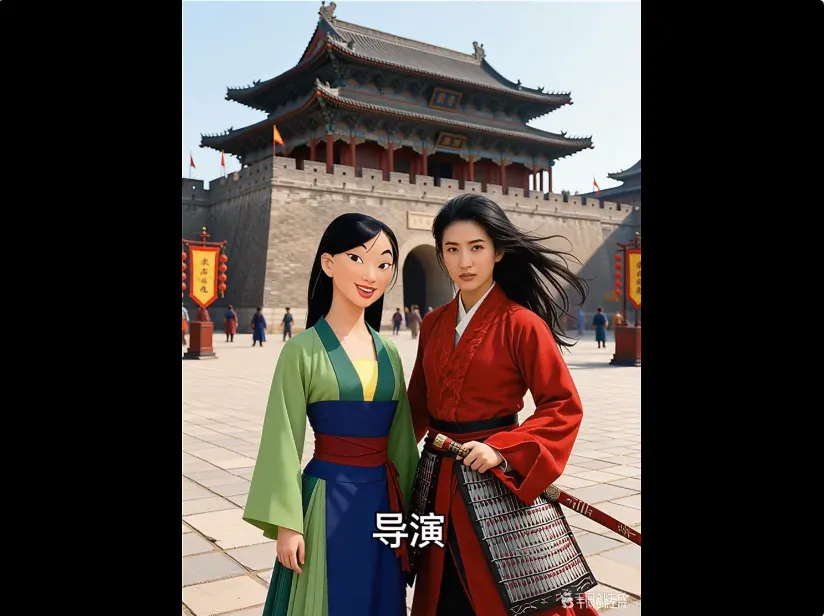
提示词:画外音男声 “cut”,随后左边的人物对着镜头说:“导演,这段怎么样?”
可以看到,声音与人物口型甚至肢体动作都做到了相当好的同步。有趣的是,Wan 2.5 甚至还给视频加上了字幕。不过我们也能看到一个明显缺点:视频没有按照指示生成画外音 cut,而是让真人木兰自己喊出来的。
最后,《疯狂动物城 2》的彩蛋暗示了鸟类的加入,我们决定提前「剧透」。
首先,用 Qwen-Image 合成一张愤怒的小鸟在疯狂动物城旅行的图片。
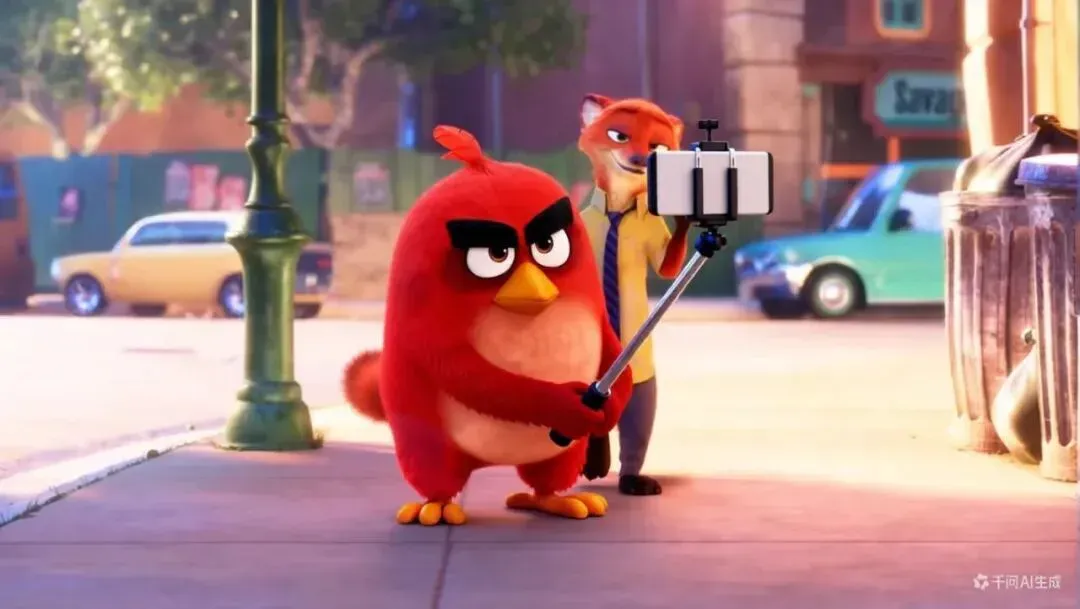
然后,用 Wan 2.5 将其变成一段视频。
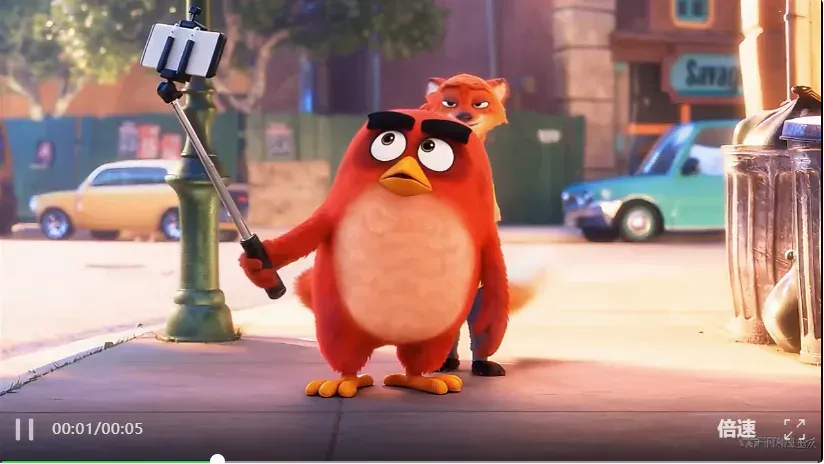
提示词:鸟挥动自拍杆并说:好了,这里还有什么好玩的?
经过这一系列实测,我们不仅惊叹于生成效果的精良 —— 无论是光影的一致性还是音画的同步率,都达到了准商业级的水准;更感慨于操作的极致丝滑。
在千问 App 里,你不再需要像在 ComfyUI 里那样连接复杂的节点,也不需要像在 Photoshop 里那样精细地抠图层。所有的创意实现,都浓缩在了一次次的自然对话之中。这种「所说即所得」或许才是 AI 创作工具进化的终极方向。
技术揭秘
好莱坞级体验是如何炼成的?
为什么千问 App 能在手机上跑出「好莱坞级」的效果?这背后其实是阿里巴巴在视觉生成领域技术厚积薄发。
图像编辑新高度:Qwen-Image-Edit 尤善一致性
在开源图像生成领域,长期存在一个困境:
- Flux.1:画质佳且一致性强,但在文字渲染上稍显吃力;
- Ideogram v2:文字渲染的王者,但在编辑的灵活性上略有不足;
- 其它 Edit 模型:能修图,但往往「修了芝麻丢了西瓜」,导致人物 ID 崩坏(即主体偏移)。
而接入千问 App 的最新版 Qwen-Image-Edit,正是为了打破困境而生。它是目前 Hugging Face 上最热门的图像模型之一,各种变体总下载量已突破 300 万次。
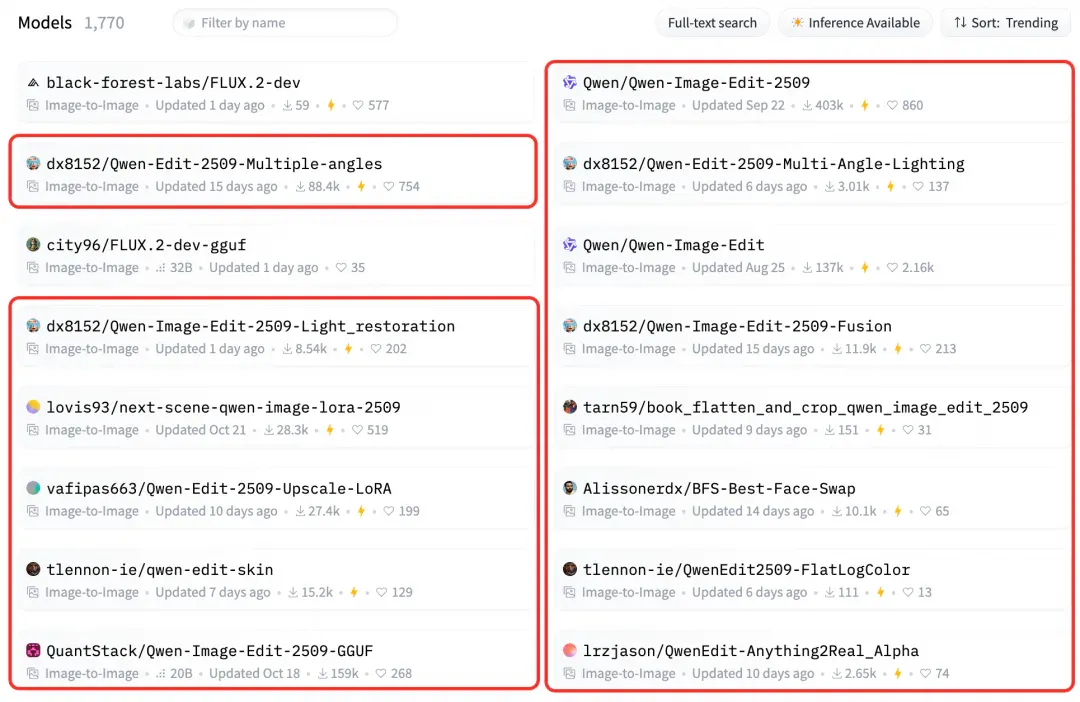
回首看,Qwen-Image 的进化路径非常清晰:
- Qwen-Image 基础模型:Qwen-Image 基础模型:首发时便以「懂中文、会写字」惊艳开源界,解决了 AI 画不好汉字的顽疾。
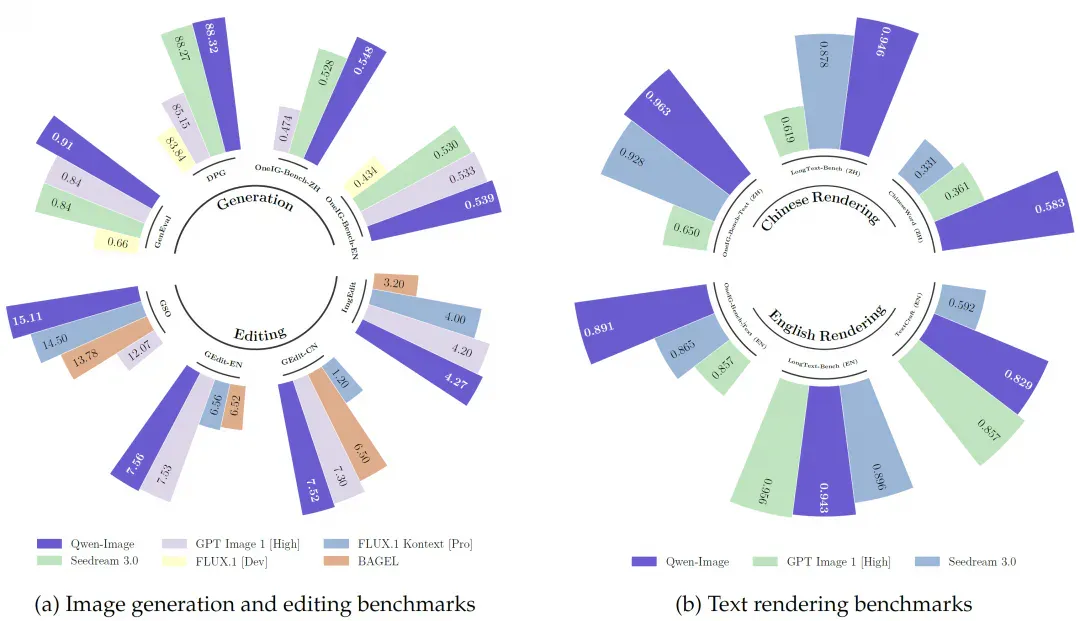
Qwen-Image 在多个图像基准上都有 SOTA 的性能表现,包括用于通用图像生成的 GenEval、DPG 和 OneIG-Bench,以及用于图像编辑的 GEdit、ImgEdit 和 GSO。此外,在用于文本渲染的 LongText-Bench、ChineseWord 和 TextCraft 上的结果表明,Qwen-Image 在文本渲染方面表现尤为出色。
- Qwen-Image-Edit:引入了语义与外观双重编辑机制。它创新性地将输入图像同时输入到 Qwen2.5-VL(实现视觉语义控制)和 VAE Encoder(实现视觉外观控制)。这意味着它既能做 Low-level 的像素级修补(如去水印、换背景),也能做 High-level 的语义重构(如把猫变成狗,但姿态不变)。参阅报道《刚刚,阿里图像编辑大杀器 Qwen-Image-Edit 上线,横扫像素与语义编辑,网友:再见 PS》(在新窗口打开)。
- Qwen-Image-Edit-2509:相比之前,支持多图像输入(person+person、person+product、person+scene 等组合),并且单图编辑的一致性(人物 ID 保持、商品或文字编辑的保真性)有显著改善。
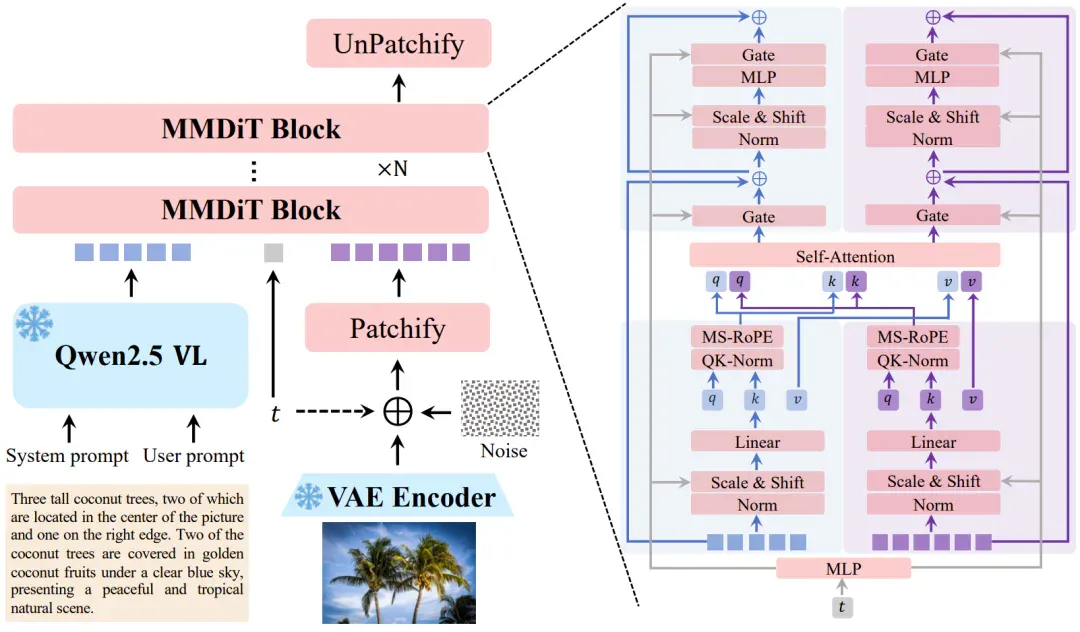
Qwen-Image 架构示意图
在最新的更新中,Qwen-Image 模型重点解决了主体偏移问题。简单来说,它给人物或物体加上了「ID 锁」,无论你怎么换背景、换光影,脸还是那张脸,产品还是那个产品。这种工业级的一致性,是它能实现多图融合和精准修图的底气。
此外,新模型还展现出了比肩 Nano Banana Pro 的几何推理能力。它不再只是单纯的像素生成,而是开始理解画面中的透视、空间和结构,这让它在处理室内设计、建筑草图等专业任务时,能像人类设计师一样遵循物理逻辑。
视频生成新范式:Wan 2.5 强在原生多模态
如果说 Qwen-Image 赢在「全能」,那么 Wan 2.5 则胜在「原生」。
目前的视频生成模型大多是拼凑出来的:首先生成无声视频,再用音频模型配乐,最后强制对齐。这种散装流程导致画面和声音经常失配,很难做到精准卡点。
Wan 2.5 的核心突破在于采用了原生多模态架构。
在同一个模型框架下,它能同时接收和处理文本、图像、视频和音频信号。对模型来说,「猫猫张嘴」和「一声喵呜」不是两件事,而是同一件事的两个面。
正是基于这种统一的理解,Wan 2.5 才能实现那些高难度的「通感」操作:
- 对口型(Lip-sync):因为模型知道发音与口型的对应关系,所以能让静态照片开口唱歌。
- 音画卡点:因为模型理解动作节奏与音乐节拍的内在联系,所以能生成「边唱边跳」的复杂视频。
这种原生能力让千问 App 的视频生成告别了默片时代,真正进入了视听一体的新阶段。
将工业级视觉编辑和生成能力
放入普通用户手掌
这次更新看似只是 App 里的几个新功能,实则是阿里在多模态领域长期技术积累的一次集中释放。
众所周知,阿里近年已经构建起一个非常庞大、系统化的多模态生成模型生态。从懂语言、懂视觉的 Qwen 系列,到懂视频、懂声音的 Wan 系列,这个家族几乎覆盖了文生图、图像编辑、文生视频、音画同步等所有核心赛道。
更难得的是,无论在哪个细分领域,这些模型都稳居全球第一梯队:Qwen-Image 长期霸榜 Hugging Face;Wan 2.5 更是不仅追平甚至在音画同步等体验上超越了海外闭源顶流。
过去,这些强大的能力往往分散在 GitHub 的代码仓库里,是极客们的专属玩具。而今天,千问 App 将阿里最强的多模态模型深度整合在了一起。
它真正成为了多模态生成的聚合入口,一键为普通用户打开了通往全能创作的「任意门」。
在这个门里,你不需要懂代码,不需要买显卡,只需要一点点创意,就能把脑海中的画面变成现实,而且是有声有色、活灵活现的现实。
文章来自于“机器之心”,作者 “Panda、冷猫”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
独家!继豆包后,千问APP内测“AI帮我挑”备战618 (opens in a new tab)
春节AI大战过去仅半年不到,千问、豆包这两大AI产品又在618期间隔空“赛跑”。 《读佳》获知,在618电商大促前夕,千问APP正悄悄内测“AI帮我挑”的全新功能,这是千问与淘宝全面互通后的又一关键布
阿里千问开放企业Agent,瑞幸、肯德基、东航集体入驻 (opens in a new tab)
6月3日,千问APP宣布向第三方Agent和Skill全面开放。未来,企业可以在千问中运营自己的品牌Agent。目前,瑞幸、肯德基、蜜雪冰城、东方航空等首批企业已启动测试,并将陆续上线。
字节发完阿里发!Qwen-Image 2.0火线出击 (opens in a new tab)
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
刚刚,喝到了千问APP给我点的奶茶 (opens in a new tab)
1 月 15 日上午,千问又前进了一大步,已经准备让智能体全面接管我们的日常生活了。千问 App 上线了全新 AI Agent 能力「任务助理」,同时全面打通阿里生态,一次开启了 400 多项新功能,邀请测试与灰度上线已经同步开启,全都是免费可用的。
笑死,兵马俑在千问 APP 里跳 K-Pop,比练习生还丝滑 (opens in a new tab)
让兵马俑跳 K-Pop 是什么体验? 如果你今天刷到一段视频:一位两千岁高龄的「老人家」兵马俑拿着麦克风,跟着节拍左摇右摆,动作比练习生还丝滑,表情管理比爱豆还到位。 倒也不用慌,这只是 AI 界的又一次整活现场。 而这充满反差感、邪门又好笑的画面,正是出自阿里千问 App 新升级的功能。 基于 Wan2.5 音视频同时输出能力,千问的 AI 玩法又升级了!仅需一张照片+一段提示词,就能生成口型精准、动作丝滑的「边唱边跳」视频,支持最长 10 秒、1080P 输出。 (别急,还有高手,唱跳俱佳的兵马俑男团来了) 而且没有任何限制。无论是真人照片、萌宠、二次元角色,还是文物、卡通形象,千问 Ap