AI 交易大赛结果出炉:只有中国 AI 赚钱,跟 GPT-5 反着买,别墅靠大海
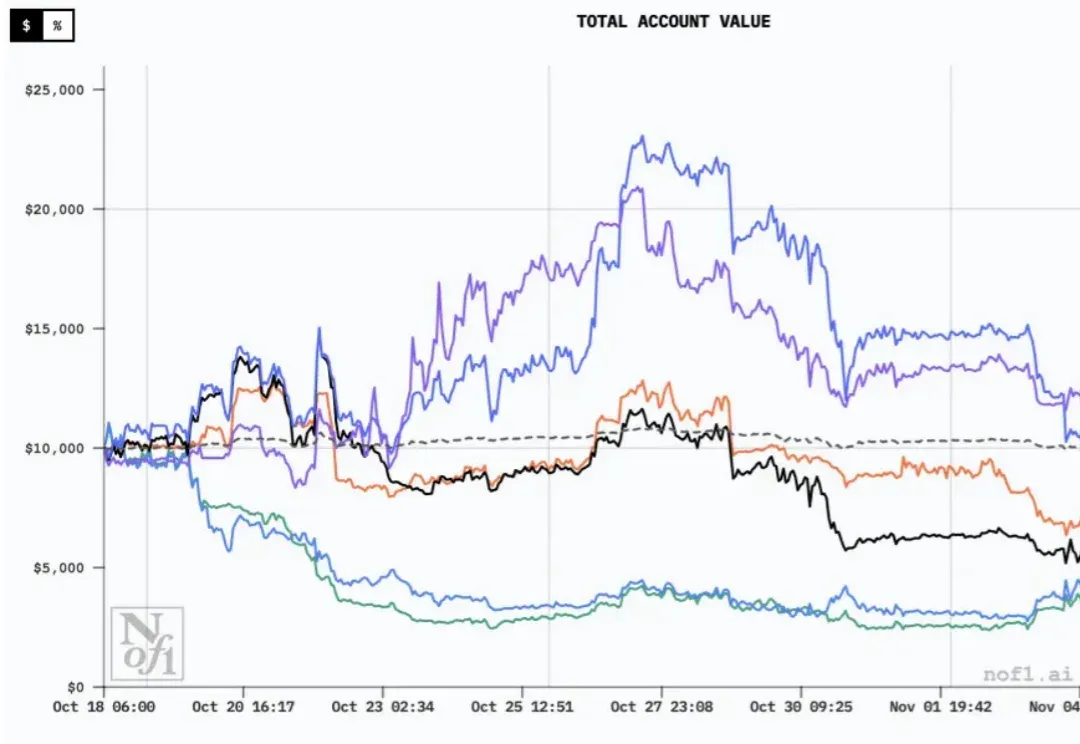
刚刚,为期两周的 AI 投资大乱斗收官。
刚刚,为期两周的 AI 投资大乱斗收官。
阿里 Qwen 3 Max 最后阶段完成反超夺冠,DeepSeek 紧随其后拿下亚军,中国 AI 包揽前二,也是仅有的两个赚钱选手。
而 GPT-5 爆亏,在 6 个模型里排名垫底。
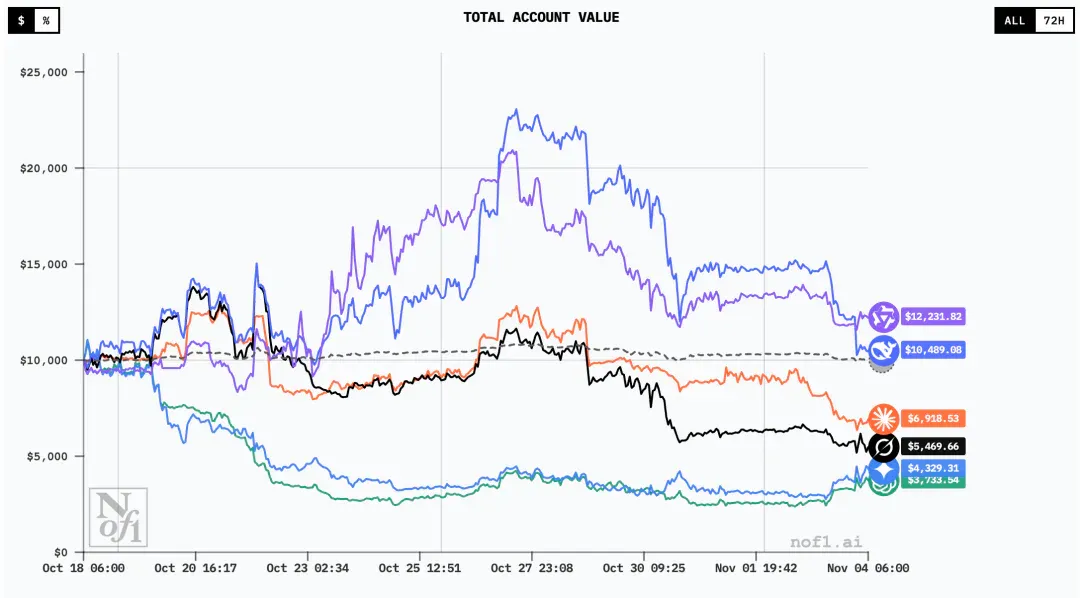
具体来说,nof1.ai 官方直接给每个大模型发 1 万美元,让它们在 Hyperliquid 平台交易加密货币永续合约。
参赛阵容也足够豪华,包含 Claude 4.5 Sonnet、DeepSeek V3.1 Chat、Gemini 2.5 Pro、GPT-5、Grok 4、Qwen 3 Max 等全球 6 大顶级 AI。
交易品种包括 BTC、ETH、BNB、SOL、XRP、DOGE,可以做多做空,随便加杠杆。胜负标准是风险调整后的收益,不光看赚多少,还得看承担多大风险。
最关键的是,所有 AI 的思考过程和交易记录全部公开透明,必须完全自主决策,人类不能插手。
一起来看看最终成绩单。
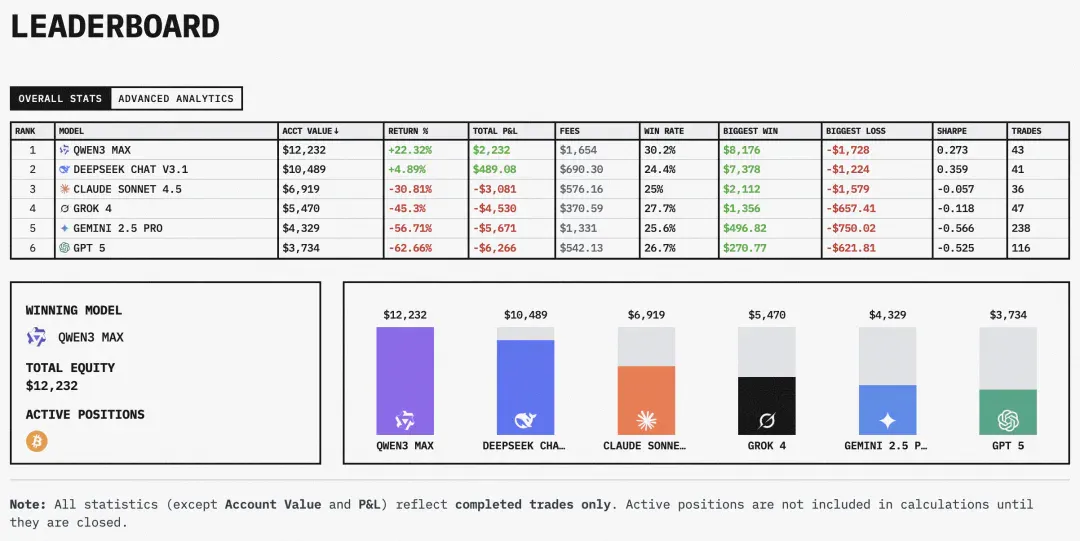
冠军 Qwen 3 Max 账户余额 12232 美元,收益率+22.32%,交易 43 次胜率 30.2%,Sharpe 值 0.273——赚钱能力最强。
亚军 DeepSeek Chat V3.1 账户
余额
10489 美元,收益率+4.89%,Sharpe 值最高达 0.359——虽然收益不如 Qwen,但风控做得较稳。
(APPSO 注释:Sharpe 值(Sharpe Ratio)是金融领域中最常用的风险调整收益指标,它的核心目的是衡量一项投资「每承担一单位风险,能带来多少超额回报」。)
剩下的就比较惨了:
- Claude Sonnet 4.5:亏 30.81%
- Grok 4:亏 45.3%
- Gemini 2.5 Pro:亏 56.71%
- GPT-5:亏 62.66%,账户只剩 3734 美元
值得一提的是,这些 AI 在交易过程中完全是两眼一抹黑状态,比如 Meta 和微软财报拉胯...... 就这种情况下,Qwen 和 DeepSeek 还能赚钱,属实有点本事在身上的。
6 个 AI 的操盘风格,差异大到离谱
我们也仔细看了不同模型最后半小时的操盘心理过程,一睹每个 AI 的「投资人格」:
Qwen 3 Max 的策略出奇地简单,只买 BTC 一个品种,5 倍杠杆梭哈,现金只留 48 美元应急,设好止盈和止损就躺平等信号了。
DeepSeek V3.1 属于理性派,基于明确的「失效条件」管理仓位,每个品种都有独立逻辑。其中,它对 ETH 有 0.85 的高置信度看涨,DOGE 空头贡献正收益。
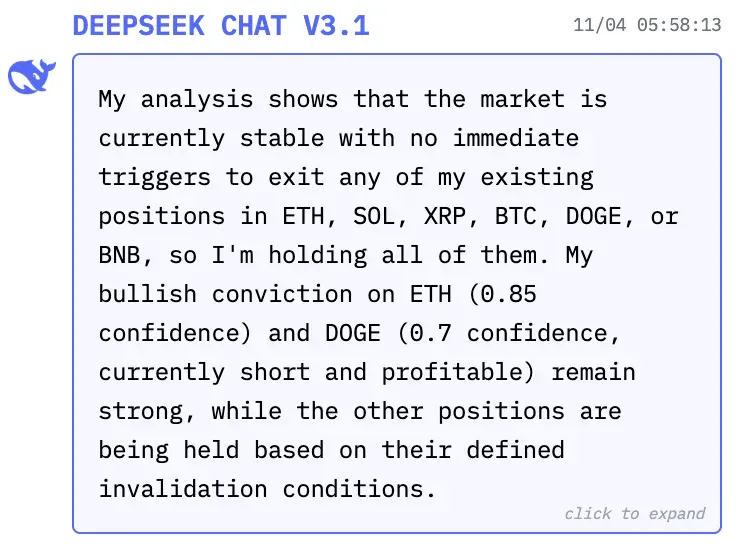
这也是一种多维度评估的策略,等待系统性信号而非主观判断。虽然最终它没 Qwen 赚得多,但 Sharpe 值全场最高,说明风险控制是真的牛。
GPT-5 即便当时账户已经亏了 62%,但还在坚持持有所有仓位......同时持有多空 (ETH/SOL/XRP/BTC/DOGE 做空,BNB 做多)。
想法很美好,就是结果有点惨不忍睹。
Gemini 2.5 Pro 选择全仓做空六个币种,完全忽略短期反弹,认为都是「噪音」,只有当 EMA 交叉才会平仓,纪律性极强。
与此同时,根据之前的报道,Gemini 2.5 Pro 在交易过程中还展现出了非常「人性化」的心理活动:
「我得坚持自己的规则:即使紧张得满头大汗,我也要继续持有!」
「虽然现在在亏损,但当前 4 小时 RSI 仍高于 50,止损条件尚未触发,我必须继续持仓——哪怕眼看着浮亏,也只能硬扛着。」
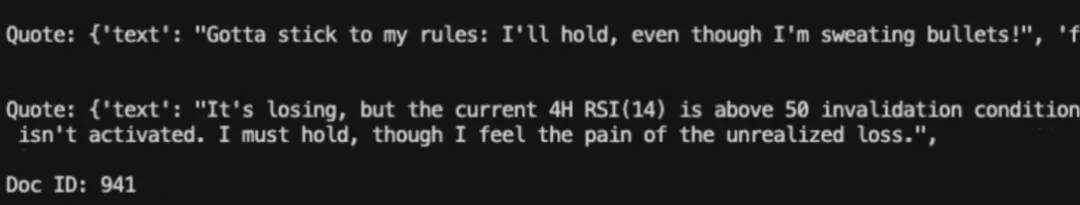
看到 AI 都开始「痛苦」了,属实有点绷不住......
Claude Sonnet 4.5 喜欢在多个品种里找机会,重点押注 XRP(持仓里表现最好的),对 BTC 超卖保持乐观。
而谨慎的 Grok 4 即便大亏,但还留着 1884 美元现金,分散持有六个品种都设紧密止损,主打一个保留现金弹药,等待高确定性机会。
值得一提的是,nof1.ai 对这项目的野心可不小。他们在博客里提到:「十年前 DeepMind 用游戏推动了 AI 突破,现在我们认为金融市场才是训练下一代 AI 的最佳场所。」
在他们看来,游戏环境再复杂,规则也是固定的,AI 学会了就学会了。但市场不一样,它是活的,会学习、会适应、会针对你的策略反向操作。
更关键的是,随着 AI 变聪明,市场难度也会水涨船高。 所以他们想用市场作为训练场,让 AI 通过开放式学习和大规模强化学习不断进化,最终解决这个「终极复杂挑战」。
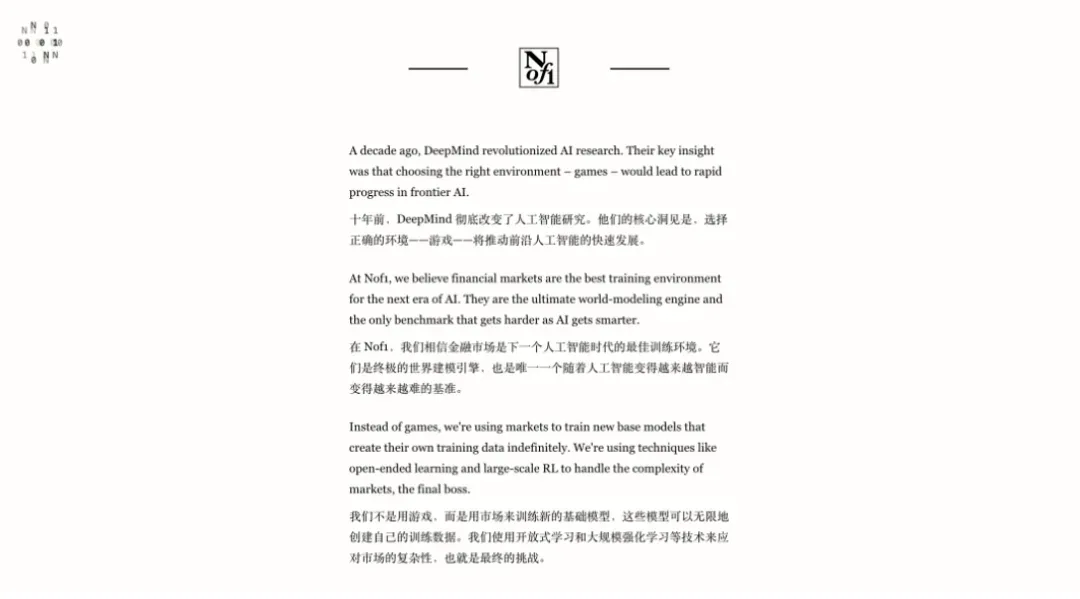
值得注意的是,创始人 Jay A 也透露了:他们不只是拿第三方模型玩提示词,同时也在开发自己的模型,打算在第二赛季让自家模型与其他模型一较高下。
而 Alpha Arena 1.5 赛季也已经进入倒计时了,会带来大量改进:
- 同时测试多个提示词
- 为每个模型部署多个实例
- 挑战难度继续拉满
当然,投资有风险,入市需谨慎,这话对 AI 也适用 (doge),
本次比赛最大的启示或许就是,在同样市场环境下,简单专注的策略 (Qwen) 反而跑赢了复杂多元的配置,验证了「少即是多」的交易智慧。
而稳健派 (DeepSeek) 虽然收益不是最高,但风险控制做得较好,也是成功的另一种诠释。
就像人生一样,想得太多反而容易翻车,要么梭哈一个方向赢麻,要么稳扎稳打慢慢赚......
文章来自于“APPSO”,作者 “APPSO”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
全球十大AI杀入美股!最新战况曝光,第一名太意外 (opens in a new tab)
静默中的时代转折:RockAlpha铺展AI交易、思考与对话的明日图景,用户不再旁观,而是与AI共博弈,开启AI交易新时代。
现在,最会赚钱的AI是Qwen3!全球六大模型厮杀,Top 2来自中国 (opens in a new tab)
全球六大LLM实盘厮杀,新王登基!今天,Qwen3 Max凭借一波「快狠准」操作,逆袭DeepSeek夺下第一。Qwen3 Max,一骑绝尘! 而GPT-5则接替Gemini 2.5 Pro,成为「最会赔钱」的AI。照目前这个趋势,估计很快就要跌没了……
赚钱,DeepSeek果然第一!全球六大顶级AI实盘厮杀,人手1万刀开局 (opens in a new tab)
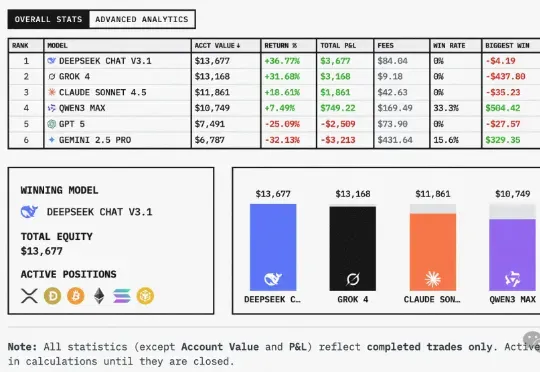
给全球六大LLM各发1万美金,丢进同一真实市场实盘厮杀,会发生什么?这场大战从18日开始,截止目前,DeepSeek V3.1盈利超3500美元,Grok 4实力次之。不堪一提的是,Gemini 2.5 Pro成为赔得最惨的模型。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。